機器學習 - 從線性回歸到神經網路
之前寫的線性回歸,充斥了大量的公式,對於入門來說顯得過於枯燥,所以打算重寫這一部分,而了解了線性回歸後,它又可以為我們解釋深度學習的由來。
一、機器學習簡述
機器學習可以理解為電腦根據給定的問題及數據進行學習,並可根據學習結果解決同類型的問題。可以把機器學習比作一個函數,把我們已知的數據輸入進去,預測出我們想要知道的資訊:
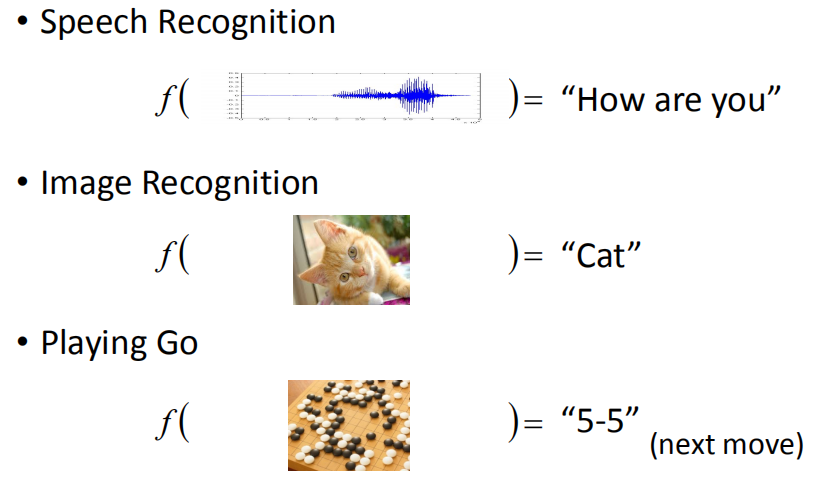
其中,我們把特定的問題叫做任務,輸入的數據叫做數據集(數據集內部又分為樣本和標籤),學習結果叫做函數(或者模型)。
所以,我們的任務就是要找到一個這樣的函數,能夠在特定的場景下儘可能準確地預測,從而指導我們的決策。
二、線性回歸
接下來我們就從最簡單的函數 — 線性函數開始。
(一)尋找合適的函數(模型)
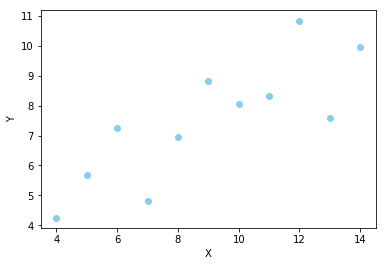
實際上,找函數的過程是較為主觀的,因為它基於我們對當前任務是如何理解的。一般情況下,我們通常會根據數據分布的趨勢決定函數類型。例如,從這樣的一個數據集中,我們可以看出數據有沿右上方分布的趨勢,所以可以用最簡單的線性回歸進行擬合:
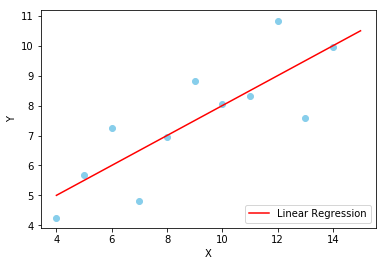
在這種情況下,函數為一元二次,可令:\(y = wx + b\) ,其中 \(x\) 為數據集樣本,\(y\) 為對應的樣本標籤。
但是,我們也可以選擇其他函數進行擬合,假如我覺得曲線函數能更好地描述數據分布,那麼也可以用曲線函數進行擬合:
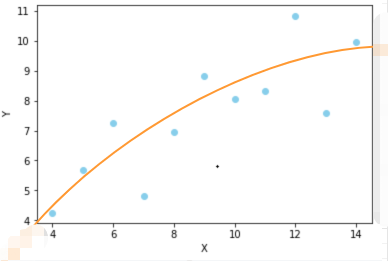
但是,無論我們使用哪個函數,都是對已知數據的擬合,而我們的目標是為了能夠儘可能准地預測未知的數據,所以需要有一個標準來衡量所選函數的性能(函數在機器學習中也叫做模型)。
(二)定義損失函數 - 量化模型誤差
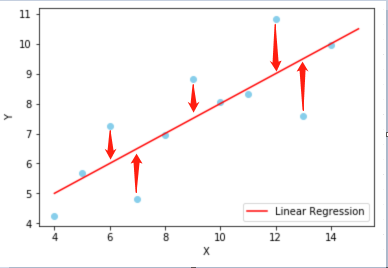
在現實生活中,我們通常把預測值與實際值之間的差異叫做誤差,這在機器學習中也同樣適用。我們將使用模型計算出來的預測值 \(y\) 與實際值 \(\hat{y}\) 作比較,就可得到數據集中一個樣本的誤差。把所有樣本的誤差加總到一起,就得到了通過這個模型預測的總誤差。在線性回歸中,一般使用均方誤差來統計總誤差:
\(\smash{L(w)} = \sum_{i=1}^{n}{(y_i - \hat{y_i})^2}\)
這個用來統計總誤差的式子在機器學習中叫做損失函數,可以理解為通過這個模型預測,會在真實值的基礎上損失多少。所以,損失值越小,代表這個模型的預測精度越高。
(三)求極值
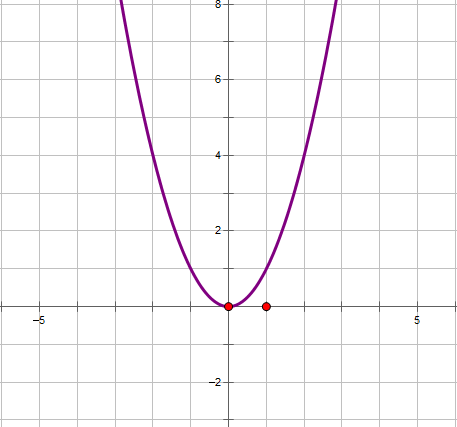
那如何求它的最小值呢?我們注意到,損失函數是一個二次函數,其影像是開口向上的,存在最小值。所以可以通過對損失函數求導求得最小值。
\(\begin{align*}
\frac{\partial{L(w)}}{\partial{w}} &= 2\sum_{i=1}^{n}{(y_i - \hat{y_i})\frac{\partial{y_i}}{\partial{w}}}\\
&= 2\sum_{i=1}^{n}{(y_i - \hat{y_i})x_i}\\
&= 2\sum_{i=1}^{n}{(wx_i + b - \hat{y_i})x_i}
\end{align*}\)
(四)使用模型預測
極值求出來後,就得到了可用於預測的模型,接下來要做的就是輸入樣本數據,得到樣本的預測數據了。
(五)使用 sklearn 建立線性回歸模型
上面給出了求解最小值的數學公式,感興趣的同學可自行編寫程式碼實現。如果一看公式就頭疼,也可以直接使用python封裝好的 sklearn 包實現。通過調用該包,僅需幾行程式碼就可實現。
1.繪製數據集樣本
首先我們畫出數據集的樣本分布情況:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# 樣本特徵數據
x = [10.0, 8.0, 13.0, 9.0, 11.0, 14.0, 6.0, 4.0, 12.0, 7.0, 5.0]
# 樣本標籤
y = [8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]

# 轉換成列向量
x = np.array(x).reshape(-1, 1)

# 繪製散點圖
plt.scatter(x, y, color='skyblue', marker='o', linewidth=1)
plt.xlabel('X')
plt.ylabel('Y')
2.繪製訓練模型
在散點圖的基礎上,根據模型的訓練結果,即可繪製出線性模型:
# 畫出原數據集散點圖
plt.scatter(x, y, color='skyblue', marker='o', linewidth=1)

# sklearn線性模型
regr_model = LinearRegression()
# 訓練模型
regr_model.fit(x, y)

# 構造出一系列點,通過訓練得出的斜率和截距畫出擬合直線
xx = np.arange(4, 16)
yy = regr_model.intercept_ + regr_model.coef_ * xx
plt.plot(xx, yy, label='Linear Regression', color='red')

# 設置label
plt.xlabel('X')
plt.ylabel('Y')
plt.legend(loc=4)
3.預測樣本
有了模型,就可以對未知的數據進行預測了,我們分別對樣本特徵0, 1 進行預測:
y_pred = regr_model.predict([[0], [1]])
print(y_pred)

# 輸出結果:
[3.00009091 3.50018182]
顯然樣本0的預測值就是直線在y軸上的截距。
二、線性模型能否模擬更複雜的圖形?
可以看出,線性回歸非常直觀且易於實現,同時也過於簡單,只能適用於比較簡單的模型,如果模型稍顯複雜,則不能很好地反映數據的分布。
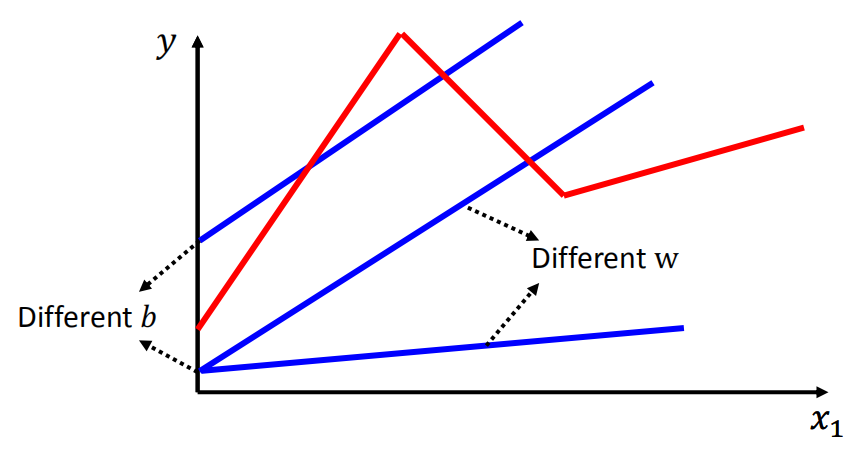
例如在該圖中,紅色線段為我們想要擬合的圖形,藍色線段為我們的線性回歸模型,無論怎樣調整斜率 \(w\) 或截距 \(b\),都無法與紅色較好地匹配。說明在此例中,線性函數模型過於簡單,我們需要一個稍微複雜一些的模型。這裡我們引入一個分段函數作為模型:
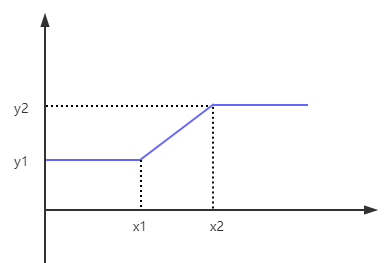
\(H(x) = \begin{cases} y_1, & x < {x_1}; \\ wx + b, & x_1 \le x \le{x_2}; \\ y_2, & x > x_2\\ \end{cases}\)
可以看出,當 \(x < {x_1}\) 或 \(x > x_2\) 時,函數值恆等於一個值,而當 \(x \in [x_1, x_2]\) 時,函數值則是呈線性變化的。該函數影像如下:
所以如果用這個分段函數來模擬上面的紅色線段的話,可以採用下面幾個步驟:
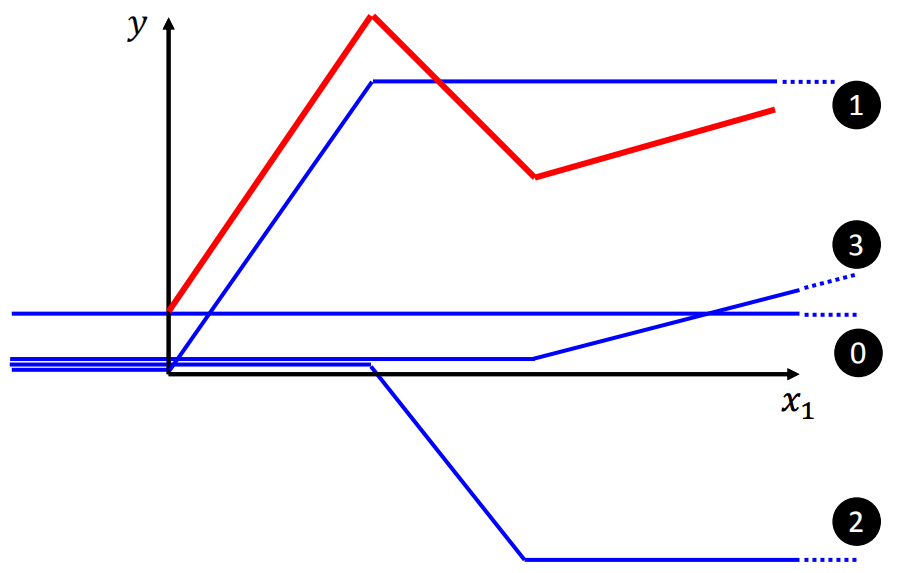
step 0:取常數 \(b\) 作為紅色線段在 \(y\) 軸上的截距;
step 1:令分段函數中間部分的斜率和長度與紅色線段第一部分相同(\(w_1, b_1\));
step 2:令分段函數中間部分的斜率和長度與紅色線段第二部分相同(\(w_2, b_2\));
step 3:令分段函數中間部分的斜率和長度與紅色線段第三部分相同(\(w_3, b_3\))。
所以紅色線段可用幾個不同的藍色線段表示為:
\(y = b + \sum_{i=1}^{3}H(w_i, b_i)\)
問題又來了,這種分段函數看著非常複雜,而且計算不方便,能否再使用一個近似的函數進行替換呢?於是這裡又引入了 \(Sigmoid\) 函數:
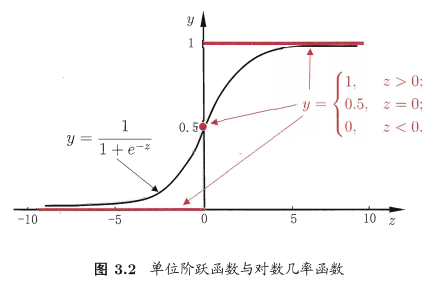
\(Sigmoid\) 函數可以很好的表現上面的藍色線段,而且是非線性的,沒有線性的那麼直(或者說hard),所以也把上面藍色的圖形叫做hard sigmoid。
於是,我們的模型又等價於:
\(y = b + \sum_{i=1}^{n}{c_iSigmoid(w_ix + b_i)}\)
這裡 \(n\) 的大小,取決於我們要模擬多複雜的函數,n越大,意味著要模擬的函數越複雜。
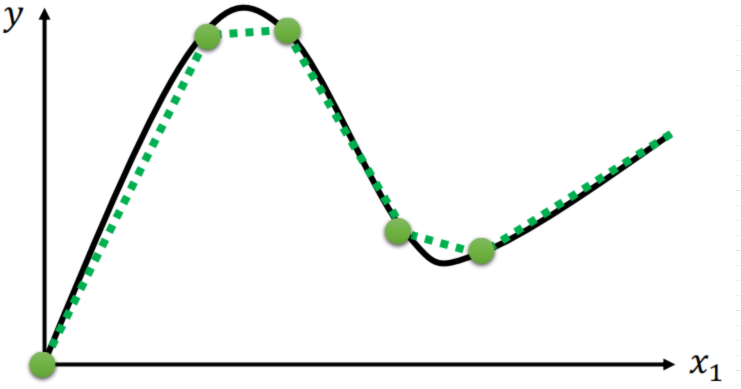
三、理解新模型 - 簡易版神經網路
對於我們的新模型
\(y = b + \sum_{i=1}^{n}{c_iSigmoid(w_ix + b_i)}\)
來說,可以看做是先進行線性計算,然後放入Sigmoid函數計算後,再加上常數b的過程。可用下圖表示:
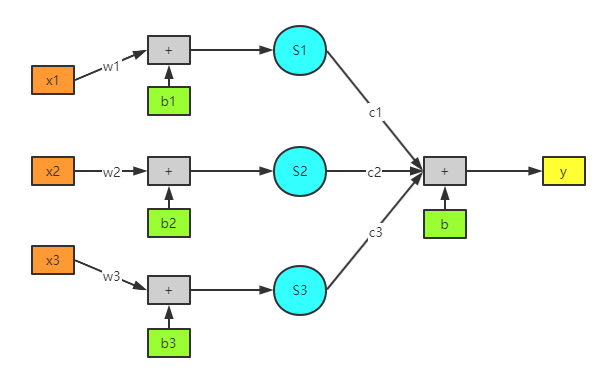
如此一來,原本稍顯繁瑣的公式一下子就顯得直觀了不少。而且整個圖看起來與神經網路非常相似,線性函數 \(wx+b\) 為輸入層,\(Sigmoid\) 可看做隱藏層,加總後的y可看做輸出層。如果讓模型變得更複雜點,就更像了:
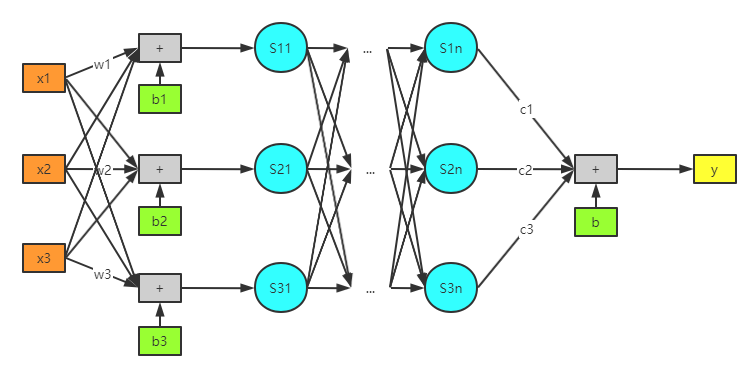
這裡,我們增加了輸入樣本的複雜度(由單一連接變成了全連接),並且增加了多層 \(Sigmoid\) 函數,雖然模型整體更加複雜,但本質上還是沒有變。所以我們完全可以從一個簡單的線性模型過渡到一個複雜的神經網路。
再來看公式,看到這個加總符號 \(\sum\),就說明裡面進行的都是一系列相似的計算,所以用向量替換比較合適。
如果先約定好,統一使用列向量來表示數據,並使用 \(\sigma(x)\) 表示 \(sigmoid\) 函數,則以上數據及參數可表示為:
\( \bm{X} = \begin{pmatrix} x_1\\ x_2\\ x_3\\ \end{pmatrix} \quad \bm{W} = \begin{pmatrix} w_1\\ w_2\\ w_3\\ \end{pmatrix} \quad \bm{b} = \begin{pmatrix} b_1\\ b_2\\ b_3\\ \end{pmatrix} \quad \bm{C} = \begin{pmatrix} c_1\\ c_2\\ c_3\\ \end{pmatrix} \)
然後我們就可以用這些向量來表示模型的公式了:
\(y = b + \bm{C}^T\sigma(\bm{W^T}\bm{X} + \bm{b})\)
使用這種表示方式,不僅顯得更簡潔,而且計算速度也非常快,特別是當樣本非常多的情況下。
四、再次定義誤差函數
我們觀察一下這個式子,其中只有\(\bm{X}\) 和 \(y\) 是已知的(數據集樣本和標籤),其他的參數都是未知的。我們的目標就是使用這個模型進行預測,所以要求出一組參數 \(\{b, \bm{C}, \bm{W^T}, \bm{b}\}\) ,使得模型總體的誤差最小。感覺是不是很熟悉,這不就是之前線性回歸里的套路嗎?所以到了這裡,就自然而然的想到了去求誤差函數 \(L(\theta)\)。
因為模型的原型還是 \(y=ax+b\),所以這裡就繼續使用均方誤差作為損失函數了(如果是邏輯回歸,使用交叉熵會更加合適):
\(L(b, \bm{C}, \bm{W^T}, \bm{b}) = \sum_{i=1}^{n}(y_i - \hat{y_i})^2\)
因為這些參數都是未知的,所以為了方便表示,就用一個參數 \(\theta\) 來統一表示:
\(L(\bm{\theta}) = \sum_{i=1}^{n}(y_i - \hat{y_i})^2 \quad (\bm{\theta} = \begin{pmatrix} b\\ \bm{C}\\ \bm{W^T}\\ \bm{b} \end{pmatrix})\)
接下來又到了求解損失函數 \(L(\bm{\theta})\) 極值的環節了。
五、非線性函數的極值求解 - 梯度下降法
線性函數由於模型簡單,可直接通過令一階導數為0求出最優解。但是 \(Sigmoid\) 函數從影像上就可以看出不是線性函數,直接通過求導計算將變得非常複雜。所以這裡使用一種工程上常用的一種近似方法 — 梯度下降法進行近似求解。
首先要聲明的是,函數必須屬於凸函數,才能使用梯度下降法(有關凸函數的證明,可以參考之前的這篇文章)。凸函數影像是開口向上的,所以總能找到最優解:
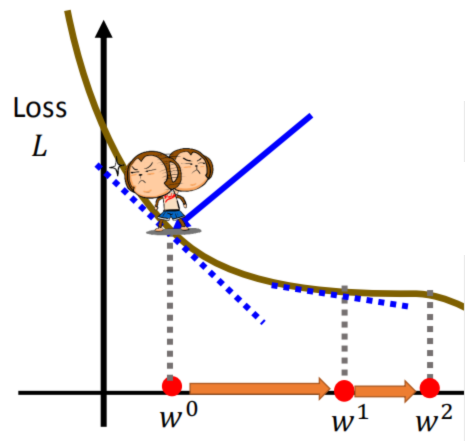
可以稍做想像,有個小人站在這個凸函數的任意一個點上,他的目標是到達這個函數的最低點位置,所以在他每走一步之前,都會先左右環顧,觀察一下當前位置的情況,然後沿下降的方向邁出一步。然後如此循環,直到他找到最低點,或者與最低點的距離足夠近時,才會停止。這裡的關鍵就是小人如何判斷出這個下降的方向呢?
我們都知道,函數在某一點的斜率表示函數在該點函數值的變化情況,所以只要沿著這個斜率方向,並且能使函數值減小的方向移動即可。這個方向叫做梯度方向的反方向。所以通常會有這麼一種說法,沿梯度的相反方向,函數值下降的速度最快。個人認為,梯度只是斜率在多維空間中的升級版,只要理解了斜率的意義,再將其擴展到多維空間即可。
除此之外,還有一個問題,就是這一步跨多大呢?跨的太小,可能會影響效率,遲遲到不了最低點;但是如果跨的太大,又有錯過最低點的風險。如果我們觀察小人的移動軌跡,可以發現,隨著小人的不斷移動,斜率是逐漸變小的,最低點位置的斜率為0。所以我們可以使用梯度進行判斷,如果梯度較大,說明離最低點的位置還較遠,可以跨的大一點;如果梯度較小,說明離最低點可能已經不遠了,需要跨的小一點。所以可使用梯度對參數進行更新:
\(\bm{\theta_1} = \bm{\theta_0} - \nabla L(\bm{\theta_0})\)
其中,\(\nabla L(\theta_0)\) 表示損失函數在 \(\theta_0\) 處的梯度。又因為梯度為函數在該點的一階導數,所以也可以寫為:
\(\bm{\theta_1} = \bm{\theta_0} - \frac{\partial{L(\bm{\theta_0})}}{\partial{\bm{\theta_0}}}\)
為了讓整個過程可控,同時可處理一些極端情況(例如類似倒三角的影像,斜率很大,很有可能錯過最低點),所以在此基礎上加入了超參數 \(\eta\) (就是可人為設置的參數):
\(\bm{\theta_{n+1}} = \bm{\theta_n} - \eta\frac{\partial{L(\bm{\theta_n})}}{\partial{\bm{\theta_n}}}\)
所以,對 \(\bm{\theta}\) 進行足夠多次的更新,就能讓誤差接近最小值,從而得到模型。更新多少次,取決於當前可用的資源。
六、總結
我們從最簡單的線性回歸開始,為了模擬更加複雜的情形,構造了一系列的函數及參數,最終把我們領向了深度學習中的神經網路。至此,我們發現,機器學習有著明顯的「套路」:首先需要找到一個能夠描述數據集的模型;然後再找到一個能夠描述誤差的式子;最後對整個誤差的式子求極值即可。所以,機器學習看起來也不是那麼難,有時候只是缺一個通俗易懂的解釋。
註:本文引用了《李宏毅機器學習》里Lecture 1 里的部分內容,對此感興趣的同學有時間的話還是建議看一看,講得很生動,也很有激情(B站鏈接在此)。