中文NER的那些事兒3. SoftLexicon等辭彙增強詳解&程式碼實現
前兩章我們分別介紹了NER的基準線模型Bert-Bilstm-crf, 以及多任務和對抗學習在解決詞邊界和跨領域遷移的解決方案。這一章我們就辭彙增強這個中文NER的核心問題之一來看看都有哪些解決方案。以下預測結果和程式碼詳見Github-DSXiangLi/ChineseNER
第一章提到過中文NER的普遍使用字元粒度的輸入,從而避免分詞錯誤/分詞粒度和NER粒度不一致限制模型表現的天花板,以及詞輸入OOV的問題。但是字元輸入會有兩個問題
- 缺失了字元在辭彙中的語義表達
- 丟失了詞邊界資訊
有人說不要擔心我們有Bert!可以直接用預訓練語言模型去提取通用的包含上下文的文本資訊,但使用Bert還是幾個問題
- infer速度在部分場景不滿足要求,因此部分場景使用辭彙增強是為了在保證推理延時的前提下,去逼近bert的性能
- Bert在部分垂直領域的表現一般,因此需要領域內的辭彙資訊加持
- Bert的資訊提取更加全局,NER的識別需要局部資訊,因此依舊會存在邊界識別錯誤的問題
辭彙增強的方法主要分為兩種
- Embedding增強:包括softword, Ex-softword, 以及去年的新貴SoftLexicon,它們對模型結構無任何要求只通過引入帶有辭彙/分詞資訊的Embedding達到辭彙增強的目的,更靈活且SoftLexicon的效果拔群
- 特殊模型結構類:Lattice-LSTM出發的各種改良,例如用CNN替換LSTM結構的LR-CNN,改造transformer positional encoding的FLAT等等。
Embedding增強
Softword
最簡單引入詞邊界資訊的方案,就是直接引入分詞B/M/E/S的標籤。這裡我直接用了jieba,當然如果有用目標數據集訓練的Segmentator更好,對句子進行分詞,根據分詞結果對字元分別標註是一個單詞的開始(B),中間(M),結束(E)還是單個字元(S),如下
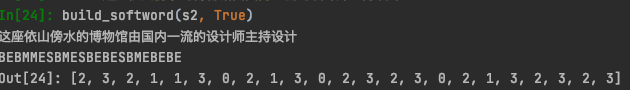
然後在模型輸入側,把分詞的label encoding進行向量表達,用相加或者拼接的方式,加入到已有的token embedding上。
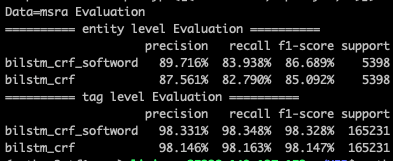
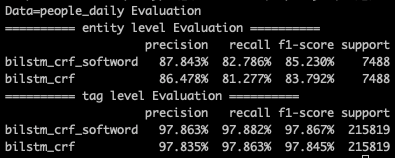
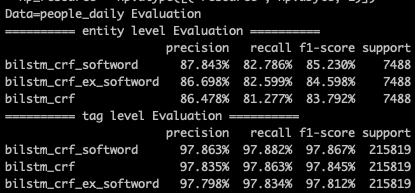
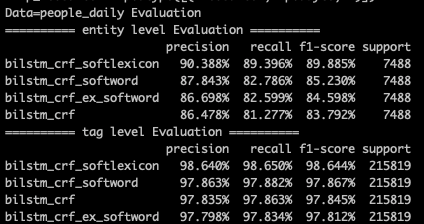
這種方式最簡單粗暴,但問題就是其一B/M/E/S基本只引入了詞邊界資訊,對於詞本身語義資訊的表達有限,其二單一分詞器的會因為自身的準確率以及粒度問題引入噪音。在MSRA/People Daily的數據集上,softword對tag級別的預測基本沒啥增益,但是對entity級別的預測有1個多點左右的提升,對於樣本更小的people daily數據集提升更大。
Ex-softword
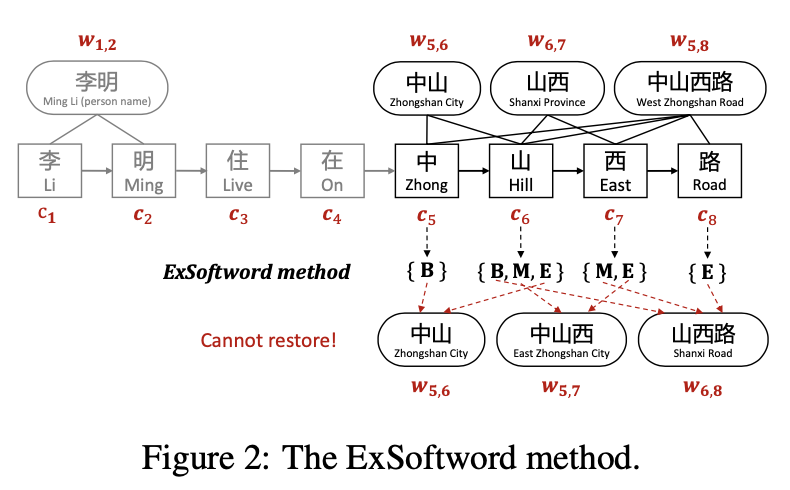
既然softword有單一分詞器的問題,那如果不考慮分詞,直接把該字元在上下文中所有能匹配上辭彙資訊都加入進來會不會更好呢? 如下所示每個字元會遍歷詞表,拿到所有包含這個字且滿足前後文本的所有分詞tag。整個遍歷是O(NK)的複雜度其中N是句子長度,K是最長詞搜索長度我取了10,Exsoftword的結果如下

Ex-softword通過引入更多的分詞資訊,來模糊單一分詞器可能的分詞錯誤問題,不過它並沒有對引入的資訊相關性/重要性進行區分,雖然引入更多資訊,但同時引入了更多噪音,效果相較softword並沒啥提升。
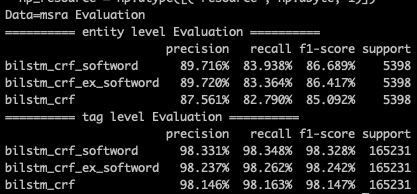
Softlexicon

softlexicon是在Ex-softword的基礎上把只使用B/M/E/S的分詞tag,變成直接使用所有匹配上的單詞。每個字元都得到該字元作為B/M/E/S所能匹配上的所有單詞,這樣在引入詞邊界資訊的同時也引入辭彙本身資訊。
default = {'B' : set(), 'M' : set(), 'E' : set(), 'S' :set()}
soft_lexicon = [deepcopy(default) for i in range(len(sentence))]
for i in range(len(sentence)):
    for j in range(i, min(i+MaxWordLen, len(sentence))):
        word = sentence[i:(j + 1)]
        if word in Vocab2IDX:
            if j-i==0:
                soft_lexicon[i]['S'].add(word)
            elif j-i==1:
                soft_lexicon[i]['B'].add(word)
                soft_lexicon[i+1]['E'].add(word)
            else:
                soft_lexicon[i]['B'].add(word)
                soft_lexicon[j]['E'].add(word)
                for k in range(i+1, j):
                    soft_lexicon[k]['M'].add(word)
    for key, val in soft_lexicon[i].items():
        if not val:
            soft_lexicon[i][key].add(NONE_TOKEN)
以上build_softlexicon會得到以下輸出
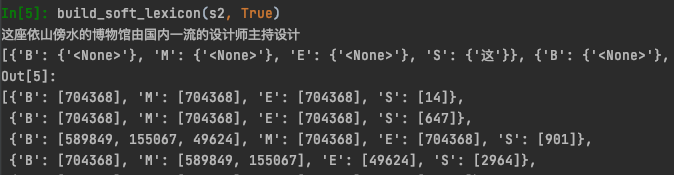
作者嘗試了對匹配上的單詞取對應預訓練Embedding然後對B/M/E/S分別算average embedding再concat在一起,但是效果並不好。這種做法和以上Ex-softword相同,沒有對辭彙的重要性進行區分會引入較多噪音。於是作者是直接在訓練集+驗證集上統計了匹配上的word count \(z(w)\) 作為該詞的embeding權重,在程式碼里我默認使用了預訓練glove的詞頻,畢竟實際標註數據往往較少,直接在訓練集上統計詞頻OOV問題會比較嚴重。
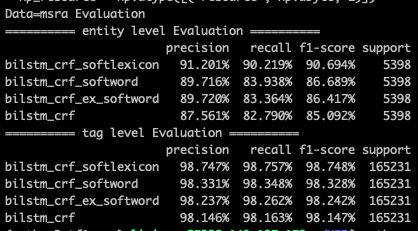
在效果上softLexicon還是比較厲害的,相較bilstm_crf有近6個點的提升【這裡MSRA的樣本split和paper有差異,bilstm_crf就低了3個點左右,不過相對提升和paper中近似】。在paper的樣本劃分中,MSRA數據集上softlexicon的效果只比bert差1個多點,在Weibo/OneNote上要差的多些,畢竟詞頻統計在測試集上的適配程度是訓練集越大好的,不過和以下Lattice增強的各種模型相比表現是不相上下的!
對比我們馬上要聊的Lattice家族,SoftLexicon可以說是簡單粗暴又好使!且因為只比bilstm多了一層O(NK)的詞表匹配,infer speed比bert要快一倍多,比lattice快5倍,可以說是十分優秀了!
Lattice Family
辭彙增強的另一種實現方式就是藉助特殊的模型結構引入詞資訊,這一塊沒有程式碼復現更多只是了解下模型,畢竟結構的限制在使用上沒有上面的Embedding方案靈活。
Lattice-LSTM
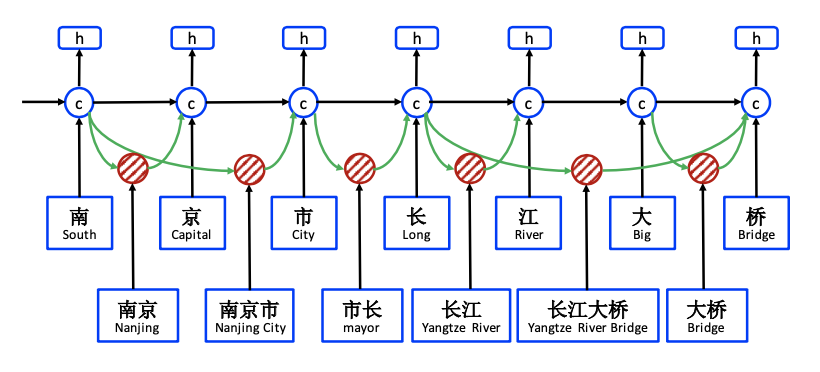
Lattice引入詞資訊的方式是通過加入一條額外詞資訊傳遞路徑,把該路徑的資訊補充到字元路徑的隱藏層,一同計算輸出h。詞資訊的傳遞需要解決兩個問題,其一詞資訊的向前傳遞如何計算,其二一個字元可能對應詞庫中的多個詞,例如'長江大橋'中的橋字,會對應『大橋』,以及長江大橋這兩個詞,也就是會有兩條向前傳遞的資訊,這兩個資訊如何加權。
首先,我們看下詞資訊如何向前傳遞。在上圖南京市的例子中,『市』字可以引入『南京市』這個辭彙資訊,於是會產生一條額外的向前傳遞路徑。作者用下標b,e表示詞的開始位置和結束位置,用上標w,c分別表示辭彙和字元對應的LSTM路徑。於是『市』對應的t-1隱藏層是『南』字字元路徑的輸出層,輸入\(x_{b,e}^w\)是『南京市』這個詞對應的詞向量,輸出的t隱藏層是位置在『市』字的\(c_{b,e}^w\)。如下計算詞路徑的LSTM。輸出gate被省略,因為輸出層只有一個就是字元路徑對應的輸出層,詞路徑只需要隱藏層。

要完成以上計算,需要記錄每個字元所能匹配到的所有單詞(用來取詞embedding),以及每個單詞的長度(用來計算上一個hidden state的位置)因為每個輸入序列的詞位置不同,所以每個序列的LSTM向前傳遞的方式都不同限制了Lattice-LSTM的batch_size只能為1。Ref2是做了優化的支援batch_size>1的類lattice-LSTM實現,感興趣的同學可以自己看下~
其次,一個字元可能對應多個匹配詞,也就是一個\(c_j^c\)可能存在多個以上\(c_{b,j}^w\)。 以下作者引入額外的input gate來衡量不同辭彙路徑隱藏層和當前字元向量的相關性,相關性越高該辭彙路徑權重越高。

辭彙路徑input gate和字元路徑的input gate權重進行歸一化得到\(a_{b,j}^c\)和\(a_j^c\),歸一化保證了多詞/單一/無辭彙匹配的辭彙增強資訊可比。得到辭彙增強的字元隱藏層後,\(o_j^c \cdot tanh(c_j^c)\)得到輸出資訊.
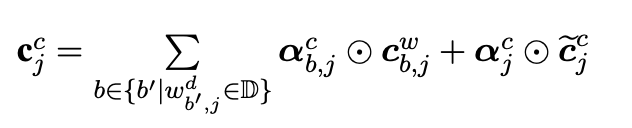
LR-CNN
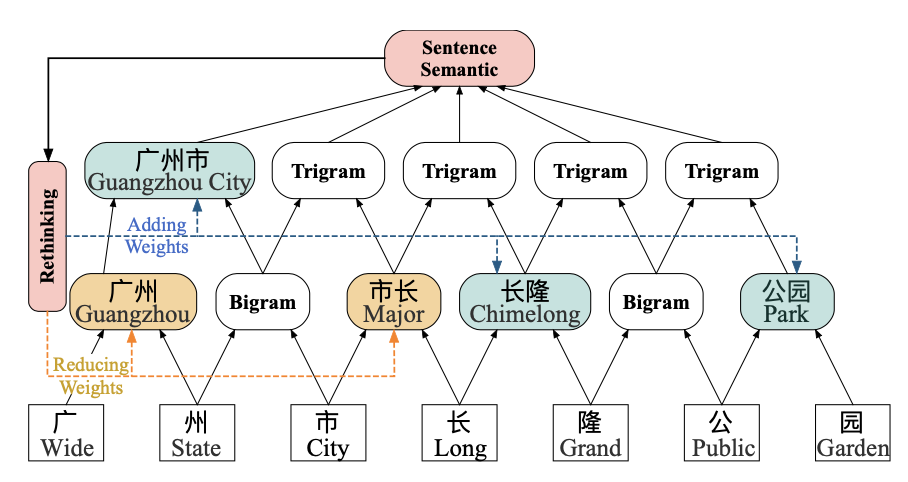
以上Lattice LSTM最明顯的問題就是運行效率,LSTM無法並行已經夠慢了,Lattice還要限制batch_size=1。還有一個問題就是詞向量資訊的權重計算只用到了和字元的相關性,並沒有考慮上下文語義,可能會導致錯誤辭彙的權重過大引入噪音。例如下圖,對『長』字的判斷可能因為錯誤引入『市長』這個錯誤詞資訊而導致無法識別B-GPE這個label。針對這兩個問題我們看下LR-CNN是如何解決的
針對LSTM的運行效率問題,最常見的解法就是用CNN替換LSTM。想讓CNN提取到更長距離的文本資訊,可能會採用stack或者不同window size拼接的CNN cell。這裡作者採用了window_size=2的stack CNN來捕捉n-gram資訊,在MSRA數據集上用了50層,filter=300的模型結構。
辭彙資訊的加入是按照長度分層加入的,長度為2的單詞在第二層加入和CNN提取的bigram特徵加權,長度為3的在第三層加入和trigram加權。以下\(C_m^l\)是基於字元特徵stack CNN在l層m位置輸出的l-gram特徵,\(w_m^l\)是對應m位置l長度的詞embedding特徵,加權方式和Lattice相同,都是用詞向量和當前CNN層n-gram向量的相似度分別計算input_gate \(i_1\)和forget_gate \(f_1\),正則化後加權得到l層m位置的特徵向量。
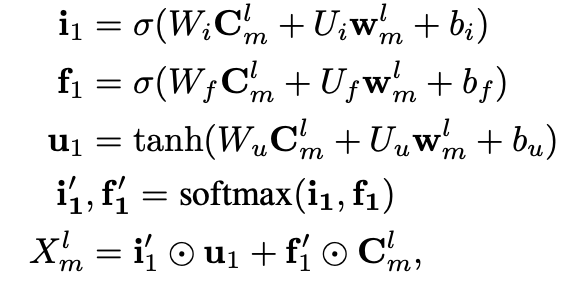
以上向前傳遞的CNN,依舊無法解決辭彙衝突的問題,因為詞向量權重還是用當前的n-gram資訊和詞的相似度計算的。我們需要引入更全局包含上下文的語義特徵來調整詞向量的權重。LR-CNN把stack CNN的top層作為全局語義資訊的表達。以上stack CNN向前傳遞到L層之後,需要用L層的輸出對1~L-1層的特徵輸出進行調整,也就是所謂的Rethinking。調整方式就是在以上的attention計算中加入包含全局資訊的頂層CNN特徵向量\(X_m^L\),計算考慮全局語義的局部辭彙重要性。

以上會得到1~L層每個位置調整後的\(X_m^1,...X_m^L\),然後用Multi-scale Feature Attention對每個位置1~L層的特徵進行加權得到m位置的輸出特徵進入CRF進行解碼預測。簡單解釋下\(s_m^l\),就是l層m位置的Conv Block計算得到的k個filter進行求和得到scaler,把這個scaler作為該位置Conv Block特徵重要性的度量,細節詳見Ref4
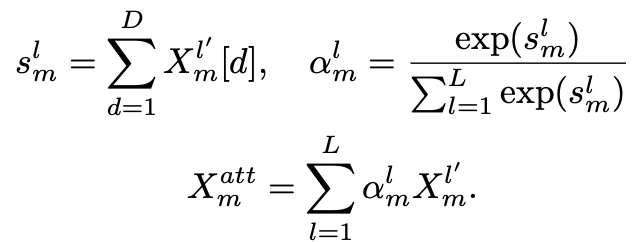
LR-CNN在不損失Lattice-LSTM效果的前提下比Lattice要快3倍左右,不過還是比SoftLexicon慢一倍多。那辭彙增強我們先說這麼多,基於transformer的TENER和FLAT放到後面和玄妙的positional encoding一起再說咯~
Reference
- [Lattice-LSTM]Chinese NER using lattice LSTM, 2018
- [Batch Lattice] An Encoding Strategy Based Word-Character LSTM for Chinese NER
- [LR-CNN]LR-CNN:CNN-Based Chinese NER with Lexicon Rethinking, 2019
- [Mutli-scale Feature Attention]Densely Connected CNN with Multi-scale Feature Attention for Text Classification
- [softword]Unsupervised Segmentatino Helps Supervised Learning of Character Taggering for Word Segmentation and Named Entity Recognition
- [Positional Embedding]Named Entity Recognition for Chinese Social Media with Jointly Trained Embeddings
- [Soft-Lexicon] Simple-Lexicon:Simplify the Usage of Lexicon in Chinese NER
- //zhuanlan.zhihu.com/p/77788495
- //zhuanlan.zhihu.com/p/142615620
- //zhuanlan.zhihu.com/p/166496466
- //www.paperweekly.site/papers/notes/623
