Stanford公開課《編譯原理》學習筆記(1~4課)
- 2019 年 10 月 3 日
- 筆記
目錄
示例程式碼託管在:http://www.github.com/dashnowords/blogs
部落格園地址:《大史住在大前端》原創博文目錄
華為雲社區地址:【你要的前端打怪升級指南】
B站地址:【編譯原理】
Stanford公開課:【Stanford大學公開課官網】
課程里涉及到的內容講的還是很清楚的,但個別地方有點脫節,任何看不懂卡住的地方,請自行查閱經典著作《Compilers——priciples, Techniques and Tools》(也就是大名鼎鼎的龍書)的對應章節。
一. 編譯的基本流程
完整的編譯的5個基本步驟包括lexcical anlysis,parse,sematic,optimize,code generate。課程中並沒有使用複雜的程式語言,而是一種用於課堂教學的自發明語言COOL,很明顯老師為它寫好了編譯器程式。
二. Lexical Analysis(詞法分析階段)
任務:將字元串分解成為[Type, (Value)]元組的形式的詞法單元。
「龍書」里的示例更為直觀,例如表達式語句
E = M * C ** 2進行詞法分析後會得到如下的類似結果:[
id,指向符號表中E的條目的指針][
assign_op][
id,指向符號表中M的條目的指針][
mult_op][
id,指向符號表中C的條目的指針][
exp_op][
number,整數值2]
詞法分析基本需要經歷如下幾個階段:
Lexical Specification——>Regular expressions——>NFA——>DFA——>Table-driven Implementation of DFA
2.1 Lexical Specification(分詞原則)
COOL中的基本Type包括如下幾個類別:
Indentifier標識符-指以字母開頭後續為若干個字母或數字的字元組Integer-指一組非空的數字字元Keyword- 指語言中的關鍵詞,例如if,else等Whitespace- 指一組非空的空格字元或換行符或製表符
很多程式設計語言中的分詞原則基本都會覆蓋關鍵字,運算符,標識符,常量,標點符號,他們也會在後面的實現中被作為終止符集合,課程板書中也提供了COOL分詞原則的類正則形式。

分詞時類型的正則匹配默認為貪婪模式,即匹配更多的字元。詞法單元也具備一定的優先順序次序(通常也是程式碼邏輯的實現順序),例如if從正則上來判斷既符合Keywords也符合Identifier,此時該單元的類型就應該標記為Keywords。這個階段就完成了從Lecical Specification——>Regular expressions的部分。
2.2 Finite Automata (典型分詞演算法-有窮自動機)
FA是一個可以自動識別詞法單元的機器,它是一個狀態轉換圖,「有限」是指它包含的狀態是有限的,一個狀態讀入一個字元後,後繼的狀態可能為:
- 後繼狀態為自身
- 後繼狀態只有一個
- 後繼狀態有多個
如果每次轉換後的後繼狀態都是唯一的,則稱為DFA(確定有限自動機),如果後繼狀態可能有多個則稱為NFA(不確定有限狀態機)。由於DFA的狀態轉移路徑是唯一的,所以作為狀態查詢圖時,無論成功或者失敗只需要運行一次,但NFA就可能需要運行多次。
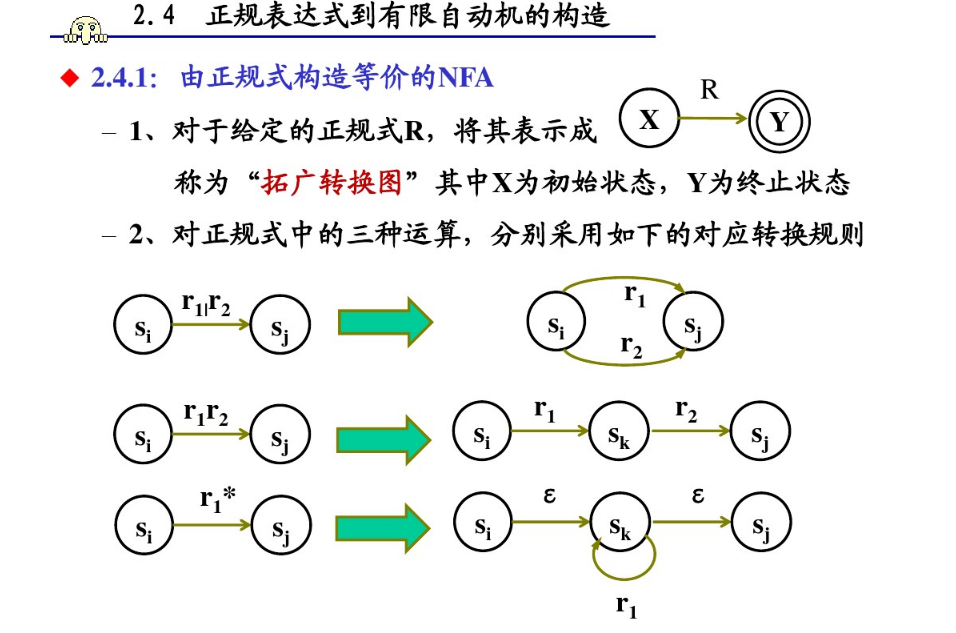
正則表達式是可以轉換為NFA形式的,或許你已經在一些可視化正則表達式的網站上[https://regexper.com ]見過類似的形式。下圖比較清晰地展示了從正則表達式到NFA狀態圖的轉換規則(Regular expressions——>NFA):
如果一個DFA和一個NFA能夠識別的字符集是一致的,則稱它們為等價的,對於任意NFA,一定存在一個DFA與其等價,由NFA構建DFA的過程被稱為DFA的確定化,也就是NFA——>DFA的過程。這個過程是圍繞ε -closure狀態集合的概念展開的,大致的過程就是從起點開始,每次將當前狀態和通過若干次ε轉換(它是一個特殊的狀態轉移函數,表示轉換後的狀態還是當前狀態)作為一個新的ε -closure狀態集合 ,使用矩陣記錄每個ε -closure集合轉換前後的集合,最後對整個狀態轉移矩陣進行標記重命名,就可以得到一個DFA,事實上轉化後的DFA中的每一個狀態,就是NFA中的一個ε -closure集合,你可以將它理解成一個通過分組來簡化表達方式的過程,相關的過程可以參考下面這個文章西北農林科技大學編譯原理課程PPT【詞法分析】,裡面圖比較多,能夠輔助理解,本文不再贅述。
三. 手動實現分詞器
至此1-4課就結束了,估計看影片課程的人也是一臉懵逼,因為課程並沒有講解如何利用DFA得到最終期望的形式——Token元組,那麼最後我們就自己手動來實現一下。
3.1 基本定義
假設我們需要對下面這段程式碼進行分詞解析:
let snippet = ` var b3 = 2; a = 1 + ( b3 + 4); return a; `;那麼先來進行一些基本類型集合定義:
//解析結束標記 const EOF = undefined; //Token Type 可識別的Token類型, const TT = { num: 'num', id: 'id', keywords: 'keywords', //var | return lparen: 'lparen',// ( rparen: 'rparen',// ) semicolon: 'semicolon', //; whitespace: 'whitespace', // n | t | s (空格,製表符,換行符) plus: 'plus', // + assign: 'assign',// = } // 狀態集類型,除開始和結束外,其他可以與Token支援的類型相對應,每次分詞從start狀態開始,接收一個字元後改變狀態,直到在done狀態結束時,可以得到一個token const S = { start: 'start', done: 'done', ...TT }進行工具函數定義:
//判斷是否為關鍵詞(為簡化流程,僅檢測上面示例中包含的關鍵詞) const isKeywords = (token) => ['function', 'return', 'if', 'var'].includes(token); //判斷是否為數字 const isDigit = c => /d/.test(c); //判斷是否為合法的標識符字元 const isValidId = c => /[A-Za-z0-9]/.test(c); //判斷是否為空格 const isBlank = c => /(s|t|n)/.test(c);3.2 構建DFA
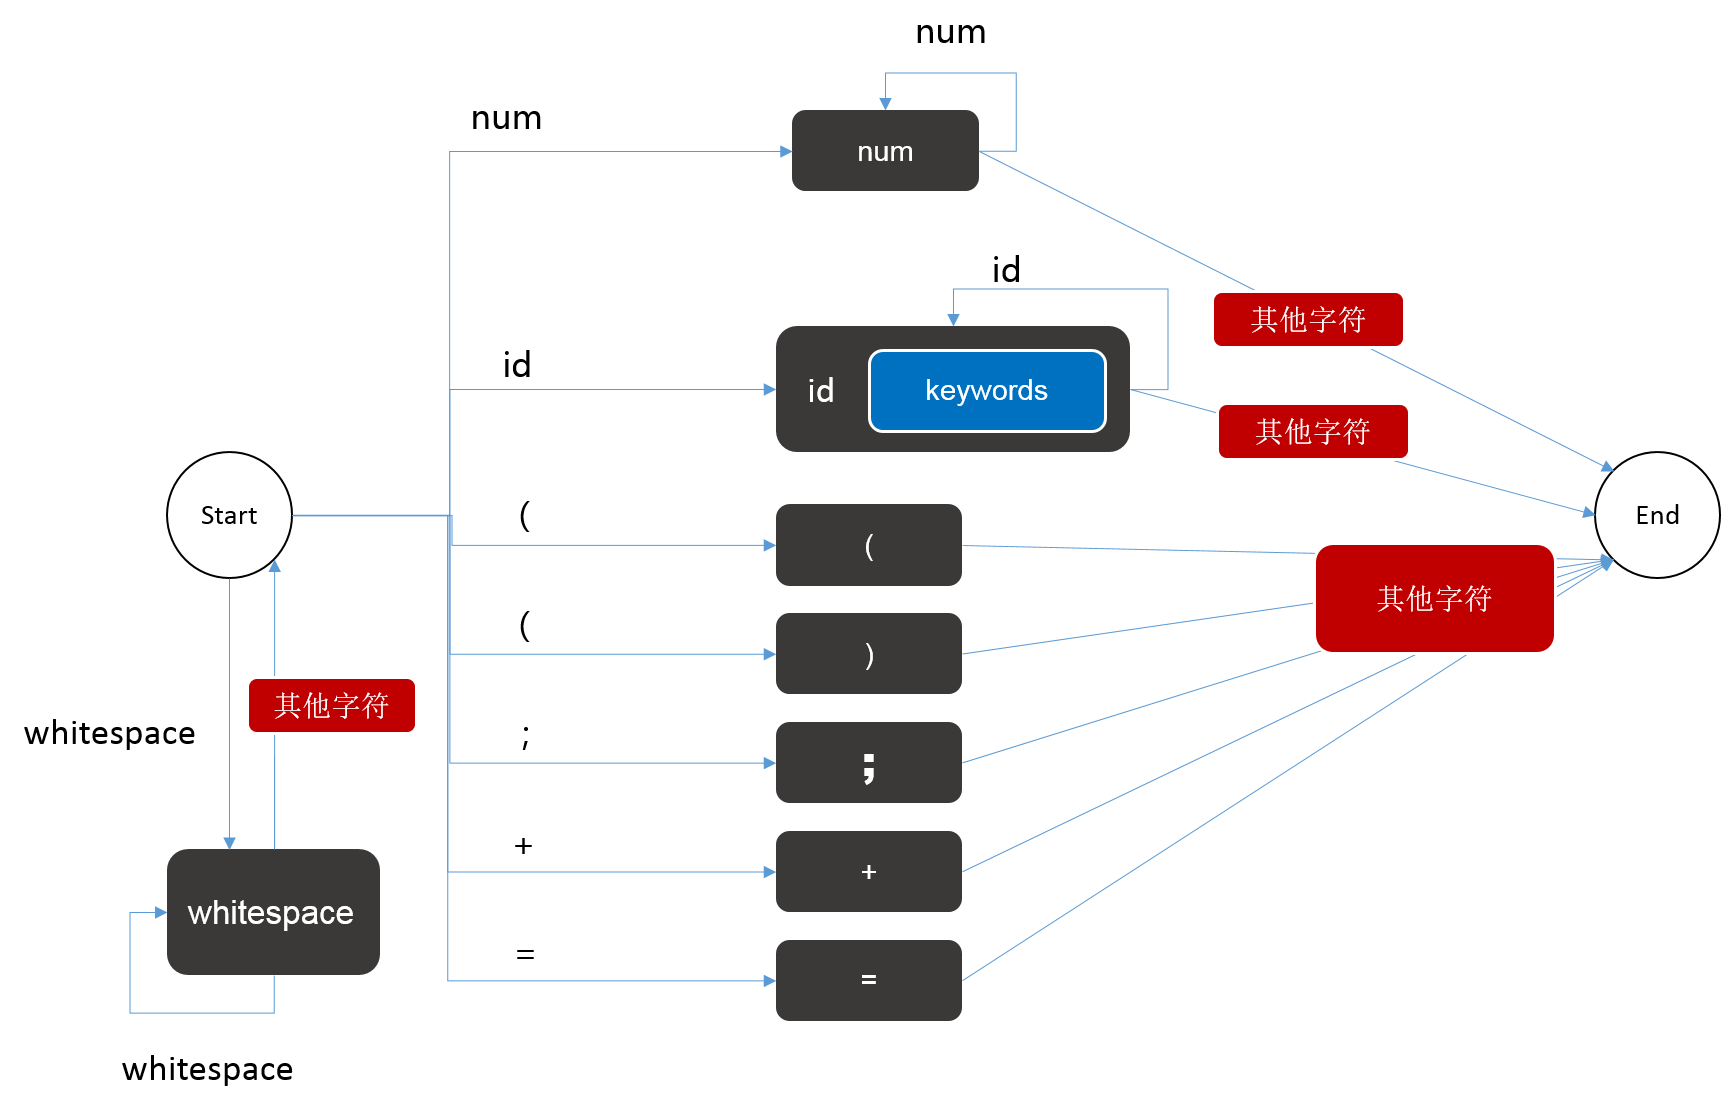
以上面定義的狀態集合和token類別為依據構建DFA:
3.3 開始分詞
分詞的邏輯實際上就是,每次先將狀態置為start,然後讀入一個字元,根據該字元判斷下一個狀態,只要沒有到達完成狀態done就繼續讀入字元,每次到達done狀態時,就可以得到一個token,將其記錄下來,然後重新將狀態置為start,開始尋找下一個token直到分析完整個程式碼段。也就是說DFA狀態機每運行一輪,就得到一個token。參考程式碼如下:
/** * 詞法分析 */ function tokenize(code) { let state = S.start; let currentToken;//標記當前尋找到的token let index = 0;//起始指針,每次分析指向start狀態 let lookup = 0;//前探指針,每次分析最終指向done狀態,start->done之間的字元即為token while (code[lookup] !== EOF) { //如果還有字元 while (state !== S.done) { //開始拆分token //獲取下一個字元 let c = code[lookup++]; //根據當前狀態和下一個字元判斷DFA如何跳轉 switch (state) { case S.start: //開始為空集,實現DFA中各個狀態轉移分支 if (isDigit(c)) { state = S.num; } else if (isValidId(c)) { state = S.id; } else if (isBlank(c)) { state = S.done; } else if (c === '=') { currentToken = [TT.assign, '='] state = S.done; } else if (c === '+') { currentToken = [TT.plus, '+'] state = S.done; } else if (c === ';') { currentToken = [TT.semicolon, ';'] state = S.done; }; break; case S.num: //如果是整數 if (isDigit(c)) { state = S.num; } else { currentToken = [TT.num, code.slice(index,lookup - 1)]; lookup -= 1; //從數字狀態跳出後,最後一位需要參與下一輪分詞,故回退一位 state = S.done; } break; case S.id: //如果是標識符狀態 if (isValidId(c)) { state = S.id; } else { let tempToken = code.slice(index,lookup - 1); lookup -= 1; //從標識符狀態跳出後,最後一位需要參與下一輪分詞,故回退一位 if (isKeywords(tempToken)) { currentToken = [TT.keywords, tempToken]; }else{ currentToken = [TT.id, tempToken]; } state = S.done; } break; } } //state = S.done時跳出 currentToken && console.log(currentToken); currentToken = undefined; //起指針跟上末指針 index = lookup; //開始下一輪分詞 state = S.start; } }3.4 查看分詞結果
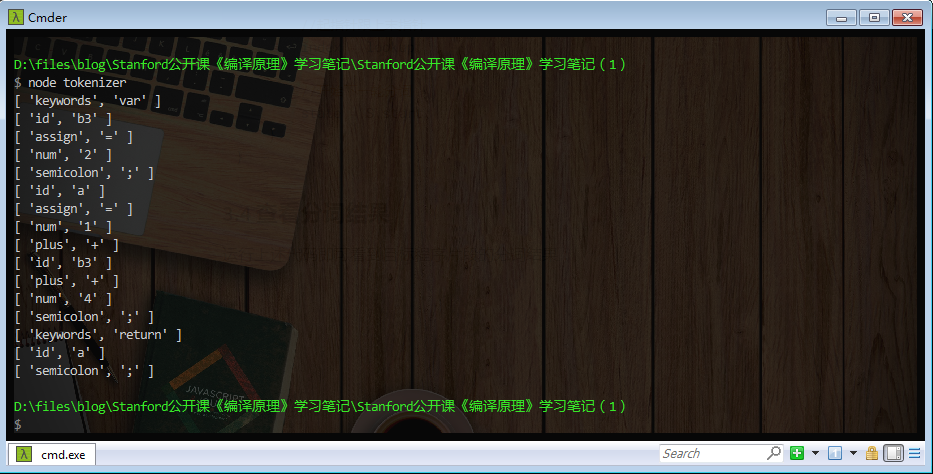
運行上述程式碼即可看到目標程式片段的分詞結果:
四. 小結
至此,我們就得到了元組形式的分詞結果,完成了編譯中第一步lexical analysis的部分,筆者同時提供了一份包含token所在行列資訊的版本,你可以從附件或【我的github倉庫】中拿到示例程式碼,如果覺得對你有幫助,可以在github上為我加個星星哦~