JVM記憶體溢出後服務還能運行嗎
- 2021 年 5 月 21 日
- 筆記
文章開篇問一個問題吧,一個java程式,如果其中一個執行緒發生了OOM,那進程中的其他執行緒還能運行嗎?
接下來做實驗,看看JVM的六種OOM之後程式還能不能訪問。
在這裡我用的是一個springboot程式。
/**
 * @author :charon
 * @date :Created in 2021/5/17 8:30
 * @description : 程式啟動類
 * @version: 1.0
 */
@SpringBootApplication
public class CharonApplication {

    public static void main(String[] args) {
        SpringApplication.run(CharonApplication.class, args);
    }

}
監測服務是否可用(//localhost:8080/checkHealth 測試服務正常可用):
/**
 * @author :charon
 * @date :Created in 2021/5/17 8:49
 * @description : 測試服務是否可用
 * @version: 1.0
 */
@RestController
public class CheckHealthController {

    @RequestMapping("/checkHealth")
    public String stackOverFlowError(){
        System.out.println("調用服務監測介面-----------------------");
        return "服務監測介面返回";
    }
}
1.StackOverflowError(棧溢出)
棧溢出代表的是:當棧的深度超過虛擬機分配給執行緒的棧大小時就會出現error。
/**
 * @author :charon
 * @date :Created in 2021/5/17 8:49
 * @description : 測試java.lang.StackOverflowError: null的錯誤
 * @version: 1.0
 */
@RestController
public class StackOverFlowErrorController {

	/**
	 * 遞歸調用一個方法,使其超過棧的最大深度
	 */
    @RequestMapping("/stackOverFlowError")
    public void stackOverFlowError(){
        stackOverFlowError();
    }
}
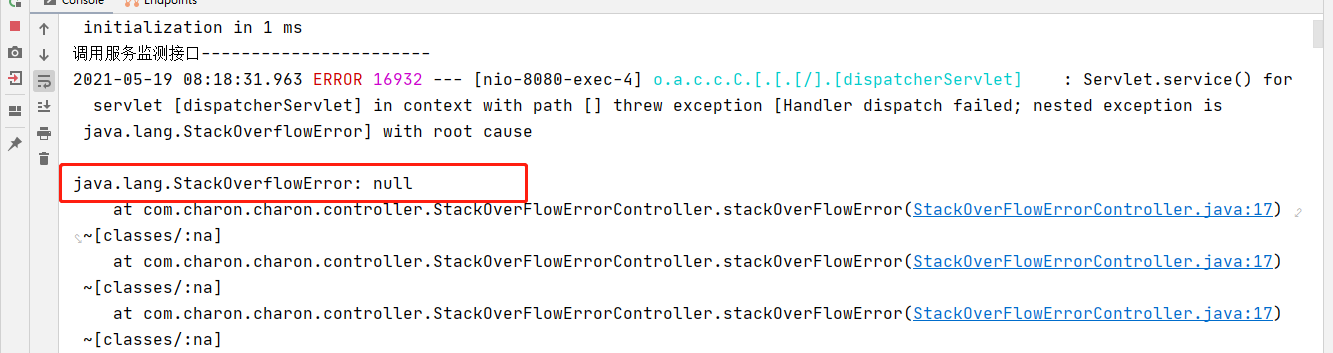
使用瀏覽器調用棧溢出的介面(localhost:8080/stackOverFlowError),發現後台報了棧溢出的錯誤。
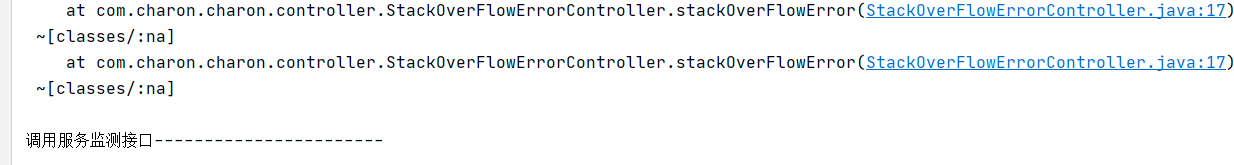
調用監測程式可用的介面,發現還是可以正常訪問。
2.Java heap space(堆記憶體溢出)
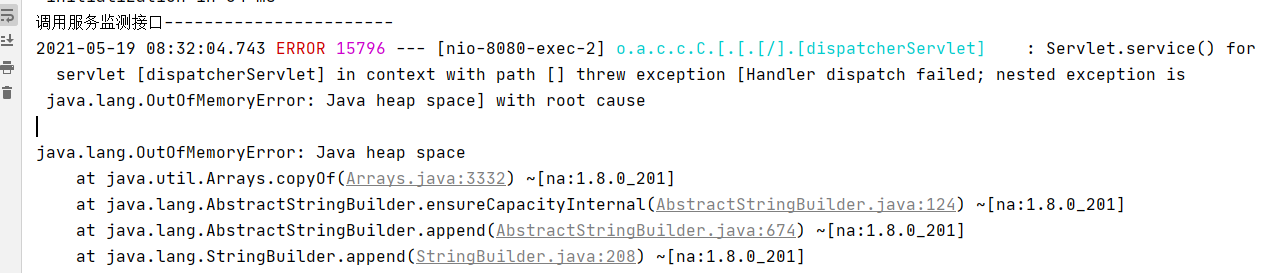
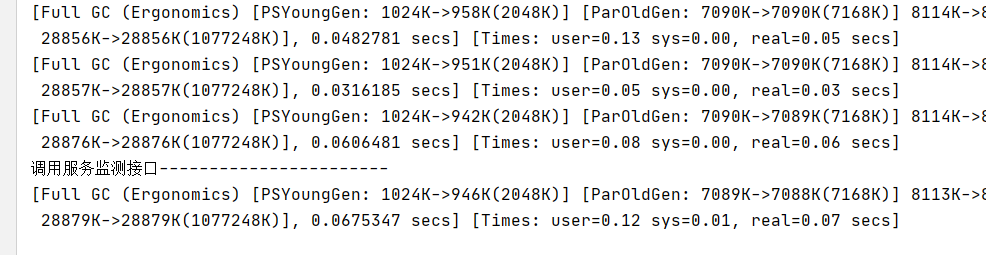
當GC多次的時候新生代和老生代的堆記憶體幾乎用滿了,頻繁觸發Full GC (Ergonomics) ,直到沒有記憶體空間給新生對象了。所以JVM拋出了記憶體溢出錯誤!進而導致程式崩潰。
設置虛擬機參數(-Xms10m -Xmx10m -XX:+PrintGCDetails),如果不設置的話,可能會執行很久。
@RestController
public class JavaHeapSpaceController {

    /**
     * 使用是循環創建對象,是堆記憶體溢出
     */
    @RequestMapping("/javaHeapSpace")
    public void javaHeapSpace(){
        String str = "hello world";
        while (true){
            str += new Random().nextInt(1111111111) + new Random().nextInt(222222222);
            /**
             *  intern()方法:
             * (1)當常量池中不存在這個字元串的引用,將這個對象的引用加入常量池,返回這個對象的引用。
             * (2)當常量池中存在這個字元串的引用,返回這個對象的引用;
             */
            str.intern();
        }
    }
}
調用監測程式可用的介面,發現還是可以正常訪問。
3.direct buffer memory
在寫IO程式(如Netty)的時候,經常使用ByteBuffer來讀取或者寫入數據,這是一種基於通道(channel)和緩衝區(Buffer)的IO方式,他可以使用Native函數庫直接分配對外記憶體,然後通過一個存儲在java堆裡面的DirectByteBuffer對象作為這塊記憶體的引用操作,這樣能在在一些場景中顯著提高性能,因為避免了再java堆和Native堆中來回複製數據。
ByteBuffer.allocate(capacity) 這種方式是分配jvm堆記憶體,屬於GC管轄的範圍,由於需要拷貝所以速度較慢
ByteBuffer.allocateDirect(capacity) 這種方式是分配本地記憶體,不屬於GC的管轄範圍,由於不需要記憶體拷貝,所以速度較快
但是如果不斷分配本地記憶體,堆記憶體很少使用,那麼JVM就不需要執行GC,DirectByteBuffer對象就不會回收,
這時候堆記憶體充足,但本地記憶體可能已經使用光了,再次嘗試分配本地記憶體,就會出現OutOfMemoryError
設置JVM參數: -Xms10m -Xmx10m -XX:+PrintGCDetails -XX:MaxDirectMemorySize=5m
@RestController
public class DirectBufferMemoryController {

    @RequestMapping("/directBufferMemory")
    public void directBufferMemory(){
        System.out.println("初始配置的最大本地記憶體為:"+ (sun.misc.VM.maxDirectMemory()/1024/1024)+"MB");
        // 在jvm參數里設置的最大記憶體為5M,
        ByteBuffer buffer = ByteBuffer.allocateDirect(6*1024*1024);
    }

}
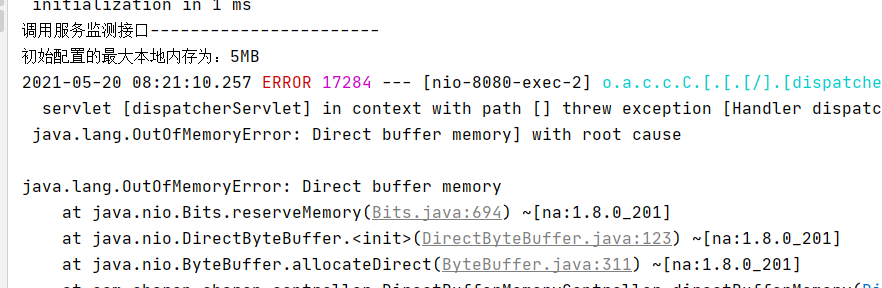
訪問記憶體溢出的介面(//localhost:8080/directBufferMemory),報錯之後再次訪問服務監測介面,發現還是可以繼續訪問的。
4.GC overhead limit exceeded
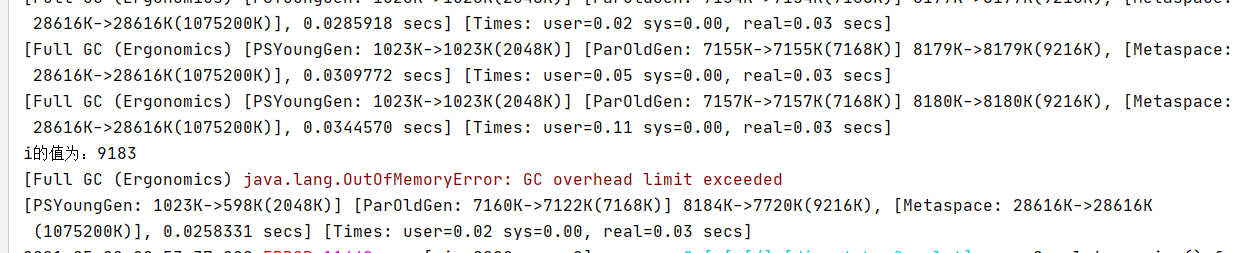
GC回收之間過長會拋出這個錯,過長的定義是:超過98%的時間用來做垃圾回收並且只回收了不到2%的堆記憶體,連續多次GC都只回收了不到2%的極端情況下才會拋出,加入不拋出GC overhead limit錯誤,就會發生下列情況:
- GC清理的這麼點記憶體很快就會再次被填滿,形成惡性循環
- CPU使用率一直是100%,而GC沒有任何效果
設置JVM參數: -Xms10m -Xmx10m -XX:+PrintGCDetails -XX:MaxDirectMemorySize=5m
@RestController
public class GcOverHeadController {

    @RequestMapping("/gcOverHead")
    public void gcOverHead(){
        int i = 0;
        List<String> list = new ArrayList<>();
        try{
            while(true){
                list.add(String.valueOf(++i).intern());
            }
        }catch(Throwable e){
            System.out.println("i的值為:" + i);
            e.printStackTrace();
            throw e;
        }
    }
}
如下圖所示,在報錯這個異常之前,在頻繁的Full GC,但是垃圾回收前後,新生代和老年代的記憶體差不多,就說明,垃圾回收效果不大。
再次訪問服務監測介面,發現還是可以繼續訪問的。
5.Metaspace
java 8及其以後的版本中使用了MetaSpace代替了永久代,它與永久代最大的區別在於:
MetaSpace並不在虛擬機記憶體中,而是使用本地記憶體,也就是說,在java8中,Class metadata被存儲在MetaSpace的native Memory中
MetaSpace中存儲了一下資訊:
- 虛擬機載入的類資訊
- 常量池
- 靜態變數
- 即時編譯後的程式碼
參數設置:-XX:+PrintGCDetails -XX:MetaspaceSize=50m -XX:MaxMetaspaceSize=50m
@RestController
public class MetaSpaceController {

    static class OomTest{

    }

    /**
     * 模擬MetaSpace溢出,不斷生成類往元空間放,類佔據的空間會超過MetaSpace指定的大小
     */
    @RequestMapping("/metaSpace")
    public void metaSpace(){
        int i = 0;
        try{
            while (true){
                i++;
                /**
                 * Enhancer允許為非介面類型創建一個java代理。Enhancer動態創建了給定類型的子類但是攔截了所有的方法,
                 * 和proxy不一樣的是:不管是介面還是類它都能正常工作。
                 */
                Enhancer enhancer = new Enhancer();
                enhancer.setSuperclass(OomTest.class);
                enhancer.setUseCache(false);
                enhancer.setCallback(new MethodInterceptor() {
                    @Override
                    public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable {
                        return methodProxy.invokeSuper(o,objects);
                    }
                });
                enhancer.create();
            }
        }catch (Throwable e){
            System.out.println("i的值為:" + i);
            e.printStackTrace();
        }
    }
}
我記得之前看過一篇公眾號的文章,就是使用Fastjson創建的代理類導致的Metaspace的問題,具體地址我也忘記了。。。。。
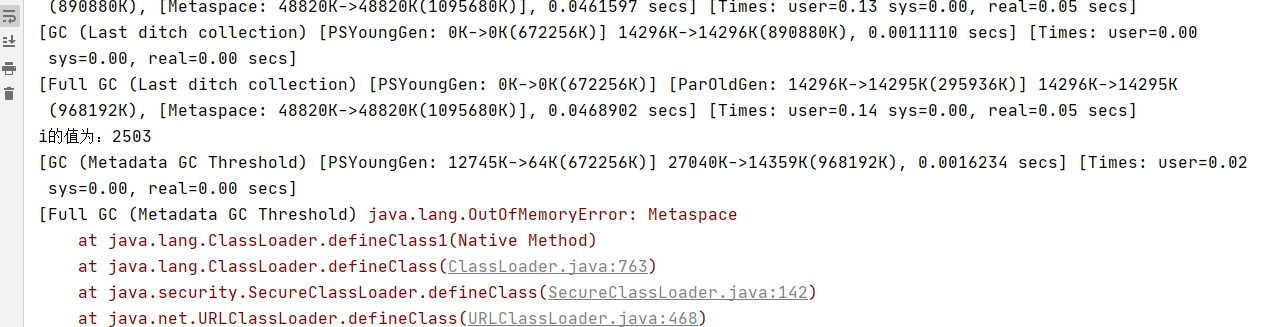
再次訪問服務監測介面,發現還是可以繼續訪問的。
6.unable to create new thread
在高並發服務時,經常會出現如下錯誤,
導致原因:
- 1.應用程式創建了太多的執行緒,一個應用進程創建的執行緒超過了系統承載極限
- 2.伺服器不允許應用程式創建這麼多執行緒,linux系統默認允許單個進程可以創建的執行緒數為1024個(如果是普通用戶小於這個值)
解決辦法:
- 1.降低應用程式創建執行緒的數量,分析應用是否真的需要創建這麼多執行緒
- 2.對於有的應用確實需要創建這麼多的執行緒,可以修改linux伺服器配置,擴大linux的默認限制
查看:ulimit -u
修改:vim /etc/security/limits.d/90-nproc.conf
@RestController
public class UnableCreateThreadController {
	/**
     * 友情提示:千萬別在windows中運行這段程式碼,如果不小心和我一樣試了,那就只能強制重啟了
     */
    @RequestMapping("/unableCreateThread")
    public void unableCreateThread(){
        for (int i = 0; ; i++) {
            System.out.println("i的值為:" + i);
            new Thread(()->{
               try{
                   Thread.sleep(1000*1000);
               } catch (InterruptedException e){
                   e.printStackTrace();
               }
            }).start();
        }
    }
}
我這裡是使用的root用戶測試的,創建了7409個執行緒。大家測試的時候最好是使用普通用戶測試。
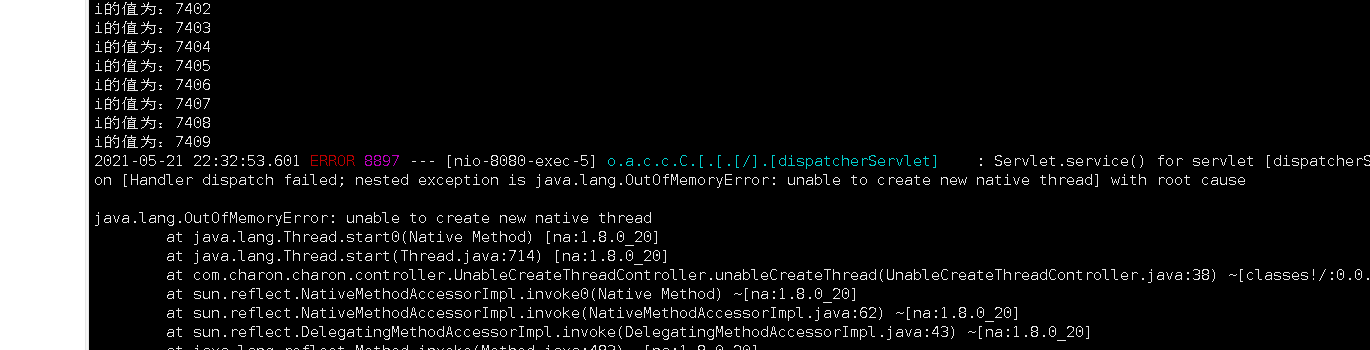
最後執行檢測服務的介面,發現程式還是可以繼續訪問的。
小結
其實發生OOM的執行緒一般情況下會死亡,也就是會被終結掉,該執行緒持有的對象佔用的heap都會被gc了,釋放記憶體。因為發生OOM之前要進行gc,就算其他執行緒能夠正常工作,也會因為頻繁gc產生較大的影響。