MySQL分頁優化_別再用offset和limit分頁了
- 2021 年 5 月 8 日
- 筆記
終於要對MySQL優化下手了,本文將對分頁進行優化說明,希望可以得到一個合適你的方案。
開始之前,先分享一套MySQL教程👇,小白入門或者學習鞏固都可以看👇
MySQL基礎入門-mysql教程-資料庫實戰(MySQL基礎+MySQL高級+MySQL優化+MySQL34道作業題)_嗶哩嗶哩 (゜-゜)つロ 乾杯~-bilibili
分頁這個話題已經是老生常談了,但是有多少小夥伴一邊是既希望優化的自己的系統,另一邊在項目上還是保持自己獨有的個性。
優化這件事是需要自己主動行動起來的,自己搞測試數據,只有在測試的路上才會發現更多你未知的事情。
本文小編也會針對分頁優化這個話題進行解讀。
一、表結構
這個資料庫結構就是小編目前線上項目的表,只不過將欄位名改了而已,還有將時間欄位取消了。
資料庫結構如下
1 CREATE TABLE `tp_statistics` (
2 `ss_id` int(11) NOT NULL AUTO_INCREMENT,
3 `ss_field1` decimal(11,2) NOT NULL DEFAULT '0.00',
4 `ss_field2` decimal(11,2) NOT NULL DEFAULT '0.00',
5 `ss_field3` decimal(11,2) NOT NULL DEFAULT '0.00',
6 PRIMARY KEY (`ss_id`)
7 ) ENGINE=InnoDB AUTO_INCREMENT=3499994 DEFAULT CHARSET=utf8 COLLATE=utf8mb4_general_ci ROW_FORMAT=COMPACT;
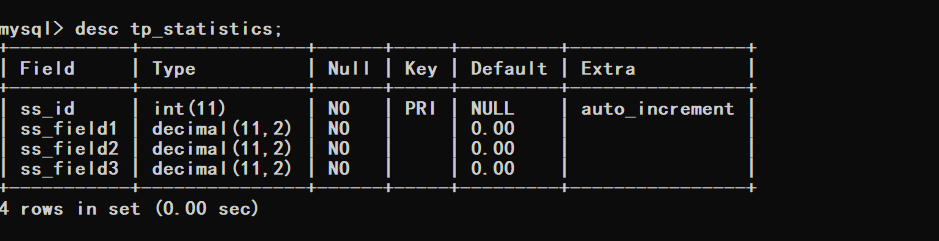
根據以上資訊可以看到目前表裡邊的數據有350萬記錄,接下來就針對這350W條記錄進行查詢優化。
二、初探查詢效率
先來寫一個查詢的SQL語句,先看一下查詢耗費的時間。
根據下圖可以看到查詢時間基本忽略不計,但是要注意的是limit的偏移量值。

於是我們要一步一步的加大這個偏移量然後進行測試,先將偏移量改為10000
可以看到查詢時間還是非常理想的。
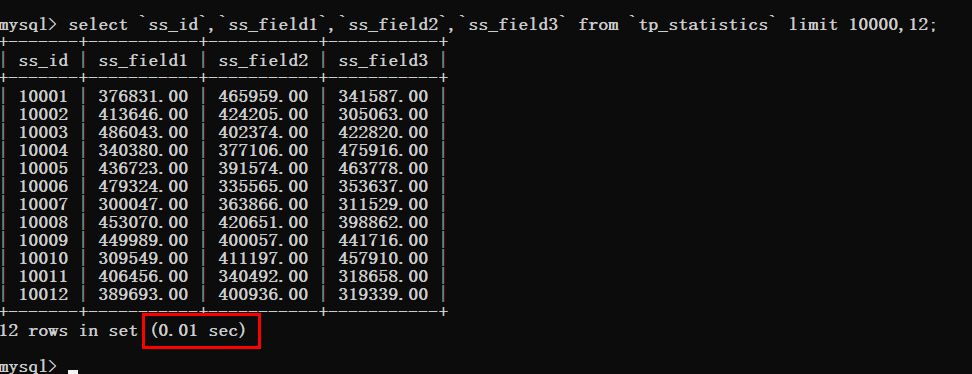
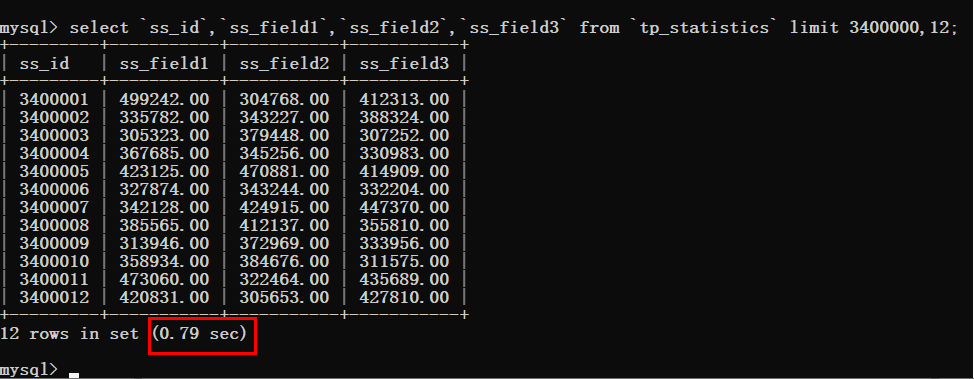
為了節省時間咔咔將這個偏移量的值直接調整到340W。
這個時候就可以看到非常明顯的變化了,查詢時間猛增到了0.79s。
出現了這樣的情況,那肯定就需要進行優化了,拿起鍵盤就是干。
三、分析查詢耗時的原因
提到分析SQL語句,必備的知識點就是explain,如果對這個工具不會使用的可以去看看MySQL的基礎部分。
根據下圖可以看到三條查詢語句都進行了表掃描。

都知道只要有關於分頁就必存在排序,那麼加一個排序再來看一下查詢效率。
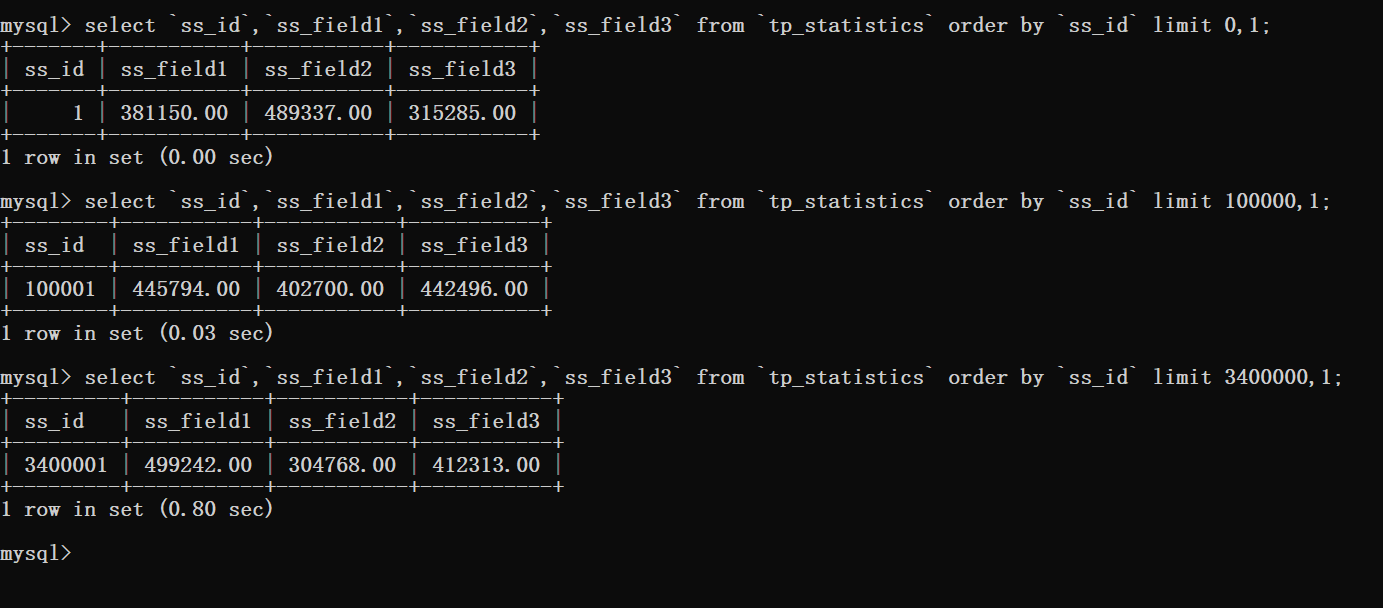
然後在進行對排序的語句進行分析查看。
通過這裡看到當使用了排序時資料庫掃描的行數就是偏移量加上需要查詢的數量。
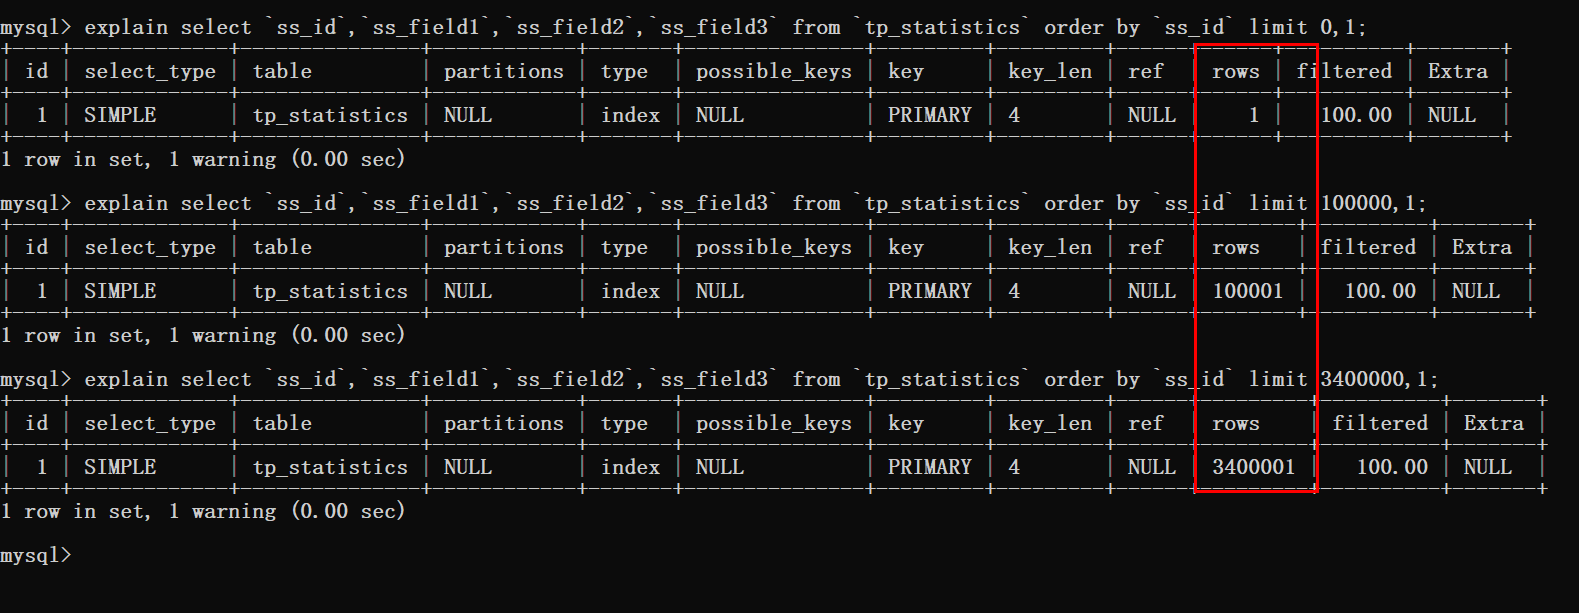
此時就可以知道的是,在偏移量非常大的時候,就像上圖案例中的limit 3400000,12這樣的查詢。
此時MySQL就需要查詢3400012行數據,然後在返回最後12條數據。
前邊查詢的340W數據都將被拋棄,這樣的執行結果可不是我們想要的。
小編之前看到相關文章說是解決這個問題的方案,要麼直接限制分頁的數量,要麼就優化當偏移量非常大的時候的性能。
如果你都把本文看到了這裡,那怎麼會讓你失望,肯定是優化大偏移量的性能問題。
四、優化
既然提到了優化,無非就那麼倆點,加索引,使用其它的方案來代替這個方案。
小編提供的這條數據表結構資訊,完全可以理解為就是圖書館的借閱記錄,欄位的什麼都不要去關心就可以了。
對於排序來說,在這種場景下是不會給時間加排序的,而是給主鍵加排序,並且由於添加測試數據的原因將時間欄位給取消了。
接下來使用覆蓋索引加inner join的方式來進行優化。
1 select ss_id,ss_field1,ss_field2,ss_field3 from tp_statistics inner join ( select ss_id from tp_statistics order by ss_id limit 3000000,10) b using (ss_id);
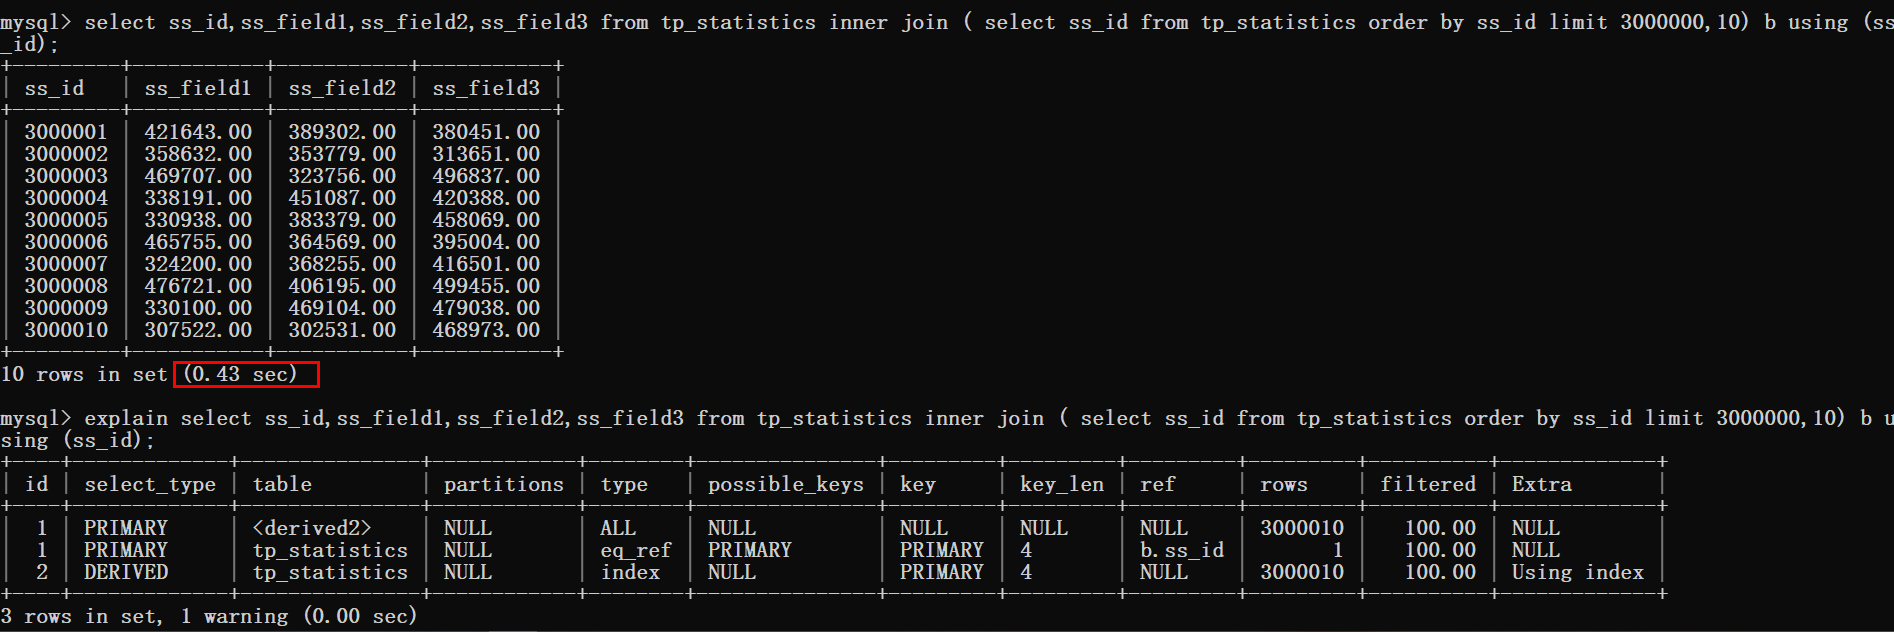
從上圖可以看到查詢時間從0.8s優化到了0.4s,但是這樣的效果還是不盡人意。
於是只能更換一下思路再進行優化。
既然優化最大偏移量這條路有點坎坷,能不能從其它方面進行入手。
估計有很多同學已經知道咔咔將要拋出什麼話題了。
沒錯,就是使用where > id 然後使用limit。
先來測試一波結果,在寫具體實現方案。
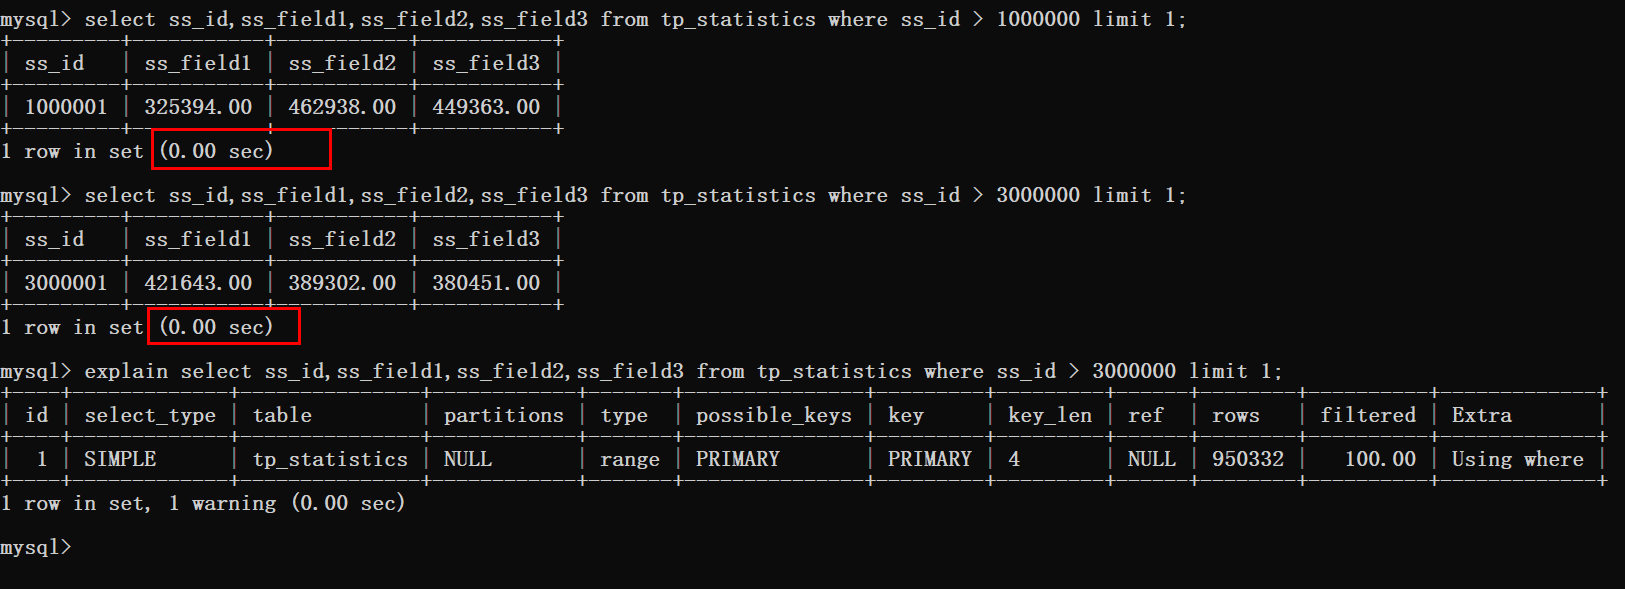
根據上圖可以看到這種方式是十分可行的,分頁在300W條數據以後的查詢時間也基本忽略不計。
那麼這種方案要怎麼實現呢!
五、方案落地
其實這個方案真的很簡單,只需要簡單的轉換一下思路即可。

當客戶端第一次獲取數據的時候就正常傳遞offset、limit倆個參數。
首次返回的數據就使用客戶端傳遞過來的offset、limit進行獲取。
當第一次的數據返回成功後。
客戶端第二次拉取數據時這個時候參數就發生改變了,就不能再是offset、limit了。
此時應該傳遞的參數就是第一次獲取的數據最後一條數據的id。
此時的參數就為last_id、limit。
後台獲取到last_id後就可以在sql語句中使用where條件 < last_id
咔咔這裡給的情況是數據在倒敘的情況下,如果正序就是大於last_id即可。
接下來咔咔使用一個案例給大家直接明了的說明。
實戰案例
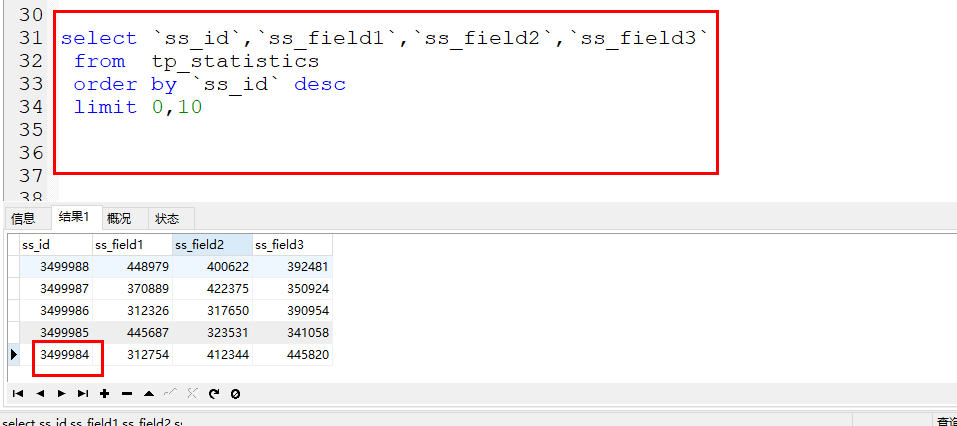
如下就是將要實戰演示的案例,例如首次使用page、limit獲取到了數據。
返回結果的最後一條數據的id就是3499984
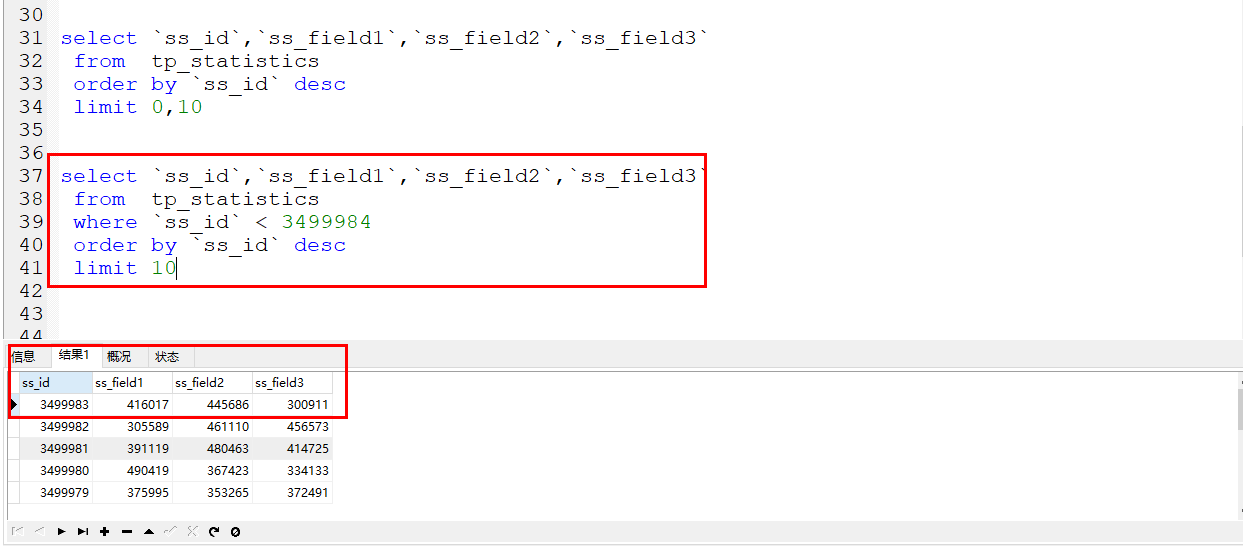
此時如果在獲取第二條記錄就不是使用offset、limit了,就是傳遞last_id和limit了。
如下圖
此時就是使用的where條件來進行直接過濾數據,條件就是id小於上次數據的最後一條id即可。
時間對比
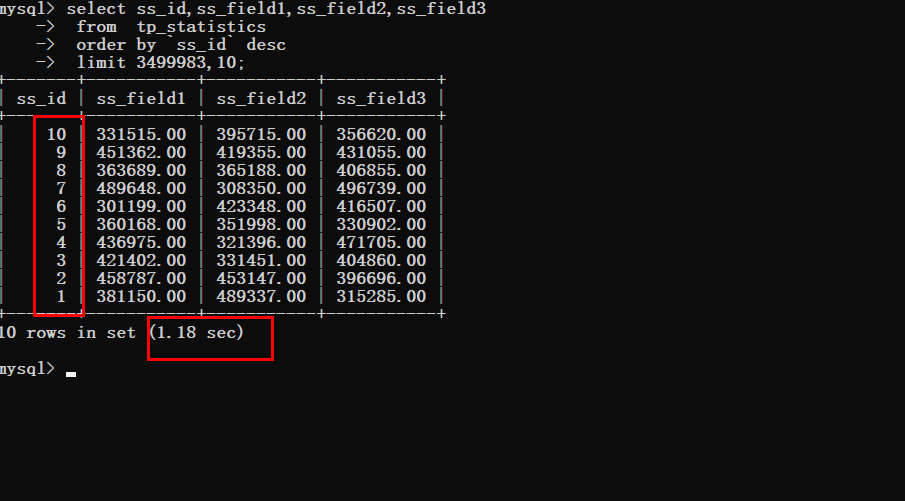
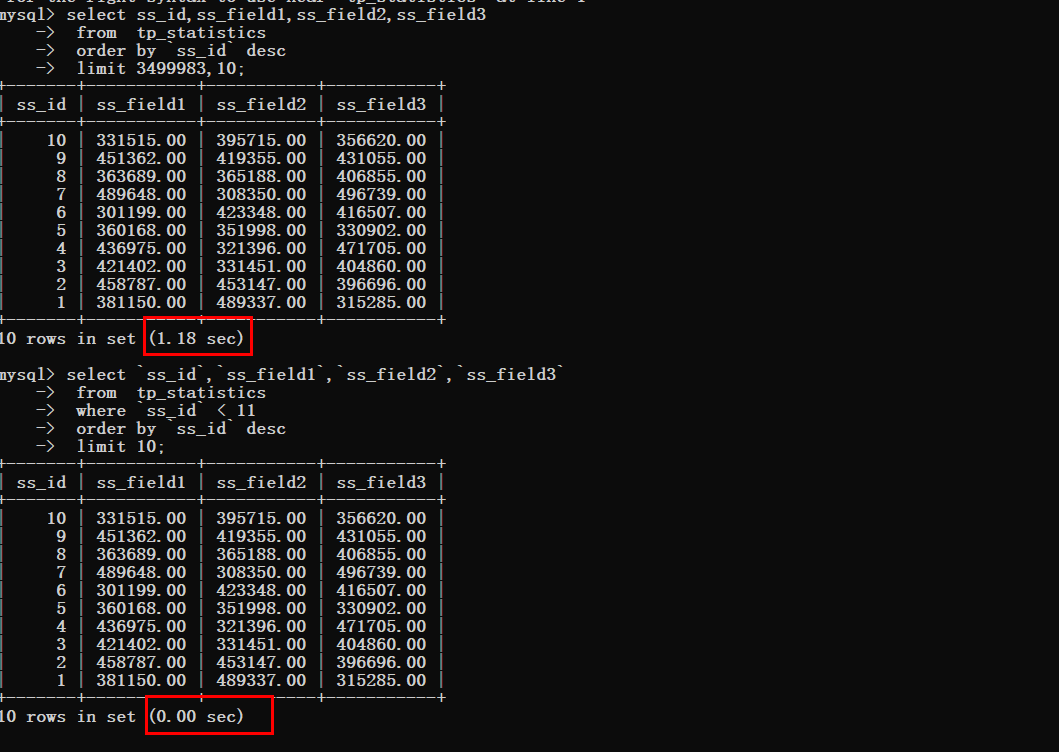
假設現在要獲取最後一條數據
沒有優化之前
優化之後可以明顯的看到查詢時間的變化
六、總結
關於limit優化簡單幾句話概述一下。
數據量大的時候不能使用offset、limit來進行分頁,因為offset越大,查詢時間越久。
當然不能說所有的分頁都不可以,如果你的數據就那麼幾千、幾萬條,那就很無所謂,隨便使用。
落地方案就是上邊的方案,首次使用offset、limit獲取數據,第二次獲取數據使用where條件到第一次數據最後一條id即可。
————————————————

