一文讀懂什麼是進程、執行緒、協程
- 2019 年 10 月 3 日
- 筆記
進程
我們都知道電腦的核心是CPU,它承擔了所有的計算任務;而作業系統是電腦的管理者,它負責任務的調度、資源的分配和管理,統領整個電腦硬體;應用程式則是具有某種功能的程式,程式是運行於作業系統之上的。
進程是一個具有一定獨立功能的程式在一個數據集上的一次動態執行的過程,是作業系統進行資源分配和調度的一個獨立單位,是應用程式運行的載體。進程是一種抽象的概念,從來沒有統一的標準定義。
進程一般由程式、數據集合和進程式控制制塊三部分組成。
- 程式用於描述進程要完成的功能,是控制進程執行的指令集;
- 數據集合是程式在執行時所需要的數據和工作區;
- 程式控制塊(Program Control Block,簡稱PCB),包含進程的描述資訊和控制資訊,是進程存在的唯一標誌。
進程具有的特徵:
- 動態性:進程是程式的一次執行過程,是臨時的,有生命期的,是動態產生,動態消亡的;
- 並發性:任何進程都可以同其他進程一起並發執行;
- 獨立性:進程是系統進行資源分配和調度的一個獨立單位;
- 結構性:進程由程式、數據和進程式控制制塊三部分組成。
執行緒
在早期的作業系統中並沒有執行緒的概念,進程是能擁有資源和獨立運行的最小單位,也是程式執行的最小單位。任務調度採用的是時間片輪轉的搶佔式調度方式,而進程是任務調度的最小單位,每個進程有各自獨立的一塊記憶體,使得各個進程之間記憶體地址相互隔離。
後來,隨著電腦的發展,對CPU的要求越來越高,進程之間的切換開銷較大,已經無法滿足越來越複雜的程式的要求了。於是就發明了執行緒。
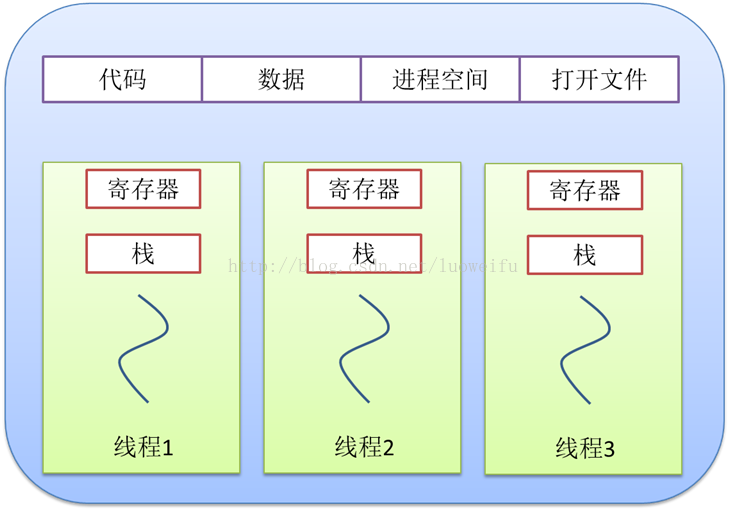
執行緒是程式執行中一個單一的順序控制流程,是程式執行流的最小單元,是處理器調度和分派的基本單位。一個進程可以有一個或多個執行緒,各個執行緒之間共享程式的記憶體空間(也就是所在進程的記憶體空間)。一個標準的執行緒由執行緒ID、當前指令指針(PC)、暫存器和堆棧組成。而進程由記憶體空間(程式碼、數據、進程空間、打開的文件)和一個或多個執行緒組成。
(讀到這裡可能有的讀者迷糊,感覺這和Java的記憶體空間模型不太一樣,但如果你深入的讀過深入理解Java虛擬機這本書的話你就會恍然大悟)
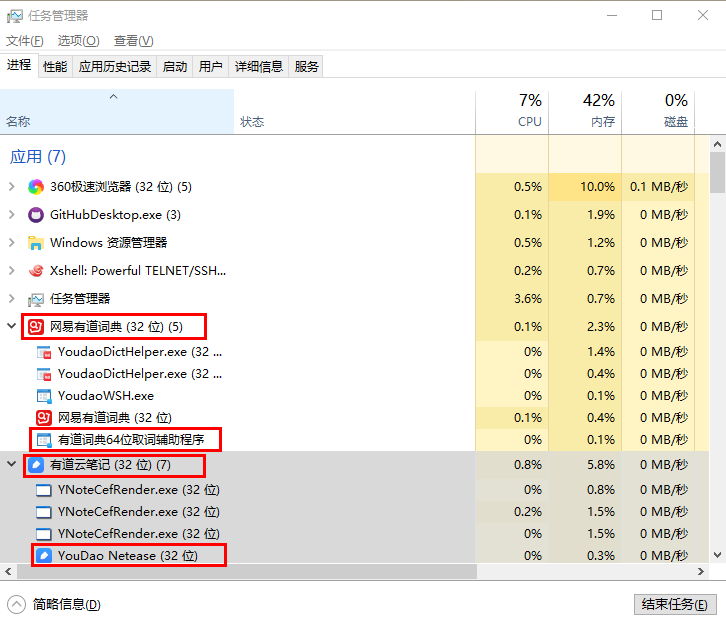
如上圖,在任務管理器的進程一欄里,有道詞典和有道雲筆記就是進程,而在進程下又有著多個執行不同任務的執行緒。
任務調度
執行緒是什麼?要理解這個概念,需要先了解一下作業系統的一些相關概念。大部分作業系統(如Windows、Linux)的任務調度是採用時間片輪轉的搶佔式調度方式。
在一個進程中,當一個執行緒任務執行幾毫秒後,會由作業系統的內核(負責管理各個任務)進行調度,通過硬體的計數器中斷處理器,讓該執行緒強制暫停並將該執行緒的暫存器放入記憶體中,通過查看執行緒列表決定接下來執行哪一個執行緒,並從記憶體中恢復該執行緒的暫存器,最後恢復該執行緒的執行,從而去執行下一個任務。
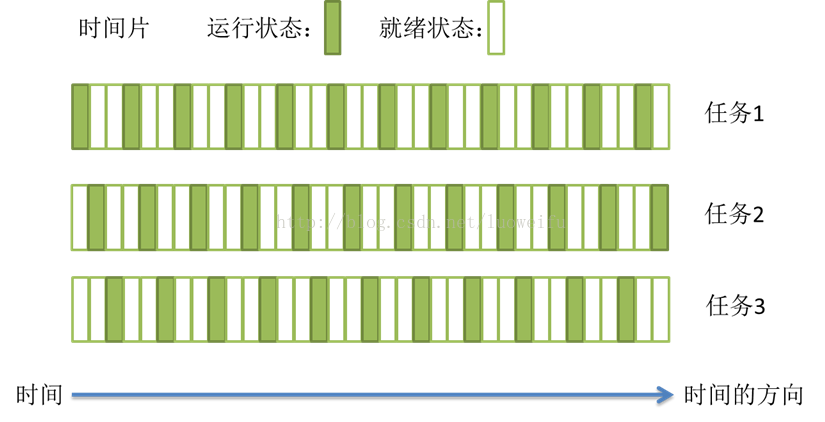
上述過程中,任務執行的那一小段時間叫做時間片,任務正在執行時的狀態叫運行狀態,被暫停的執行緒任務狀態叫做就緒狀態,意為等待下一個屬於它的時間片的到來。
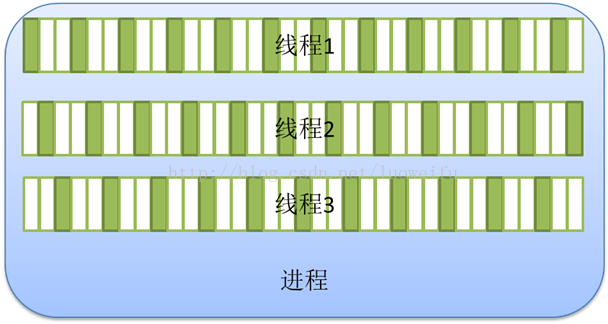
這種方式保證了每個執行緒輪流執行,由於CPU的執行效率非常高,時間片非常短,在各個任務之間快速地切換,給人的感覺就是多個任務在「同時進行」,這也就是我們所說的並發(別覺得並發有多高深,它的實現很複雜,但它的概念很簡單,就是一句話:多個任務同時執行)。多任務運行過程的示意圖如下:
進程與執行緒的區別
前面講了進程與執行緒,但可能你還覺得迷糊,感覺他們很類似。的確,進程與執行緒有著千絲萬縷的關係,下面就讓我們一起來理一理:
- 執行緒是程式執行的最小單位,而進程是作業系統分配資源的最小單位;
- 一個進程由一個或多個執行緒組成,執行緒是一個進程中程式碼的不同執行路線;
- 進程之間相互獨立,但同一進程下的各個執行緒之間共享程式的記憶體空間(包括程式碼段、數據集、堆等)及一些進程級的資源(如打開文件和訊號),某進程內的執行緒在其它進程不可見;
- 調度和切換:執行緒上下文切換比進程上下文切換要快得多。
執行緒與進程關係的示意圖:
總之,執行緒和進程都是一種抽象的概念,執行緒是一種比進程更小的抽象,執行緒和進程都可用於實現並發。
在早期的作業系統中並沒有執行緒的概念,進程是能擁有資源和獨立運行的最小單位,也是程式執行的最小單位。它相當於一個進程里只有一個執行緒,進程本身就是執行緒。所以執行緒有時被稱為輕量級進程(Lightweight Process,LWP)。
後來,隨著電腦的發展,對多個任務之間上下文切換的效率要求越來越高,就抽象出一個更小的概念——執行緒,一般一個進程會有多個(也可是一個)執行緒。
多執行緒與多核
上面提到的時間片輪轉的調度方式說一個任務執行一小段時間後強制暫停去執行下一個任務,每個任務輪流執行。很多作業系統的書都說「同一時間點只有一個任務在執行」。那有人可能就要問雙核處理器呢?難道兩個核不是同時運行嗎?
其實「同一時間點只有一個任務在執行」這句話是不準確的,至少它是不全面的。那多核處理器的情況下,執行緒是怎樣執行呢?這就需要了解內核執行緒。
多核(心)處理器是指在一個處理器上集成多個運算核心從而提高計算能力,也就是有多個真正並行計算的處理核心,每一個處理核心對應一個內核執行緒。
內核執行緒(Kernel Thread,KLT)就是直接由作業系統內核支援的執行緒,這種執行緒由內核來完成執行緒切換,內核通過操作調度器對執行緒進行調度,並負責將執行緒的任務映射到各個處理器上。一般一個處理核心對應一個內核執行緒,比如單核處理器對應一個內核執行緒,雙核處理器對應兩個內核執行緒,四核處理器對應四個內核執行緒。
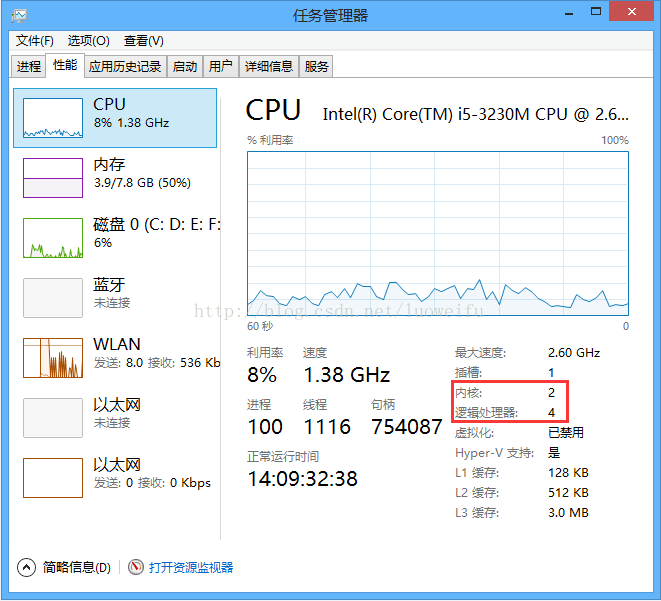
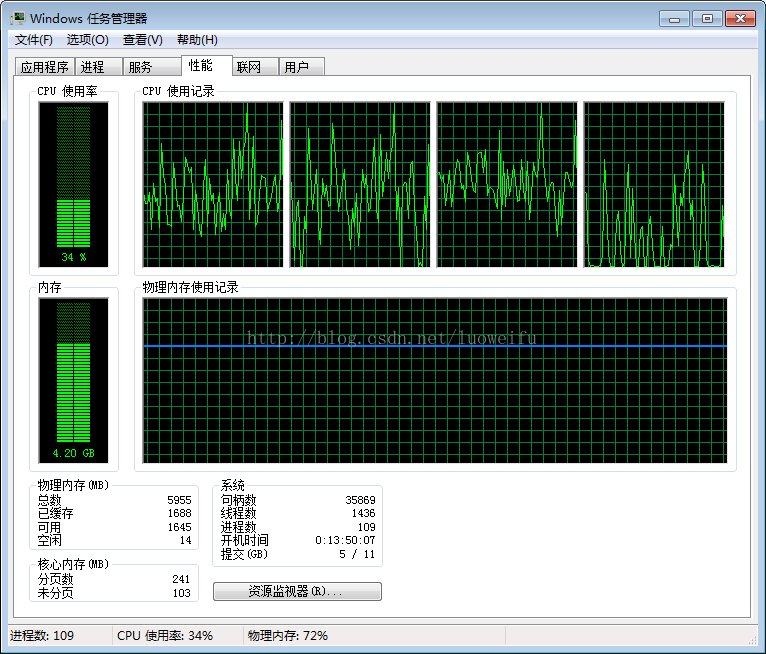
現在的電腦一般是雙核四執行緒、四核八執行緒,是採用超執行緒技術將一個物理處理核心模擬成兩個邏輯處理核心,對應兩個內核執行緒,所以在作業系統中看到的CPU數量是實際物理CPU數量的兩倍,如你的電腦是雙核四執行緒,打開「任務管理器性能」可以看到4個CPU的監視器,四核八執行緒可以看到8個CPU的監視器。
超執行緒技術就是利用特殊的硬體指令,把一個物理晶片模擬成兩個邏輯處理核心,讓單個處理器都能使用執行緒級並行計算,進而兼容多執行緒作業系統和軟體,減少了CPU的閑置時間,提高的CPU的運行效率。這種超執行緒技術(如雙核四執行緒)由處理器硬體的決定,同時也需要作業系統的支援才能在電腦中表現出來。
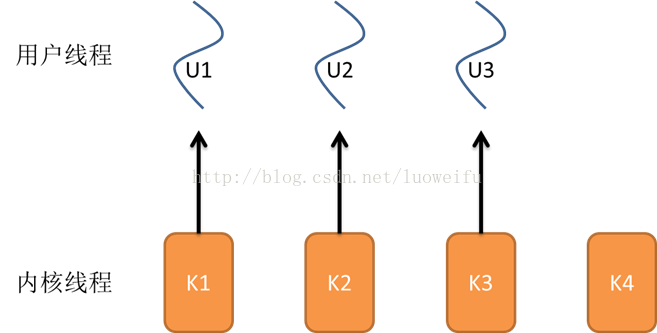
程式一般不會直接去使用內核執行緒,而是去使用內核執行緒的一種高級介面——輕量級進程(Lightweight Process,LWP),輕量級進程就是我們通常意義上所講的執行緒,也被叫做用戶執行緒。由於每個輕量級進程都由一個內核執行緒支援,因此只有先支援內核執行緒,才能有輕量級進程。用戶執行緒與內核執行緒的對應關係有三種模型:一對一模型、多對一模型、多對多模型,在這以4個內核執行緒、3個用戶執行緒為例對三種模型進行說明。
一對一模型
對於一對一模型來說,一個用戶執行緒就唯一地對應一個內核執行緒(反過來不一定成立,一個內核執行緒不一定有對應的用戶執行緒)。這樣,如果CPU沒有採用超執行緒技術(如四核四執行緒的電腦),一個用戶執行緒就唯一地映射到一個物理CPU的內核執行緒,執行緒之間的並發是真正的並發。一對一模型使用戶執行緒具有與內核執行緒一樣的優點,一個執行緒因某種原因阻塞時其他執行緒的執行不受影響;此處,一對一模型也可以讓多執行緒程式在多處理器的系統上有更好的表現。
但一對一模型也有兩個缺點:
- 許多作業系統限制了內核執行緒的數量,因此一對一模型會使用戶執行緒的數量受到限制;
- 許多作業系統內核執行緒調度時,上下文切換的開銷較大,導致用戶執行緒的執行效率下降。
多對一模型
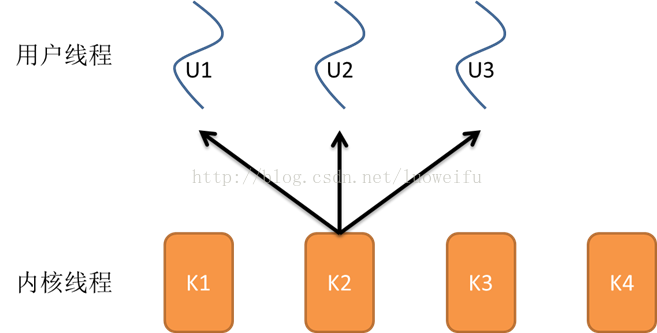
多對一模型將多個用戶執行緒映射到一個內核執行緒上,執行緒之間的切換由用戶態的程式碼來進行,系統內核感受不到執行緒的實現方式。用戶執行緒的建立、同步、銷毀等都在用戶態中完成,不需要內核的介入。因此相對一對一模型,多對一模型的執行緒上下文切換速度要快許多;此外,多對一模型對用戶執行緒的數量幾乎無限制。
但多對一模型也有兩個缺點:
- 如果其中一個用戶執行緒阻塞,那麼其它所有執行緒都將無法執行,因為此時內核執行緒也隨之阻塞了;
- 在多處理器系統上,處理器數量的增加對多對一模型的執行緒性能不會有明顯的增加,因為所有的用戶執行緒都映射到一個處理器上了。
多對多模型
多對多模型結合了一對一模型和多對一模型的優點,將多個用戶執行緒映射到多個內核執行緒上。由執行緒庫負責在可用的可調度實體上調度用戶執行緒,這使得執行緒的上下文切換非常快,因為它避免了系統調用。但是增加了複雜性和優先順序倒置的可能性,以及在用戶態調度程式和內核調度程式之間沒有廣泛(且高昂)協調的次優調度。
多對多模型的優點有:
- 一個用戶執行緒的阻塞不會導致所有執行緒的阻塞,因為此時還有別的內核執行緒被調度來執行;
- 多對多模型對用戶執行緒的數量沒有限制;
- 在多處理器的作業系統中,多對多模型的執行緒也能得到一定的性能提升,但提升的幅度不如一對一模型的高。
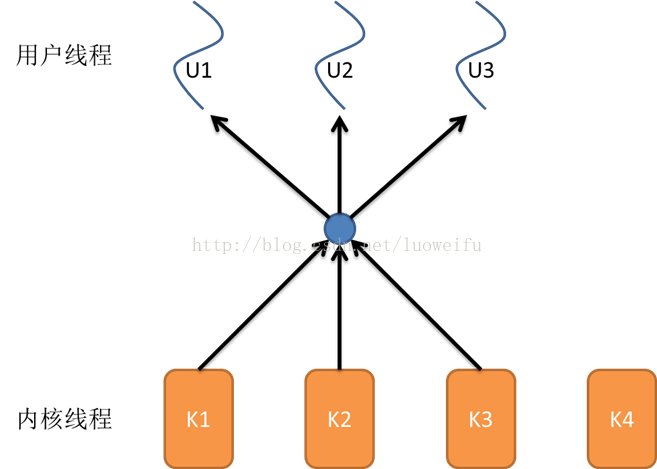
在現在流行的作業系統中,大都採用多對多的模型。
查看進程與執行緒
一個應用程式可能是多執行緒的,也可能是多進程的,如何查看呢?在Windows下我們只須打開任務管理器就能查看一個應用程式的進程和執行緒數。按「Ctrl+Alt+Del」或右鍵快捷工具欄打開任務管理器。
查看進程數和執行緒數:
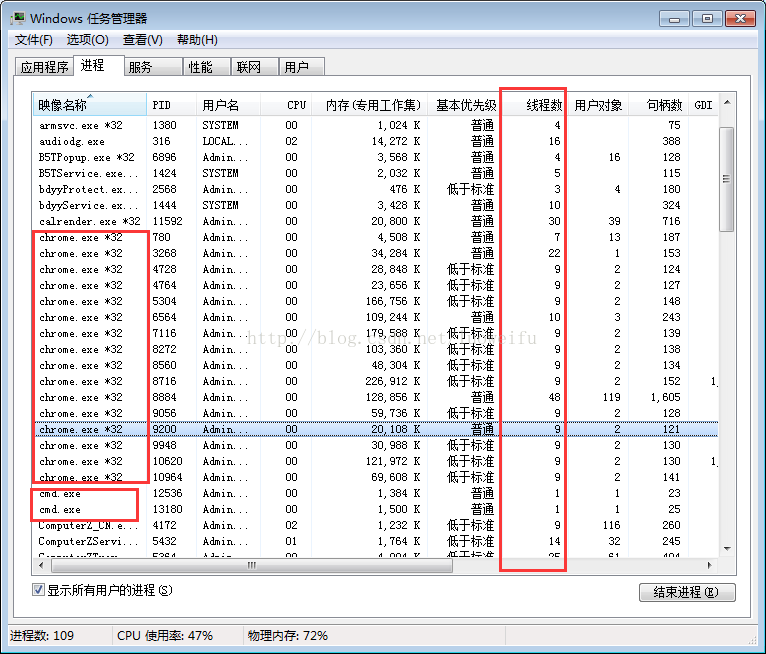
在「進程」選項卡下,我們可以看到一個應用程式包含的執行緒數。如果一個應用程式有多個進程,我們能看到每一個進程,如在上圖中,Google的Chrome瀏覽器就有多個進程。同時,如果打開了一個應用程式的多個實例也會有多個進程,如上圖中我打開了兩個cmd窗口,就有兩個cmd進程。如果看不到執行緒數這一列,可以再點擊「查看選擇列」菜單,增加監聽的列。
查看CPU和記憶體的使用率:
在性能選項卡中,我們可以查看CPU和記憶體的使用率,根據CPU使用記錄的監視器的個數還能看出邏輯處理核心的個數,如我的雙核四執行緒的電腦就有四個監視器。
執行緒的生命周期
當執行緒的數量小於處理器的數量時,執行緒的並發是真正的並發,不同的執行緒運行在不同的處理器上。但當執行緒的數量大於處理器的數量時,執行緒的並發會受到一些阻礙,此時並不是真正的並發,因為此時至少有一個處理器會運行多個執行緒。
在單個處理器運行多個執行緒時,並發是一種模擬出來的狀態。作業系統採用時間片輪轉的方式輪流執行每一個執行緒。現在,幾乎所有的現代作業系統採用的都是時間片輪轉的搶佔式調度方式,如我們熟悉的Unix、Linux、Windows及macOS等流行的作業系統。
我們知道執行緒是程式執行的最小單位,也是任務執行的最小單位。在早期只有進程的作業系統中,進程有五種狀態,創建、就緒、運行、阻塞(等待)、退出。早期的進程相當於現在的只有單個執行緒的進程,那麼現在的多執行緒也有五種狀態,現在的多執行緒的生命周期與早期進程的生命周期類似。
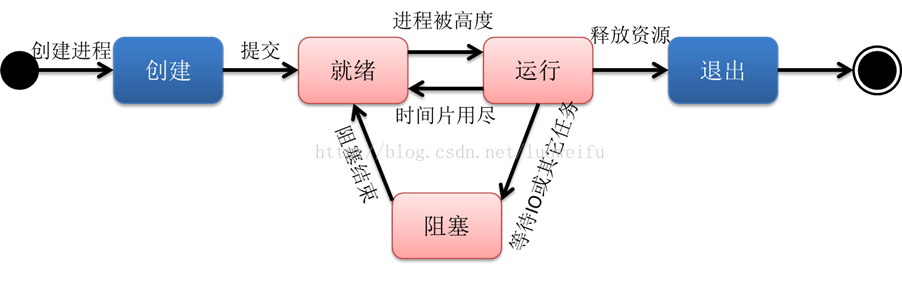
進程在運行過程有三種狀態:就緒、運行、阻塞,創建和退出狀態描述的是進程的創建過程和退出過程。
- 創建:進程正在創建,還不能運行。作業系統在創建進程時要進行的工作包括分配和建立進程式控制制塊表項、建立資源表格並分配資源、載入程式並建立地址空間;
- 就緒:時間片已用完,此執行緒被強制暫停,等待下一個屬於它的時間片到來;
- 運行:此執行緒正在執行,正在佔用時間片;
- 阻塞:也叫等待狀態,等待某一事件(如IO或另一個執行緒)執行完;
- 退出:進程已結束,所以也稱結束狀態,釋放作業系統分配的資源。
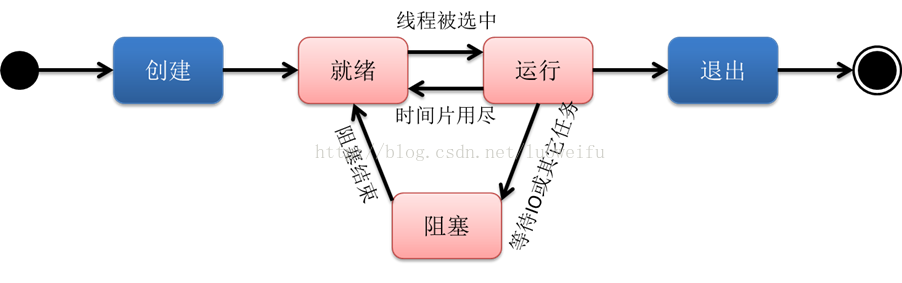
- 創建:一個新的執行緒被創建,等待該執行緒被調用執行;
- 就緒:時間片已用完,此執行緒被強制暫停,等待下一個屬於它的時間片到來;
- 運行:此執行緒正在執行,正在佔用時間片;
- 阻塞:也叫等待狀態,等待某一事件(如IO或另一個執行緒)執行完;
- 退出:一個執行緒完成任務或者其他終止條件發生,該執行緒終止進入退出狀態,退出狀態釋放該執行緒所分配的資源。
協程
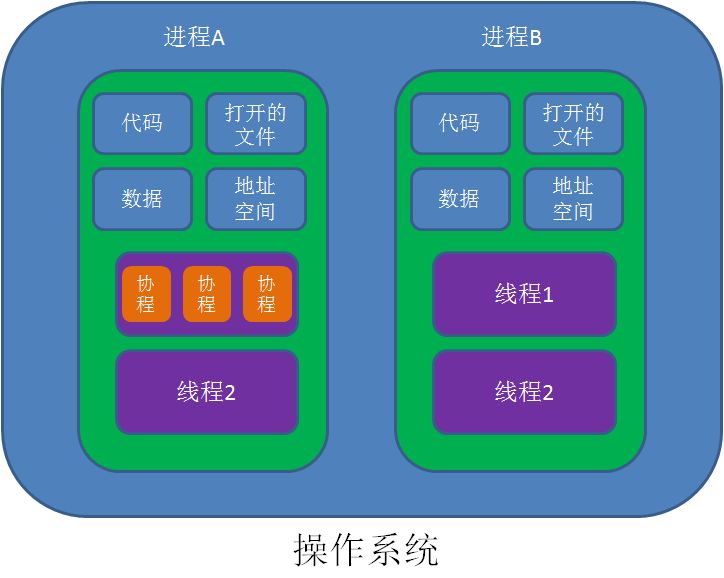
協程,英文Coroutines,是一種基於執行緒之上,但又比執行緒更加輕量級的存在,這種由程式設計師自己寫程式來管理的輕量級執行緒叫做『用戶空間執行緒』,具有對內核來說不可見的特性。
因為是自主開闢的非同步任務,所以很多人也更喜歡叫它們纖程(Fiber),或者綠色執行緒(GreenThread)。正如一個進程可以擁有多個執行緒一樣,一個執行緒也可以擁有多個協程。
協程的目的
在傳統的J2EE系統中都是基於每個請求佔用一個執行緒去完成完整的業務邏輯(包括事務)。所以系統的吞吐能力取決於每個執行緒的操作耗時。如果遇到很耗時的I/O行為,則整個系統的吞吐立刻下降,因為這個時候執行緒一直處於阻塞狀態,如果執行緒很多的時候,會存在很多執行緒處於空閑狀態(等待該執行緒執行完才能執行),造成了資源應用不徹底。
最常見的例子就是JDBC(它是同步阻塞的),這也是為什麼很多人都說資料庫是瓶頸的原因。這裡的耗時其實是讓CPU一直在等待I/O返回,說白了執行緒根本沒有利用CPU去做運算,而是處於空轉狀態。而另外過多的執行緒,也會帶來更多的ContextSwitch開銷。
對於上述問題,現階段行業里的比較流行的解決方案之一就是單執行緒加上非同步回調。其代表派是node.js以及Java里的新秀Vert.x。
而協程的目的就是當出現長時間的I/O操作時,通過讓出目前的協程調度,執行下一個任務的方式,來消除ContextSwitch上的開銷。
協程的特點
- 執行緒的切換由作業系統負責調度,協程由用戶自己進行調度,因此減少了上下文切換,提高了效率。
- 執行緒的默認Stack大小是1M,而協程更輕量,接近1K。因此可以在相同的記憶體中開啟更多的協程。
- 由於在同一個執行緒上,因此可以避免競爭關係而使用鎖。
- 適用於被阻塞的,且需要大量並發的場景。但不適用於大量計算的多執行緒,遇到此種情況,更好實用執行緒去解決。
協程的原理
當出現IO阻塞的時候,由協程的調度器進行調度,通過將數據流立刻yield掉(主動讓出),並且記錄當前棧上的數據,阻塞完後立刻再通過執行緒恢復棧,並把阻塞的結果放到這個執行緒上去跑,這樣看上去好像跟寫同步程式碼沒有任何差別,這整個流程可以稱為coroutine,而跑在由coroutine負責調度的執行緒稱為Fiber。比如Golang里的 go關鍵字其實就是負責開啟一個Fiber,讓func邏輯跑在上面。
由於協程的暫停完全由程式控制,發生在用戶態上;而執行緒的阻塞狀態是由作業系統內核來進行切換,發生在內核態上。
因此,協程的開銷遠遠小於執行緒的開銷,也就沒有了ContextSwitch上的開銷。
協程和執行緒的比較
| 比較項 | 執行緒 | 協程 |
|---|---|---|
| 佔用資源 | 初始單位為1MB,固定不可變 | 初始一般為 2KB,可隨需要而增大 |
| 調度所屬 | 由 OS 的內核完成 | 由用戶完成 |
| 切換開銷 | 涉及模式切換(從用戶態切換到內核態)、16個暫存器、PC、SP...等暫存器的刷新等 | 只有三個暫存器的值修改 - PC / SP / DX. |
| 性能問題 | 資源佔用太高,頻繁創建銷毀會帶來嚴重的性能問題 | 資源佔用小,不會帶來嚴重的性能問題 |
| 數據同步 | 需要用鎖等機制確保數據的一直性和可見性 | 不需要多執行緒的鎖機制,因為只有一個執行緒,也不存在同時寫變數衝突,在協程中控制共享資源不加鎖,只需要判斷狀態就好了,所以執行效率比多執行緒高很多。 |