亮相 LiveVideoStackCon,透析阿里雲窄帶高清的現在與未來
2021.4.16-4.17,阿里雲影片雲亮相 LiveVideoStackCon 音影片技術大會上海站,帶來三場不同視角的主題演講,並與眾多行業夥伴一同交流。在 「編解碼的新挑戰與新機會」 專場,影片雲的資深技術專家深度分享了 「窄帶高清」 技術演進思路。
窄帶高清是一套以人眼的主觀感受最優為基準的影片編碼技術,研究在頻寬受限的情況下,如何追求最佳的視覺感受。阿里雲早在 2015 年就提出了該技術概念,在 2016 年正式推出窄帶高清技術品牌併產品化,自提出便促動整個行業開始逐步引用該概念,形成了行業共識並不斷演化至今。
阿里雲智慧影片雲資深技術專家王豪,在演講中闡釋了窄帶高清的本質、當前的技術聚焦點、及其未來的方向與布局。以下為完整的演講內容。
「大家好,我是王豪,來自阿里雲智慧影片雲。現在主要負責影片編碼和增強。我們團隊一直關注影片編碼和處理方向的進展及其技術前沿工作。今天和大家分享的是我們在窄帶高清方面的進展和思考,希望能與大家一起探討。
我今天重點要講的是三個部分:窄帶高清是什麼、關於現在在窄帶高清方面關注哪些內容、以及關於未來的布局是什麼。」
阿里雲的窄帶高清
1.1 窄帶高清技術

窄帶高清是阿里雲影片雲的技術品牌,是屬於內容自適應編碼里的。窄帶高清是修復增強 + 壓縮的問題,主要目標是追求品質、碼率、和成本的最優均衡。在這個方向我們有兩代不同版本。
第一代是均衡版,主要作用是如何用最少的成本去實現自適應的內容處理和編碼,達到品質提升同時節省碼率的目的。所以,我們在窄高 1.0 充分利用編碼器里的資訊幫助影片處理,即成本很小的前處理方法,從而實現低成本的自適應內容處理和編碼。同時,在編碼器里,主要時間是基於主觀的碼控。
第二代(窄高 2.0),與窄高 1.0 相比會有更多的、更充分的、複雜度更高的技術來保證自適應能力,同時我們在窄高 2.0 里增加了修復能力,比較適用於高熱內容,比如優酷世界盃。對這種重要的比賽用窄高 2.0 進行處理,在品質提升的同時,碼率節省也更多,具體內容我在後面會一一展開。
1.2 窄帶高清的全景圖

上圖是窄帶高清的框圖。從上一頁 PPT 來講,窄帶高清除了單點技術之外,主打內容自適應。上圖最下面的內容是核心技術:影片處理和影片編碼。影片處理和影片編碼是原子能力,上面的內容就是如何去做自適應。對窄帶高清來說,自適應來自三個維度。
第一個維度:業務。不同的影片語音業務對窄帶高清的訴求是不一樣的,比如長影片和短影片:由於影片的採集方式不同和時效性不同,它所需要的窄高採用的技術和編碼模式都是不同的。
第二個維度:影片熱度。在首淘場景中對高熱內容可以用窄高 2.0 啟動二次轉碼來實現品質的進一步提升和碼率的節省。
第三個維度:內容。內容分為兩塊 ——High level 和 Low level。
High level 第一點就是語義。在語義中,基於不同的場景決策最優的編碼參數,同時還有分割,分割就是 ROI,我們可以對感興趣的區域進行編碼。第二點是品質,片源品質包括失真,包括亮度、對比度、雜訊等等,以及它的片源品質是怎樣的。這些內容極大地決定了影片處理的組合和強度,同時對編碼器的決策也會有很大的影響。
Low level 被我們認為是低成本的思路,包括時空複雜度和 JND 兩個內容,我在後面都會進行展開。
影片普惠化下的影片編碼與影片處理
阿里雲影片雲當下重點發力的內容之一是把影片普惠化,而影片普惠化的關鍵在於成本,2021 年我們會繼續聚焦在 264、265 持續成本的節省,同時在下一代 VVC 和 AV1 上發力。
2.1 影片處理
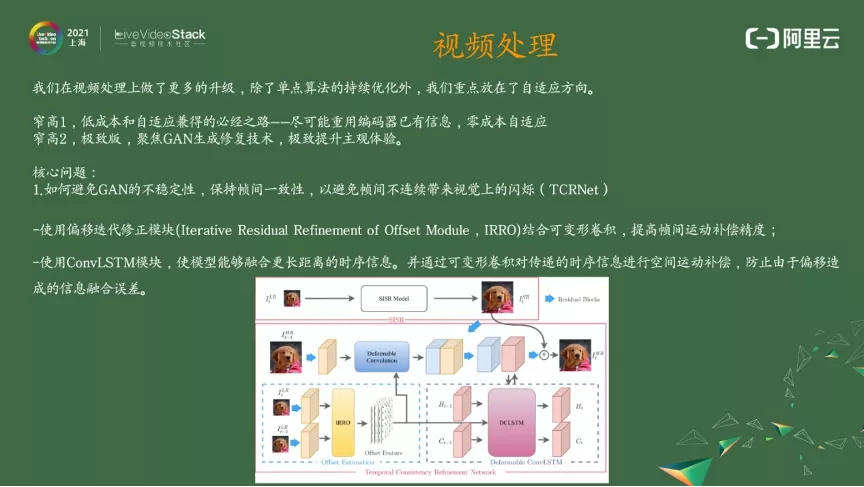
在影片處理方向,除了單點演算法之外,我們還把重點放在了自適應方向上。窄高 1.0 的核心就是低成本和自適應如何兼得,我們的重要思路就是:儘可能地重用編碼器的編碼資訊去幫助影片處理做自適應的決策,這樣的自適應是零成本自適應,包括影片編碼里的 CUtree 和自適應量化 (AQ) 的資訊、運動搜索的資訊等,充分地使用到這些資訊並幫助影片處理做出決策。
窄高 2.0 除了之前講的場景語義幫助編碼做決策之外,另一個重點要講的是基於 GAN 的生成修復技術。這裡的核心問題:由於 GAN 生成是不穩定的,怎樣保證幀間一致性就是一個難題 —— 這裡我們用的是 TCRnet。TCRnet 是用 IRRO 偏移迭代修正模組結合可變形卷積來提高運動補償的精度,同時利用 ConvLSTM 進行時序資訊的補償防止造成資訊誤差。
2.2 影片處理人像處理
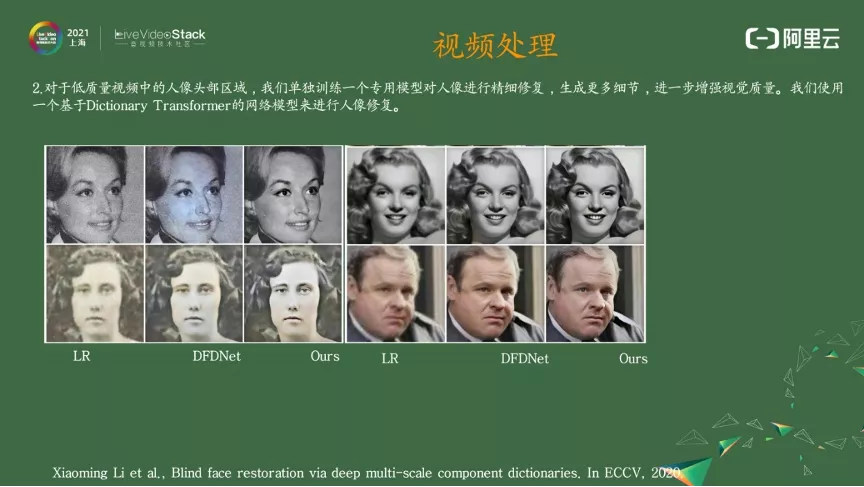
我們認為無論是在點播、直播還是 RTC 場景裡面,人臉部分一直是人的 ROI,如果我們能把人臉區域或人像區域做比較大的提升,那這塊對主觀品質來說一定有比較好的提升以及視覺增強。我們這塊是和高校合作的,從上圖可以看出,和 LR 以及 DFDNet 對比起來,我們的結果(第三列和第六列)清晰度更高,同時魯棒性更好。目前我們的演算法正在申請專利,等結束之後會更加詳細地分享。
內容分析
3.1 片源品質
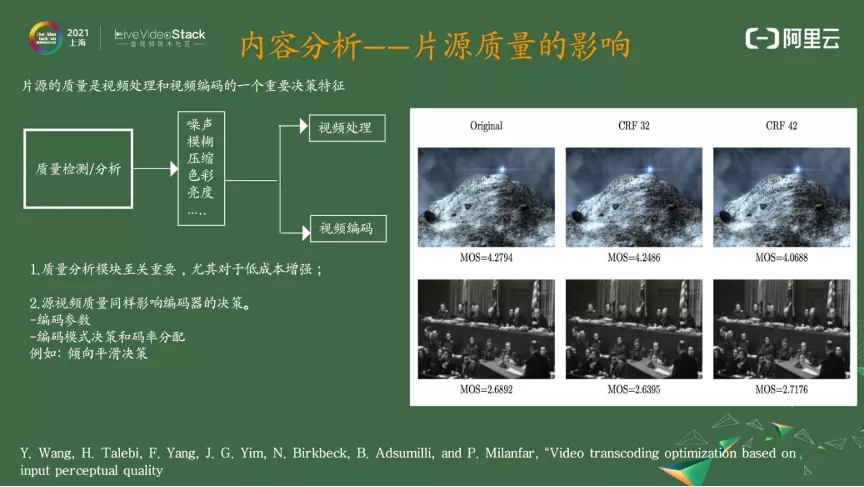
片源品質是一個非常重要的決策因素。大家一般關注在影片處理上,比如對片源檢測有哪些失真:雜訊、模糊、壓縮、色彩、亮度等,根據這些失真來做影片處理決策,做組合以及強度。對低成本的影片增強來講,影片品質的分析非常重要。因為對一個大模型來說,可以用大模型學到很多自適應能力;對小模型來說,要給它足夠的先驗資訊,幫助它在低成本下實現影片處理的較好的決策。
除了對影片處理的幫助之外,片源品質對影片編碼的影響也比較大。
大家可以看到影片右邊這個圖,這個圖我是從Google那篇 paper 中摘出來的,我們自己測也能發現,但Google那邊 MOS 打分非常詳細,所以我把這個圖給貼出來。上圖右側的圖片中 CRF42 跟源的品質差不多,但是下面的 CRF42 的品質比源的品質還高。
在片源品質較差的情況下,自適應編碼是個低通濾波,如果用自適應編碼將雜訊濾掉,這對主觀品質是有提升的。這對我們的啟發是之前做的主播優化,就是如何通過編碼決策,通過 QP (量化參數) 分配,通過一些碼控前處理來幫助編碼器把高頻留下來。
大家都會認為錯誤的高頻會比模糊的低頻更好,但是在片源品質差的情況下就不是這個思路了,主觀優化的思路要反過來,怎樣把編碼器的決策使它偏向於模糊的決策,或者使它傾向於做一個平滑的,比如多選雙向預測、多選低幀。整個窄帶高清裡面很重要的模組就是影片品質的分析檢測 —— 用來幫助我們做編碼和處理的決策資訊。
3.2 JND
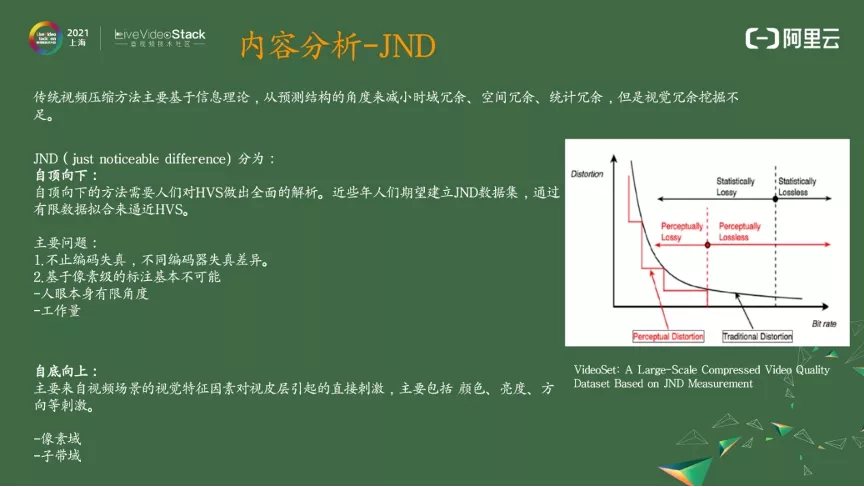
JND 對工業界來說是一個非常重要的方向。傳統的影片編碼是基於資訊理論的,所以它在一直做時域冗餘、空間冗餘、統計冗餘等等的冗餘,但是對視覺冗餘的挖掘是遠遠不夠的。
JND 對視覺冗餘的挖掘思路十分直接。上圖取自於王海強博士的一篇 paper,它的思路是傳統做 RDO ,是一個連續的凸曲線,但在人眼中它是個階梯形的,那我們就可以找這個階梯,找到這個階梯就可以省下碼率欄,使它主觀品質不可見。基於這個思路 —— 也是 JND 的思路,JND 分為兩個思路。
3.2.1 自頂向下
自頂向下就是要去模擬人的 HVS 的機制來實現 JND 的擬合,但是人們對 HVS 的研究還遠遠不夠,很難用一個東西模擬它,所以現在業界有一些學者去研究間接數據集,通過數據的驅動來逼近 HVS 。
現存的幾個問題:第一個就是影片編碼的失真其實跟碼控、主觀優化都有很大關係,稍微動一點編碼器的配置,失真差異就會很大;第二個就是基於像素級的標註是不可能的,因為人眼看東西是有角度的,不可能對整個像素進行標註,這樣做的工作量是非常大的,所以業界一般用的是第二種方案。
3.2.2 自底向上
自底向上的核心主要是對視覺皮層的視覺特徵來進行表真,包括顏色、亮度、對比度、運動等方式。這種也分為像素域和子帶域,有沒有可能用深度學習來幫助 JND 做提升。
3.3 關於 JND

上圖的工作核心是因為 IQA 的業界研究比較多,且有很多的數據集來幫助 IQA 做提升,而 JND 的研究不夠。但是 IQA 和 JND 都是保真影片的客觀冗餘和品質,有沒有可能兩個做結合,使它互為先驗資訊呢?
接下來是它的兩個主要假設,第一個影片冗餘的去除是雜訊疊加,大概意思是給一張圖上加雜訊,加完以後還看不出來,那麼這個圖的這個區域就是有冗餘的。第二個在圖上加雜訊,然後利用 IQA 作評價把冗餘去除變換為雜訊疊加,雜訊疊加後這個圖片用 IQA 做評價。
上圖是一個自變數卷積的網路。I 是原圖,PC 是吳老師提出的一個特徵,PC 是人眼用表真複雜度較低的方式去表真這個規則紋理,而對無規則紋理則用複雜度較高的模式表真。複雜度低和複雜度高的模式對應的 JND 是不一樣的,所以把 PC 做為先驗傳到網路裡面,把原圖、PC、以及原圖和 PC 的綜合(concatenation)做為自變數卷積做成的圖。
這個思路是利用 IQA 的結果來幫助 JND 做提升,從上圖中可以看到,整個思路有很多漏洞,比如 IQA 的判斷,哪個 IQA 可以來判斷雜訊疊加之後的圖的品質,PC 是不是好的表真方式等,這些問題都是有提升空間的,但這是我們目前看到幫助 JND 提升的比較好的方向。
影片編碼與處理聯合優化
4.1 影片編碼與處理聯合優化的思路

現在我們正在做的影片編碼和影片處理的聯合優化就是既有發送端也有接收端,不僅有前處理也有後處理。
基於上面的框圖來說,整個影片編碼的失真假設是有所改變的,不再是編碼前後的失真,而是前處理之前和後處理之後的失真。同時碼率也會發生變化,不一定是只有基本層,還可以有增項層來幫助影片後處理去做提升和恢復。
影片編碼與處理聯合優化有幾種思路。
第一個思路是怎樣利用影片處理幫助編碼提升壓縮率。這裡可以利用場景分類、內容理解、品質分析以及 JND 幫助做出決策;第二是除了幫助影片編碼做決策之外,還可以利用影片編碼影片前處理提升影片品質達到更好效果。
第二個思路是怎樣用影片編碼幫助影片處理提升效果,這邊的處理指的是後處理。這裡有兩個核心問題,基於後處理的情況如何做編碼的決策。之前用的 RDO 的公式、曲線 \ 以及碼率分配都是基於編碼器得到的。但是在有後處理的情況下,在決策和預測時應該做出怎樣的變化,這是我們和高校正在探索的問題。
這裡著重講分層編碼,分享一下我們在這一部分的思考。
分層編碼一定要滿足幾個條件:
第一個條件是是否能找出更高效的數據表達形式,不僅僅是上傳的資訊在編碼器做碼率分配就可以,而是編碼器在做碼率分配時有更高效的方式才會有分層的價值。
第二個是發現對品質貢獻有價值的資訊,傳遞這些資訊會比在普通編碼時碼率分配那些資訊更高效,可以識別出對品質更具有價值的資訊,這一點後面會進行展開。
第三個是編碼處理的聯合優化。
4.2 關鍵點 + 雅可比矩陣
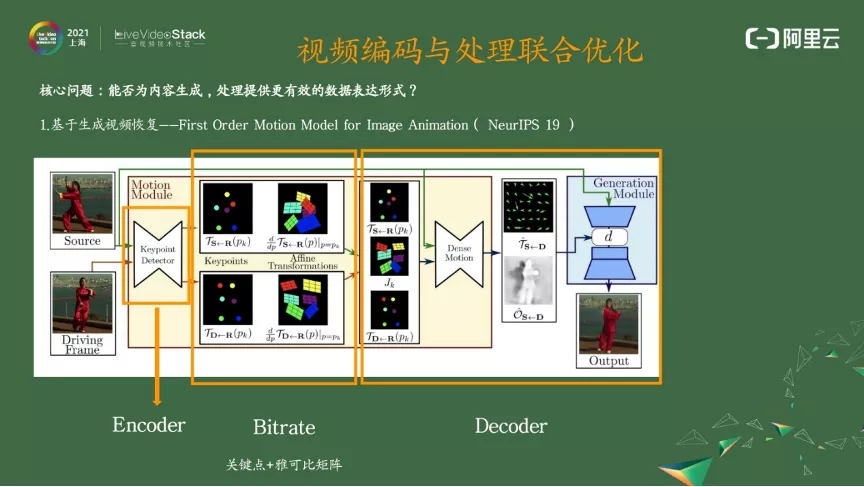
上圖大家可能看的比較多,像NVIDIA 也是基於這份會議 paper 來制訂的會議方案,這個就是一個非常好的更有效的數據表達形式。
這裡引用 19 年的一篇文章,First Order motion model for image animation,它的工作是做影像合成,給一張原圖然後生成一張圖,生成的這張圖包括原圖的結構資訊加上引導圖的姿態資訊。
從上圖可以看到,這裡分為了兩個模組。一個模組是運動預測模組,是圖中的黃色區域;第二個模組是生成模組。在運動預測模組前面對關鍵點進行檢測,這個關鍵點和我們以為的關鍵點不一樣,不是人臉的關鍵點,而是通過網路分析 —— 這樣對運動表真會更有幫助 —— 得出關鍵點附近的雅可比矩陣。雅可比矩陣是一個 2*2 的局部仿射變換的矩陣。
基於關鍵點和雅可比矩陣,可以通過 Dance motion 來得到密集的光流加上遮擋圖,把遮擋圖、密集光流進入生成網路後來生成最後的圖。我框出的圖中 Keypoint Detector 就是一個編碼器。編碼輸出了它的特徵,特徵點和 22 的這個矩陣就是要傳輸的碼流,後面就是解碼器。現在的關鍵點加 22 的矩陣是一個非常高效的表達形式。假設關鍵點有十個,對應的 2*2 矩陣也有十個,那麼對一張圖的表示只需要 50 個比特,這比傳統編碼器更加高效。
我們基於這個思路也在做自己的方案,現在有一些成果,在這裡和大家分享一點 —— 我們覺得在這個整體中非常重要的是工程的魯棒性。它的使用是有限制的,人偏到一定程度,背景比較亂或者人有其他動作時,這種方法就失效了。我們要做一下工程方面的保證,把這些條件全部檢測出來,來保證在合適使用的時間把它使用上。
4.3 核心問題
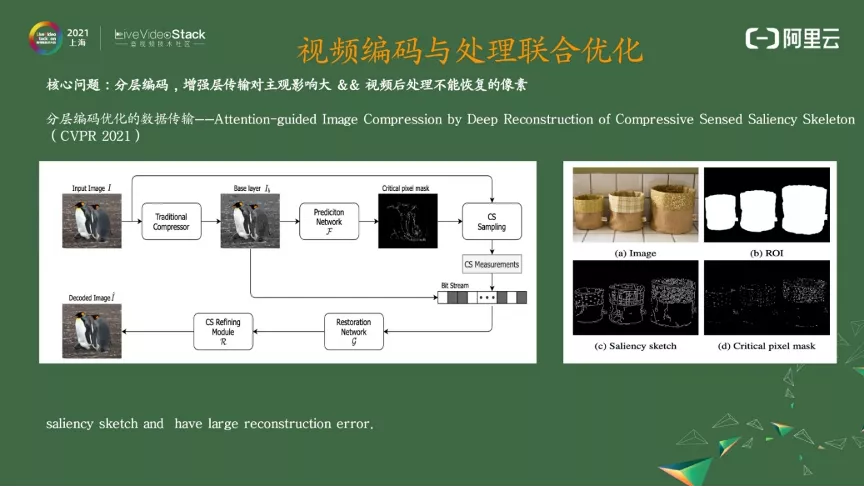
工作的思路是,我們要傳輸對主觀影響大、同時影片後處理不能恢復的像素。編碼傳到後面深度學習進行影片修復,修復了我們能真正識別出來的資訊。資訊是否需要傳?修復的資訊就不需要傳了,把不能恢復的資訊進行傳輸,能讓整體更高效。
大家從圖上可知這是一篇 CVPR 2021 的 paper。它的思路是進來一張圖,用傳統的編碼器或者是 JPEG 去編,編成 Base layer 直接輸一個預測網路,預測網路可以得到關鍵像素的值。這個關鍵像素是對主觀影響大且影片後處理不能恢復的像素,和原圖一起做一個感知壓縮,作為增強層的碼流來融合到編碼器的碼流里,一起傳到對端來進行修復。
有意思的是,它能識別資訊後處理後的能做與不能做,它的問題是關鍵點的預測是直接通過壓縮之後的重建圖得出的。原因在我不想傳位置資訊,直接通過壓縮之後的重建圖得出關鍵點,在解碼端也可以做。但如果把它放入影片編碼里,這對失真圖的預測來說是個比較大的問題,但這開啟了一個比較好的方向,一個我們可以去嘗試的方向。
4.4 LCEVC

從純壓縮率來講,從輸入影片到取樣,比如 4k 到 1080 經過 540 後用 Base Layer 進行編碼,做一個基本層。把這個重建幀進行熵取樣成 1080 的重建幀,跟 1080 的源進行殘差,殘差進行變換量化、熵編碼、反變換量化,L-1Filter 是一個傳統編碼器裡面的 Filter,它的方式會更簡單。把重建之後的東西跟 1080 的源相減 3k 或 4k 做時域的預測,做 L2 的 Tem poral Layer 的編碼。
Tem poral 預測是一個同位的預測,沒有應用搜索。基於有效的框圖來說需要有幾個條件,它做了降取樣和升取樣,Base Layer 可以認為是一個低頻訊號,殘差可以被認為高頻訊號,那這個框架是否對高頻訊號有更好的壓縮,這是我們的問題。這裡最核心的問題是如果它真的對高頻訊號有更好的壓縮,那整個框架要求就非常高。
第二,它對增強層的壓縮比傳統編碼器更好。從我們的分析包括結果來看都沒有達到這兩個條件,因為它的時域的資訊利用不足,對影片來講時域冗餘才是核心。同時它增強層的所有的 Transfrom 是哈達瑪變換的不是 ECT,很多都是近似。
所以壓縮率來講沒有達到分層編碼應該達到的水平,但很可能在軟硬結合的時候是有優勢的。硬體編碼器可能動不了,需要用軟體編碼器去做一些分層方面的考慮,這個問題可以後面和各位專家共同討論一下。
4.5 影片編碼與處理聯合優化
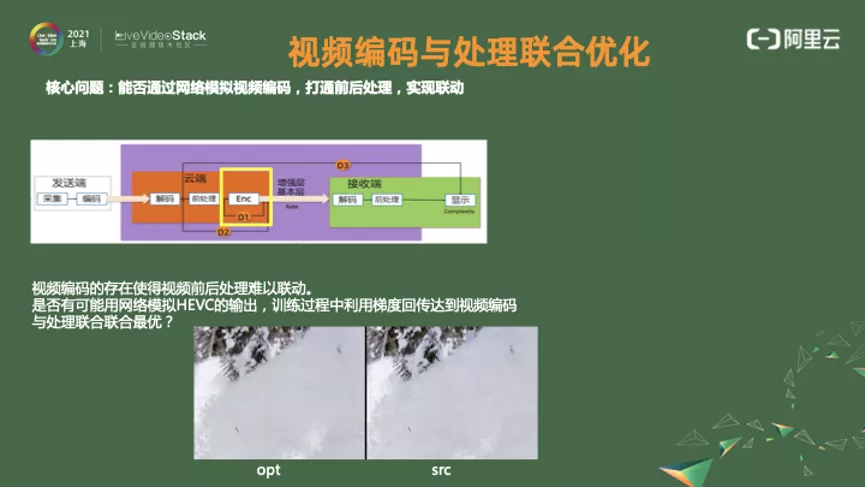
從上圖可以看到,影片編碼由於編碼器的存在把它的前後截斷了,是否有可能利用網路模擬影片編碼,使得它能夠擁有市面的驅動回傳,達到前處理和後處理的聯動,達到主觀最優,我們據此做了些嘗試。
我們也用網路去近似它,去模擬傳統的 HEVC。後來看效果,網路模擬不能很準確,但我們從主觀上和客觀上看到了效果,這對我們是個很好的啟發。
網路模擬到什麼程度或者說你這個起作用的原因是什麼,起作用的是不是一個趨勢,基於這個趨勢怎麼構建模擬過程可能能幫助實現前後的聯動。我們計劃今年下半年發 paper,等 paper 公布後和大家好好討論。因為我們發現不用模擬得很準確就能出效果。
從上圖的中下方可以看出,對傳統的影片編碼模擬還不足的情況下,處理聯動起來之後塊效應少了,細節變多了。
品質評價定義了技術選擇

品質評價定義了一個技術選擇,如何評價演算法就定義演算法往哪個方向去演進。
上圖主要說的是引入 GAN 之後,主觀品質和客觀品質的正相關性沒那麼強,即主觀品質好不一定客觀指標高,所以右圖的 quality 和 distortion 的 tradeoff 需要調整。在這個曲線上主觀品質好客觀品質必定差,主觀品質差客觀品質就可以好。
在上圖中左側可以看出,SRGAN 是很清楚的,SRResNet 是糊的,最右邊的圖品質最好,但它的 PSRN/SSIM 是比較低的,同時 VMAF 也是比較低的。所以用 VMAF 來評測也不是特別合適的方式。
我們在影片編碼中也發現了一個類似的規律 —— 主觀評價是評價窄帶高清的唯一方法。我們也找了很多客觀評價的東西,包括 LPM,NPS 等等,也包括很多無源的有源的。確實真正符合主觀的還沒找到,這塊是我們必須要做的。
窄帶高清的測評方案
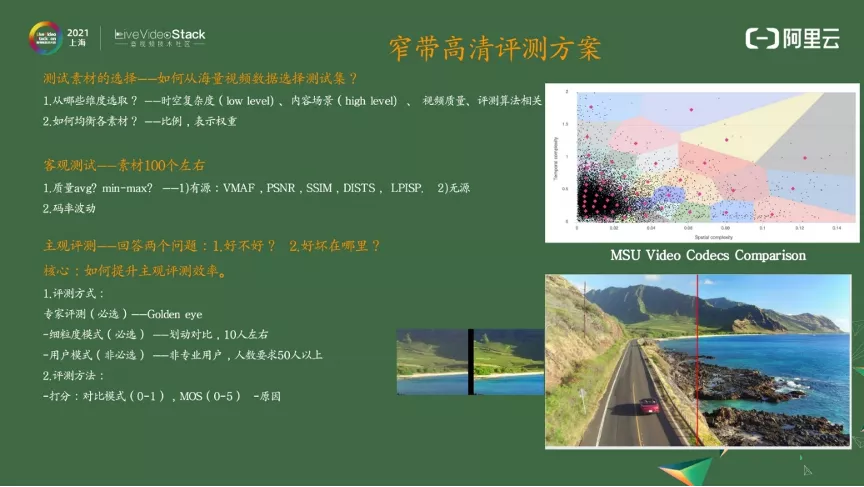
我們的思路放在如何提升主觀評測效率。主觀既然是唯一評價方法,那麼是否有方式提升主觀評測效率,比如影片素材的選擇,怎麼從這些維度去選你的影片作為測試集,包括 MSO 最常用的時空複雜度,包括內容、影片的品質,包括與評測演算法相關的因素。
如果想評測調色,就要選調色相關的影片,比如時延比較大的與時延比較小的等等。同時,比例也很重要。由於比例是一個結論,所以不合適的比例對你的結論會有比較大的影響。
從上圖右側可以看到,MUS 在測編碼器的時候會把幾千個影片放到表裡面,不同影片在不同區域的分布是什麼樣子的,如果能達到這個分布我們就知道它的權重了 —— 是不同影片對最後結果的權重是什麼。
客觀評價有很多種,看平均的值,看 min、max,或者用其他什麼方式,但都很難在實際中應用起來。這些可能對不同的場景有效,但怎麼樣做到魯棒也是我們自己的一個困惑,所以我們現在把重點放在主觀上 —— 核心是如何用很多工具、用很多數據、用很多系統來幫助主觀提升評測效率。
這裡有幾種評測方式:第一個是專家評測。Golden eye 一定要細膩地發現各種失真,這裡用 10 個人是比較好的。細粒度是右邊這個圖,做了一些工具,包括可以隨時放大的、可以拖動的等等來幫助我們發現編碼或者演算法方面的一些小的提升;用戶評測這方面太大,我們平時做的比較少,我們覺得專家評測和細粒度評測已經可以把我們整個演算法覆蓋住了;打分方面,對比模式是 0 到 1 時好時壞,還是 MOS 的 0 到 5 分。我覺得如果人少,推薦 01;人多的話推薦用 MOS。
窄帶高清的商用結果
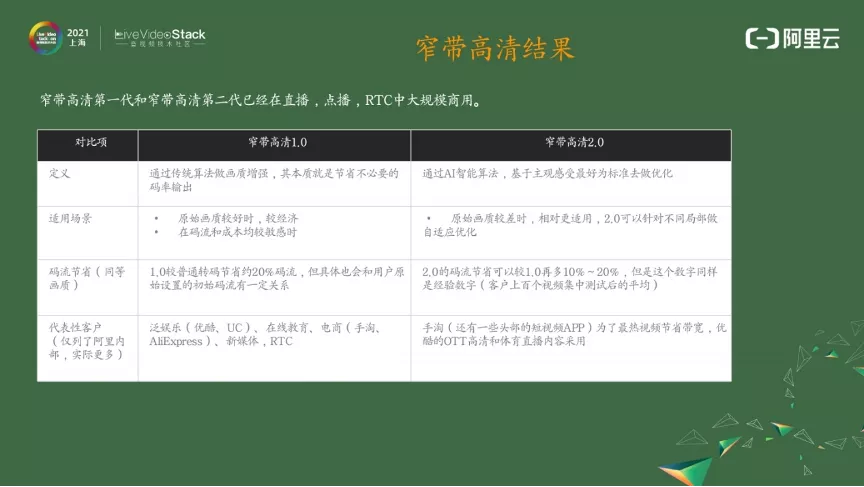
上圖是我們的結果,現在在窄帶高清 1.0 和窄帶高清 2.0 的直播、點播、RTC 方面已經大規模商用。剛剛已經說了,窄高 1.0 的定位是通惠,窄高 2.0 則用更高的演算法來幫助特殊的直播,包括優酷的世界盃體育直播和 OTT 直播。
同時,在窄高 2.0 裡面,我們還在做生成技術 —— 就是剛剛講的對人臉的修復。

上圖影片由於畫面運動比較快,我們節省了 30% 的畫面,使主觀品質更好。
關於未來:視覺 + 大腦
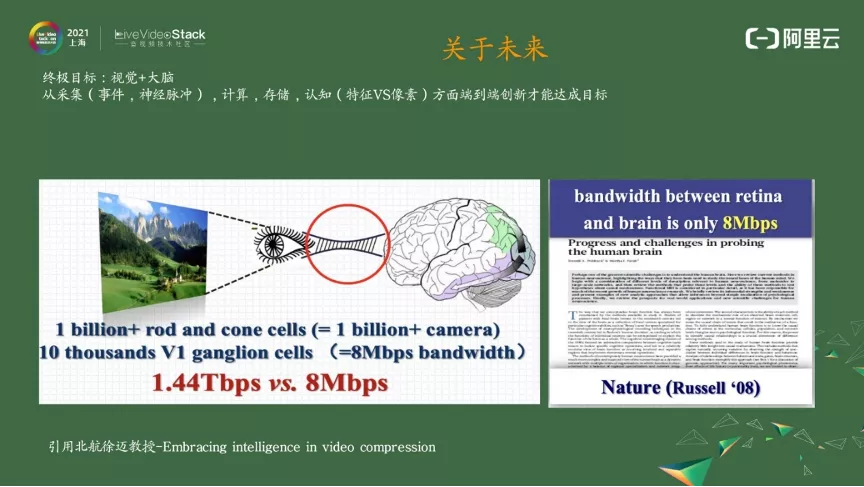
關於未來,窄帶高清的未來肯定是視覺加大腦,這點毋庸置疑,因為從壓縮效率來講肯定是視覺加大腦的效率是最高的。
下面的圖引自徐邁教授,上面寫了人眼的干錐細胞有十億個,或者說十億個 Camaro。從視覺進入大腦 V1 視覺皮層的一個頻寬只有 8M—— 不管你看什麼內容最終傳輸到大腦的只有 8M,這個壓縮率是非常高的。
下面這個 1.44T 和 8M 對比,從未來的角度看,我們覺得它需要採集計算存儲認知方面的創新才能達到這個目標。
舉個例子,我們現在的採集都是基於像素的採集,業界也在做基於事件的採集,基於神經脈衝的採集;從計算來講,雖然現在計算的效率提高了很多,但是和人腦來比算力還遠遠不夠,包括它的消耗 —— 比如我們人吃頓飯能看好久,但機器需要很多的電 —— 這一點從計算上一定得進行突破。
存儲是我們持續關注的一個點。是否有可能我的影片編碼越多我的影片品質就越好?或者我編碼的成本越低,像大腦一樣,我們人看過這個東西就直接腦補上了?這些都是從存儲裡面去找東西來幫助我們去做修復,很多東西都不用傳了。
認知也是一樣的,關於機器的壓縮也有,從特徵到像素,因為人腦是不能傳像素的,肯定是傳特徵的,那它的特徵是什麼也是待學術界要去分析的。
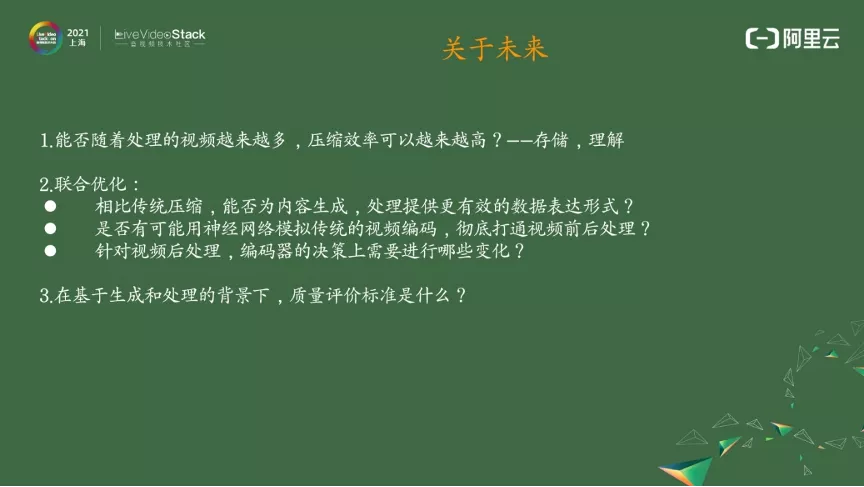
以下有幾個問題是我們短期的問題,我們會一直沿著這些問題探討下去,也以及部分地在這些方面做了合作布局,與高校一起來突破。
第一個,能否隨著處理的影片越來越多,壓縮效率可以越來越好,這個是我們想跟高校去布局的方向。同時,在聯合優化方面,像我們看到的一份 2019 年的 paper,在人臉表達姿態的表達方面有更高效的表達形式了,因為那個不是做壓縮的,在壓縮方面有沒有可能針對更多的場景,或者有壓縮的更好的表達形式出來。
第二個,傳統的影片編碼在中間使前後分離。我們現在有一些結果,發現影片編碼是一個工作量大的事情,是否有可能把編碼器模擬出來,徹底打通前後處理。這是我們自己在做的、同時也是和高校一起在探索的方向。
第三個,我們針對影片後處理和編碼上的決策有一些成果,並且想持續做下去。現在的 RDO 一直是針對於影片編碼的,而影片前面有前處理、影片後面有後處理,所以在針對有影片要處理的情況下,編碼的 RDO 需要決策編碼的碼控。
此外,我們在推廣的時候很多客戶不願意接受主觀評價,在給客戶推廣的時候,客戶一般就看一下 VMAF、PSRN 和 SSIM 是怎麼樣的,但這個對我們的主觀品質、演算法演進是不利的。那麼,基於主觀、 生成和處理的背景下,能適應的品質評價標準究竟是什麼?這是需要不斷思考的問題。
這就是我全部的分享。謝謝大家!
「影片雲技術」你最值得關注的音影片技術公眾號,每周推送來自阿里雲一線的實踐技術文章,在這裡與音影片領域一流工程師交流切磋。