我們真的需要模型壓縮嗎
- 2021 年 4 月 21 日
- 筆記
本文翻譯自部落格:
《Do We Really Need Model Compression?》
作者:Mitchell A. Gordon
前言:
模型壓縮是一種縮小訓練後的神經網路的技術。 壓縮的模型在使用少量計算資源的情況下,其性能通常與原始模型相似。 但是,在許多應用程式中,瓶頸被證明是在壓縮之前訓練原始的大型神經網路。例如,可以在低成本的GPU(12 GB的記憶體)上訓練基於BERT的模型,但是BERT-large需要在Google TPU(64 GB的記憶體)上訓練,這使許多人無法嘗試使用預訓練的語言模型。
模型壓縮領域的結果告訴我們,我們收斂的解決方案通常比最初訓練的模型具有更少的參數。那麼,是什麼阻止我們通過從頭訓練小型模型來節省GPU記憶體呢?
在這篇文章中,我們將探索從頭開始訓練小型模型所涉及的困難。我們將討論模型壓縮為何起作用,以及兩種進行記憶體有效訓練的方法:過量參數的界限和更好的優化方法,這些方法可以減少或消除事後模型壓縮。最後我們將總結未來的研究方向。
Appropriately-Parameterized Models
適量參數的模型--既沒有過量參數也沒有欠參數的模型,而是具有合適數量的參數以表示任務的理想解決方案的模型。
我們通常不會在深度學習範式中訓練適量參數的模型。這是因為對於給定的數據集,通常不知道使用多少參數量合適。即使知道了解決方案,眾所周知,使用梯度下降法訓練適量參數的模型也很困難。
相反,訓練程式通常看起來像這樣:
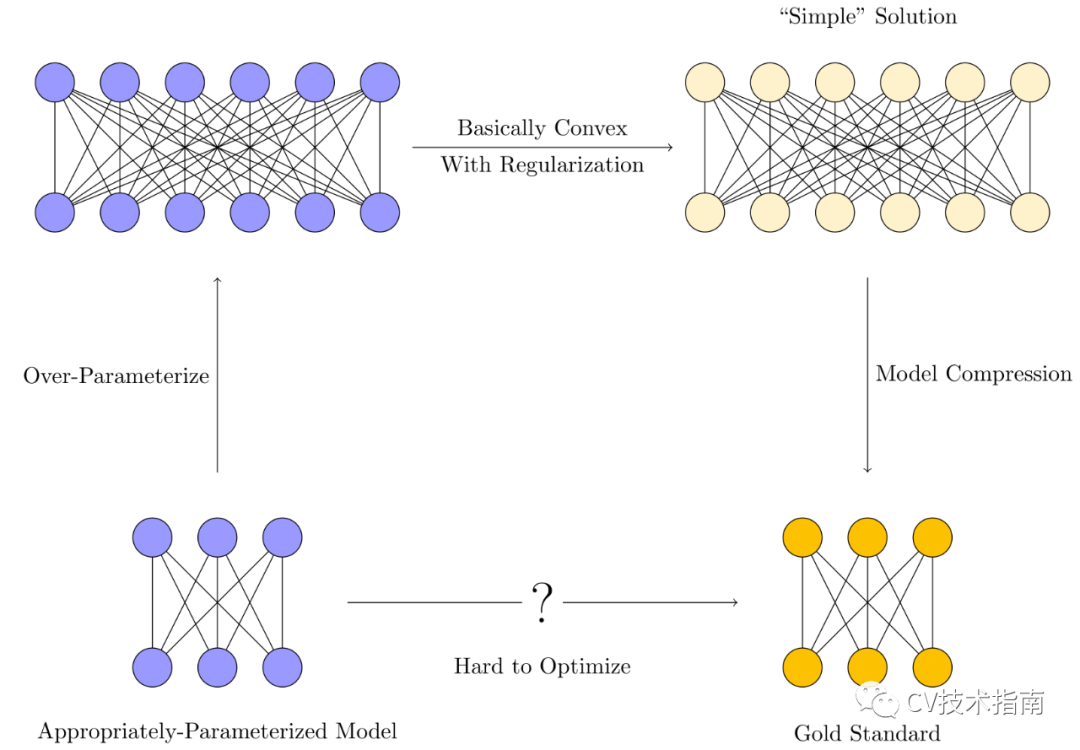

- 我們會訓練一個過參數化的模型。這些模型通常具有比訓練樣本數量更多的參數。
- 各種正則化技術(隱式或其他)用於約束優化,以偏向於「簡單解決方案」而不是過度擬合。
- 模型壓縮通過消除冗餘來提取嵌入在較大模型中的「簡單」模型,使記憶體和時間效率更接近理想的適量參數的模型。
極端的過度參數化使訓練變得更加容易。 但是,由於模型被過度參數化,因此它們可以存儲數據,而不是學習數據中的有用模式,因此需要進行正則化。 然後,模型壓縮利用這種簡單性僅保留解決方案實際需要的參數。
由於我們的目標是使用更少的GPU記憶體來訓練神經網路,因此我們可以提出一些明顯的問題:
- 為什麼需要過度參數化? 需要多少過參數化?
- 我們可以通過使用更智慧的優化方法來減少過度參數化嗎?
接下來的兩個部分將依次解決這些問題。
Over-parameterization Bounds
為什麼需要超量參數?通過充分超量參數的神經網路,我們可以使優化的landscape有效凸出。 杜etc(2019)、Haeffele和Vidal(2017)在一些簡單情況下對此進行了數學證明,給出了必要的過參數化量,能在多項式時間內實現0訓練損失。有效地,過度參數化是為了增加記憶體使用量而犧牲了計算難易度。
這些界限通常被認為是寬鬆的。 這意味著儘管我們可以預測出足夠數量的參數來完美擬合某些數據,但我們仍然不知道要完美擬合數據所需的最小參數數量。 嚴格的界限可能取決於從優化過程(SGD與GD,Adam與其他)到體系結構的所有方面。計算嚴格邊界甚至比訓練所有可能的候選網路在計算上更加棘手。
但是,在這方面肯定還有改進的餘地。嚴格的過度參數化範圍將使我們可以訓練較小的網路,而無需在架構上進行網格搜索,也不必擔心更大的網路可能為我們帶來更好的性能。 證明是否可以擴展到recurrent models, transformers,按batch norm訓練的模型等仍然存在問題。
上面忽略了提及不同的體系結構可能具有不同的過參數化範圍的情況。 那麼,一種合理的方法是使用具有較低過參數化範圍的不同體系結構。 一些有趣的「efficient transformers」包括Reformer,ALBERT,Sparse Transformers和SRU。
Better Optimization Techniques
從經驗上講,很難對參數正確的模型進行訓練。 用梯度下降訓練適當大小的模型通常會嚴重失敗。 該模型將無法收斂以適合訓練數據,更不用說泛化了。這部分由神經網路的優化環境的非凸性/ non-friendliness來部分解釋,但是訓練適量參數化模型的計算複雜度的精確表徵仍然不完整。
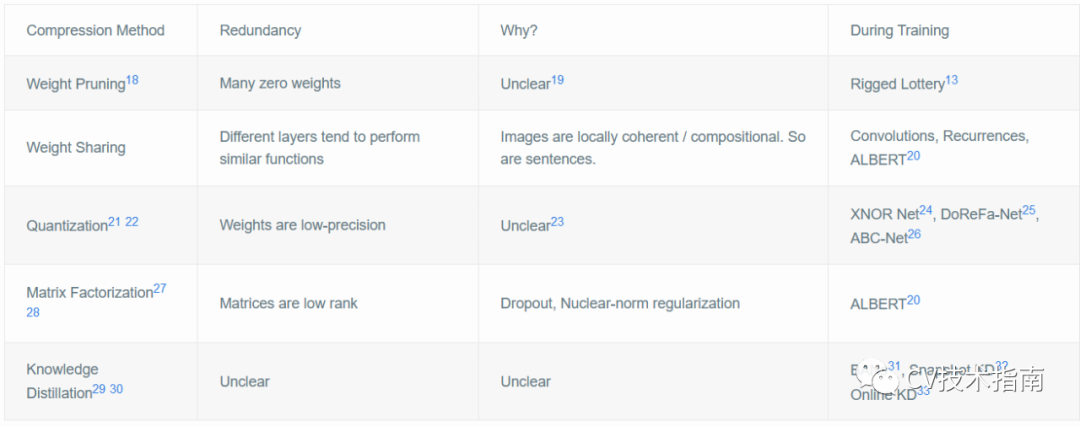
模型壓縮技術通過闡明過參數化模型趨於收斂的解的類型,為我們提供了有關如何訓練適當參數化模型的提示。 模型壓縮的類型很多,每種模型都利用一種不同類型的「簡單性」,這種「簡單性」往往在訓練有素的神經網路中發現:
-
許多權重接近零(修剪)
-
權重矩陣低秩(權重分解)
-
權重只用幾位來表示(量化)
-
層通常會學習類似的功能(權重共享)
這些「簡單性」中的每一個都是由於訓練過程中的正則化(隱式或其他)或訓練數據的品質而引起的。當我們知道我們正在尋找具有這些特性的解決方案時,它為改進我們的優化技術開闢了令人振奮的新方向。
Sparse Networks from Scratch
權重修剪可能是最成功的壓縮方法示例,可以將壓縮方法轉變為優化方法。 經過訓練的神經網路通常具有許多權重(30-95%),它們接近於0。可以刪除這些權重而不會影響神經網路的輸出。
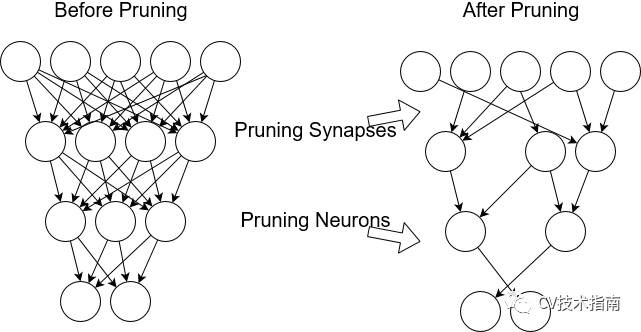
我們是否可以通過從一開始就訓練稀疏神經網路來減少GPU使用,而不是事後修剪呢?有一陣子,我們認為答案是否定的。稀疏的網路很難訓練;優化環境非常不凸且不友好。
然而,Frankel和Carbin(2018)朝著這個方向邁出了第一步。他們發現他們可以從頭開始重新訓練修剪的網路,但前提是必須將其重新初始化為在密集訓練期間使用的相同初始化。他們對此的解釋是the Lottery Ticket Hypothesis:密集網路實際上是許多適量參數化的稀疏模型的並行隨機初始化組合。 碰巧得到了幸運的初始化並收斂於解決方案。
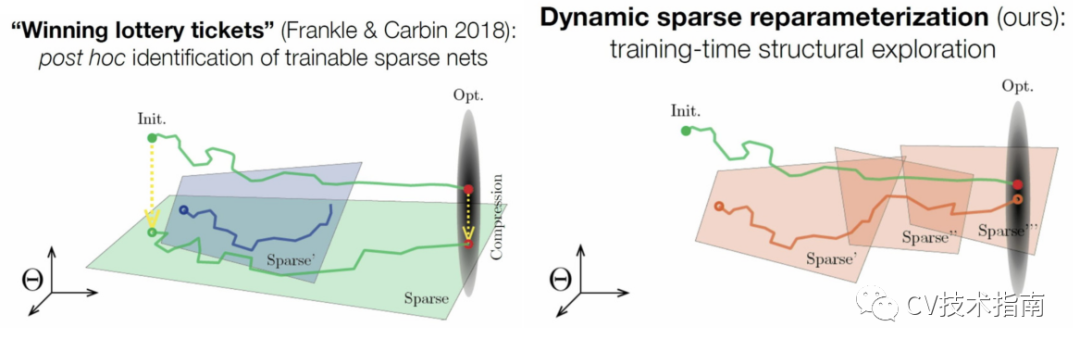
最近,Dettmers和Zettlemoyer(2019),Mostafa(2019),和Evci 等人(2019),指明可以從頭開始訓練適當參數化的稀疏網路,從而大大減少了訓練神經網路所需的GPU記憶體量。重要的不是初始化,而是探索模型的稀疏子空間的能力。Lee等人的類似工作(2018),嘗試通過對數據進行一次傳遞來快速找到合適的稀疏架構。
我相信,其他類型的模型壓縮可能會重複這種模式。 一般而言,模式是:
- 模型壓縮方法揭示了訓練後的神經網路中的一些常見冗餘。
- 研究了造成這種冗餘的歸納偏差/正則化。
- 從訓練開始,就創建了一種巧妙的優化演算法來訓練沒有這種冗餘的網路。
下表列出了其他類型的模型壓縮,以及為使模型更接近訓練的開始而付出的努力16(成功水平各不相同)
Future Directions
我們真的需要模型壓縮嗎? 這篇文章的標題具有挑釁性,但想法並非如此:通過收緊過度參數化的界限並改善我們的優化方法,我們可以減少或消除對事後模型壓縮的需求。 顯然,在我們有一個明確的答案之前,仍有許多懸而未決的問題需要回答。 以下是我希望在未來幾年完成的一些工作。
超量參數方面
-
我們可以通過窺視數據品質(使用低資源計算)來獲得更緊密的界限嗎?
-
如果我們使用巧妙的優化技巧(如Rigged Lottery13),超參數化界限會如何變化?
-
我們可以得到強化學習環境的過度參數化界限嗎?
-
我們可以將這些範圍擴展到其他常用的體系結構(RNN,Transformers)嗎?
優化方面
-
我們沒有利用的經過訓練的神經網路中還有其他冗餘嗎?
-
使這些變得可行:
從頭開始訓練量化的神經網路。
從頭開始使用低秩矩陣訓練神經網路。
-
弄清楚為什麼知識蒸餾可以改善優化。如果可能的話,使用類似的想法進行優化,同時使用更少的GPU記憶體。
正則化方面
-
哪些類型的正則化會導致哪些類型的模型冗餘?
-
修剪和重新訓練與L0正則化有何關係?哪些隱式正則化導致可修剪性?
-
哪些類型的正則化可以量化?
原文鏈接:
//mitchgordon.me/machine/learning/2020/01/13/do-we-really-need-model-compression.html#fn:lottery-general
本文來源於公眾號CV技術指南的論文分享系列,更多內容請掃描文末二維碼關注公眾號。