淺入淺出 Java 排序演算法
- 2019 年 10 月 3 日
- 筆記
Java String 源碼的排序演算法
一、前言
Q:什麼是選擇問題?
選擇問題,是假設一組 N 個數,要確定其中第 K 個最大值者。比如 A 與 B 對象需要哪個更大?又比如:要考慮從一些數組中找出最大項?
解決選擇問題,需要對象有個能力,即比較任意兩個對象,並確定哪個大,哪個小或者相等。找出最大項問題的解決方法,只要依次用對象的比較(Comparable)能力,循環對象列表,一次就能解決。
那麼 JDK 源碼如何實現比較(Comparable)能力的呢?
二、java.lang.Comparable 介面
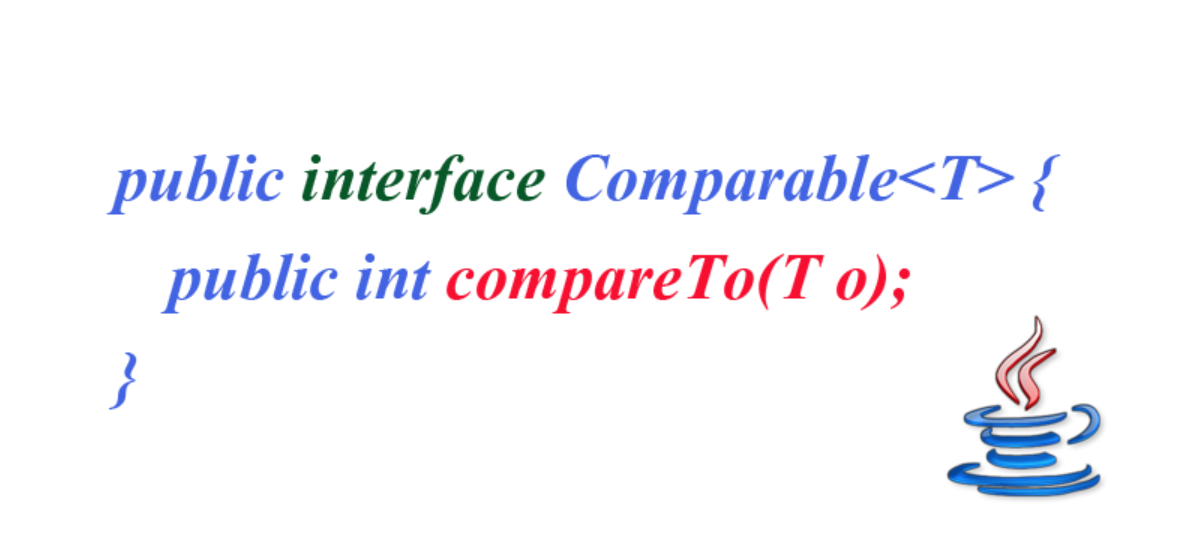
ComparablecompareTo 方法,稱為自然比較法。
該介面只有一個方法 public int compareTo(T o); ,可以看出
- 入參 T o :實現該介面類,傳入對應的要被比較的對象
- 返回值 int:正數、負數和 0 ,代表大於、小於和等於
對象的集合列表(Collection List)或者數組(arrays) ,也有對應的工具類可以方便的使用:
- java.util.Collections#sort(List) 列表排序
- java.util.Arrays#sort(Object[]) 數組排序
那 String 對象如何被比較的?
三、String 源碼中的演算法
String 源碼中可以看到 String JDK 1.0 就有了。那麼應該是 JDK 1.2 的時候,String 類實現了 Comparable 介面,並且傳入需要被比較的對象是 String。對象如圖:
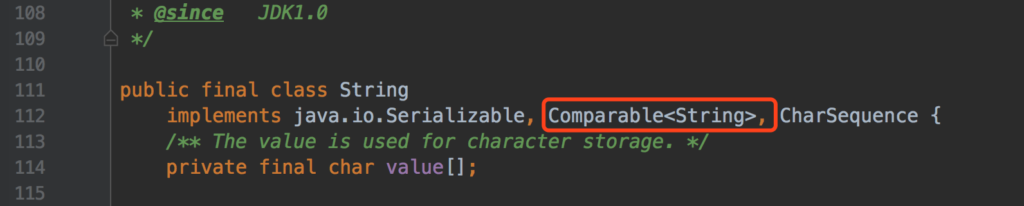
String 是一個 final 類,無法從 String 擴展新的類。從 114 行,可以看出字元串的存儲結構是字元(Char)數組。先可以看看一個字元串比較案例,程式碼如下:
/** * 字元串比較案例 * * Created by bysocket on 19/5/10. */ public class StringComparisonDemo { public static void main(String[] args) { String foo = "ABC"; // 前面和後面每個字元完全一樣,返回 0 String bar01 = "ABC"; System.out.println(foo.compareTo(bar01)); // 前面每個字元完全一樣,返回:後面就是字元串長度差 String bar02 = "ABCD"; String bar03 = "ABCDE"; System.out.println(foo.compareTo(bar02)); // -1 (前面相等,foo 長度小 1) System.out.println(foo.compareTo(bar03)); // -2 (前面相等,foo 長度小 2) // 前面每個字元不完全一樣,返回:出現不一樣的字元 ASCII 差 String bar04 = "ABD"; String bar05 = "aABCD"; System.out.println(foo.compareTo(bar04)); // -1 (foo 的 'C' 字元 ASCII 碼值為 67,bar04 的 'D' 字元 ASCII 碼值為 68。返回 67 - 68 = -1) System.out.println(foo.compareTo(bar05)); // -32 (foo 的 'A' 字元 ASCII 碼值為 65,bar04 的 'a' 字元 ASCII 碼值為 97。返回 65 - 97 = -32) String bysocket01 = "泥瓦匠"; String bysocket02 = "瓦匠"; System.out.println(bysocket01.compareTo(bysocket02));// -2049 (泥 和 瓦的 Unicode 差值) } } 運行結果如下:
0 -1 -2 -1 -32 -2049 可以看出, compareTo 方法是按字典順序比較兩個字元串。具體比較規則可以看程式碼注釋。比較規則如下:
- 字元串的每個字元完全一樣,返回 0
- 字元串前面部分的每個字元完全一樣,返回:後面就是兩個字元串長度差
- 字元串前面部分的每個字元存在不一樣,返回:出現不一樣的字元 ASCII 碼的差值
- 中文比較返回對應的 Unicode 編碼值(Unicode 包含 ASCII)
- foo 的 'C' 字元 ASCII 碼值為 67
- bar04 的 'D' 字元 ASCII 碼值為 68。
- foo.compareTo(bar04),返回 67 - 68 = -1
- 常見字元 ASCII 碼,如圖所示
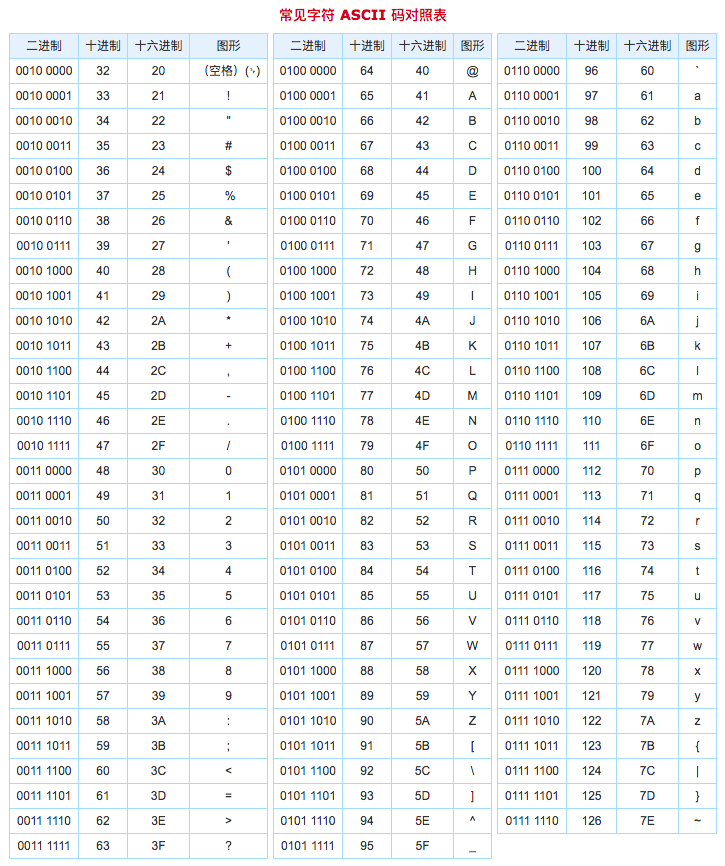
再看看 String 的 compareTo 方法如何實現字典順序的。源碼如圖:
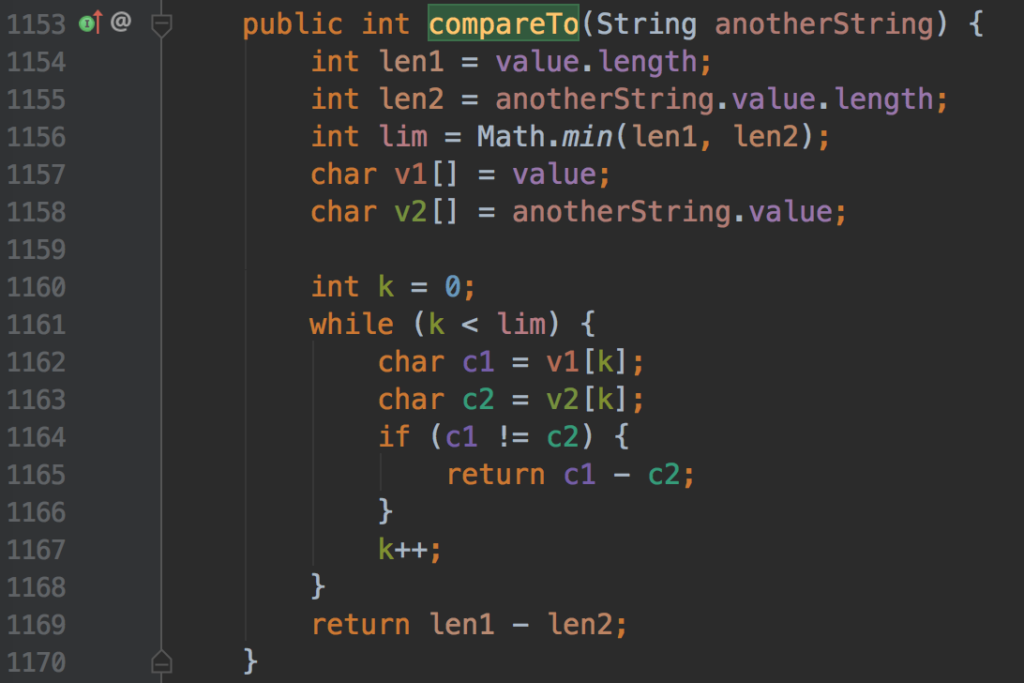
源碼解析如下:
- 第 1156 行:獲取當前字元串和另一個字元串,長度較小的長度值 lim
- 第 1161 行:如果 lim 大於 0 (較小的字元串非空),則開始比較
- 第 1164 行:當前字元串和另一個字元串,依次字元比較。如果不相等,則返回兩字元的 Unicode 編碼值的差值
- 第 1169 行:當前字元串和另一個字元串,依次字元比較。如果均相等,則返回兩個字元串長度的差值
所以要排序,肯定先有比較能力,即實現 Comparable 介面。然後實現此介面的對象列表(和數組)可以通過 Collections.sort(和 Arrays.sort)進行排序。
還有 TreeSet 使用樹結構實現(紅黑樹),集合中的元素進行排序。其中排序就是實現 Comparable 此介面
另外,如果沒有實現 Comparable 介面,使用排序時,會拋出 java.lang.ClassCastException 異常。詳細看《Java 集合:三、HashSet,TreeSet 和 LinkedHashSet比較》https://www.bysocket.com/archives/195
四、小結
上面也說到,這種比較其實有一定的弊端:
- 默認 compareTo 不忽略字元大小寫。如果需要忽略,則重新自定義 compareTo 方法
- 無法進行二維的比較決策。比如判斷 2 * 1 矩形和 3 * 3 矩形,哪個更大?
- 比如有些類無法實現該介面。一個 final 類,也無法擴展新的類。其也有解決方案:函數對象(Function Object)
方法參數:定義一個沒有數據只有方法的類,並傳遞該類的實例。一個函數通過將其放在一個對象內部而被傳遞。這種對象通常叫做函數對象(Funtion Object)
在介面方法設計中,
那插入排序呢?
文章工程:
- JDK 1.8
- 工程名:algorithm-core-learning
- 工程地址:https://github.com/JeffLi1993/algorithm-core-learning
一、前言
上面 Java String 源碼的排序演算法,講了什麼是選擇問題,什麼是比較能力。
選擇問題,是假設一組 N 個數,要確定其中第 K 個最大值者。演算法是為求解一個問題。
那什麼是演算法?
演算法是某種集合,是簡單指令的集合,是被指定的簡單指令集合。確定該演算法重要的指標:
- 第一是否能解決問題;
- 第二演算法運行時間,即解決問題出結果需要多少時間;
- 還有所需的空間資源,比如記憶體等。
很多時候,寫一個工作程式並不夠。因為遇到大數據下,運行時間就是一個重要的問題。
演算法性能用大 O 標記法表示。大 O 標記法是標記相對增長率,精度是粗糙的。比如 2N 和 3N + 2 ,都是 O(N)。也就是常說的線性增長,還有常說的指數增長等
典型的增長率
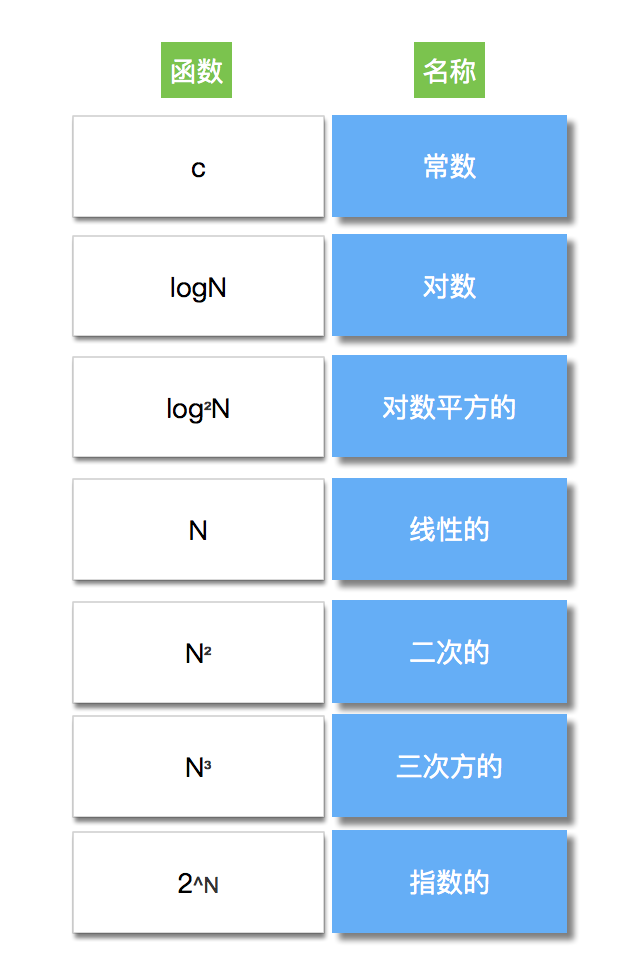
典型的提供性能做法是分治法,即分支 divide and conquer 策略:
- 將問題分成兩個大致相等的子問題,遞歸地對它們求解,這是分的部分;
- 治階段將兩個子問題的解修補到一起,並可能再做些少量的附加工作,最後得到整個問題的解。
二、排序
排序問題,是古老,但一直流行的問題。從 ACM 接觸到現在工作,每次涉及演算法,或品讀 JDK 源碼中一些演算法,經常會有排序的演算法出現。
排序演算法是為了將一組數組(或序列)重新排列,排列後數據符合從大到小(或從小到大)的次序。這樣數據從無序到有序,會有什麼好處?
- 應用層面:解決問題。
- 最簡單的是可以找到最大值或者最小值
- 解決"一起性"問題,即相同標誌元素連在一起
- 匹配在兩個或者更多個文件中的項目
- 通過鍵碼值查找資訊
- 系統層面:減少系統的熵值,增加系統的有序度
(Donald Knuth 的經典之作《電腦程式設計藝術》(The Art of Computer Programming)的第三卷)
通過維基百科查閱資料得到:
在主記憶體中完成的排序叫做,內部排序。那需要在磁碟等其他存儲完成的排序,叫做外部排序 external sorting。資料地址:https://en.wikipedia.org/wiki/External_sorting
上一篇《Java String 源碼的排序演算法》,講到了 java.lang.Comparable 介面。那麼介面是一個抽象類型,是抽象方法(compareTo)的集合,用 interface 來聲明。因此被排序的對象屬於 Comparable 類型,即實現 Comparable 介面,然後調用對象實現的 compareTo 方法進行比較後排序。
在這些條件下的排序,叫作基於比較的排序(comparison-based sorting)
三、插入排序
白話文:熊大(一)、熊二、熊三... 按照身高從低到高排隊(排序)。這時候熊 N 加入隊伍,它從隊伍尾巴開始比較。如果它比前面的熊身高低,則與被比較的交換位置,依次從尾巴到頭部進行比較 & 交換位置。最終換到了應該熊 N 所在的位置。這就是插入排序的原理。
插入排序(insertion sort)
- 最簡單的排序之一。ps: 冒泡排序看看就好,不推薦學習
- 由 N - 1 次排序過程組成。
- 如果被排序的這樣一個元素,就不需要排序。即 N =1 (1 - 1 = 0)
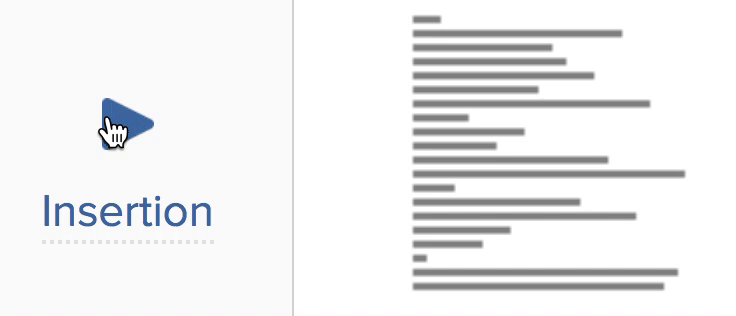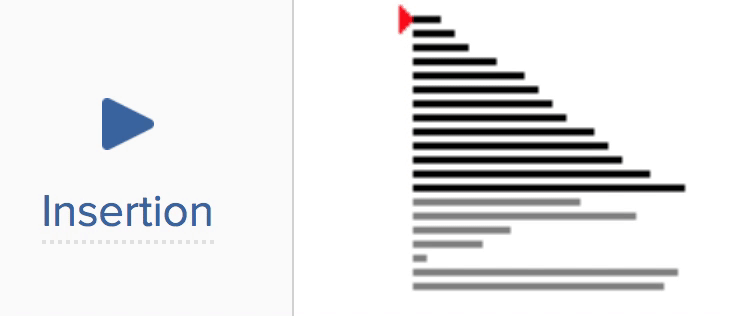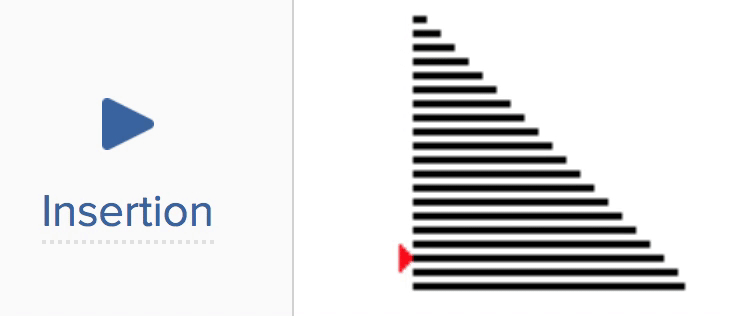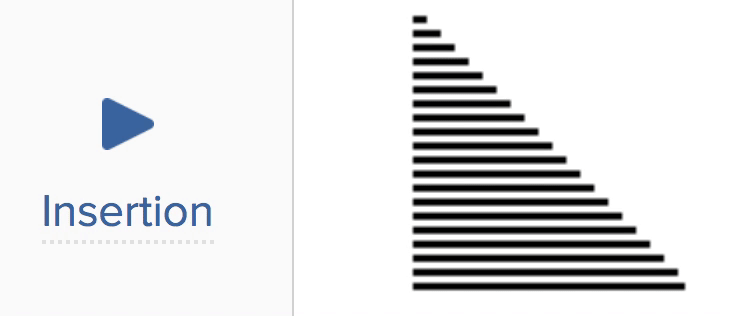
- 每一次排序保證,從第一個位置到當前位置的元素為已排序狀態。
- 如圖:每個元素往前進行比較,並終止於自己所在的位置
/** * 插入排序案例 * <p> * Created by 泥瓦匠@bysocket.com on 19/5/15. */ public class InsertionSortingDemo { /** * 插入排序 * * @param arr 能比較的對象數組 * @param <T> 已排序的對象數組 */ public static <T extends Comparable> void insertionSort(T[] arr) { int j; // 從數組第二個元素開始,向前比較 for (int p = 1; p < arr.length; p++) { T tmp = arr[p]; // 循環,向前依次比較 // 如果比前面元素小,交換位置 for (j = p; (j > 0) && (tmp.compareTo(arr[j - 1]) < 0); j--) { arr[j] = arr[j - 1]; } // 如果比前面元素大或者相等,那麼這就是元素的位置,交換 arr[j] = tmp; } } public static void main(String[] args) { Integer[] intArr = new Integer[] {2, 3, 1, 4, 3}; System.out.println(Arrays.toString(intArr)); insertionSort(intArr); System.out.println(Arrays.toString(intArr)); } }程式碼解析如下:
- 從數組的第二個元素,向前開始比較。比第一個元素小,則交換位置
- 如果第二個元素比較完畢,那就第三個,第四個... 以此類推
- 比較到最後一個元素時,完成排序
時間複雜度是 O(N^2),最好情景的是排序已經排好的,那就是 O(N),因為滿足不了循環的判斷條件;最極端的是反序的數組,那就是 O(N^2)。所以該演算法的時間複雜度為 O(N^2)
運行 main 方法,結果如下:
[2, 3, 1, 4, 3] [1, 2, 3, 3, 4]再考慮考慮優化,會怎麼優化呢?
插入排序優化版 不是往前比較 。往前的一半比較,二分比較會更好。具體程式碼,可以自行試試
四、Array.sort 源碼中的插入排序
上面用自己實現的插入演算法進行排序,其實 JDK 提供了 Array.sort 方法,方便排序。案例程式碼如下:
/** * Arrays.sort 排序案例 * <p> * Created by 泥瓦匠@bysocket.com on 19/5/28. */ public class ArraysSortDemo { public static void main(String[] args) { Integer[] intArr = new Integer[] {2, 3, 1, 4, 3}; System.out.println(Arrays.toString(intArr)); Arrays.sort(intArr); System.out.println(Arrays.toString(intArr)); } }運行 main 方法,結果如下:
[2, 3, 1, 4, 3] [1, 2, 3, 3, 4]那 Arrays.sort 是如何實現的呢?JDK 1.2 的時候有了 Arrays ,JDK 1.8 時優化了一版 sort 演算法。大致如下:
- 如果元素數量小於 47,使用插入排序
- 如果元素數量小於 286,使用快速排序
- Timsort 演算法整合了歸併排序和插入排序
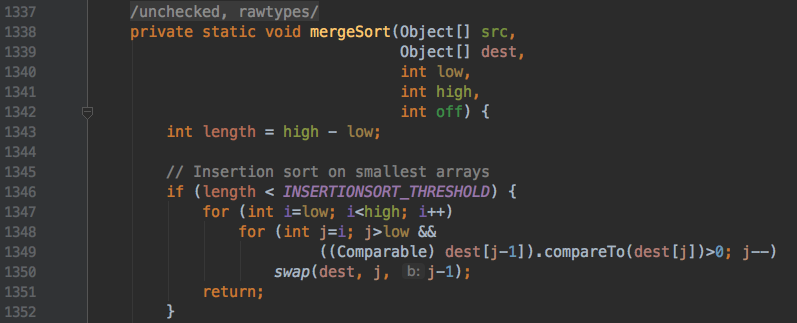
源碼中我們看到了 mergeSort 裡面整合了插入排序演算法,跟上面實現的異曲同工。這邊就不一行一行解釋了。
五、小結
演算法是解決問題的。所以不一定一個演算法解決一個問題,可能多個演算法一起解決一個問題。達到問題的最優解。插入排序,這樣就這麼簡單
程式碼示例
本文示例讀者可以通過查看下面倉庫的中: StringComparisonDemo 字元串比較案例案例:
- Github:https://github.com/JeffLi1993/algorithm-core-learning
- Gitee:https://gitee.com/jeff1993/algorithm-core-learning
參考資料
- 《數據結構與演算法分析:Java語言描述(原書第3版)》
- https://en.wikipedia.org/wiki/Unicode
- https://www.cnblogs.com/vamei/tag/%E7%AE%97%E6%B3%95/
- https://www.bysocket.com/archives/2314/algorithm