java面試系列<2>——java容器
1、概覽
容器主要包括Collection和Map兩種,Collection存儲著對象的集合,而map存儲著鍵值對(兩個對象)的映射表
Collection
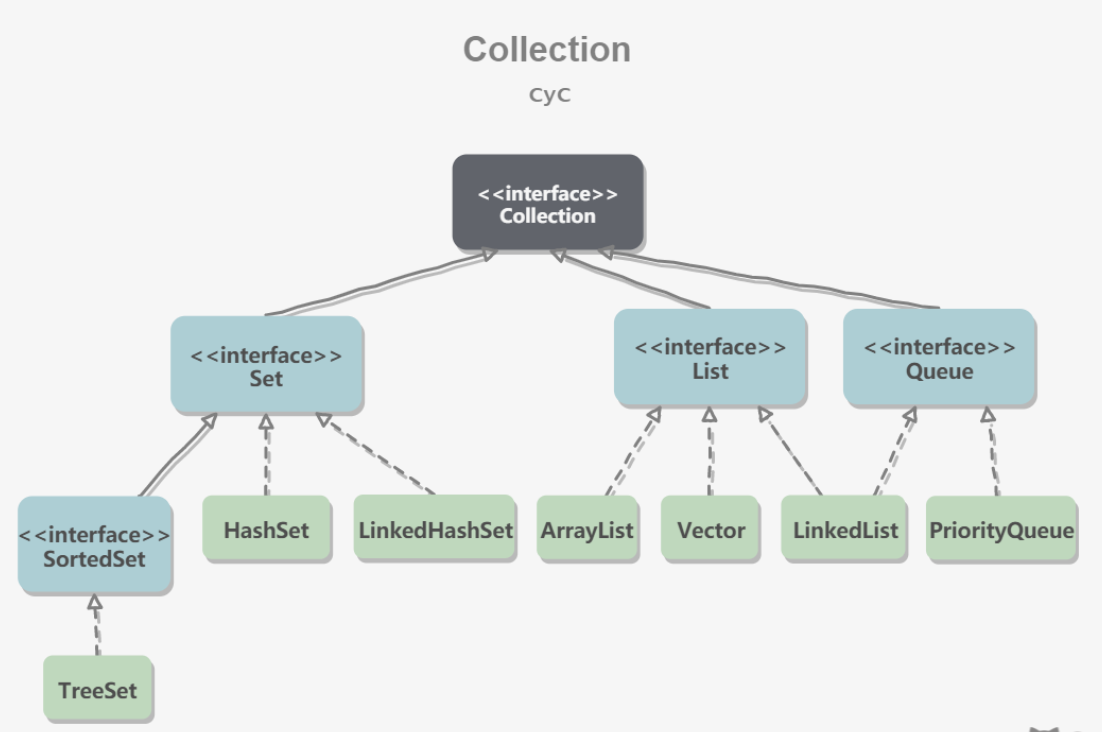
1、set
- TreeSet:基於紅黑樹實現,支援有序操作,。查找效率不如HashSet,HashSet查找的時間複雜度為O(1),TreeSet則為O(logN)。
- HashSet:基於哈希表實現,支援快速查找,但不支援有序性操作。並且失去元素的插入順序資訊,即遍歷HashSet時候得到的結果是不確定的。
- LinkeHashSet:具有HashSet的查找效率,並且內部使用雙向鏈表維護元素的插入順序。
2、List
- ArrayList:基於動態數組實現,支援隨機訪問
- Vector:和ArrayList類型,但它是執行緒安全的。
- LinkedList:基於雙向鏈表實現,只能順序訪問,但是可以快速地在鏈表中間插入和刪除元素。不僅如此,LinkedList還可以用作棧、隊列和雙向隊列。
3、Queue
- LinkedList:可以用它來實現雙向隊列
- PriorityQueue:基於堆結構實現,可以用它來實現優先隊列。
Map
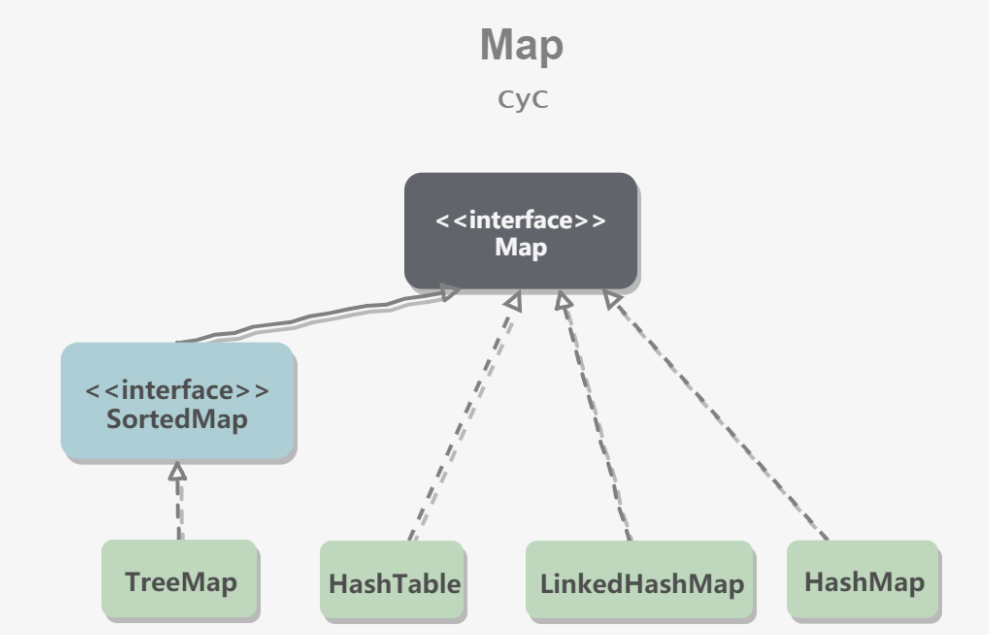
- TreeMap:基於紅黑樹實現。
- HashMap:基於哈希表實現。
- HashTable:和HashMap類似,但它是執行緒安全的,這意味著同一時刻多個縣城同時寫入HashTable不會導致數據不一致。遺留類,不應該使用,而是使用 ConcurrentHashMap 來支援執行緒安全,ConcurrentHashMap 的效率會更高,因為 ConcurrentHashMap 引入了分段鎖。
- LinkedHashMap:使用雙向鏈表來維護元素的順序,順序為插入順序或者最近最少使用(LRU)順序。
2、設計模式
迭代器模式:
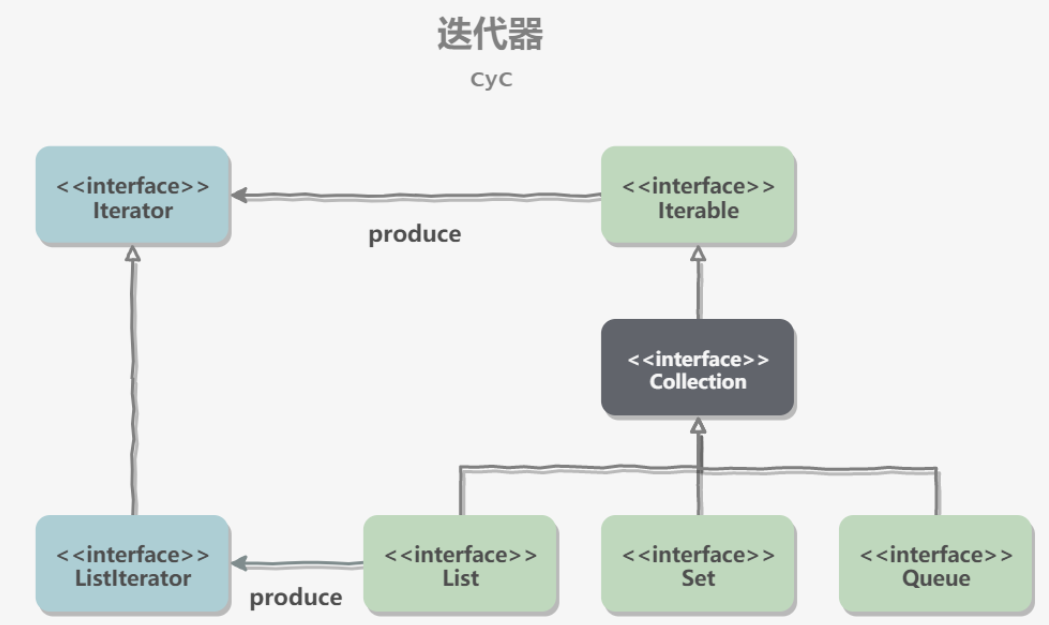
Collection繼承了Iterable介面,其中的iterator()方法能夠產生一個Iterator對象,通過這個對象就可以迭代遍歷Collection中的元素。
適配器模式
java.Util.Arrays.asList()可以把數組類型轉換為List類型。
應該注意的是 asList() 的參數為泛型的變長參數,不能使用基本類型數組作為參數,只能使用相應的包裝類型數組。
3、源碼分析
ArrayList
1、概述
因為ArrayList是基於數組實現的,所以支援快速隨機訪問。
數組的默認大小為10.
private static final int DEFAULT_CAPACITY = 10;
2、擴容
添加元素時候使用ensureCapacityInternal()方法來保證容量足夠,需要使用grow()方法進行擴容,新容量的大小為(oldCapacity+oldCapacity/2)。因此,新容量大約是舊容量的1.5倍左右。 (oldCapacity 為偶數就是 1.5 倍,為奇數就是 1.5 倍-0.5)。
擴容時候,需要調用操作Arrays.copyOf()把原數組整個複製到新數組中,整個操作代價高,因此最好在創建ArrayList對象時候就指定大概的容量大小,減少擴容次數。
3、刪除元素
需要調用System.arraycopy()將index+1後面的元素都複製到index位置上,該操作的時間複雜度是O(N),因此ArrayList刪除元素的代價是很高的。
Vector
它的實現與ArrayList類似,但是使用了synchronized進行同步。
public synchronized boolean add(E e) {
    modCount++;
    ensureCapacityHelper(elementCount + 1);
    elementData[elementCount++] = e;
    return true;
}

public synchronized E get(int index) {
    if (index >= elementCount)
        throw new ArrayIndexOutOfBoundsException(index);

    return elementData(index);
}
2、擴容
Vector的可以傳入 capacityIncrement 參數,可以使在擴容時使容量增長 capacityIncrement 。如果這個參數值小於或等於0,擴容時每次擴容兩倍。
3、與ArrayList的比較
- Vector是同步的,因此開銷就比ArrayList大,訪問速度更慢。最好使用ArrayList而不是Vector,因為同步操作可以由程式設計師控制。
- Vector每次擴容請求其大小2倍,而ArrayList是1.5倍。
4、替代方案
可以使用Collections.synchronizedList();得到一個執行緒安全的ArrayList
List<String> list = new ArrayList<>();
List<String> synList = Collections.synchronizedList(list);
List<String> list = new CopyOnWriteArrayList<>();
CopyOnWriteArrayList
1、讀寫分離
寫操作在一個複製的數組上進行,讀操作是在原始數組,讀寫分離,互不影響。
寫操作需要加鎖,防止並發寫入時導致寫入數據丟失
寫操作結束後需要把原始數組指向新的複製數組
2、適用場景
CopyOnWriteArrayList 在寫操作的同時允許讀操作,大大提高了讀操作的性能,因此很適合讀多寫少的應用場景。
缺陷
- 記憶體佔用:在寫操作的同時需要複製一個新的數組,記憶體佔用為原來的兩倍
- 數據不一致:讀操作不能讀取實時性的數據,因為部分寫操作的數據還未同步到讀數組中。
所以CopyOnWriteArrayList不適合記憶體敏感以及對實時性要求很高的場景。
LinkedList
基於雙向鏈表實現,使用Node存儲鏈表節點資訊。
與ArrayList比較
ArrayList基於動態數組實現,LinkedList基於雙向鏈表實現。ArrayList和LinkedList的區別可以歸結為數組和鏈表的區別:
- 數組支援隨機訪問,但插入刪除的代價很高,需要移動大量元素
- 鏈表不支援隨機訪問,但插入刪除只需要改變指針。
HashMap
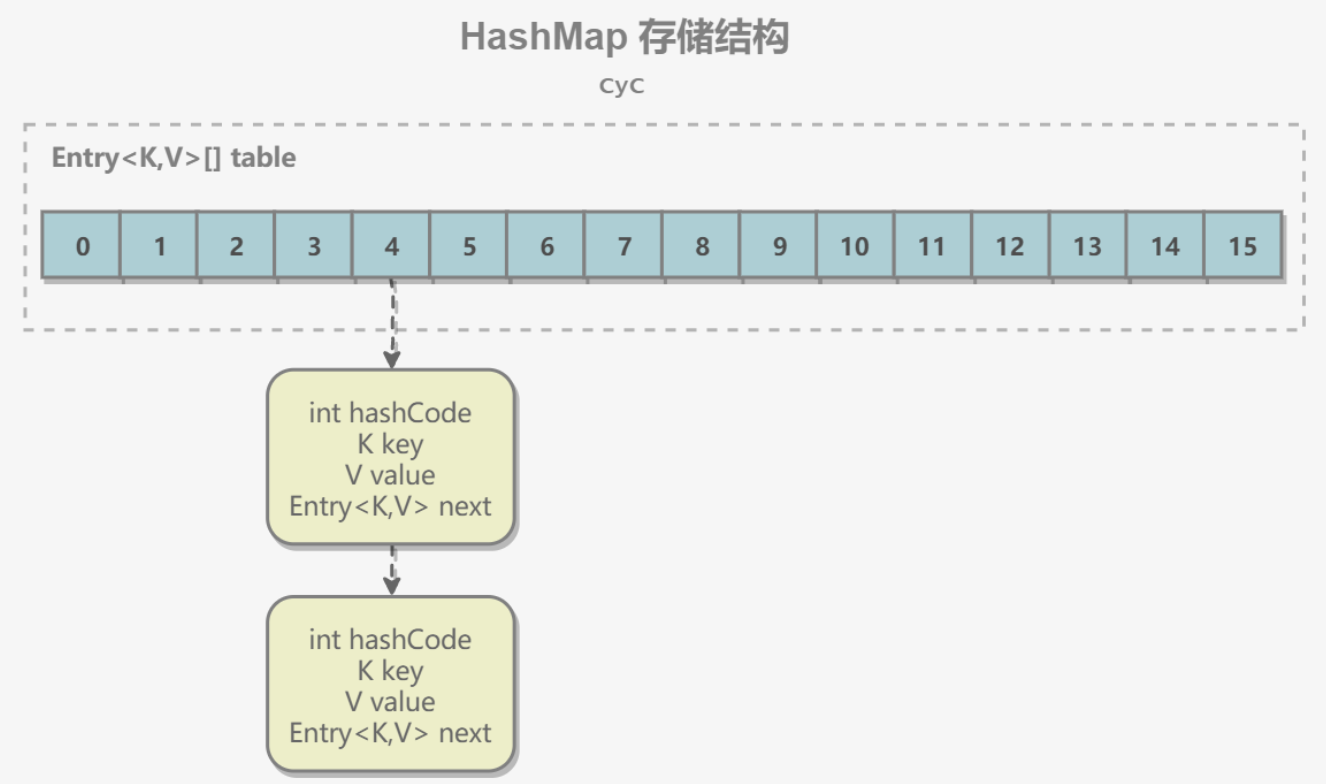
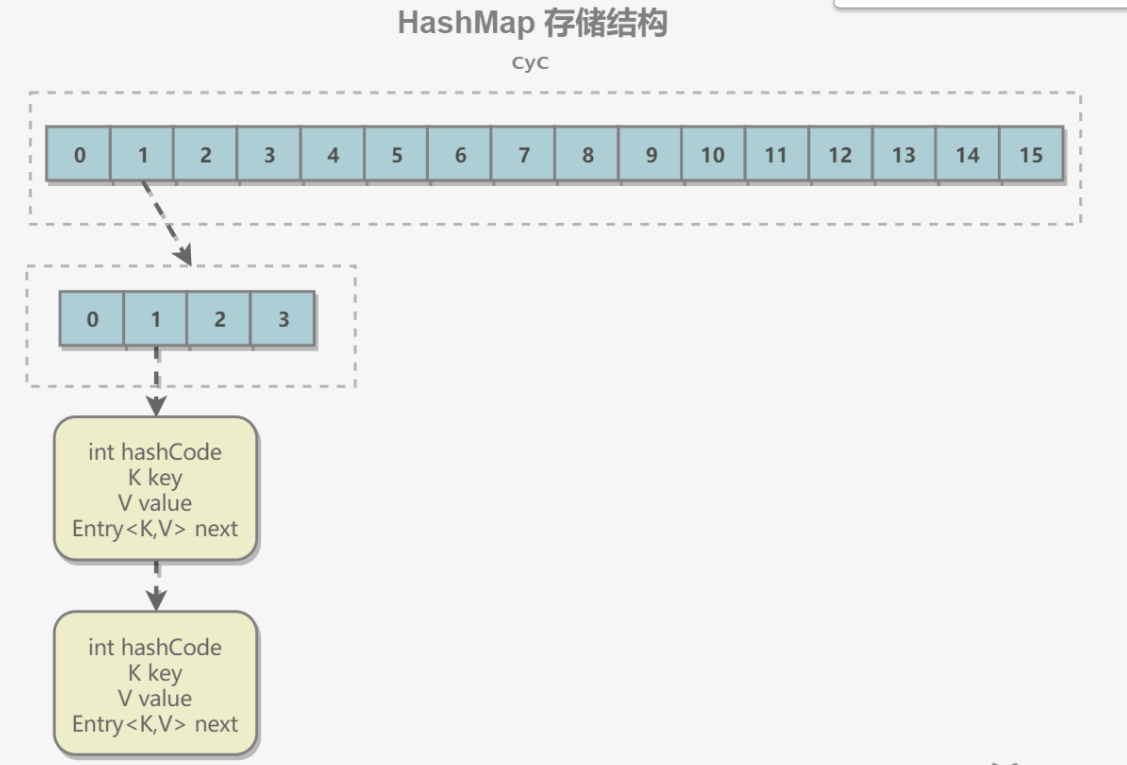
內部包含了一個 Entry 類型的數組 table。Entry 存儲著鍵值對。它包含了四個欄位,從 next 欄位我們可以看出 Entry 是一個鏈表。即數組中的每個位置被當成一個桶,一個桶存放一個鏈表。HashMap 使用拉鏈法來解決衝突,同一個鏈表中存放哈希值和散列桶取模運算結果相同的 Entry。
2、拉鏈法工作原理
- 新建一個 HashMap,默認大小為 16;
- 插入 <K1,V1> 鍵值對,先計算 K1 的 hashCode 為 115,使用除留餘數法得到所在的桶下標 115%16=3。
- 插入 <K2,V2> 鍵值對,先計算 K2 的 hashCode 為 118,使用除留餘數法得到所在的桶下標 118%16=6。
- 插入 <K3,V3> 鍵值對,先計算 K3 的 hashCode 為 118,使用除留餘數法得到所在的桶下標 118%16=6,插在 <K2,V2> 前面。
應該注意到鏈表的插入是以頭插法方式進行的,例如上面的 <K3,V3> 不是插在 <K2,V2> 後面,而是插入在鏈表頭部。
查找需要分成兩步進行:
- 計算鍵值對所在的桶;
- 在鏈表上順序查找,時間複雜度顯然和鏈表的長度成正比。
HashMap 允許插入鍵為 null 的鍵值對。但是因為無法調用 null 的 hashCode() 方法,也就無法確定該鍵值對的桶下標,只能通過強制指定一個桶下標來存放。HashMap 使用第 0 個桶存放鍵為 null 的鍵值對。
3、擴容
設 HashMap 的 table 長度為 M,需要存儲的鍵值對數量為 N,如果哈希函數滿足均勻性的要求,那麼每條鏈表的長度大約為 N/M,因此查找的複雜度為 O(N/M)。
為了讓查找的成本降低,應該使 N/M 儘可能小,因此需要保證 M 儘可能大,也就是說 table 要儘可能大。HashMap 採用動態擴容來根據當前的 N 值來調整 M 值,使得空間效率和時間效率都能得到保證。
4、擴容-重新計算桶下標
在進行擴容時,需要把鍵值對重新計算桶下標,從而放到對應的桶上。在前面提到,HashMap 使用 hash%capacity 來確定桶下標。HashMap capacity 為 2 的 n 次方這一特點能夠極大降低重新計算桶下標操作的複雜度。
假設原數組長度 capacity 為 16,擴容之後 new capacity 為 32:
對於一個 Key,它的哈希值 hash 在第 5 位:
- 為 0,那麼 hash%00010000 = hash%00100000,桶位置和原來一致;
- 為 1,hash%00010000 = hash%00100000 + 16,桶位置是原位置 + 16。
5、鏈錶轉紅黑樹
從JDK1.8開始,一個桶存儲的鏈表長度大於等於8時會將鏈錶轉為紅黑樹。
6、與Hashtable的比較
- Hashtable使用synchronized來進行同步
- HashMap可以插入鍵為null的Entry
- HashMap是無序的
ConcurrentHashMap
ConcurrentHashMap 和 HashMap 實現上類似,最主要的差別是 ConcurrentHashMap 採用了分段鎖(Segment),每個分段鎖維護著幾個桶(HashEntry),多個執行緒可以同時訪問不同分段鎖上的桶,從而使其並發度更高(並發度就是 Segment 的個數)。
LinkedHashMap
存儲結構
繼承自HashMap,因此具有和HashMap一樣的快速查找特性。
內部維護了一個雙向鏈表,用來維護插入順序或者 LRU 順序。
LinkedHashMap 最重要的是以下用於維護順序的函數,它們會在 put、get 等方法中調用。
void afterNodeAccess(Node<K,V> p) { }
void afterNodeInsertion(boolean evict) { }
afterNodeAccess()
當一個節點被訪問時,如果 accessOrder 為 true,則會將該節點移到鏈表尾部。也就是說指定為 LRU 順序之後,在每次訪問一個節點時,會將這個節點移到鏈表尾部,保證鏈表尾部是最近訪問的節點,那麼鏈表首部就是最近最久未使用的節點。
afterNodeInsertion()
在 put 等操作之後執行,當 removeEldestEntry() 方法返回 true 時會移除最晚的節點,也就是鏈表首部節點 first。
evict 只有在構建 Map 的時候才為 false,在這裡為 true。
