Java常用類庫與技巧
Java異常
異常處理機制主要回答了三個問題
What:異常類型回答了什麼被拋出
Where:異常堆棧跟蹤回答了在哪拋出
Why:異常資訊回答了為什麼被拋出
Java的異常體系
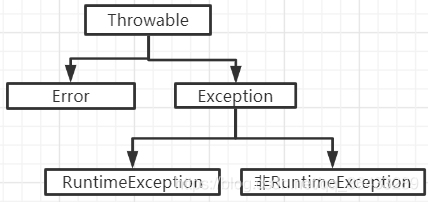

Error和Exception的區別
從概念角度解析Java的異常處理機制:
1.Error:程式無法處理的系統處理,編輯器不做檢查(如系統崩潰,虛擬機錯誤,記憶體空間不足,方法調用棧溢出等)
2.Exception:程式可以處理的異常,捕獲後可能恢復
- RuntimeException:不可預知的,程式應當自行避免
- 非RuntimeException:可預知的,從編譯器校驗的異常
從責任角度看:
1.Error屬於JVM需要負擔的責任
2.RuntimeException是程式應該負擔的責任
3.Checked Exception可檢查異常是Java編譯器應該負擔的責任(編譯時就應該捕獲或者拋出的異常)
常見Error以及Exception
RuntimeException
1.NullPointerException - 空指針引用異常
2.ClassCastException - 類型強制轉換異常
3.IllegalArgumentException - 傳遞非法參數異常
4.IndexOutOfBoundsException - 下標越界異常
5.NumberFormatException - 數字格式異常
非RuntimeException
1.ClassNotFoundException - 找不到指定class的異常
2.IOException - IO操作異常
3.SQLException - SQL異常
Error
1.NoClassDefFoundError - 找不到class定義的異常(原因:類依賴的class或者jar不存在;類文件存在,但是存在不同的域中;大小寫問題,javac編譯的時候是無視大小寫的,很有可能編譯出來的class文件就與想要的不一樣)
2.StackOverflowError - 深遞歸導致棧被耗盡而拋出的異常
3.OutOfMemoryError - 記憶體溢出異常
Java的異常處理機制
- 拋出異常:創建異常對象,交由運行時系統處理
- 捕獲異常:尋找合適的異常處理器處理異常,否則終止運行
private static int doSomething(){
   try {
      int i = 10/0;
      System.out.println("i= " + i);
   } catch (ArithmeticException e) {
      System.out.println("ArithmeticException: " + e);
      return 0;
   } catch (Exception e) {
      System.out.println("Exception: " + e);
      return 1;
   } finally {
      System.out.println("Finally");
      return 2;
   }
}

public static void main(String[] args) {
   System.out.println("執行後的值為:" + doSomething());
   System.out.println("執行結束");
}
執行結果
ArithmeticException: java.lang.ArithmeticException: / by zero
Finally
執行後的值為:2
執行結束
注意
盡量細化異常,別拋出異常的父類,也是為了方便定位問題
避免在finally中寫return語句,其他return不會執行
Java異常的處理原則
- 具體明確:拋出的異常應能通過異常類名和message準確說明異常的類型和產生異常的原因
- 提早拋出:應儘可能早的發現並拋出異常,便於精確定位問題
- 延遲捕獲:異常的捕獲和處理應儘可能延遲,讓掌握更多資訊的作用域來處理異常
高效主流的異常處理框架
在用戶看來,應用系統發生的所有異常都是應用系統內部的異常
- 設計一個通用的繼承自RuntimeException的異常來統一處理
- 其餘異常都統一轉譯為上述異常AppException
- 在catch之後,拋出上述異常的子類,並提供足以定位的資訊
- 由前端接收AppException做統一處理
看看try-catch的性能問題
private static void testException(String[] array){
   try {
      System.out.println(array[0]);
   }catch (NullPointerException e){
      System.out.println("array cannot be null");
   }
}


private static void testIf(String[] array){
   if (array != null){
      System.out.println(array[0]);
   } else {
      System.out.println("array cannot be null");
   }
}


public static void main(String[] args) {
   long start = System.nanoTime();
   testException(null);
   System.out.println("testException cost " + (System.nanoTime() - start));
}

// 運行結果
array cannot be null
testException cost 322997


public static void main(String[] args) {
   long start = System.nanoTime();
   testIf(null);
   System.out.println("testIf cost " + (System.nanoTime() - start));
}

// 運行結果
array cannot be null
testIf cost 238152
Java異常處理消耗性能的地方
- try-catch塊影響JVM的優化
- 異常對象實例需要保持棧快照等資訊,開銷較大
Java集合框架
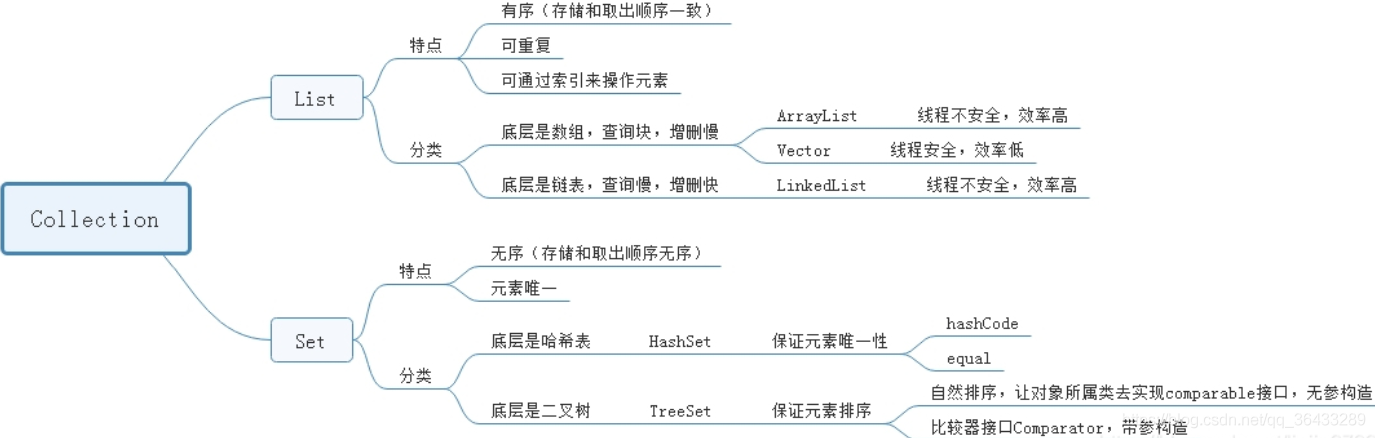
集合之List和Set
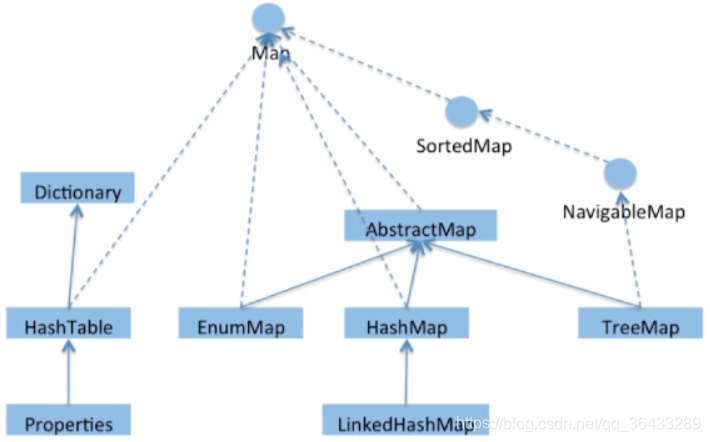
集合之Map
HashMap、HashTable、ConcurrentHashMap
HashMap
Java8以前(不包含):數組+鏈表
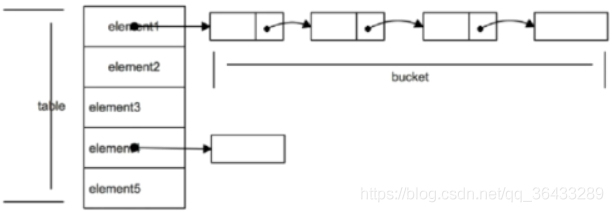
數組長度默認是16,數組中每個元素存儲著鏈表的頭節點,通過hash(key.hashCode())%len(哈希函數取模操作)獲得添加元素所要存放的數組的位置。
有個問題,如果哈希函數計算的值一直是同一個,會導致bucket(桶)過長,鏈表查詢,就需要從頭部開始遍歷,最壞的情況下,性能會從O(1)變成O(n)。
Java8以後:數組+鏈表+紅黑樹
Java8之後做了調整,會通過一個常量TREEIFY_THRESHOLD控制是否將鏈接轉成紅黑樹,性能從O(n)提高到O(logn)
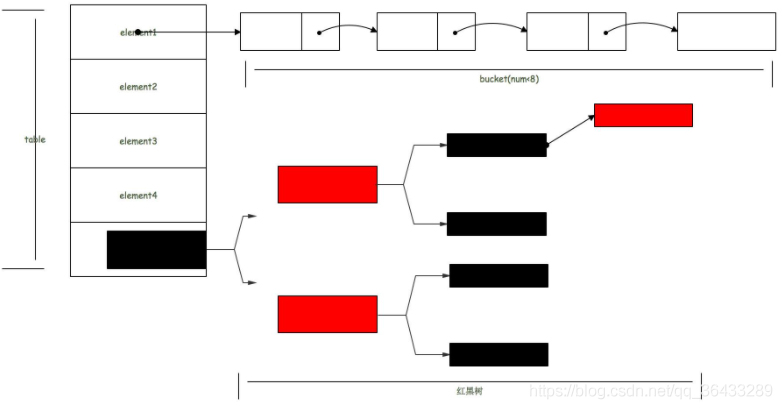
HashMap使用懶載入,首次使用才初始化
HashMap:put方法的邏輯
1、如果HashMap未被初始化過,則初始化
2、對Key求Hash值,然後計算下標
3、如果沒有碰撞,直接放入桶中
4、如果碰撞了,以鏈表的方式鏈接到後面
5、如果鏈表長度超過閾值,就把鏈錶轉成紅黑樹
6、如果鏈表長度低於6,就把紅黑樹轉回鏈表
7、如果節點已經存在就替換舊值
8、如果桶滿了(容量16*載入因子0.75),就需要resize(擴容2倍後重排)
HashMap:如何有效減少碰撞
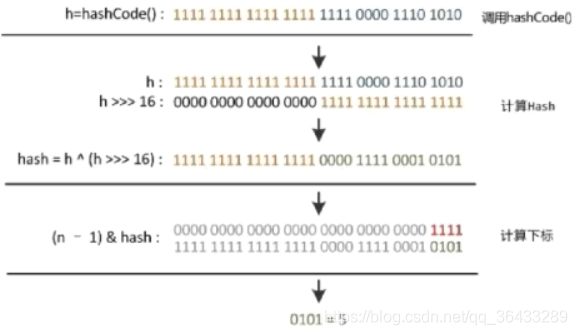
- 擾動函數:促使元素位置分布均勻,減少碰撞幾率(兩個不相等的對象返回不同的哈希值)
- 使用final對象,並採用合適的equals()和hashCode()方法
HashMap:從獲取hash到散列的過程
HashMap:擴容問題
- 多執行緒環境下,調整大小會存在條件競爭,容易造成死鎖
- rehashing是一個比較耗時的過程
Hashtable
注意點
- 多執行緒安全,鎖住整個HashTable,力度大
- 底層:數組+鏈表
- 無論key還是value都不能為null
如何優化Hashtable
通過鎖細粒度化,將整鎖拆解成多個鎖進行優化,所以出現了ConcurrentHashMap
ConcurrentHashMap
早期的ConcurrentHashMap:通過分段鎖Segment來實現
數組+鏈表
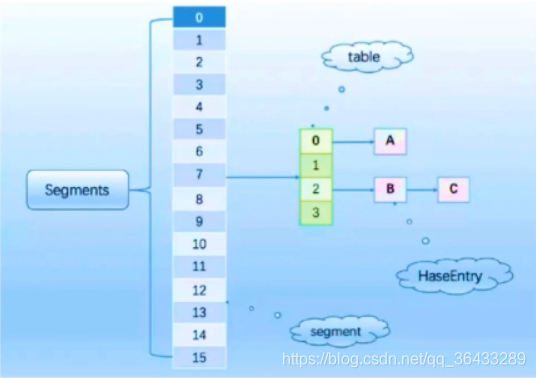
當前的ConcurrentHashMap:CAS+synchronized使鎖更細化
數組+鏈表+紅黑樹
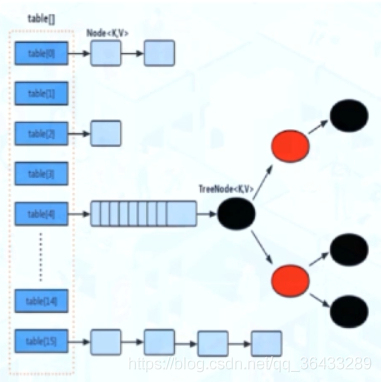
ConcurrentHashMap:put方法的邏輯
1.判斷Node[]數組是否初始化,沒有則進行初始化操作
2.通過hash定位數組的索引坐標,是否有Node節點,如果沒有則使用CAS進行添加(鏈表的頭節點),添加失敗則進入下次循環
3.檢查到內部正在擴容,就幫助它一塊擴容。
4.如果f!=null,則使用synchronized鎖住f元素(鏈表/紅黑二叉樹的頭元素)
4.1如果是Node(鏈表結構)則執行鏈表的添加操作
4.2如果是TreeNode(樹型結構)則執行樹添加操作
5.判斷鏈表長度已經達到臨界值8(默認值),當節點數超過這個值就需要把鏈錶轉換為樹結構
ConcurrentHashMap總結
- 比起Segment,鎖拆得更細
- 首先使用無鎖操作CAS插入頭節點,失敗則循環重試
- 若頭節點已存在,則嘗試獲取頭節點的同步鎖,再進行操作
HashMap、Hashtable、ConcurrentHashMap區別
- HashMap執行緒不安全,數組+鏈表+紅黑樹
- Hashtable執行緒安全,鎖住整個對象,數組+鏈表
- ConcurrentHashMap執行緒安全,CAS+同步鎖,數組+鏈表+紅黑樹
- HashMap的key、value均可為null,而其他的兩個類不支援
J.U.C知識點梳理
java.util.concurrent:提供了並發編程的解決方案
- CAS是java.util.concurrent.atomic包的基礎
- AQS是java.util.concurrent.locks包以及一些常用類比如Semophore,ReentrantLock等類的基礎
J.U.C包的分類
- 執行緒執行器executor
- 鎖locks
- 原子變數類atomic
- 並發工具類tools
- 並發集合collections
並發工具類
- 閉鎖CountDownLatch
- 柵欄CyclicBarrier
- 訊號量Semaphore
- 交換器Exchanger
CountDownLatch
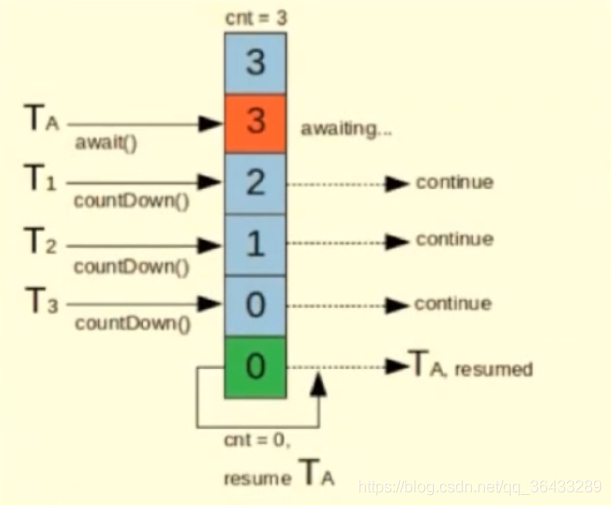
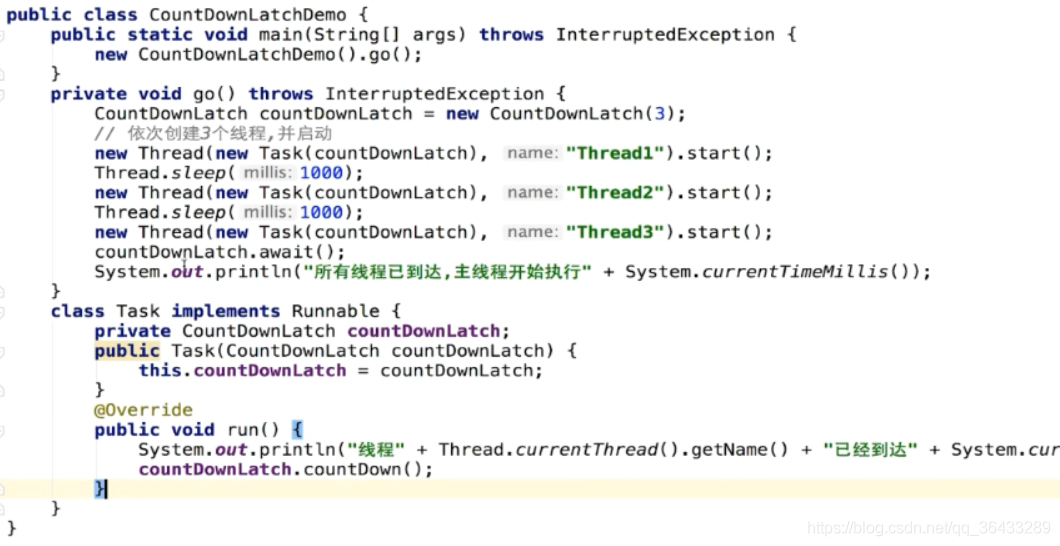
讓主執行緒等待一組事件發生後繼續執行,事件指的是CountDownLatch里的countDown()方法
CyclicBarrier
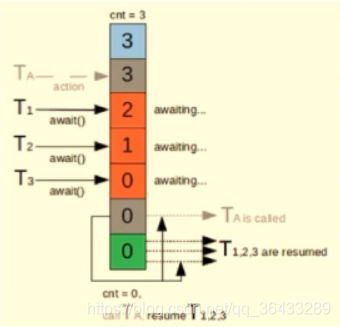
阻塞當前執行緒,等待其他執行緒
- 等待其它執行緒,且會阻塞自己當前執行緒,所有執行緒必須同時到達柵欄位置後,才能繼續執行
- 所有執行緒到達柵欄處,可以觸發執行另外一個預先設置的執行緒
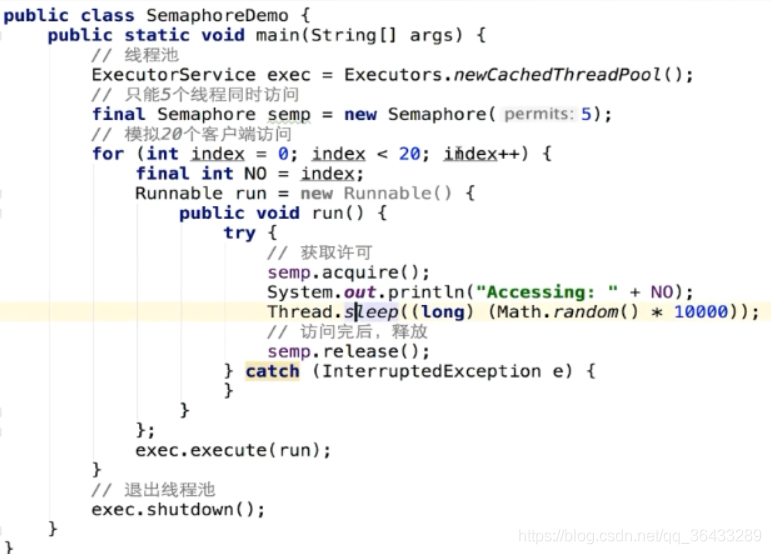
Semaphore
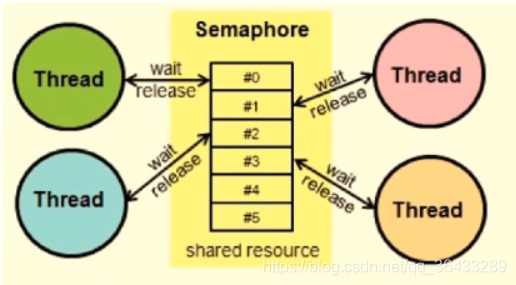
控制某個資源可被同時訪問的執行緒個數
Exchanger
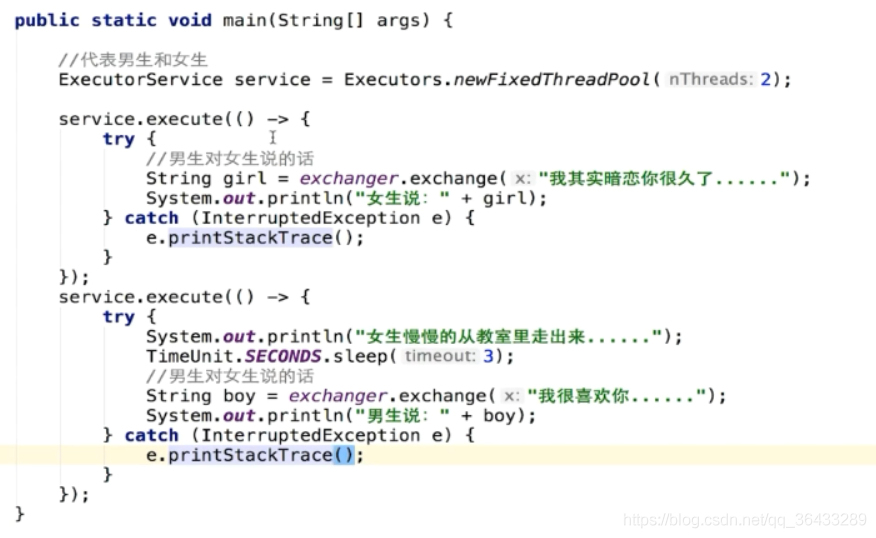
主要用於執行緒間的數據交換,它提供一個同步點,一個執行緒到達同步點就會被阻塞,直到另外一個執行緒進入到同步點為止,兩個執行緒到達同步點後,相互交換數據。

BlockingQueue
提供可阻塞的入隊和出隊操作,如果隊列滿了,入隊操作將阻塞,直到有空間可用,如果隊列空了,出隊操作將阻塞,直到有元素可用。
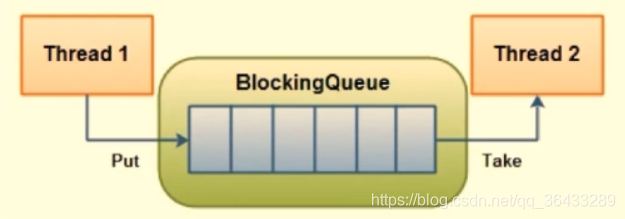
主要用於生產者-消費者模式,在多執行緒場景時生產者執行緒在隊列尾部添加元素,而消費者執行緒則在隊列頭部消費元素,通過這種方式能夠達到將任務的生產和消費進行隔離的目的
主要有以下七個隊列實現,都是執行緒安全的
1、ArrayBlockingQueue:一個由數組結構組成的有界阻塞隊列(有界指的是容量大小有限制,先進先出)
2、LinkedBlockingQueue:一個由鏈表結構組成的有界/無界阻塞隊列(先進先出)
3、PriorityBlockingQueue:一個支援優先順序排序的無界阻塞隊列
4、DealyQueue:一個使用優先順序隊列實現的無界阻塞隊列
5、SynchronousQueue:一個不存儲元素的阻塞隊列
6、LinkedTransferQueue:一個由鏈表結構組成的無界阻塞隊列
7、LinkedBlockingDeque:一個由鏈表結構組成的雙向阻塞隊列
Java的IO機制
BIO
Block-IO:其實是傳統的java.net,java.io包下的介面或者類,比如java.net下的socket,servletSocket和http,因為網路通訊都是IO行為,所以可以說是BIO的範疇,傳統的IO基於位元組流和字元流進行操作,比如InputStream和OutputStream,Reader和Writer。
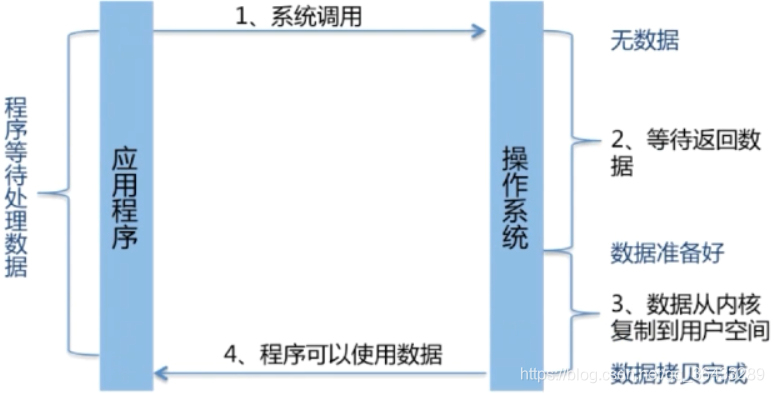
BIO是基於流模型實現的,這意味著其交互方式是同步阻塞的,在讀取輸入流或者寫入輸出流時,在讀寫操作完成之前,執行緒會一直阻塞,它們之間的調用是可靠的線性順序,程式發送請求給內核,然後由內核進行通訊,在內核準備好數據之前,執行緒是被掛起的,所以在兩個階段,程式都處於掛起狀態,類比成ClientServlet模式,其實現模式為一個連接一個執行緒,即客戶端有連接請求時,則服務端啟動一個執行緒處理,待作業系統返回結果,如果這個連接不做任何事情,會造成不必要的執行緒開銷,當然,我們可以通過執行緒池機制來改善。
特點:在IO執行的階段,都被阻塞住了
好處:程式碼比較簡單
缺點:IO擴展性和效率存在瓶頸
NIO(Java4)
NonBlock-IO:構建多路復用的、同步非阻塞的IO操作,提供了更接近作業系統底層的高性能數據操作方式
特點:程式要不斷去詢問內核是否準備好

NIO核心
- Channels
- Buffers
- Selectors
AIO
Asynchronous IO:基於事件和回調機制

AIO如何進一步加工處理結果
- 基於回調:實現CompletionHandler介面,調用時觸發回調函數
- 返回Future:通過isDone()查看是否準備好,通過get()等待返回數據
區別
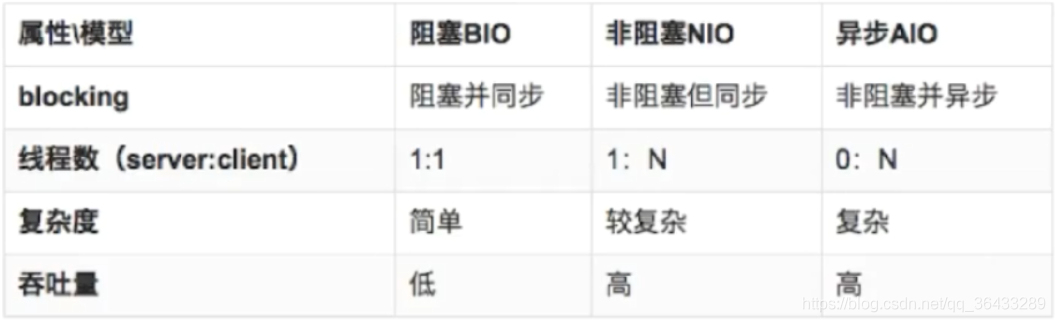
AIO連server都免了,所以是0:N
BIO適用於連接數少且固定的架構,這種方式對伺服器的資源要求較高,1.4之前的唯一選擇
NIO適用於連接數多且短的架構,比如聊天伺服器,編程複製
AIO適用於連接數多且長的架構,比如相冊伺服器,可以充分調用OS來參與並發操作,編程複製,1.7才出現的

