從本質徹底精通Git——4個模型1個周期1個史觀1個工作流
一、什麼是Git?
Git是一個開源的分散式版本控制系統,用于敏捷高效地處理任何或小或大的項目。
Git是Linus Torvalds為了幫助管理 Linux 內核開發而開發的一個開放源碼的版本控制軟體。
二、分散式VS集中式
VisualSVN、TortoiseSVN、Bazzar為集中式版本控制系統,而Mercurial、Git、Bitkeeper為分散式版本控制系統。
1. 集中式版本控制
優點:可以對具體的文件或目錄進行許可權控制,有全局的版本號。
缺點:所有操作都需要聯網中心伺服器。
2. 分散式版本控制
優點:
i. 分支管理。
ii. 完整性和安全性更高,各客戶端保留有完整的版本庫。
iii. 絕大部分操作都是本地化的,支援離線。
缺點:
i. 對版本庫的目錄和文件無法做到精細化的許可權控制。
ii. 無全局性的版本號。
通過以上分析的集中式和分散式版本控制的優缺點,我們就能總結出以Git為代表的分散式版本控制和以SVN為代表的集中式版本控制之間的區別。
3. Git和SVN的區別
- 最核心的區別當然是分散式和集中式。
- 處理數據的方式不同,Git以元數據方式存儲數據,SVN按照文件存儲,對應的取出數據方式也不一樣。
- 分支管理或分支模型(下文會詳解)。
- 全局性的版本號。
- 數據的完整性和安全性,分散式的更好。
三、常用的Git解決方案和程式碼託管平台
1.開源軟體解決方案:Gitea、GitLab
2.程式碼託管平台:碼雲(Gitee)、碼市(Coding)、GitHub、GitLab、Bitbucket
四、Git的基石SHA-1
In cryptography, SHA-1 (Secure Hash Algorithm 1) is a cryptographichash function which takes an input and produces a 160-bit (20-byte) hash value known as a message digest – typically rendered as ahexadecimal number, 40 digits long. It was designed by the UnitedStates National Security Agency, and is a U.S. Federal InformationProcessing Standard.
以上摘自維基百科,主要說明了SHA是一個密碼散列函數家族,是FIPS所認證的安全散列演算法。能計算出一個數字消息所對應到的,長度固定的字元串(又稱消息摘要)的演算法。且若輸入的消息不同,它們對應到不同字元串的機率很高。SHA-1長度為20位元組,160位,熟悉網路編程的都知道,4位可以轉換成一個十六進位的數字,所以一個SHA-1散列可以展示為40長度的十六進位的數字。
SHA-1的計算方法偽程式碼:
 1 //Note: All variables are unsigned 32 bits and wrap modulo 232 when calculating
 2
 3 //Initial variables:
 4 h0 := 0x67452301
 5 h1 := 0xEFCDAB89
 6 h2 := 0x98BADCFE
 7 h3 := 0x10325476
 8 h4 := 0xC3D2E1F0
 9
10 //Pre-processing:
11 append the bit '1' to the message
12 append k bits '0', where k is the minimum number >= 0 such that the resulting message
13     length (in bits) is congruent to 448(mod 512)
14 append length of message (before pre-processing), in bits, as 64-bit big-endian integer
15
16 //Process the message in successive 512-bit chunks:
17 break message into 512-bit chunks
18 for each chunk
19     break chunk into sixteen 32-bit big-endian words w[i], 0 ≤ i ≤ 15
20
21     //Extend the sixteen 32-bit words into eighty 32-bit words:
22     for i from 16 to 79
23         w[i] := (w[i-3] xor w[i-8] xor w[i-14] xor w[i-16]) leftrotate 1
24
25     //Initialize hash value for this chunk:
26     a := h0
27     b := h1
28     c := h2
29     d := h3
30     e := h4
31
32     //Main loop:
33     for i from 0 to 79
34         if 0 ≤ i ≤ 19 then
35             f := (b and c) or ((not b) and d)
36             k := 0x5A827999
37         else if 20 ≤ i ≤ 39
38             f := b xor c xor d
39             k := 0x6ED9EBA1
40         else if 40 ≤ i ≤ 59
41             f := (b and c) or (b and d) or(c and d)
42             k := 0x8F1BBCDC
43         else if 60 ≤ i ≤ 79
44             f := b xor c xor d
45             k := 0xCA62C1D6
46         temp := (a leftrotate 5) + f + e + k + w[i]
47         e := d
48         d := c
49         c := b leftrotate 30
50         b := a
51         a := temp
52
53     //Add this chunk's hash to result so far:
54     h0 := h0 + a
55     h1 := h1 + b
56     h2 := h2 + c
57     h3 := h3 + d
58     h4 := h4 + e
59
60 //Produce the final hash value (big-endian):
61 digest = hash = h0 append h1 append h2 append h3 append h4
雖然SHA-1作為數字簽名的演算法不安全,但是作為日常項目程式碼管理來說卻足夠能夠保證其唯一性。
我們已經了解到SHA-1摘要的長度是20位元組,也就是160位。要確保有50%的概率出現一次衝突,需要2^80個隨機散列的對象(計算衝突概率的公式是p=(n(n-1)/2)*(1/2^160))。2^80=1.2*10^24,也就是一億億億,這是地球上沙粒總數的1200倍。即使按照目前公開的2005年CRYPTO會議中由王小雲提出的更具效率的SHA-1攻擊法,也需要2^63=9.2*10^18,也就是九十二億億,雖然不及地球上的沙粒數也是一個很大的數字。
超大型項目Linux內核有超過45萬次提交,包含360萬個對象,也至多需要前11個字元就能夠保證SHA-1的唯一性。
Git根據文件內容或目錄結構計算出SHA-1散列值,然後通過散列值存儲、檢索和處理資訊。
五、Git模型
1. 區域模型
Git項目中的主要區域:Git目錄(倉庫)、工作目錄和暫存區(索引)
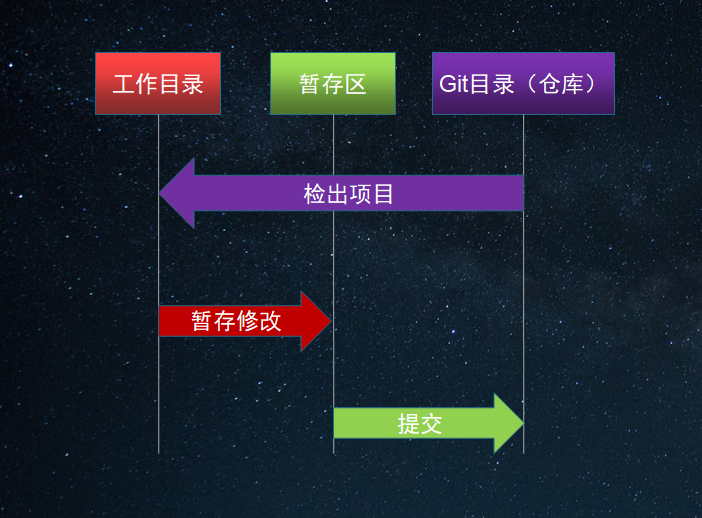
Git目錄也稱為Git倉庫或Git資料庫,是保存Git項目元數據和對象資料庫的地方。是Git最重要的部分,當從其它電腦中克隆項目時需要複製的內容。
工作目錄是項目某個版本的單次檢出。這些文件從Git倉庫中提取出來,放置在磁碟上使用和修改。我們平時碼程式碼時的區域就是在工作目錄中,因為這裡是唯一提供了對文件進行編輯的地方。
暫存區也稱為索引,是一個文件,一般位於Git目錄中。保存了下次所要提交內容的相關資訊。Git的add命令就是將工作目錄中的內容添加到暫存區中。
2. 分支模型
分支模型是Git的精髓,被稱為Git的「殺手鐧特性」。
分支意味著偏離開發主線並繼續你自己的工作而不影響主線開發。在其它很多版本控制工具中,有較昂貴的成本,因為常常需要去對整個源程式碼目錄進行一次複製,特別對於大型項目,這樣的複製時間成本是很高的。
Git的分支與眾不同的地方在於,極致的輕量,幾乎即時就可以完成分支操作,分支間的切換操作也很方便。
Git以快照的方式存儲數據。
當發起提交時,Git存儲的是提交對象(commit object),其中包含了指向暫存區快照的指針。提交對象也包含作者的姓名和郵箱地址、已輸入的提交資訊以及指向其父提交的指針。初始提交沒有父提交,而一般的提交會有一個父提交;對於兩個或更多分支的合併提交,存在多個父提交。
當執行git commit進行提交時,Git會先為每個子目錄計算校驗和,然後再把這些樹對象(tree object)保存到Git倉庫中,Git隨後會創建提交對象,其中包括元數據以及指向項目根目錄的樹對象的指針,以便有需要的時候重新創建這次快照。
Git分支只不過是一個指向某次提交的輕量級的可移動指針。Git默認的分支名稱是master。當你發起提交時,你的當前分支比如master分支就會移動指向你剛剛的提交。
git init命令默認創建的就是master分支。
Git的分支實際上就是一個簡單的文件,其中只包含了該分支所指向提交的長度為40個字元的SHA-1校驗和。正因如此,Git分支的創建和刪除成本就很低。創建新分支就如同向文件寫入40個字元外加一個換行符一件簡單方便。
提交時Git保存了父對象的指針,當進行合併操作時Git會自動尋找適當的合併基礎,創建新分支並在其上coding,然後把多個分支間的程式碼進行合併很方便,所以Git鼓勵開發人員創建和使用分支。
接下來我們來了解幾個分支概念
長期分支VS主題分支
主題分支是指短期的、用於實現某一特定功能及其相關工作的分支。與之相對的就是長期分支,長期分支是在整個項目中會一直保持,用於合併主題分支或版本控制和程式碼發布的分支。比如在master分支上存放穩定版的程式碼,develop上進行開發,test分支上進行測試,在iss-email上進行email的主題開發。
遠程分支VS跟蹤分支
遠程分支是指向遠程倉庫的分支的指針,這些指針存在於本地且無法被移動。基於遠程分支創建的本地分支就是其遠程分支的跟蹤分支(tracking branch),有時也叫做上游分支(upstream branch)。遠程分支我們能夠理解是在伺服器上的分支,那跟蹤分支呢?我隨便創建的本地分支都是跟蹤分支嗎?本地非跟蹤分支和跟蹤分支又有什麼區別呢?
當你克隆一個遠程倉庫時,Git默認情況下會自動創建跟蹤著遠程origin/master分支的本地master分支。當你試圖執行分支切換操作時,如果該分支尚未被創建,並且該分支名稱和某個遠程分支名稱一致,那麼Git會幫你創建跟蹤分支。當設置成為跟蹤分支後,使用Git命令時可以簡化操作,比如在master分支上push程式碼到遠程倉庫上,可以直接使用git push,如果沒設置跟蹤分支需要使用git push origin/master。
$git checkout --track origin/serverfix
Branch serverfix set up to track remote branch serverfix from origin.
Switched to new Branch 'serverfix'
$git checkout -b sf origin/serverfix
Branch sf set up to track remote branch serverfix from origin.
Switch to a new branch 'sf'
當我們了解了Git的分支模型後,分支模型正確的打開方式是什麼樣的呢?
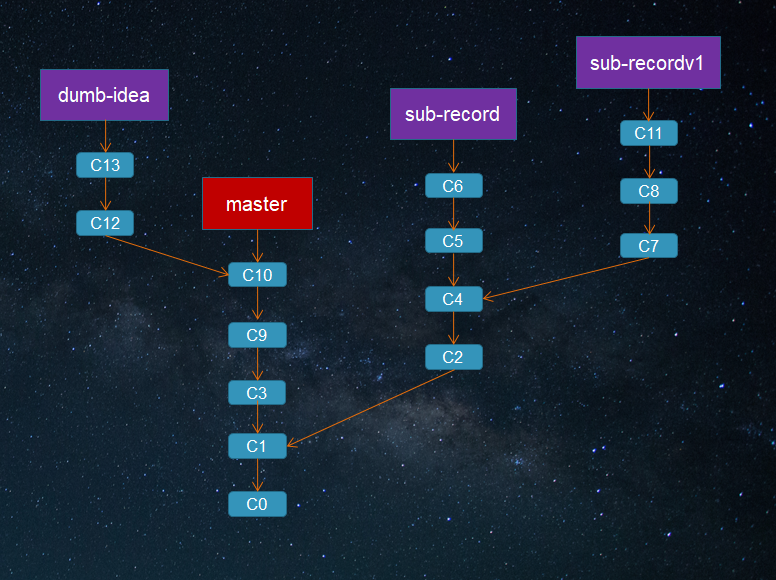
假設你在master分支上做了一些項目起始的工作,之後為了實現某個需求,創建並切換到主題分支sub-record,並在其上做了一些開發工作。之後,你又嘗試另一種能實現需求的方式,創建並切換到新的分支sub-recordv1。接著你又切換回master分支並繼續工作了一段時間,最後你創建了新的分支dumb-idea來實現你的一個不確定的想法。
最後你覺得sub-recordv1方案效率比較高,而在dumb-idea上的工作同事們都覺得很有意義,那麼把主題分支上的提交合併合併入長期分支master,捨棄掉sub-record上的C5和C6提交。
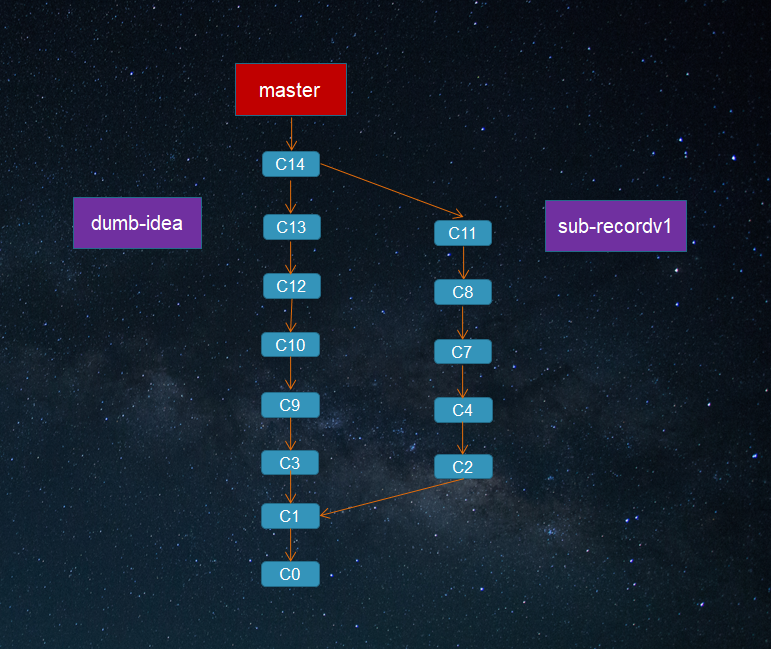
根據項目的需要,為實現一個需求或一個子需求甚至一個想法創建一個分支。合併程式碼的時候只需要合併需要的,那些暫時沒能合併入的程式碼也許以後要麼直接或間接就可以用上,如果沒能用上也可以借鑒和參考。畢竟創建和使用Git分支的成本很低而且方便有效,這樣才是Git分支模型的正確打開方式。
3. 對象模型
對象模型分為:主要對象和標籤對象。主要對象又分為blob對象、樹對象和提交對象。
blob對象是保存到Git倉庫的文件當前版本或者稱為元數據。可以理解為文件內容。
樹對象解決的是文件名的存儲問題。可以認為是目錄,對應為Unix目錄項。單個樹對象包含一個或多個樹條目,每個條目包含一個指向blob對象或子樹的指針以及相關模式、類型和文件名。
提交對象指定了此刻項目快照的頂層樹對象、作者/提交者資訊、提交時間戳、一個空行以及提交消息。指向的是樹對象。
標籤對象與提交對象非常相似,包含了標籤的創建者、日期、標籤消息和一個指針。通常指向提交對象也可以指向blob對象。是不可變的分支引用,總是指向相同的提交對象或blob對象。
4. 「三棵樹」模型
將Git類比為三棵樹的內容管理器。「樹」實際上指的是「文件的集合」,並非特定的數據結構。
| 三棵樹 | HEAD | 最近提交的快照,下次提交的父提交 |
| 索引 | 預計的下一次提交的快照 | |
| 工作目錄 | 沙盒 |
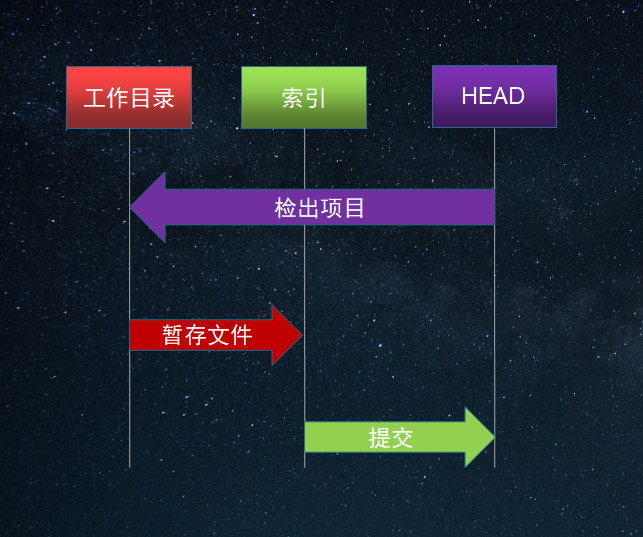
HEAD和索引著兩棵樹把數據以一種高效但不夠直觀的方式保存在.git目錄中。而工作目錄則將其提取成實際的文件,以便於編輯。可以把工作目錄當作沙盒,在將內容提交到暫存區(索引)並寫入歷史記錄之前,你可以隨意修改。
三棵樹之間的切換
$git status

Changes to be committed:
    (use "git restore --staged <file>..."to unstage)

Changes not staged for commit:
    (use "git add <file>..." to update what will be committed)
    (use "git restore <file>..." to discard changes in working directory)
其中Changes not staged for commit提示的是索引和工作目錄之間的差異。
其中Changes to be committed提示的是HEAD和索引之間的差異。
通過以上我們了解到,Git通過操作三棵樹的狀態來記錄項目的快照。
通過學習了三棵樹模型,我們將運用所學來理解Git的重置,包括兩個命令:reset和checkout。
reset命令會以特定的次序重寫這三棵樹,操作方式如下:
(1)移動HEAD分支的指向(指定了--soft選項,則在此停止)。
(2)使索引看起來像HEAD(默認行為,或指定了--mixed選項,則在此停止)。
(3)使工作目錄看起來像索引(指定了--hard選項,則在此停止)。
checkout命令操作三棵樹有兩種方式:
方式一(不使用路徑):
(1)與reset --hard不同,checkout不會影響工作目錄。他會確保不會破壞已更改的文件。
(2)更新HEAD的方式。reset移動的是HEAD指向的分支,而checkout移動的是HEAD,使其指向其他分支。
假設我們有兩個分支:master和develop,分別指向不同的提交。我們當前處在develop分支(因為HEAD也指向該分支)。如果執行git reset master,那麼develop會與master一樣,指向同一提交。如果執行的是git checkout master,那麼發生移動的會是HEAD,而不是develop。HEAD將會指向master。
方式二(使用路徑):
加上文件路徑,與reset一樣,不會移動HEAD。會使用提交中的文件來更新索引,但是也會覆蓋工作目錄中對應的文件。
reset和checkout命令速查表
| 操作 | HEAD | 索引 | 工作目錄 | 工作目錄是否安全? | |
| 提交級別 | reset --soft [commit] | REF | 否 | 否 | 是 |
| reset [commit] | REF | 是 | 否 | 是 | |
| reset --hard [commit] | REF | 是 | 是 | 否 | |
| checkout [commit] | HEAD | 是 | 是 | 是 | |
| 文件級別 | reset (commit) [file] | 否 | 是 | 否 | 是 |
| checkout (commit) [file] | 否 | 是 | 是 | 否 | |
HEAD一列中的REF表示該命令移動了HEAD指向的引用(分支),HEAD表示移動了HEAD自身。
注意:「工作目錄是否安全」一列,如果顯示是否,應當慎重,執行前要考慮清楚,否則可能丟失工作成果。
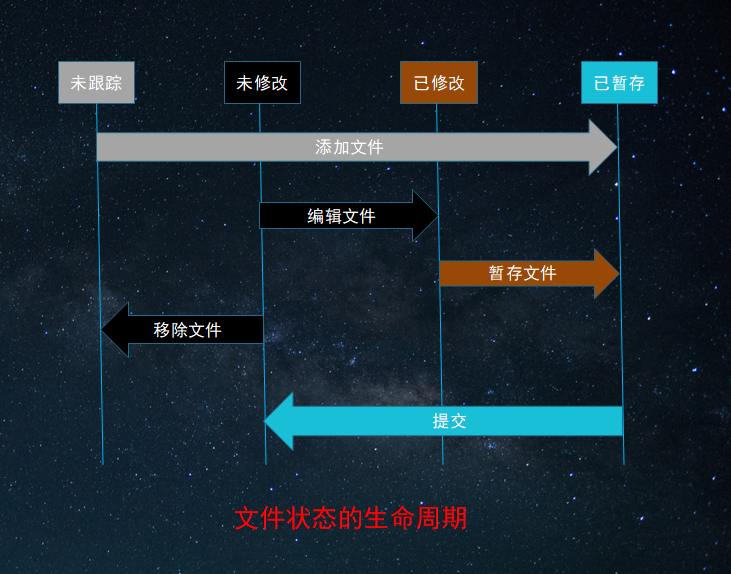
六、文件狀態的生命周期
七、提交史觀
| 代表觀點 | 提交史觀 | 代表命令 |
| 「史書」、「記錄」 | Git倉庫提交歷史就是實際發生過的事件的記錄 | merge |
| 「故事」 | Git提交歷史是關於項目如何構建的故事 | rebase |
變基操作是把某條分支線上的工作在另一個分支線上按順序重現。而合併操作則是找出兩個分支的末端,並把它們合併到一起。
最好的操作方式是,在本地尚未推送的更改進行變基操作,從而簡化提交歷史,單決不能對任何已經推送到伺服器的更改進行變基操作。
八、分散式工作流
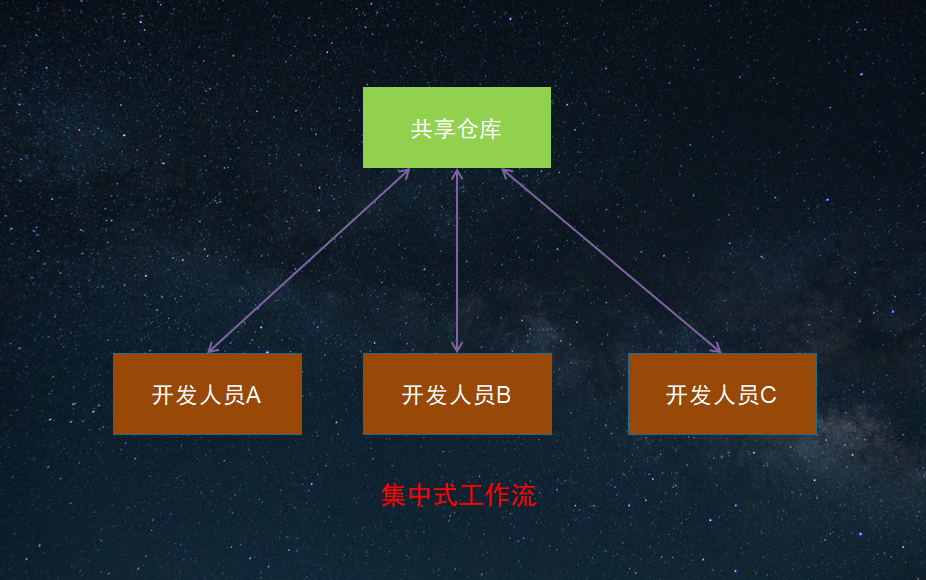
1. 集中式工作流
一個中樞(或是倉庫)接受程式碼,所有人以此同步各自的工作。
2. 集成管理者工作流
(1)項目維護人員推送到公開倉庫。
(2)貢獻者克隆該倉庫,作出自己的修改。
(3)貢獻者推送到自己的公開倉庫副本。
(4)貢獻者向維護人員發送電子郵件,要求合併變更。
(5)維護人員將貢獻者的倉庫添加為遠程倉庫並在本地進行合併。
(6)維護人員將合併後的變更推送到主倉庫。

3. 司令官與副官工作流
(1)普通開發人員使用自己的主題分支,根據參考倉庫(reference repository)拉取項目或進行變基。
(2)副官將開發人員的主題分支合併入master分支。
(3)司令官將副官的master分支合併入自己的master分支。
(4)司令官將其master分支推送到參考倉庫,同時其他開發人員以此為基礎進行變基操作。

參考資料
[1] Scott Chacon,Ben Straub《精通Git》(第2版)
[2] 維基百科
[3] //www.sohu.com/a/234659269_575744
[4] //www.runoob.com/git/git-tutorial.html