Python要點總結,我使用了100個小例子!
- 2019 年 12 月 5 日
- 筆記
本文提綱


1靜態/動態OR強類型/弱類型

- 靜態類型 vs 動態 程式語言
- 強類型 vs 弱類型 程式語言
1.1 類型檢查
類型檢查是一個驗證和施加類型約束的過程,編譯器或解釋器通常在編譯或運行階段做類型檢查。例如,你不能拿一個string類型值除以浮點數。
用更簡單的術語,類型檢查僅僅就是查看變數和它們的類型,然後說這個表達式是合理的。
因此,現在我們知道類型檢查是什麼,明白這些術語真的很簡單。
在靜態類型語言(statically typed languages)中,類型檢查發生在編譯階段(compile time),然而,在動態類型語言(dynamically typed languages)中,類型檢查發生在運行階段(run time)
1.2 它意味著什麼?
1.2.1 類型聲明
靜態類型(static): 所有的變數類型必須被顯示地聲明,因為這些資訊在編譯階段就被需要。例如,在 Java 中
float f = 0.5
動態(Dynamic): 顯示聲明不被要求,因為類型賦值發生在運行階段。例如在 Python 中,
f = 0.5
1.2.2 性能
靜態類型(static): 編譯階段做更多處理,但是運行時(run-time)性能更好
動態(Dynamic): 編譯階段更高效,但是運行時的類型檢查會影響到性能
1.2.3 靈活性和出錯
靜態類型: 運行時出錯機會更小,但是提供給程式設計師的靈活性不好
動態類型: 提供更多的靈活性但是運行時出錯機會相對更大
1.2.4 記住
各種語言按照動態/靜態,弱類型/強類型的劃分:
==> Statically type-checked languages. ==> Dynamically type-checked languages.

1.3 什麼是強類型/弱類型?
首先看下什麼是強類型,在強類型中,不管在編譯時還是運行時,一旦某個類型賦值給某個變數,它會持有這個類型,並且不能同其他類型在計算某個表達式時混合計算。例如在Python中:
data = 5 # 在runtime時,被賦值為整形 data = data + "xiaoming" # error
然而,在弱類型中,它是很容易與其他類型混合計算的,比如同樣一門偉大的語言 Javascript,使用它:
var data = 5 data = data + 'xiaoming' //string和int可以結合
1.4 結論
類型檢查確保一個表達式中的變數類型是合法的。在靜態類型語言中,類型檢查發生在編譯階段;動態類型語言,類型檢查發生在運行階段。
強類型語言有更強的類型檢查機制,表達式計算中會做嚴格的類型檢查;而弱類型語言允許各種變數類型間做一些運算。
2 內置函數(63個)
1 abs()
絕對值或複數的模
In [1]: abs(-6) Out[1]: 6
2 all()
接受一個迭代器,如果迭代器的所有元素都為真,那麼返回True,否則返回False
In [2]: all([1,0,3,6]) Out[2]: False In [3]: all([1,2,3]) Out[3]: True
3 any()
接受一個迭代器,如果迭代器里有一個元素為真,那麼返回True,否則返回False
In [4]: any([0,0,0,[]]) Out[4]: False In [5]: any([0,0,1]) Out[5]: True
4 ascii()
調用對象的repr() 方法,獲得該方法的返回值
In [30]: class Student(): ...: def __init__(self,id,name): ...: self.id = id ...: self.name = name ...: def __repr__(self): ...: return 'id = '+self.id +', name = '+self.name In [33]: print(xiaoming) id = 001, name = xiaoming In [34]: ascii(xiaoming) Out[34]: 'id = 001, name = xiaoming'
5 bin()
將十進位轉換為二進位
In [35]: bin(10) Out[35]: '0b1010'
6 oct()
將十進位轉換為八進位
In [36]: oct(9) Out[36]: '0o11'
7 hex()
將十進位轉換為十六進位
In [37]: hex(15) Out[37]: '0xf'
8 bool()
測試一個對象是True, 還是False.
In [38]: bool([0,0,0]) Out[38]: True In [39]: bool([]) Out[39]: False In [40]: bool([1,0,1]) Out[40]: True
9 bytes()
將一個字元串轉換成位元組類型
In [44]: s = "apple" In [45]: bytes(s,encoding='utf-8') Out[45]: b'apple'
10 str()
將字元類型、數值類型等轉換為字元串類型
In [46]: integ = 100 In [47]: str(integ) Out[47]: '100'
11 callable()
判斷對象是否可以被調用,能被調用的對象就是一個callable 對象,比如函數 str, int 等都是可被調用的,但是例子4 中xiaoming這個實例是不可被調用的:
In [48]: callable(str) Out[48]: True In [49]: callable(int) Out[49]: True In [50]: xiaoming Out[50]: id = 001, name = xiaoming In [51]: callable(xiaoming) Out[51]: False
12 chr()
查看十進位整數對應的ASCII字元
In [54]: chr(65) Out[54]: 'A'
13 ord()
查看某個ascii對應的十進位數
In [60]: ord('A') Out[60]: 65 14 classmethod()
classmethod 修飾符對應的函數不需要實例化,不需要 self 參數,但第一個參數需要是表示自身類的 cls 參數,可以來調用類的屬性,類的方法,實例化對象等。
In [66]: class Student(): ...: def __init__(self,id,name): ...: self.id = id ...: self.name = name ...: def __repr__(self): ...: return 'id = '+self.id +', name = '+self.name ...: @classmethod ...: def f(cls): ...: print(cls)
15 complie()
將字元串編譯成python 能識別或可以執行的程式碼,也可以將文字讀成字元串再編譯。
In [74]: s = "print('helloworld')" In [75]: r = compile(s,"<string>", "exec") In [76]: r Out[76]: <code object <module> at 0x0000000005DE75D0, file "<string>", line 1> In [77]: exec(r) helloworld 16 complex()
創建一個複數
In [81]: complex(1,2) Out[81]: (1+2j)
17 delattr()
刪除對象的屬性
In [87]: delattr(xiaoming,'id') In [88]: hasattr(xiaoming,'id') Out[88]: False
18 dict()
創建數據字典
In [92]: dict() Out[92]: {} In [93]: dict(a='a',b='b') Out[93]: {'a': 'a', 'b': 'b'} In [94]: dict(zip(['a','b'],[1,2])) Out[94]: {'a': 1, 'b': 2} In [95]: dict([('a',1),('b',2)]) Out[95]: {'a': 1, 'b': 2} 19 dir()
不帶參數時返回當前範圍內的變數,方法和定義的類型列表;帶參數時返回參數的屬性,方法列表。
In [96]: dir(xiaoming) Out[96]: ['__class__', '__delattr__', '__dict__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__le__', '__lt__', '__module__', '__ne__', '__new__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__', '__weakref__', 'name']
20 divmod()
分別取商和餘數
In [97]: divmod(10,3) Out[97]: (3, 1)
21 enumerate()
返回一個可以枚舉的對象,該對象的next()方法將返回一個元組。
In [98]: s = ["a","b","c"] ...: for i ,v in enumerate(s,1): ...: print(i,v) ...: 1 a 2 b 3 c
22 eval()
將字元串str 當成有效的表達式來求值並返回計算結果取出字元串中內容
In [99]: s = "1 + 3 +5" ...: eval(s) ...: Out[99]: 9
23 exec()
執行字元串或complie方法編譯過的字元串,沒有返回值
In [74]: s = "print('helloworld')" In [75]: r = compile(s,"<string>", "exec") In [76]: r Out[76]: <code object <module> at 0x0000000005DE75D0, file "<string>", line 1> In [77]: exec(r) helloworld 24 filter()
過濾器,構造一個序列,等價於
[ item for item in iterables if function(item)]
在函數中設定過濾條件,逐一循環迭代器中的元素,將返回值為True時的元素留下,形成一個filter類型數據。
In [101]: fil = filter(lambda x: x>10,[1,11,2,45,7,6,13]) In [102]: list(fil) Out[102]: [11, 45, 13]
25 float()
將一個字元串或整數轉換為浮點數
In [103]: float(3) Out[103]: 3.0
26 format()
格式化輸出字元串,format(value, format_spec)實質上是調用了value的format(format_spec)方法。
In [104]: print("i am {0},age{1}".format("tom",18)) i am tom,age18 27 frozenset()
創建一個不可修改的集合。
In [105]: frozenset([1,1,3,2,3]) Out[105]: frozenset({1, 2, 3}) 28 getattr()
獲取對象的屬性
In [106]: getattr(xiaoming,'name') Out[106]: 'xiaoming'
29 globals()
返回一個描述當前全局變數的字典
30 hasattr()
In [110]: hasattr(xiaoming,'name') Out[110]: True In [111]: hasattr(xiaoming,'id') Out[111]: False
31 hash()
返回對象的哈希值
In [112]: hash(xiaoming) Out[112]: 6139638
32 help()
返回對象的幫助文檔
In [113]: help(xiaoming) Help on Student in module __main__ object: class Student(builtins.object) | Methods defined here: | | __init__(self, id, name) | | __repr__(self) | | ---------------------------------------------------------------------- | Data descriptors defined here: | | __dict__ | dictionary for instance variables (if defined) | | __weakref__ | list of weak references to the object (if defined)
33 id()
返回對象的記憶體地址
In [115]: id(xiaoming) Out[115]: 98234208
34 input()
獲取用戶輸入內容
In [116]: input() aa Out[116]: 'aa'
35 int()
int(x, base =10) , x可能為字元串或數值,將x 轉換為一個普通整數。如果參數是字元串,那麼它可能包含符號和小數點。如果超出了普通整數的表示範圍,一個長整數被返回。
In [120]: int('12',16) Out[120]: 18 36 isinstance(object, classinfo)
判斷object是否為類classinfo的實例,是返回true
In [20]: class Student(): ...: ...: def __init__(self,id,name): ...: ...: self.id = id ...: ...: self.name = name ...: ...: def __repr__(self): ...: ...: return 'id = '+self.id +', name = '+self.name ...: In [21]: xiaoming = Student('001','xiaoming') In [22]: isinstance(xiaoming,Student) Out[22]: True 37 issubclass(class, classinfo)
如果class是classinfo類的子類,返回True:
In [27]: class undergraduate(Student): ...: def studyClass(self): ...: pass ...: def attendActivity(self): ...: pass ...: In [28]: issubclass(undergraduate,Student) Out[28]: True In [29]: issubclass(object,Student) Out[29]: False In [30]: issubclass(Student,object) Out[30]: True
如果class是classinfo元組中某個元素的子類,也會返回True
In [26]: issubclass(int,(int,float)) Out[26]: True
38 iter(object, sentinel)
返回一個可迭代對象, sentinel可省略
In [72]: lst = [1,3,5] In [73]: for i in iter(lst): ...: print(i) ...: 1 3 5
sentinel 理解為迭代對象的哨兵,一旦迭代到此元素,立即終止:
In [81]: class TestIter(object): ...: def __init__(self): ...: self.l=[1,3,2,3,4,5] ...: self.i=iter(self.l) ...: def __call__(self): #定義了__call__方法的類的實例是可調用的 ...: item = next(self.i) ...: print ("__call__ is called,which would return",item) ...: return item ...: def __iter__(self): #支援迭代協議(即定義有__iter__()函數) ...: print ("__iter__ is called!!") ...: return iter(self.l) ...: In [82]: t = TestIter() ...: t1 = iter(t, 3) ...: for i in t1: ...: print(i) ...: __call__ is called,which would return 1 1 __call__ is called,which would return 3 39 len(s)
返回對象的長度(元素個數)
In [83]: dic = {'a':1,'b':3} In [84]: len(dic) Out[84]: 2 40 list([iterable])
返回可變序列類型
In [85]: list(map(lambda x: x%2==1, [1,3,2,4,1])) Out[85]: [True, True, False, False, True]
41 map(function, iterable, …)
返回一個將 function 應用於 iterable 中每一項並輸出其結果的迭代器:
In [85]: list(map(lambda x: x%2==1, [1,3,2,4,1])) Out[85]: [True, True, False, False, True]
可以傳入多個iterable對象,輸出長度等於最短序列的長度:
In [88]: list(map(lambda x,y: x%2==1 and y%2==0, [1,3,2,4,1],[3,2,1,2])) Out[88]: [False, True, False, False]
42 max(iterable,*[, key, default])
返回最大值:
In [99]: max(3,1,4,2,1) Out[99]: 4 In [100]: max((),default=0) Out[100]: 0 In [89]: di = {'a':3,'b1':1,'c':4} In [90]: max(di) Out[90]: 'c' In [102]: a = [{'name':'xiaoming','age':18,'gender':'male'},{'name':' ...: xiaohong','age':20,'gender':'female'}] In [104]: max(a,key=lambda x: x['age']) Out[104]: {'name': 'xiaohong', 'age': 20, 'gender': 'female'} 43 min(iterable,*[, key, default])
返回最小值
44 memoryview(obj)
返回由給定實參創建的「記憶體視圖」對象, Python 程式碼訪問一個對象的內部數據,只要該對象支援 緩衝區協議 而無需進行拷貝
45 next(iterator,[, default])
返回可迭代對象的下一個元素
In [129]: it = iter([5,3,4,1]) In [130]: next(it) Out[130]: 5 In [131]: next(it) Out[131]: 3 In [132]: next(it) Out[132]: 4 In [133]: next(it) Out[133]: 1 In [134]: next(it,0) #迭代到頭,默認返回值為0 Out[134]: 0 In [135]: next(it) ---------------------------------------------------------------------- StopIteration Traceback (most recent call last) <ipython-input-135-bc1ab118995a> in <module> ----> 1 next(it) StopIteration:
46 object()
返回一個沒有特徵的新對象。object 是所有類的基類。
In [137]: o = object() In [138]: type(o) Out[138]: object
47 open(file)
返迴文件對象
In [146]: fo = open('D:/a.txt',mode='r', encoding='utf-8') In [147]: fo.read() Out[147]: 'ufefflife is not so long,nI use Python to play.' mode取值表:
讀取(默認)
48 pow(base, exp[, mod])
base為底的exp次冪,如果mod給出,取余
In [149]: pow(3, 2, 4) Out[149]: 1
49 print(objects)
列印對象,此函數不解釋
50 class property(fget=None, fset=None, fdel=None, doc=None)
返回 property 屬性,典型的用法:
class C: def __init__(self): self._x = None def getx(self): return self._x def setx(self, value): self._x = value def delx(self): del self._x # 使用property類創建 property 屬性 x = property(getx, setx, delx, "I'm the 'x' property.")
使用python裝飾器,實現與上完全一樣的效果程式碼:
class C: def __init__(self): self._x = None @property def x(self): return self._x @x.setter def x(self, value): self._x = value @x.deleter def x(self): del self._x
51 range(stop)
range(start, stop[,step])
生成一個不可變序列:
In [153]: range(11) Out[153]: range(0, 11) In [154]: range(0,11,1) Out[154]: range(0, 11)
52 reversed(seq)
返回一個反向的 iterator:
In [155]: rev = reversed([1,4,2,3,1]) In [156]: for i in rev: ...: print(i) ...: 1 3 2 4 1
53 round(number[, ndigits])
四捨五入,ndigits代表小數點後保留幾位:
In [157]: round(10.0222222, 3) Out[157]: 10.022
54 class set([iterable])
返回一個set對象,可實現去重:
In [159]: a = [1,4,2,3,1] In [160]: set(a) Out[160]: {1, 2, 3, 4} 55 class slice(stop)
class slice(start, stop[, step])
返回一個表示由 range(start, stop, step) 所指定索引集的 slice對象
In [170]: a = [1,4,2,3,1] In [171]: a[slice(0,5,2)] #等價於a[0:5:2] Out[171]: [1, 2, 1]
56 sorted(iterable, *, key=None, reverse=False)
排序:
In [174]: a = [1,4,2,3,1] In [175]: sorted(a,reverse=True) Out[175]: [4, 3, 2, 1, 1] In [178]: a = [{'name':'xiaoming','age':18,'gender':'male'},{'name':' ...: xiaohong','age':20,'gender':'female'}] In [180]: sorted(a,key=lambda x: x['age'],reverse=False) Out[180]: [{'name': 'xiaoming', 'age': 18, 'gender': 'male'}, {'name': 'xiaohong', 'age': 20, 'gender': 'female'}] 57 @`staticmethod
將方法轉換為靜態方法,不做解釋
58 vars()
返回模組、類、實例或任何其它具有 __dict__屬性的對象的 __dict__ 屬性
In [2]: vars() Out[2]: {'__name__': '__main__', '__doc__': 'Automatically created module for IPython interactive environment', '__package__': None, '__loader__': None, '__spec__': None, '__builtin__': <module 'builtins' (built-in)>, '__builtins__': <module 'builtins' (built-in)>, '_ih': ['', 'vars([1,2,3])', 'vars()'], '_oh': {}, '_dh': ['C:\Windows\system32'], 'In': ['', 'vars([1,2,3])', 'vars()'], 'Out': {}, 'get_ipython': <bound method InteractiveShell.get_ipython of <IPython.terminal.interactiveshell.TerminalInteractiveShell object at 0x0000026004D91C50>>, 'exit': <IPython.core.autocall.ExitAutocall at 0x26006011048>, 'quit': <IPython.core.autocall.ExitAutocall at 0x26006011048>, '_': '', '__': '', '___': '', '_i': 'vars([1,2,3])', '_ii': '', '_iii': '', '_i1': 'vars([1,2,3])', '_i2': 'vars()'} 59 sum(iterable, /, start=0)
求和:
In [181]: a = [1,4,2,3,1] In [182]: sum(a) Out[182]: 11 In [185]: sum(a,10) #求和的初始值為10 Out[185]: 21
60 super([type[, object-or-type]])
返回一個代理對象,它會將方法調用委託給 type 的父類或兄弟類
61 tuple([iterable])
雖然被稱為函數,但 tuple 實際上是一個不可變的序列類型
62 class type(object)
class type(name, bases, dict)
傳入一個參數時,返回 object 的類型:
In [186]: type(xiaoming) Out[186]: __main__.Student In [187]: type(tuple()) Out[187]: tuple
63 zip(*iterables)
創建一個聚合了來自每個可迭代對象中的元素的迭代器:
In [188]: x = [3,2,1] In [189]: y = [4,5,6] In [190]: list(zip(y,x)) Out[190]: [(4, 3), (5, 2), (6, 1)] In [191]: a = range(5) In [192]: b = list('abcde') In [193]: b Out[193]: ['a', 'b', 'c', 'd', 'e'] In [194]: [str(y) + str(x) for x,y in zip(a,b)] Out[194]: ['a0', 'b1', 'c2', 'd3', 'e4'] 3 列表生成式
python裡面[] 表示一個列表,對容器類型的數據進行運算和操作,生成新的列表最高效、快速的辦法,就是列表生成式。它優雅、簡潔,值得大家多多使用!今天盤點列表生成式在工作中的主要使用場景。
3.1 入門例子
1
range快速生成連續列表
In [1]: a = range(11) In [2]: a Out[2]: range(0, 11) In [3]: list(a) Out[3]: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
2
對列表裡面的數據進行運算後重新生成一個新的列表:
In [5]: a = range(0,11) In [6]: b = [x**2 for x in a] In [7]: b Out[7]: [0, 1, 4, 9, 16, 25, 36, 49, 64, 81, 100]
3
對一個列表裡面的數據篩選,只計算[0,11) 中偶數的平方:
In [10]: a = range(11) In [11]: c = [x**2 for x in a if x%2==0] In [12]: c Out[12]: [0, 4, 16, 36, 64, 100]
4
前面列表生成式都只傳一個參數x,帶有兩個參數的運算:
In [13]: a = range(5) In [14]: b = ['a','b','c','d','e'] In [20]: c = [str(y) + str(x) for x, y in zip(a,b)] In [21]: c Out[21]: ['a0', 'b1', 'c2', 'd3', 'e4']
3.2 中級例子
5
結合字典,列印鍵值對:
In [22]: a = {'a':1,'b':2,'c':3} In [23]: b = [k+ '=' + v for k, v in a.items()] In [24]: b = [k+ '=' + str(v) for k, v in a.items()] In [25]: b Out[25]: ['a=1', 'b=2', 'c=3'] 6
輸出某個目錄下的所有文件和文件夾的名稱:
In [33]: [d for d in os.listdir('d:/summary')] Out[33]: ['a.txt.txt', 'python-100'] 7
列表中所有單詞都轉化為小寫:
In [34]: a = ['Hello', 'World', '2019Python'] In [35]: [w.lower() for w in a] Out[35]: ['hello', 'world', '2019python']
3.3 高級例子
8
將值分組:
In [36]: def bifurcate(lst, filter): ...: return [ ...: [x for i,x in enumerate(lst) if filter[i] == True], ...: [x for i,x in enumerate(lst) if filter[i] == False] ...: ] ...: In [37]: bifurcate(['beep', 'boop', 'foo', 'bar'], [True, True, False, True]) Out[37]: [['beep', 'boop', 'bar'], ['foo']]
9
進一步抽象例子8,根據指定函數fn 對lst 分組:
In [38]: def bifurcate_by(lst, fn): ...: return [ ...: [x for x in lst if fn(x)], ...: [x for x in lst if not fn(x)] ...: ] ...: In [39]: bifurcate_by(['beep', 'boop', 'foo', 'bar'], lambda x: x[0] == 'b') Out[39]: [['beep', 'boop', 'bar'], ['foo']]
10
返回可迭代對象的差集,注意首先都把a, b用set 包裝
In [53]: def difference(a, b): ...: _a, _b =set(a),set(b) ...: return [item for item in _a if item not in _b] ...: ...: In [54]: difference([1,1,2,3,3], [1, 2, 4]) Out[54]: [3]
11
進一步抽象10,根據函數fn 映射後選取差集,如下列表元素分別為單個元素和字典的例子:
In [61]: def difference_by(a, b, fn): ...: ...: _b = set(map(fn, b)) ...: ...: return [item for item in a if fn(item) not in _b] ...: ...: ...: In [62]: from math import floor ...: difference_by([2.1, 1.2], [2.3, 3.4],floor) Out[62]: [1.2] In [63]: difference_by([{ 'x': 2 }, { 'x': 1 }], [{ 'x': 1 }], lambda v : v['x']) Out[63]: [{'x': 2}] 12
過濾非重複值,結合list 的count( 統計出元素在列表中出現次數):
In [64]: def filter_non_unique(lst): ...: return [item for item in lst if lst.count(item) == 1] In [65]: filter_non_unique([1, 2, 2, 3, 4, 4, 5]) Out[65]: [1, 3, 5]
4 Collections
Python有許多很好的庫(libraries),實現這些功能只需要幾行程式碼。今天介紹一個庫:collections. 這個模組提供容器相關的更高性能的數據類型,它們提供比通用容器 dict, list, set 和tuple更強大的功能。
今天介紹其中三種數據類型,最後你可能會驚訝它們怎麼這麼好用。
4.1 NamedTuple
對於數據分析或機器學習領域,用好namedtuples 會寫出可讀性強、易於維護的程式碼。大家回憶這種熟悉的場景,你正在做特徵工程,因為你尤其喜愛list, 所以把一堆特徵放到一個list 中,然後喂到機器學習模型中。很快,你將會意識到數百個特徵位於此list 中,這就是事情變得糟糕的開始。
In [10]: feature = ['age','height','name'] In [11]: data = [[10,1,'xiaoming'],[12,1,5,'xiaohong']] In [12]: data[0][0] #只能靠整數索引到某個特徵,0對應age Out[12]: 10
某天,你想使用某個特徵,這時比較棘手,你不知道它的index!更糟糕的是,當你準備離職要交接工作時,他們看到一個一個的數字型索引,完全對不上哪個和哪個,他們懵逼,你也尷尬。
如果我們使用NamedTuples去處理以上數據,亂為一團的事情將會迅速變得井然有序:
In [4]: Person = namedtuple('Person',['age','height','name']) In [15]: data2 = [Person(10,1.4,'xiaoming'),Person(12,1.5,'xiaohong')] In [16]: data2[0].age Out[16]: 10 僅僅幾行程式碼,我們將會很容易索引到第0行數據的age屬性取值,這在實際中真是太好用。你告別indexes訪問你的數據集中的特徵值,而是使用更加人性化,可讀性強的names索引。
NamedTuples會使得程式碼易讀、更易維護。
4.2 Counter
Counter正如名字那樣,它的主要功能就是計數。這聽起來簡單,但是我們在分析數據時,基本都會涉及計數,真的家常便飯。
習慣使用list 的看過來,有一些數值已經放在一個list中:
skuPurchaseCount = [3, 8, 3, 10, 3, 3, 1, 3, 7, 6, 1, 2, 7, 0, 7, 9, 1, 5, 1, 0] In [33]: for i in skuPurchaseCount: ...: if countdict.get(i) is None: ...: countdict[i]=1 ...: else: ...: countdict[i]+=1 In [34]: countdict Out[34]: {3: 5, 8: 1, 10: 1, 1: 4, 7: 3, 6: 1, 2: 1, 0: 2, 9: 1, 5: 1} 如果使用Counter,我們可以寫出更簡化的程式碼:
In [35]: from collections import Counter In [42]: Counter(skuPurchaseCount).most_common() Out[42]: [(3, 5),(1, 4),(7, 3),(0, 2),(8, 1),(10, 1),(6, 1),(2, 1),(9, 1),(5, 1)]
僅僅一行程式碼,我們便輸出統計計數結果,並且是一個按照次數統計出來的由大到小排序好的tuples列表,因此我們很快就會看到,購買3次是出現最多的,一共5次。
購買為1次的占多數,屬於長尾。
4.3 DefaultDict
DefaultDict是一個被初始化的字典,也就是每個鍵都已經被訪問一次:
In [53]: d = defaultdict(int) In [54]: for k in 'collections': ...: d[k] += 1 In [55]: d Out[55]: defaultdict(int, {'c': 2, 'o': 2, 'l': 2, 'e': 1, 't': 1, 'i': 1, 'n': 1, 's': 1}) 一般地,當你嘗試訪問一個不在字典中的值時,將會拋出一個異常。但是defaultdict可以幫助我們初始化,它的參數作為default_factory. 在上面例子中,將生成 int對象,意思是默認值為int 型,並設定初始值為0,所以我們可以很容易地統計每個字元出現的次數。
Simple and clean!
更有用的一個使用場景,我們有很多種商品,在每秒內下單次數的統計數據如下:
In [56]: data = [('iphone11',103), ('華為macbook-SKU1232',210),('iphone11',21),(' ...: 華為macbook-SKU1232',100)] In [57]: d = defaultdict(list) In [58]: for ele in data: ...: d[ele[0]].append(ele[1]) In [59]: d Out[59]: defaultdict(list, {'iphone11': [103, 21], '華為macbook-SKU1232': [210, 100]}) 上面例子default_dict取值為list, 因此,我們可以立即append一個元素到list中,更簡潔。
總結
至此,你已經了解collections庫中的三個類型,它們確實太好用,大家可以操練起來了!
5 itertools: 高效節省記憶體的方法
Python循環這樣寫,高效節省記憶體100倍
5.0 前言
說到處理循環,我們習慣使用for, while等,比如依次列印每個列表中的字元:
lis = ['I', 'love', 'python'] for i in lis: print(i) I love python
在列印內容位元組數較小時,全部載入記憶體後,再列印,沒有問題。可是,如果現在有成千上百萬條車輛行駛軌跡,叫你分析出其中每個客戶的出行規律,堵車情況等,假如是在單機上處理這件事。
你可能首先要面臨,也可能被你忽視,最後程式碼都寫好後,才可能暴露出的一個問題:outofmemory, 這在實際項目中經常遇到。
這個問題提醒我們,處理數據時,如何寫出高效利用記憶體的程式,就顯得很重要。今天,我們就來探討如何高效利用記憶體,節省記憶體同時還能把事情辦好。
其實,Python已經準備好一個模組專門用來處理這件事,它就是 itertools 模組,這裡面幾個函數的功能其實很好理解。
我不打算籠統的介紹它們所能實現的功能,而是想分析這些功能背後的實現程式碼,它們如何做到高效節省記憶體的,Python內核的貢獻者們又是如何寫出一手漂亮的程式碼的,這很有趣,不是嗎?
OK,let's go. Hope you enjoy the journey!
5.1 拼接元素
itertools 中的chain 函數實現元素拼接,原型如下,參數*表示個數可變的參數
chain(iterables)
應用如下:
In [33]: list(chain(['I','love'],['python'],['very', 'much'])) Out[33]: ['I', 'love', 'python', 'very', 'much']
哇,不能再好用了,它有點join的味道,但是比join強,它的重點在於參數都是可迭代的實例。
那麼,chain如何實現高效節省記憶體的呢?chain大概的實現程式碼如下:
def chain(*iterables): for it in iterables: for element in it: yield element
以上程式碼不難理解,chain本質返回一個生成器,所以它實際上是一次讀入一個元素到記憶體,所以做到最高效地節省記憶體。
5.2 逐個累積
返回列表的累積匯總值,原型:
accumulate(iterable[, func, *, initial=None])
應用如下:
In [36]: list(accumulate([1,2,3,4,5,6],lambda x,y: x*y)) Out[36]: [1, 2, 6, 24, 120, 720]
accumulate大概的實現程式碼如下:
def accumulate(iterable, func=operator.add, *, initial=None): it = iter(iterable) total = initial if initial is None: try: total = next(it) except StopIteration: return yield total for element in it: total = func(total, element) yield total
以上程式碼,你還好嗎?與chain簡單的yield不同,此處稍微複雜一點,yield有點像return,所以 yield total那行直接就返回一個元素,也就是iterable的第一個元素,因為任何時候這個函數返回的第一個元素就是它的第一個。又因為yield返回的是一個generator對象,比如名字gen,所以next(gen)時,程式碼將會執行到 for element in it:這行,而此時的迭代器it 已經指到iterable的第二個元素,OK,相信你懂了!
5.3 漏斗篩選
它是compress 函數,功能類似於漏斗功能,所以我稱它為漏斗篩選,原型:
compress(data, selectors)
In [38]: list(compress('abcdefg',[1,1,0,1])) Out[38]: ['a', 'b', 'd'] 容易看出,compress返回的元素個數等於兩個參數中較短的列表長度。
它的大概實現程式碼:
def compress(data, selectors): return (d for d, s in zip(data, selectors) if s)
這個函數非常好用
5.4 段位篩選
掃描列表,不滿足條件處開始往後保留,原型如下:
dropwhile(predicate, iterable)
應用例子:
In [39]: list(dropwhile(lambda x: x<3,[1,0,2,4,1,1,3,5,-5])) Out[39]: [4, 1, 1, 3, 5, -5]
實現它的大概程式碼如下:
def dropwhile(predicate, iterable): iterable = iter(iterable) for x in iterable: if not predicate(x): yield x break for x in iterable: yield x
5.5 段位篩選2
掃描列表,只要滿足條件就從可迭代對象中返回元素,直到不滿足條件為止,原型如下:
takewhile(predicate, iterable)
應用例子:
In [43]: list(takewhile(lambda x: x<5, [1,4,6,4,1])) Out[43]: [1, 4]
實現它的大概程式碼如下:
def takewhile(predicate, iterable): for x in iterable: if predicate(x): yield x else: break #立即返回
5.6 次品篩選
掃描列表,只要不滿足條件都保留,原型如下:
dropwhile(predicate, iterable)
應用例子:
In [40]: list(filterfalse(lambda x: x%2==0, [1,2,3,4,5,6])) Out[40]: [1, 3, 5]
實現它的大概程式碼如下:
def dropwhile(predicate, iterable): iterable = iter(iterable) for x in iterable: if not predicate(x): yield x break for x in iterable: yield x
5.7 切片篩選
Python中的普通切片操作,比如:
lis = [1,3,2,1] lis[:1]
它們的缺陷還是lis 必須全部載入記憶體,所以更節省記憶體的操作islice,原型如下:
islice(iterable, start, stop[, step])
應用例子:
In [41]: list(islice('abcdefg',1,4,2)) Out[41]: ['b', 'd'] 實現它的大概程式碼如下:
def islice(iterable, *args): s = slice(*args) start, stop, step = s.start or 0, s.stop or sys.maxsize, s.step or 1 it = iter(range(start, stop, step)) try: nexti = next(it) except StopIteration: for i, element in zip(range(start), iterable): pass return try: for i, element in enumerate(iterable): if i == nexti: yield element nexti = next(it) except StopIteration: for i, element in zip(range(i + 1, stop), iterable): pass
巧妙利用生成器迭代結束時會拋出異常StopIteration,做一些邊界處理的事情。
5.8 細胞分裂
tee函數類似於我們熟知的細胞分裂,它能複製原迭代器n個,原型如下:
tee(iterable, n=2)
應用如下,可以看出複製出的兩個迭代器是獨立的
a = tee([1,4,6,4,1],2) In [51]: next(a[0]) Out[51]: 1 In [52]: next(a[1]) Out[52]: 1
實現它的程式碼大概如下:
def tee(iterable, n=2): it = iter(iterable) deques = [collections.deque() for i in range(n)] def gen(mydeque): while True: if not mydeque: try: newval = next(it) except StopIteration: return for d in deques: d.append(newval) yield mydeque.popleft() return tuple(gen(d) for d in deques)
tee 實現內部使用一個隊列類型deques,起初生成空隊列,向複製出來的每個隊列中添加元素newval, 同時yield 當前被調用的mydeque中的最左元素。
5.9 map變體
starmap可以看做是map的變體,它能更加節省記憶體,同時iterable的元素必須也為可迭代對象,原型如下:
starmap(function, iterable)
應用它:
In [63]: list(starmap(lambda x,y: str(x)+'-'+str(y), [('a',1),('b',2),('c',3)])) Out[63]: ['a-1', 'b-2', 'c-3'] starmap的實現細節如下:
def starmap(function, iterable): for args in iterable: yield function(*args)
5.10 複製元素
repeat實現複製元素n次,原型如下:
repeat(object[, times])
應用如下:
In [66]: list(repeat(6,3)) Out[66]: [6, 6, 6] In [67]: list(repeat([1,2,3],2)) Out[67]: [[1, 2, 3], [1, 2, 3]]
它的實現細節大概如下:
def repeat(object, times=None): if times is None:# 如果times不設置,將一直repeat下去 while True: yield object else: for i in range(times): yield object
5.11 笛卡爾積
笛卡爾積實現的效果同下:
((x,y) for x in A for y in B)
所以,笛卡爾積的實現效果如下:
In [68]: list(product('ABCD', 'xy')) Out[68]: [('A', 'x'), ('A', 'y'), ('B', 'x'), ('B', 'y'), ('C', 'x'), ('C', 'y'), ('D', 'x'), ('D', 'y')] 它的實現細節:
def product(*args, repeat=1): pools = [tuple(pool) for pool in args] * repeat result = [[]] for pool in pools: result = [x+[y] for x in result for y in pool] for prod in result: yield tuple(prod)
5.12 加強版zip
組合值。若可迭代對象的長度未對齊,將根據 fillvalue 填充缺失值,注意:迭代持續到耗光最長的可迭代對象,效果如下:
In [69]: list(zip_longest('ABCD', 'xy', fillvalue='-')) Out[69]: [('A', 'x'), ('B', 'y'), ('C', '-'), ('D', '-')] 它的實現細節:
def zip_longest(*args, fillvalue=None): iterators = [iter(it) for it in args] num_active = len(iterators) if not num_active: return while True: values = [] for i, it in enumerate(iterators): try: value = next(it) except StopIteration: num_active -= 1 if not num_active: return iterators[i] = repeat(fillvalue) value = fillvalue values.append(value) yield tuple(values)
它裡面使用repeat,也就是在可迭代對象的長度未對齊時,根據 fillvalue 填充缺失值。理解上面程式碼的關鍵是迭代器對象(iter),next方法的特殊性:
In [74]: for i, it in enumerate([iter([1,2,3]),iter(['x','y'])]): ...: print(next(it)) #輸出: 1 x
結合這個提示再理解上面程式碼,就不會吃力。
5.13 總結
Python的itertools模組提供的節省記憶體的高效迭代器,裡面實現基本都藉助於生成器,所以一方面了解這12個函數所實現的基本功能,同時也能加深對生成器(generator)的理解,為我們寫出更加高效、簡潔、漂亮的程式碼打下堅實基礎。
6 模組
太好了,一分鐘帶你分清Python的模組、包和庫
6.1 模組
一個.py文件就稱之為一個模組(Module),一個模組里可能會包含很多函數,函數命名時,盡量不要與內置函數名字衝突。
常見的內置函數見文章:
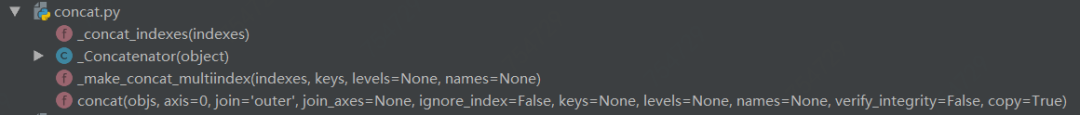
Pandas的concat.py模組如下:
img
裡面包括3個函數和1個類
注意:
系統自帶了sys模組,自己的模組就不可命名為sys.py,否則將無法導入系統自帶的sys模組。檢查方法是在Python交互環境執行import abc,若成功則說明系統存在此模組。
6.2 包
包(Package)下有多個模組,如下為pandas 的reshape 包,裡面包括多個.py 文件。

img
裡面有一個.py文件比較特殊,也是每個包下必須包括的,它是__init__.py
__init__.py可以是空文件,在此處reshape包下的這個文件就是空的。當然,也可以有Python程式碼,因為__init__.py本身就是一個模組。模組__init__.py的模組名在此處就是reshape。
可以有多級層次的包結構。比如pandas的core包,含有如下的目錄結構:

img
6.3 庫
庫是指具有相關功能模組的集合。這也是Python的一大特色之一,即具有強大的標準庫、第三方庫以及自定義模組。
標準庫:python里那些自帶的模組
第三方庫:就是由其他的第三方機構,發布的具有特定功能的模組。比如2018年最受歡迎的幾個庫:TensorFlow、pandas、scikit-learn、PyTorch、Matplotlib、Keras、NumPy、SciPy、Apache MXNet、Theano、Bokeh、XGBoost、Gensim、Scrapy、Caffe
自定義模組:用戶自己可以自行編寫模組,然後使用。
導入模組與包都是通過import來導入的
