資料庫整理
創建資料庫
創建資料庫需要指定字符集,不然容易在插入數據時發生錯誤。
create database 資料庫名 default charset utf8 collate utf8_general_ci;
創建表
創建表很容易創建,但是值得注意的是,創建表時,有時候同樣需要指定字符集以及引擎。除此之外還有約束條件。
create table 表名(
    屬性1 數據類型 not null primary key auto_increment comment '屬性描述',  # 非空、主鍵、自增。
    屬性2 數據類型 default 1 comment '屬性描述',    # 默認值constraint `外鍵名稱` foreign key (屬性) references 參照表(屬性),
)engine = InnoDB default charset =utf8;
插入數據
插入數據有兩種方式,但我們一般選擇有列名的。
Insert into 表名(列1,……列n) values (值1,……值n);
Insert into 表名  values(值1,……值n);
複製數據也算是插入數據的一種,語法如下,但要注意的是表2必須事先存在,而且查詢出的欄位數目、數據類型、欄位順序要與插入列保持一致。
Insert into 表2 列名 select 列名 from 表1;
更新數據
更新數據的前提是要遵守約束。
update 表名 set 列1 = 新值1,列2 = 新值2 where expr
刪除數據
刪除數據用 delete from 表名 where expr。
刪除數據表 用 drop table;
查詢數據(單表查詢)
查詢分為單表查詢和多表查詢。
1. 簡單查詢,比如查詢某一列(行)或者多行(列)。
2. 去重:distinct關鍵字指示資料庫只返回不同的值。
3. where 條件 查詢,例如,查詢姓名為張三的學生資訊;select * from student where sname=『張三』;
3.1 where 常用的比較運算符;=、>、>=、<、<=、<>等。
3.2 between……and 代表的意思是兩者之間且包括兩者。
3.3 in、not in 判斷某個欄位的值是否在指定的集合中。
3.4 like 選擇類似的值,例如:姓劉的:like '劉%'。 如果說是姓名為兩個字,且姓為張 : like '張_'。
3.5 is nul:判斷為空 not null : 判斷不為空
3.6 邏輯運算: and or not
4. group by 分組查詢
4.1 分組函數作用於一組數據,並對一組數據返回一個值。
4.2 avg函數返回滿足where條件的一列的平均值。聚合函數之一
4.3 count(列名)返回某一列,行的總數。聚合函數之一
4.4 Max/Min函數返回滿足where條件的一列的最大/最小值。聚合函數之一
4.5 sum函數返回滿足where條件的行的和。聚合函數之一
SELECT  聚合函數和group by後存在的欄位  FROM .. WHERE ….  GROUP BY 欄位1[,欄位2,欄位3];
舉個例子:查詢學號範圍在1001~1010之間的這10位學生的總成績,
select sum(degree),sno  from score where sno between 1001 and 1010 group by sno;
5. having 篩選
having 和 where 的區別:
1. having與where類似,可篩選數據,where 後的表達式怎麼寫,having就怎麼寫
2. having 針對查詢結果中的列發揮作用,篩選數據。where針對表中的列發揮作用,查詢數據
3. gruop by 是在where條件後執行的。having是在group by 後執行的。
4. having 後可以使用聚合函數,where不可以。
6. order by 排序
order by 指定排序的列,排序的列即可以是表中的列名,也可以是select 語句後指定的列名。
order by 默認是asc即升序。降序為desc
order by子句應該位於select 語句的結尾。order by後面可以跟多個排序條件。
7. limit 限制結果條數
Limit [offset , N] 從offset開始,限制結果取N條。經常用於分頁。
其中的3~7被合稱為select的5種子句。
查詢語句的編寫順序:SELECT … FROM … WHERE … GROUP BY … HAVING … ORDER BY …
查詢語句的執行順序:WHERE -> GROUP BY -> HAVING -> SELECT -> ORDER BY
常用函數
1. 時間日期相關函數:
| current_Date() | 當前日期 |
| current_Time() | 當前時間 |
| datediff(date1,date2) | 兩個日期差多少天 |
| timediff(date1,date2) | 兩個時間差多少時多少分多少秒 |
| now() | 當前時間 |
| Year()、Month()、Date() | 獲取年、獲取月。獲取日 |
2. 字元串相關函數:

3. 數學相關函數

4. 流程式控制制函數

舉個簡單的例子:例如:SELECT scoid,socre,IF(socre>=60,'及格','不及格') AS 等級 from score;
5. 其他函數
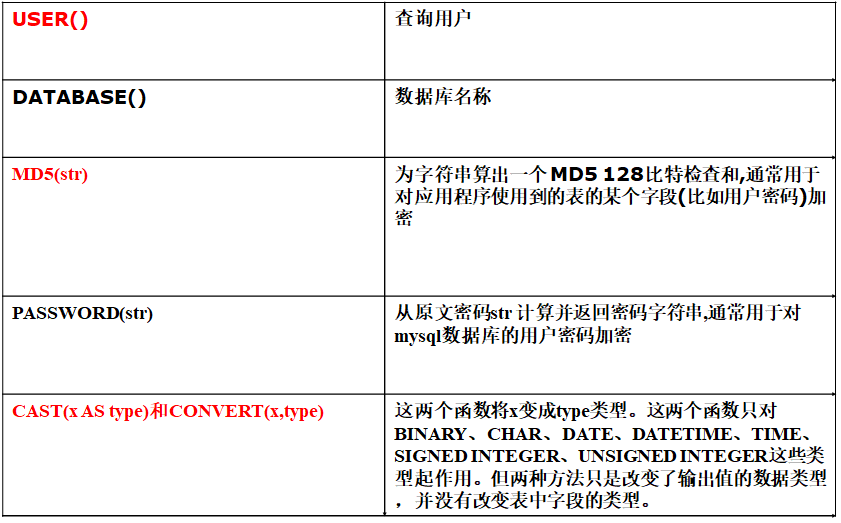
舉幾個例子:
# 獲取當前用戶
select user() as s1;

#加密函數
select md5(name) from student;

#改變欄位數據類型的函數
select cast('123' as unsigned int)+1
select convert('123',unsigned int) +1
多表查詢
1. 交叉連接:交叉連接會返回被連接的兩個表的笛卡爾積,返回結果的行數等於兩個錶行數的乘積。
交叉連接的三種語法:
select  * from table1 cross join table2 where 條件;
select * from table1 join table2 where 條件;
select * from table1,table2 where 條件;
2. 等值連接:where條件後是『=』則為等值連接;
3. 內連接:合併具有同一列的兩個以上的表的行,結果集中不包含一個表與另一個表不匹配的行。
語法:SELECT <列名> FROM 表1 INNER JOIN 表2 ON 表1.列名 條件運算符 表2.列名 [WHERE 條件] [ORDER BY 排序列]
舉個例子:查詢小王所考科目的平均成績,顯示成績,平均成績
select name,avg(score) from score inner join student on score.stuid = student.stuid where name = '小王'
3. 外連接:外連接分為左外連接和右外連接。
3.1外連接和普通連接的區別:普通連接操作只輸出滿足連接條件的元組。外連接操作以指定表為連接主體,將主體表中不滿足連接條件的元組一併輸出。
3.2 左外連接:左外連接使用LEFT JOIN連接兩表,連接時左表為主表,左表中的每條記錄必定出現在結果集中,而在右表中沒有對應的記錄,將以NULL值進行填充。
SELECT * FROM TABLE_A LEFT JOIN TABLE_B ON 連接條件 [WHERE 條件]
舉個例子:查詢所有學生課程的考試成績,查詢結果保留學生ID、姓名、性別、課程ID、成績
select student.sno,name,sex,sno,scorre from student left join score on student .sno = score.sno;
3.3 右外連接 :右外連接與左外連接相似,不同的是右表為主表,右表中的每條記錄必定出現在結果集中,而在左表中沒有對應的記錄,將以NULL值進行填充。
語法:SELECT * FROM TABLE_A RIGHT JOIN TABLE_B ON 連接條件 [WHERE 條件]
4. 內外連接的區別:

子查詢
子查詢就是在原有的查詢語句中, 嵌入新的查詢,來得到我們想要的結果集。 也叫嵌套查詢。
子查詢分為:比較子查詢,IN/NOT IN子查詢,EXISTS/NOT EXISTS子查詢
IN/NOT IN 與 EXISTS/NOT EXISTS的區別:
IN/NOT IN先執行子查詢,子查詢返回的是一個集合,然後再將子查詢的結果作為外層查詢的條件進行過濾。
EXISTS/NOT EXISTS先執行外層查詢,再將外層查詢的每一條記錄作為條件進行子查詢,子查詢返回的只是返回一個TRUE或FALSE,因此一般情況 下子查詢中直接使用SELECT 1提高效率。
視圖
什麼是視圖:視圖是一張虛擬表,視圖中不存放數據,數據存放在視圖所引用的原始表中。
如何創建:create view 視圖名 as select 語句
如何查看視圖:select * from 視圖名
如何刪除視圖:drop view 視圖名
查看視圖表結構:desc 視圖名
查看視圖:show create view 視圖名
修改視圖:alter view 視圖名 as select 語句
注意點:當表發生改變,視圖也會發生改變。同樣的當視圖發生數據的增刪改,那麼同樣也會影響到表。
視圖的優點:訂製數據、聚焦數據。簡化數據操作,原表中的數據有一定的安全性,合併分離的數據,創建分區視圖。
索引:
索引是以表列為基礎建立的資料庫對象,它保存著表中排序的索引列,並且記錄了索引列在數據表中的物理存儲位置,實現了表中數據的邏輯排序
使用索引,加快了查詢速度。但降低了曾、刪、改的速度,增大了表的文件大小。
索引的類型有以下六種:

普通索引僅僅加快了查詢的速度,主鍵索引:加上主鍵的列的值不能重複。
唯一索引:加上唯一索引的列的值不能重複,它和主鍵索引的區別是:主鍵必須唯一,但索引不一定是主鍵,一張表中只能有一個主鍵,但是可以有一個或多個唯一索引。
索引的創建:
# 建表時直接聲明索引
create table tableName (
列1 列類型 列屬性,
....
列N 列類型 列屬性,
primary key(列名),
index (列名),
unique(列名),
fulltext(列名)
)engine xxxxx  charset xxxx

# 通過修改表建立索引:
alter table add index (列名);
alter table add unique (列名);
alter table add primary key(列名);
alter table add fulltext (列名);
索引的刪除:
刪除主鍵索引:alter table drop primary key
刪除其他索引:alter table drop index 索引名
索引的查看:show index from tableName

