工作中遇到的99%SQL優化,這裡都能給你解決方案(三)
- 2019 年 10 月 3 日
- 筆記
-- 示例表 CREATE TABLE `employees` ( `id` int(11) NOT NULL AUTO_INCREMENT, `name` varchar(24) NOT NULL DEFAULT '' COMMENT '姓名', `age` int(20) NOT NULL DEFAULT '0' COMMENT '年齡', `position` varchar(20) NOT NULL DEFAULT '' COMMENT '職位', `hire_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '入職時間', PRIMARY KEY (`id`), KEY `idx_name_age_position` (`name`,`age`,`position`) USING BTREE, KEY `idx_age` (`age`) USING BTREE ) ENGINE=InnoDB AUTO_INCREMENT=136326 DEFAULT CHARSET=utf8 COMMENT='員工表' --創建100000條記錄 drop procedure if EXISTS insert_emp; delimiter ;; create procedure insert_emp() BEGIN declare i int; set i=1; while(i < 100000)DO INSERT INTO employees(name,age,position) values(CONCAT('xiaoqiang',i),i,'coder'); SET i=i+1; end WHILE; end;; delimiter ; call insert_emp();根據自增且連續的主鍵排序的分頁查詢
select * from employees LIMIT 9999 ,5;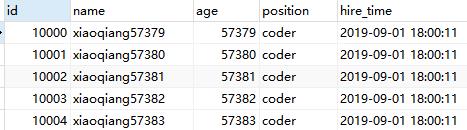

表示從表employees 中取出從10000行開始的5行記錄。看似只查詢5條記錄,實際這條SQL是先讀取10005條記錄,然後拋棄前10000條記錄,然後讀到後面5條想要的數據。沒有添加單獨的order by,表示通過主鍵排序。
因此要查詢一張大表比較靠後的數據,執行效率是非常低的。
因為主鍵是自增且連續的,所以可以改寫成按照主鍵查詢從第10001開始的五行數據,如下:
select * from employees WHERE id > 9999 limit 5;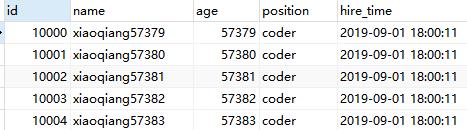

可以看到兩個sql的執行計劃,顯然改寫後的sql走了索引,而且掃描的行數大大減少,執行效率會更高。但是,這條改寫的sql在很多場景下並不實用,因為表中可能某些記錄被刪除後,主鍵空缺,導致結果不一致。
先刪除一條記錄,然後測試下原來sql和優化後的sql:
select * from employees LIMIT 9999 ,5;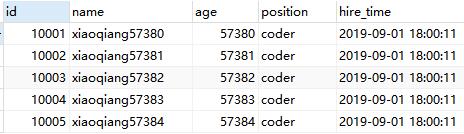
select * from employees where id> 9999 limit 5;
兩條sql的結果不一樣,因此,如果主鍵不連續,不能使用上面描述的方法。
另外由於原來sql是order by非主鍵欄位,按照上面的方法改寫sql的結果不一致。所以這種改寫得滿足以下兩個條件:
- 主鍵自增且連續
結果是按照主鍵排序的
根據非主鍵欄位排序的分頁查詢
select * from employees order by name limit 9000, 5;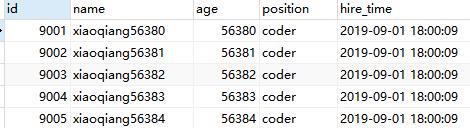
explain select * from employees order by name limit 9000, 5;
key欄位對應的值為null,發現並沒有使用name欄位的索引。因為掃描整個索引並查找到沒有索引的行,可能要便利多個索引樹,其成本比掃描全表的成本更高,索引優化器放棄使用索引。
優化的關鍵是:讓排序時返回的欄位儘可能的少,所以可以讓排序和分頁操作先查出主鍵,然後根據主鍵查到對應的記錄。
改下如下:
select * from employees as e inner join(select id from employees order by name limit 9000,5) as ed on e.id=ed.id;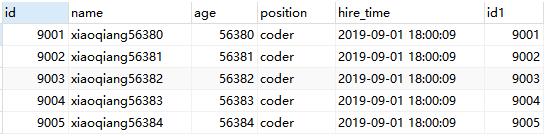
可以看到結果與原來的sql結果是一致的,執行時間減少了一般以上,再對比下執行計劃:

原來的sql使用的是filesort排序,而優化後的sql使用的是索引排序。
in和exists優化
原則:小表驅動大表,即小表的數據集驅動大表的數據集
in:當B表的數據集小於A表的數據集時,in由於exists
select * from A where id in(select id from B) 等價於 for(select id from B){ select * from A where A.id=B.id }exists:當A表的數據集小於B表的數據集時,exitsts優於in
當著查詢A的數據,放到子查詢B中做條件驗證,根據驗證結果(true或false)來決定著查詢的數據是否保留。
select * from A exists(select 1 from B where A.id=B.id) 等價於 for(select * from A){ select * from B where A.id=B.id }count(*)查詢優化
explain select count(1) from employees; explain select count(id) from employees; explain select count(name) from employees; explain select count(*) from employees;
四個sql的執行計劃幾乎一樣的,count(name)使用的是聯合索引, 主要區別根據某個欄位做count操作不會統計欄位為null的值的數據行。
除了count(name)的其他count操作,都是用的輔助索引而不是主鍵索引, 因為二級索引存儲數據更少,檢索性能更高。
還沒關注我的公眾號?
- 掃文末二維碼關注公眾號【小強的進階之路】可領取如下:
- 學習資料: 1T影片教程:涵蓋Javaweb前後端教學影片、機器學習/人工智慧教學影片、Linux系統教程影片、雅思考試影片教程;
- 100多本書:包含C/C++、Java、Python三門程式語言的經典必看圖書、LeetCode題解大全;
- 軟體工具:幾乎包括你在編程道路上的可能會用到的大部分軟體;
- 項目源碼:20個JavaWeb項目源碼。