Java集合:LinkedList (JDK1.8 源碼解讀)
- 2019 年 10 月 3 日
- 筆記
LinkedList介紹
還是和ArrayList同樣的套路,顧名思義,linked,那必然是基於鏈表實現的,鏈表是一種線性的儲存結構,將儲存的數據存放在一個存儲單元裡面,並且這個存儲單元裡面還維護了下一個存儲單元的地址。在LinkedList的鏈表儲存單元中,不僅存放了下一個存儲單元的地址,還存放了上一個單元的儲存地址,因為Linked是雙向鏈表,雙向鏈表就是可以通過鏈表中任意一個存儲單元可以獲取到上一個存儲單元和下一個存儲單元。
先看一下這個神秘的儲存單元,在LinkedList的內部類中聲明:
private static class Node<E> { E item; Node<E> next; Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } }
Node就是LinkedList的儲存單元,在JDK1.6中叫Entry,不過結構還是一樣的,裡面有三個變數一個帶這三個參數的構造方法,這三個變數分別是
1.item:存儲在存儲單元Node中的元素
2.next:下一個存儲單元
3.prev:下一個存儲單元
LinkedList的關注點
1.是否允許為空:是
2.是否允許重複數據:是
3.是否有序:是
4.是否執行緒安全:否
和之前講的ArrayList的四個關注點一模一樣
LinkedList的聲明:
public class LinkedList<E> extends AbstractSequentialList<E> implements List<E>, Deque<E>, Cloneable, java.io.Serializable { transient int size = 0; transient Node<E> first; transient Node<E> last; ... }
LinkedList除了實現List、Cloneable和Serializable介面外還實現了Deque介面,說明LinkedList具有隊列的特性,可以當做隊列使用
舉個簡單的小栗子:
1 List<String> list= new LinkedList<>(); 2 list.add("11"); 3 list.add("22"); 4 list.add("33");
LinkedList提供了兩種構造方法,例子使用的是第一種也是最常用的無參構造器:
public LinkedList() { }
這個構造方法沒有執行其他任何的操作,這與jdk1.6有所不同,jdk1.6中聲明了一個header節點,然後執行了 header.next = header.previous = header,jdk1.8中聲明了first和last兩個節點,但是構造的時候沒有操作這兩個節點。
第二種構造器和ArrayList一樣提供了一個傳入集合的構造方法public LinkedList(Collection<? extends E> c)
添加元素
接著看第二行list.add("11")做了什麼:
1 public boolean add(E e) { 2 linkLast(e); 3 return true; 4 } 5 6 void linkLast(E e) { 7 final Node<E> l = last; 8 final Node<E> newNode = new Node<>(l, e, null); 9 last = newNode; 10 if (l == null) 11 first = newNode; 12 else 13 l.next = newNode; 14 size++; 15 modCount++; 16 }
LinkedList的add方法執行的是linkLast方法,linkLast方法就是把元素e鏈接成列表的最後一個元素,
1.首先聲明一個變數l,將這個l指向last也就是列表最後一個節點
2.new一個新的Node節點newNode,這個newNode就是新增元素的儲存單元,根據之前給的Node的構造方法,它創建了一個上一個節點為l節點,儲存元素為你新增的元素e,下一個節點為null的儲存單元
3.將代表列表最後一個節點的last變數指向新的節點newNode,也就是將列表的最後一個儲存單元變成了新的newNode節點
4.如果l==null,也就是列表最後一個節點是null,那麼列表第一個節點也是newNode,也就是說如果列表是空,newNode就是第一個也是目前唯一一個儲存單元,它既是頭也是尾。如果之前的最後一個儲存單元不是null,就將之前的儲存單元的下一個節點地址改為新增的儲存單元
可能說的比較繞比較抽象,畫圖表示一下:
假設null的記憶體地址是0x0000,新增元素“11”的存儲單元地址是0x0001,元素“22”儲存單元地址是0x0002,元素“33”儲存單元地址是0x0003,每一步修改的地方我都用紅色標記出來

查找元素
LinkedList查找元素也是使用的get方法,當然也有別的方法,先看一下get方法怎麼寫的:
1 public E get(int index) { 2 checkElementIndex(index); //index >= 0 && index < size 3 return node(index).item; 4 } 5 6 Node<E> node(int index) { 7 if (index < (size >> 1)) { 8 Node<E> x = first; 9 for (int i = 0; i < index; i++) 10 x = x.next; 11 return x; 12 } else { 13 Node<E> x = last; 14 for (int i = size - 1; i > index; i--) 15 x = x.prev; 16 return x; 17 } 18 }
LinkedList查找元素也是先檢查下標,檢查的判斷已經寫在第二行的備註中,然後通過node()方法去尋找元素
查詢對應下標節點的時候首先用了一個判斷,這個判斷很有意思,它判斷指定下標index是否小於元素個數的一半,如果小於一半也就是你指定的下標位於列表前半段它就從列表第一個節點開始遍歷,通過循環獲取每個節點的next節點,如果大於一半位於列表後半段就從列表最後一個節點開始遍歷,循環獲取每個節點的prev節點,這樣做的好處就是假如列表有1000個元素,get(999)就得遍歷999次才能找到元素,這就是雙向鏈表的好處,通過維護前置節點,雖然增加了編程複雜度,也消耗了更多的空間,卻能提升查找效率。
註:即便LinkedList使用了這種巧妙的思想,但是查找速度還是不及ArrayList的隨機訪問模式,畢竟需要遍歷
刪除元素
LinkedList刪除元素和ArrayList一樣支援按照下標刪除和按照元素刪除,舉個例子:
1 List<String> list = new LinkedList<>(); 2 list.add("11"); 3 list.add("22"); 4 list.add("33"); 5 list.remove(1);
看看remove方法程式碼:
1 public E remove(int index) { 2 checkElementIndex(index); 3 return unlink(node(index)); 4 } 5 6 E unlink(Node<E> x) { 7 // assert x != null; 8 final E element = x.item; 9 final Node<E> next = x.next; 10 final Node<E> prev = x.prev; 11 12 if (prev == null) { 13 first = next; 14 } else { 15 prev.next = next; 16 x.prev = null; 17 } 18 19 if (next == null) { 20 last = prev; 21 } else { 22 next.prev = prev; 23 x.next = null; 24 } 25 26 x.item = null; 27 size--; 28 modCount++; 29 return element; 30 }
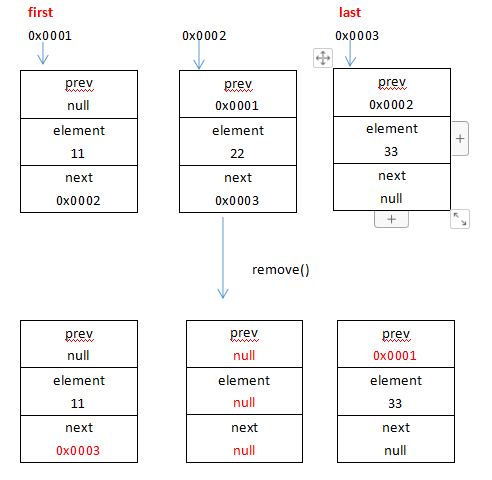
先檢查下標,然後通過node方法找到指定下標的元素,交給unlink方法去執行刪除的操作,說一下unlink的步驟
1.先獲取當前節點x的元素,當前節點x的下一個儲存單元節點next和上一個儲存單元的節點prev
2.如果上一個儲存單元為null,那說明當前節點是鏈表的第一個節點,所以需要把代表第一個節點的first變數指向當前x節點的next節點,如果下一個儲存單元為null,當前節點為鏈表的最後一個節點,同樣的需要把last節點指向x節點的prev節點
3.如果既不是第一個節點也不是最後一個節點這種特殊情況,也就是執行兩個else裡面的操作,先把x節點的上一個節點的next指向x節點的下一個節點,並且把x.prev賦值null,然後把x節點的下一個節點的prev指向x的上一個節點,並且把x.next賦值null
4.最後把當前x節點的元素賦值null,元素個數減一
經過步驟2和步驟3,成功的切斷了x節點這個儲存單元與上下節點的聯繫,經過步驟234把x節點的prev、element、next全部變成了null,讓GC去回收它,這個步驟有點繞畫圖了解一下remove方法的執行:
假設元素‘11’的儲存單元的地址是0x0001,元素‘22’的儲存單元的地址是0x0002,元素‘33’的儲存單元的地址是0x0003,現在first指向0x0001,last指向0x0003,執行list.remove(1)操作,修改的地方我用紅色字體標記
插入元素
與ArrayList一樣的,Linked同樣提供了在指定下標插入元素的方法,之所以放在刪除之後講是因為插入元素和刪除執行的操作有些類似,舉個例子:
1 1 List<String> list = new LinkedList<>(); 2 2 list.add("11"); 3 3 list.add("33"); 4 5 list.add(1,"22");
直接看第四行list.add(1,"22")執行了什麼:
1 public void add(int index, E element) { 2 checkPositionIndex(index); 3 4 if (index == size) 5 linkLast(element); 6 else 7 linkBefore(element, node(index)); 8 }
還是先檢查如果插入的下標(index >= 0 && index <= size),如果下標正好是元素的個數就相當於往鏈表最後插入一個元素,執行之前介紹過的linkLast方法,大部分情況插入都是往鏈表中間插入元素執行linkBefore方法:
1 void linkBefore(E e, Node<E> succ) { 2 // assert succ != null; 3 final Node<E> pred = succ.prev; 4 final Node<E> newNode = new Node<>(pred, e, succ); 5 succ.prev = newNode; 6 if (pred == null) 7 first = newNode; 8 else 9 pred.next = newNode; 10 size++; 11 modCount++; 12 }
往列表中間插入元素的話會先使用node方法查到對應下標的儲存單元節點,記錄此節點的前置節點prev,然後新建一個前置節點為index下標原儲存單元前置節點、元素為e、後置節點為index下標原儲存單元的儲存單元節點,如果前置節點為nulll,就將first節點指向新建的節點,否則將index下標原儲存單元的前置節點改為新增的節點newNode,如圖:
假設元素‘11’的儲存單元的地址是0x0001,元素‘33’的儲存單元的地址是0x0002,新插入的元素‘22’的儲存單元的地址是0x0002,現在first指向0x0001,last指向0x0002,執行list.add(1,"22")操作,修改的地方我用紅色字體標記

圖上半部分是插入前,圖下半部分是插入後,拋開插入和刪除的儲存單元不談,這兩個操作都是改變上一個儲存單元節點的next地址和下一個儲存單元的prev地址,是不是很相似?所以只要理解了LinkedList的這種結構,LinkedList這些操作也是很好理解的。
拿ArrayList對比總結一下LinkedList
1.查找元素的速度,如果是按照下標查找那麼ArrayList效率肯定是高於LinkedList的,ArrayList支援隨機訪問,而LinkedList需要遍歷
2.順序添加元素,雖然LinkedList順序添加也比較方便,但是需要new對象並且需要修改一些儲存單元的引用,而ArrayList的數組是事先new好的,只需要往指定位置插入元素就行,所以大部分情況下ArrayList優於LinkedList,特殊情況ArrayList添加元素需要擴容了,隨著元素數量的增加,ArrayList擴容會越來越慢
3.刪除插入的速度,LinkedList刪除插入操作效率幾乎是固定的,先定址,後修改前後Node的next、prev引用地址,而ArrayList定址較快,慢在複製數組元素,所以如果插入、刪除的元素是在數據結構的前半段尤其是非常靠前的位置的時候,LinkedList的效率將大大快過ArrayList;越往後,ArrayList要批量copy的元素越來越少,速度會越來越快,所以刪除插入操作並不能說誰一定快
4.遍曆元素,前面說過ArrayList是實現了RandomAccess介面的支援隨機訪問,而LinkedList是沒有實現這個介面的,所以ArrayList在使用普通for循環會更快,而LinkedList使用foreach循環會更快,那麼它們使用各自最快的遍歷方式誰更快呢?
我們做個測試:
public class TestList { private static int size = 100000; public static void loop(List<Integer> list){ long startTime = System.currentTimeMillis(); for (int i = 0; i < size; i++) { list.get(i); } System.out.println(list.getClass().getSimpleName() + "for循環遍歷時間:" + (System.currentTimeMillis() - startTime) + "ms"); startTime = System.currentTimeMillis(); for (Integer i: list) { } System.out.println(list.getClass().getSimpleName() + "foreach循環遍歷時間:" + (System.currentTimeMillis() - startTime) + "ms"); } public static void main(String[] args) { List<Integer> arrayList = new ArrayList<>(); List<Integer> linkedList = new LinkedList<>(); for (int i = 0; i < size; i++) { arrayList.add(i); linkedList.add(i); } loop(arrayList); loop(linkedList); } }
執行多次的結果:
ArrayListfor循環遍歷時間:3ms ArrayListforeach循環遍歷時間:4ms LinkedListfor循環遍歷時間:4638ms LinkedListforeach循環遍歷時間:3ms ArrayListfor循環遍歷時間:2ms ArrayListforeach循環遍歷時間:4ms LinkedListfor循環遍歷時間:4753ms LinkedListforeach循環遍歷時間:2ms ArrayListfor循環遍歷時間:3ms ArrayListforeach循環遍歷時間:4ms LinkedListfor循環遍歷時間:4520ms LinkedListforeach循環遍歷時間:2ms 從執行測試程式的時候就可以看出來,LinkedList使用普通for循環遍歷出奇的慢,而在使用foreach遍歷的時候LinkedList遍歷明顯更快,甚至略優於ArrayList的foreach遍歷,所以在數據量比較大的情況下,千萬不要使用普通for循環遍歷LinkedList