關於 JMeter 5.4.1 的一點記錄
APACHE JMeter
Version: 5.4.1
取樣器
JSR223
JSR是Java Specification Requests的縮寫,意思是Java規範提案.是指向JCP(Java Community Process)提出新增一個標準化技術規範的正式請求.任何人或組織都可以向JCP提交JSR,以向Java平台增添新的API和服務.JSR已成為Java界的一個重要標準.
JSR223定義了可集成在Java平台上運行的一系列腳本語言.比如Groovy,JavaScript等.
JSR223 取樣器允許腳本用於樣本執行或一些創建/更新變數必須的計算。
當取樣器運行時,如果你不需要生成樣本結果,調用以下方法:
SampleResult.setIgnore();
這個調用會產生以下影響:
- 樣本結果不會傳輸到樣本監聽器,比如:查看結果樹(View Results Tree)、統計描述(Summariser)等
- 樣本結果也不會在斷言(Assertions)和後置處理器(PostProcessors)中評估
- 樣本結果將會用於評估樣本最後的的狀態(${JMeterThread.last_sample_ok}),並且執行緒組「採取取樣器錯誤的措施」(自 JMeter 5.4 起)
JSR223 測試元素有一個特性(編譯),它可以顯著提升性能。要從這個特性中獲取好處:
-
使用腳本文件代替內嵌它們。這將使 JMeter 編譯並快取它們,如果這個特性適用於腳本引擎(ScriptEngine)。
-
或使用腳本文本並檢查
Cache compiled script if available(快取編譯過的腳本如果可用)屬性。當使用這個特性時,確保你的腳本程式碼沒有使用 JMeter 變數或者 JMeter 函數調用,因為快取只會快取第一次替換。使用腳本參數代替。要從快取和編譯中獲得好處,使用的腳本語言引擎必須實現 JSR 223 編譯介面(Groovy 是其中之一,beanshell 和 javascript 不是)當使用 Groovy 做為腳本語言並且不檢查Cache compiled script if available(推薦使用快取),你應該設置 JVM 屬性 -Dgroovy.use.calssvalue=true 因為 Groovy 2.4.6 版本記憶體泄漏,查看:
快取大小通過 JMeter 屬性控制(jmeter.properties):
jsr223.compiled_scripts_cache_size=100
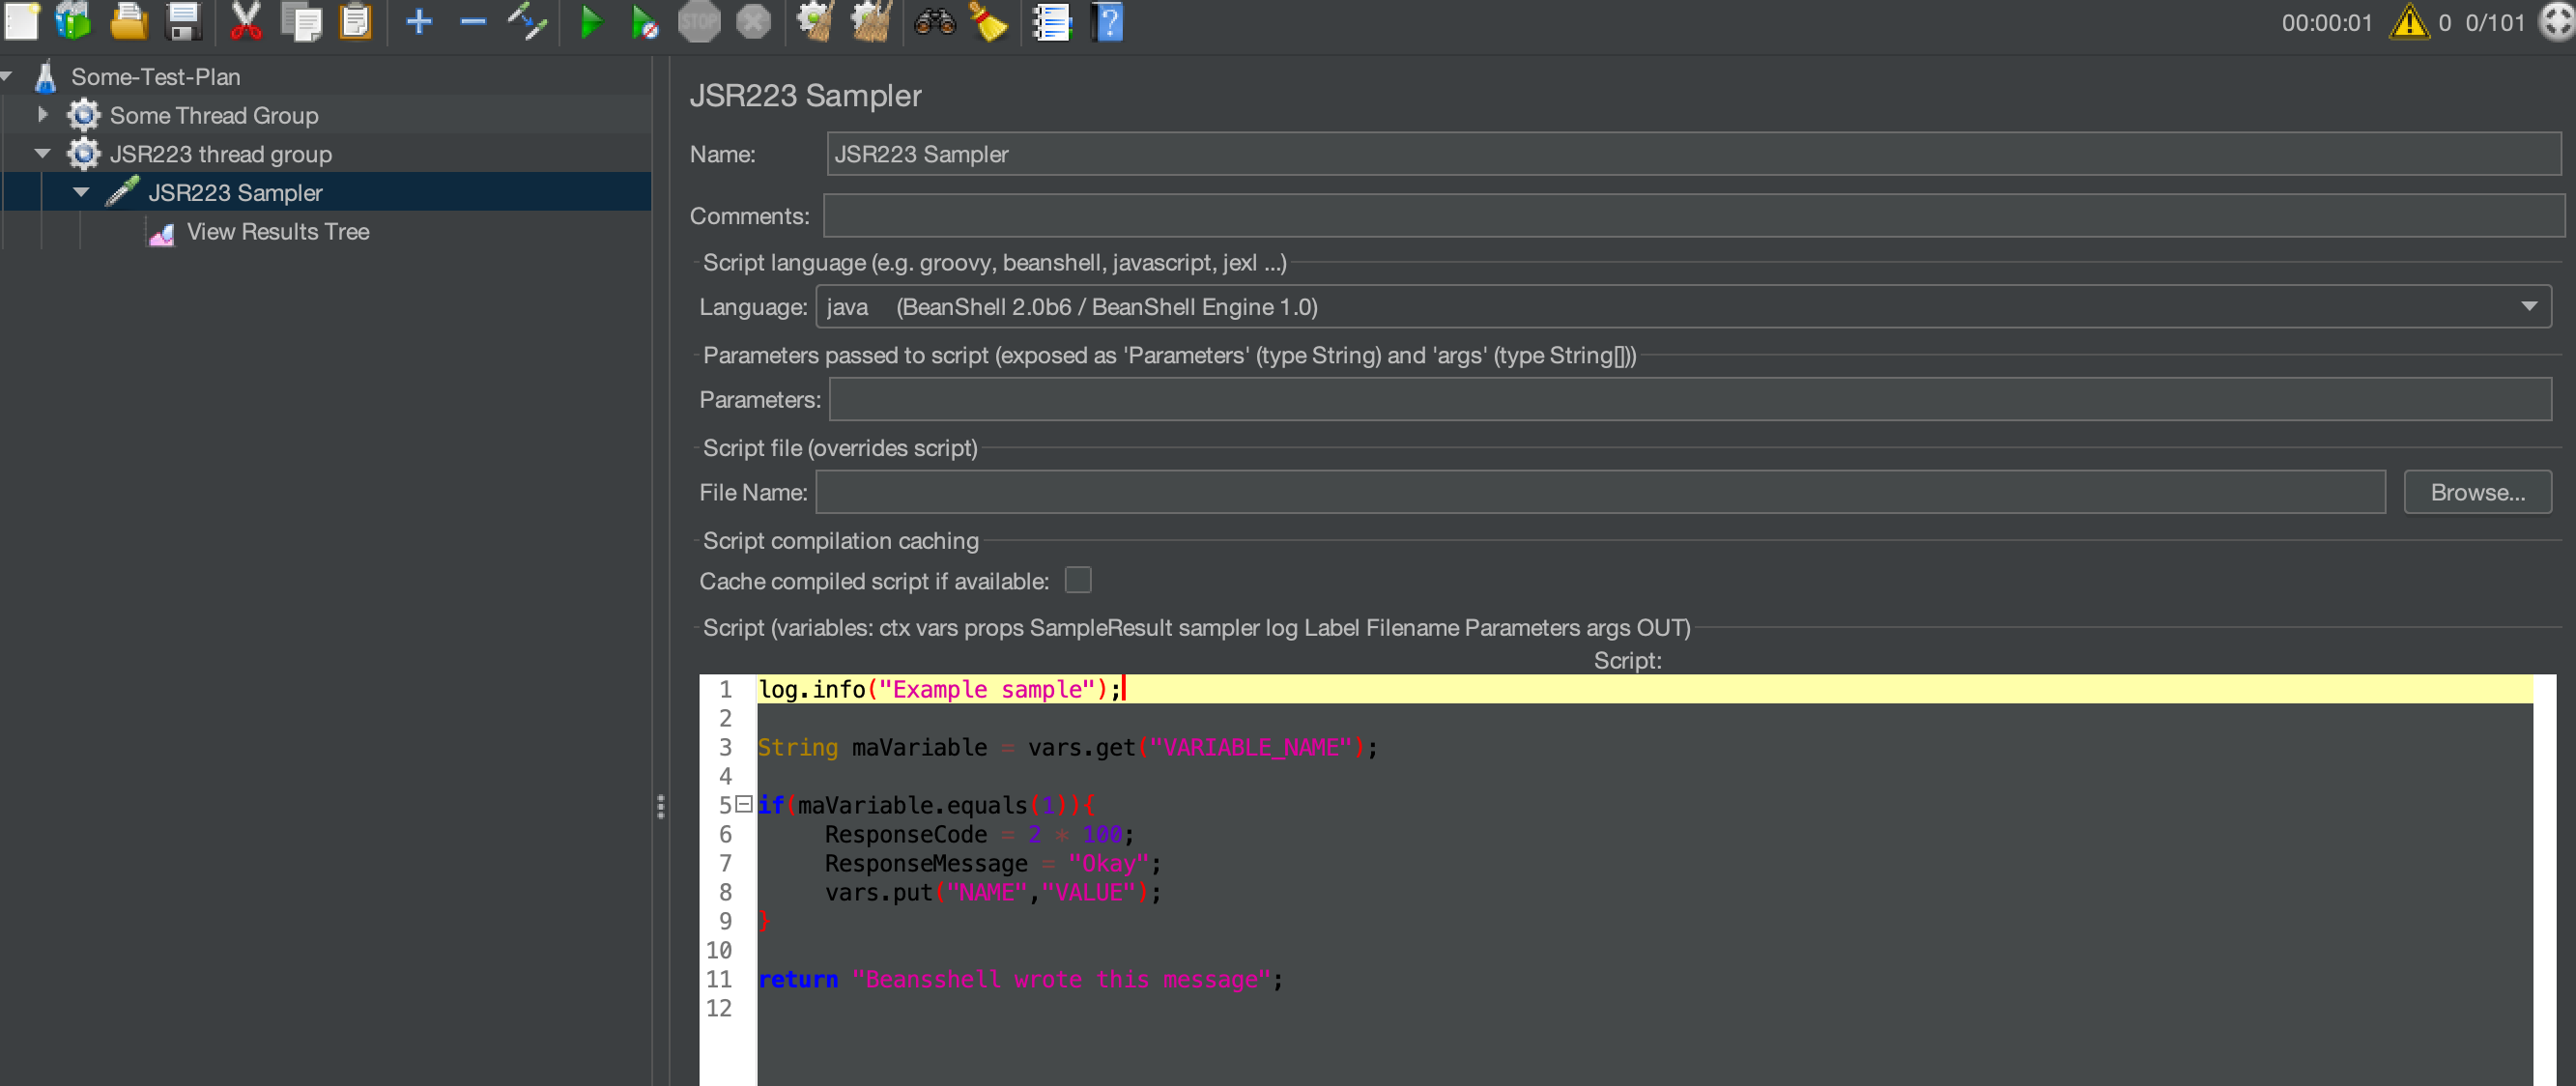
props.get("START.HMS");
props.put("PROP1","1234");
| 參數 | ||
|---|---|---|
| 屬性 | 描述 | 必填 |
| Name(名稱) | 取樣器在樹中的展示描述 | No |
| Scrpiting Language(腳本語言) | 使用的 JSR223 腳本語言名稱 | Yes |
| 不止在下拉列表中顯示的語言支援。如果合適的 jar 包安裝在 JMeter lib 文件夾下,則有可能適用。注意有的語言比如 Velocity 可能對 JSR223 變數使用不同的語法,例如: $log.debug("Hello " + $vars.get("a")); |
||
| Script File(腳本文件) | 用於 JSR223 腳本的文件名,如果使用相對地址,那麼它將通過"user.dir"系統特性關聯到文件夾 | No |
| Parameters(參數) | 傳遞到腳本文件或者腳本的參數集合 | No |
| Cache compiled script id available(快取編譯過的腳本如果可用) | 如果選中(建議選中)並且語言支援編譯介面(Groovy 是其中之一,java、beanshell和 javascript 不是),JMeter 將會編譯腳本並使用快取,腳本的 MD5 哈希值做為存儲主鍵 | No |
| Script(腳本) | 傳到 JSR223 語言的腳本 | Yes(除非提供腳本文件) |
如果支援腳本文件,那麼優先使用腳本文件,否則使用腳本。
調用腳本前,一些變數會裝配。注意有 JSR223 變數 - 例如:它們可以直接用於腳本。
- log - 日誌工具
- Label - 取樣器標籤
- FileName - 文件名,如果有的話
- Parameters - 從參數欄位獲取的文本
- args - 參數,如上所述拆分
- SampleResult - 指向當前樣本結果
- sampler - (Sampler) - 指向當前取樣器
- ctx - JMeterContext
- ctx - JMeterVariables - 例如:
vars.get("VAR1");
vars.put("VAR2","value");
vars.remove("VAR3");
vars.putObject("OBJ1",new Object());
- props - JMeter屬性(類 java.util.Properties)
props.get("START.HMS");
props.put("PROP1","1234");
- OUT - System.out - 例如:OUT.println("message")
樣本結果 響應數據設置來自腳本的返回結果。如果腳本返回 null ,它可以,通過使用方法 SampleResult.setResponseData(data) 直接設置響應,返回數據類型要麼是 String 要麼是 byte 數組。返回數據類型默認「text」,但是可以通過方法SampleResult.setDataType(SampleResult.BINARY)設置二進位。
樣本結果變數給予腳本所有欄位和方法的訪問權。例如,腳本有許可權訪問方法setStopThread(boolean) 和 setStopTest(boolean)。
不同於 BeanShell 取樣器, JSR223 取樣器不設置 ResponseCode,ReponseMessage 並且樣本狀態藉助於腳本變數。當前修改這些數據唯一的辦法是通過樣本結果方法:
- SampleResult.setSuccessful(true/false)
- SampleResult.setResponseCode("code")
- SampleResult.setResponseMessage("message")
Best Practices (最佳實踐)
設置正確的執行緒數量
除了硬體性能,測試計劃(Test Plan)設計也同樣會影響 JMeter 運行有效執行緒數量。執行緒數量還將依賴你的服務速度(更快的伺服器使 JMeter 工作更快,因為伺服器響應更快)。與任何負載測試(Load Testing)工具一樣,如果不恰當的設置執行緒數量,你將面臨「協調遺漏(Coordinated Omission)」問題,它會給你錯誤或不精確的結果。如果你需要大規模負載測試,考慮在多個機器上使用分散式模式(或者不用)運行多個 CLI JMeter 實例。當使用分散式模式時,結果文件在控制器節點(Controller node)中組合,如果使用多個自主實例,樣本結果可以組合起來以供後續分析。為了測試 JMeter 如何在給定的平台上執行,可以使用 JavaTest 取樣器。它不需要任何網路訪問,因此可以對最大可達吞吐量給出一些頭緒。
JMeter 有延遲執行緒創建的選擇,直到執行緒開始取樣。例如:在任何執行緒組延遲和執行緒自身啟動(ramp-up)時間。這將允許對於一個很大的匯流排程數量,具有不同時激活太多的能力。
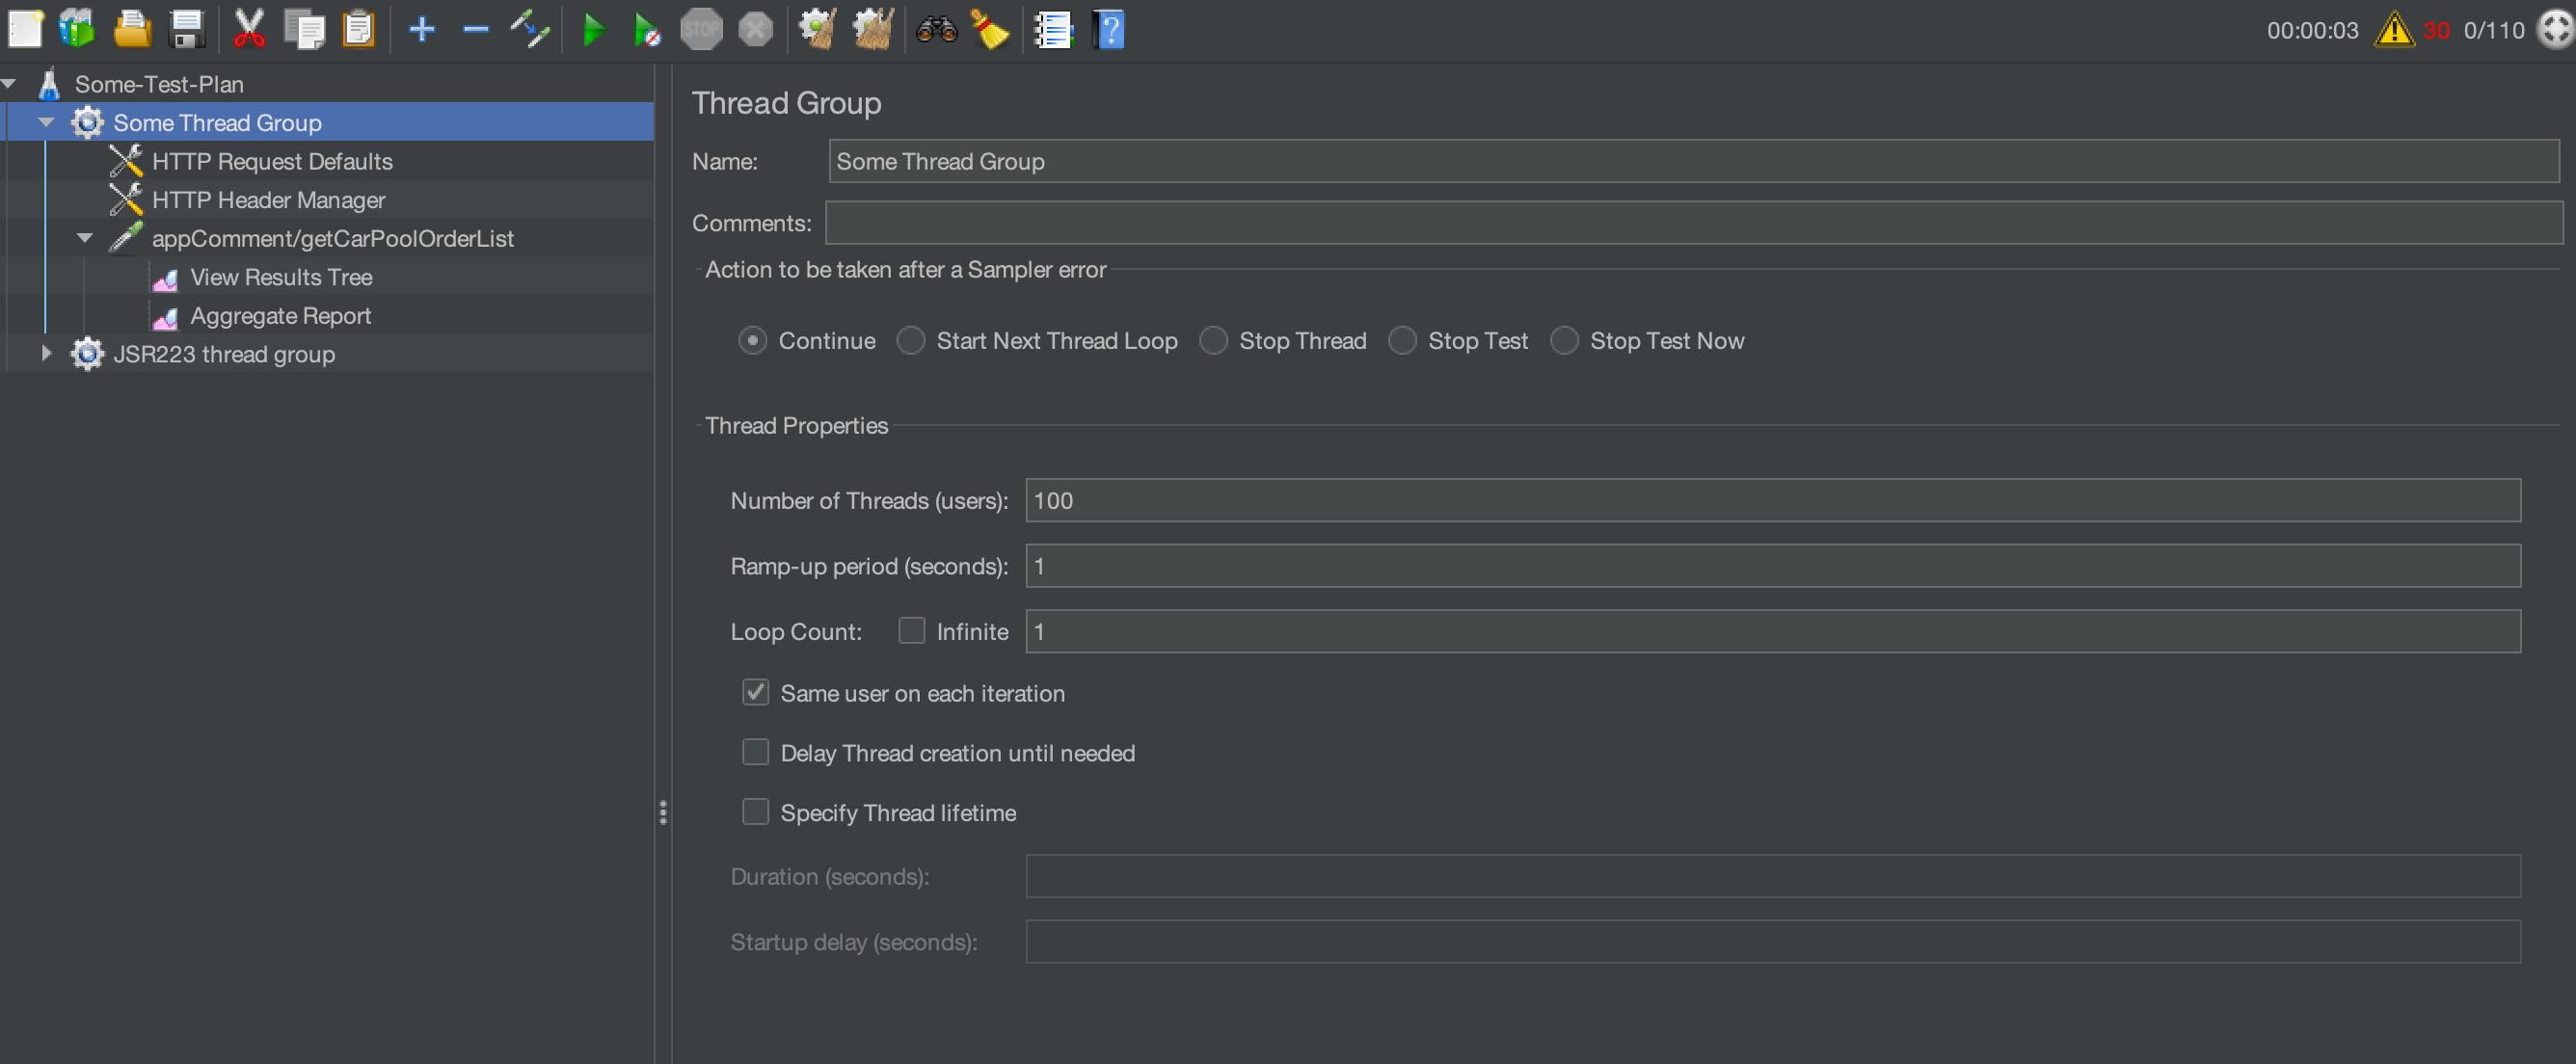
如何設置正確的執行緒數量
- 最大執行緒數量依賴於
- 運行 JMeter 的機器的功率
- JVM 32位還是64位
- JVM 分配的最大堆大小 -Xmx
- 測試計劃(大量的 beanshell 腳本、前置處理器等意味著消耗更多的 CPU)
- 作業系統配置
- GUI/NON-GUI 模式
所以沒有一個理論能直接得到最大執行緒數量。
- 設置正確的執行緒數量
- 多次設置不同執行緒數量,觀察吞吐量,找出合適的執行緒數量
Aggregate Report(聚合報告)
聚合報告在你的測試中為每個不同命名的請求在表格中創建一行。它為每個請求匯總返回資訊並提供請求次數、最短時間(同一個樣本,ms)、最長時間(同一個樣本,ms)、平均時間(結果集中的平均時間,ms)、錯誤率(請求錯誤比例)、近似吞吐率(請求/秒)和每秒 KB 吞吐量。一旦完成測試,吞吐量是整個測試期間的真實吞吐量。
吞吐量是從取樣器目標的角度計算的(例如:在 HTTP 樣本情況下的遠程伺服器)。JMeter 把生成請求的時間算入總時間。如果其它取樣器和計時器在同一個執行緒中,他們將會增加總時間,並因此減少吞吐量。所以兩個完全相同不同名字的取樣器相對兩個有相同名字的取樣器只有一半的吞吐量。要從聚合報告中獲取最佳結果,選擇正確的取樣器名字很重要。
計算中位數和 90% Line(第90百分位)值需要額外的記憶體。JMeter 現在通過相同的消耗時間聯合樣本,到目前為止,它使用的記憶體更少。然而,對於超過幾秒鐘的樣本,可能只有少數樣本有相同的時間,這種情況下需要消耗更多的記憶體。注意,之後您可以使用此偵聽器重新載入CSV或XML結果文件,這是避免對性能造成影響的推薦方法。
從 JMeter 2.12 開始,你可以配置 3 個你要計算的百分比值,可以通過設置屬性完成:
- aggregate_rpt_pct1:默認 第 90 區間
- aggregate_rpt_pct2:默認 第 95 區間
- aggregate_rpt_pct3:默認 第 99 區間
- Label - 樣本的標籤。如果選中 "Include group name in label?",那麼執行緒組的名稱會做為前綴加到標籤中。這樣,可以根據需要分別整理來自不同執行緒組的相同標籤。
-
Samples - 具有相同標籤的的樣本數量
- Average - 一個結果集中的平均時間
- Median - 中位數是結果集中的中間數。 50% 的樣本花費不超過這個時間;剩餘的至少花費了一樣的時間。
- 90% Line - 百分之 90 的樣本花費不超過這個時間。剩餘的樣本至少花費了一樣的時間。(第 90 百分位)
- 95% Line - 百分之 95 的樣本花費不超過這個時間。剩餘的樣本至少花費了一樣的時間。(第 95 百分位)
- 99% Line - 百分之 99 的樣本花費不超過這個時間。剩餘的樣本至少花費了一樣的時間。(第 99 百分位)
- Min - 同一個標籤里樣本的最短時間
- Max - 同一個標籤里樣本的最長時間
- Error % - 錯誤請求百分比
- Throughput - 吞吐量用與測量每秒鐘/分鐘/小時的請求數。時間單位是選擇的所以顯示比例至少是 1.0。當吞吐量保存到 CSV 文件時,它通過 請求數/秒 表示,例如:30.0 請求數/分 保存為 0.5 請求數/秒。
- Recieved KB/sec - 吞吐量測量每秒接收到的 KB 數
- Sent KB/sec - 吞吐量測量每秒發送的 KB 數
時間以毫秒為單位。
| Label | # Samples | Average | Median | 90% Line | 95% Line | 99% Line | Min | Max | Error % | Throughput | Received KB/sec | Sent KB/sec |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Http Request - 1 | 200 | 303 | 259 | 489 | 673 | 986 | 147 | 1069 | 0.000% | 0.09529 | 0.02 | 0.02 |
| Http Request - 2 | 100 | 229 | 222 | 288 | 319 | 358 | 143 | 381 | 0.000% | 81.63265 | 18.46 | 18.73 |
| Http Request - 3 | 100 | 225 | 194 | 324 | 440 | 506 | 146 | 677 | 0.000% | 85.91065 | 20.42 | 19.72 |
| TOTAL | 400 | 265 | 226 | 392 | 496 | 882 | 143 | 1069 | 0.000% | 0.17941 | 0.04 | 0.04 |
術語表
中位數 是一個把樣本分為兩等份的數字。一半樣本小於中位數,另一半比中位數大。【有的樣本可能等於中位數。】這是一個標準的統計學測量。中位數和第 50 百分位是相同的。
90% Line 第 90 百分位是低於 90% 樣本的值。剩餘的樣本至少和這個值一樣長。這個一個標準的統計學測量。

