sklearn中的pipeline的創建與訪問
前期博文提到管道(pipeline)在機器學習實踐中的重要性以及必要性,本文則遞進一步,探討實際操作中管道的創建與訪問。
已經了解到,管道本質上是一定數量的估計器連接而成的數據處理流,所以成功創建管道的唯一要求就是:管道中所有估計器必須具有fit()和transform()方法,但管道中最後一個估計器只需具有fit()方法足矣;
這個約束條件的目的是保證,管道中後一個估計器能夠接受前一個估計器的transform輸出。
pipeline創建
創建管道一般有兩種途徑:
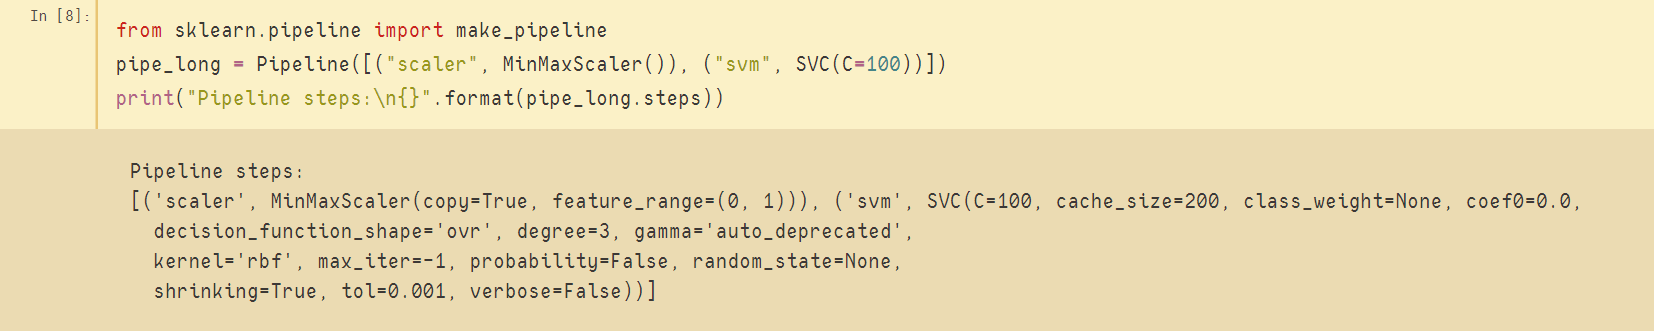
如上圖,利用Pipeline創建兩個估計器構成的管道,並且指明每個步驟的名稱;利用pipe_long.steps()方法可以得到管道的每個估計器的細節資訊。
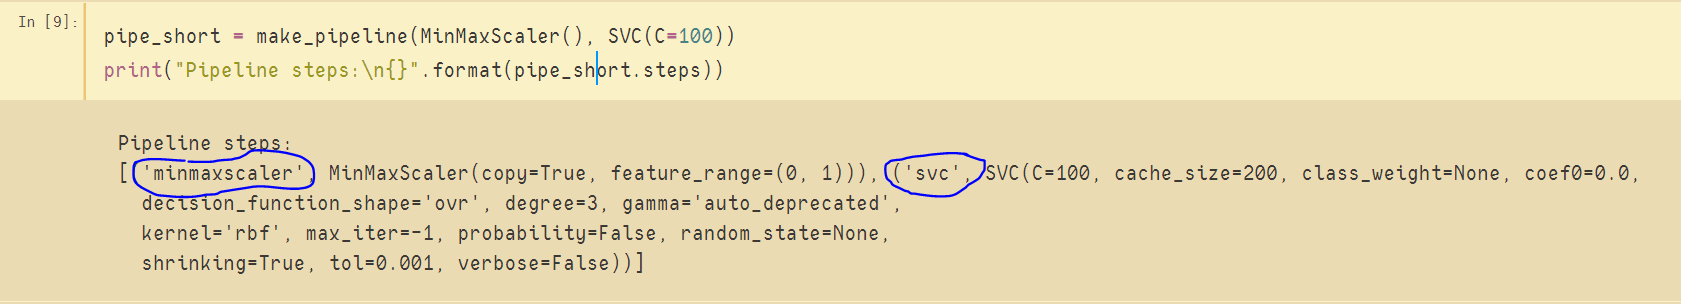
對比這兩個創建方法,可以發現不指定處理步驟名稱時,系統會自動給估計器命名(見圖中圓圈部分)。
訪問pipeline中估計器資訊
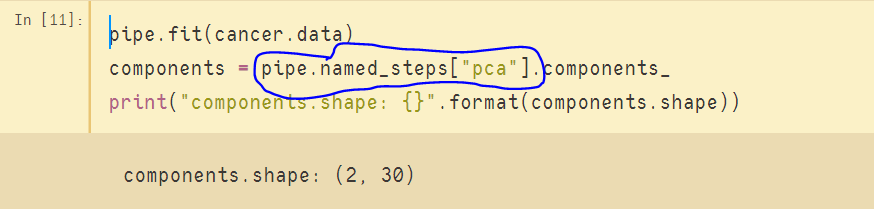
如下圖所示,圓圈部分利用管道的named_steps屬性和特定估計器的名稱指定訪問目標,而後訪問目標的components_資訊。
下面是一個較為完整的實例:
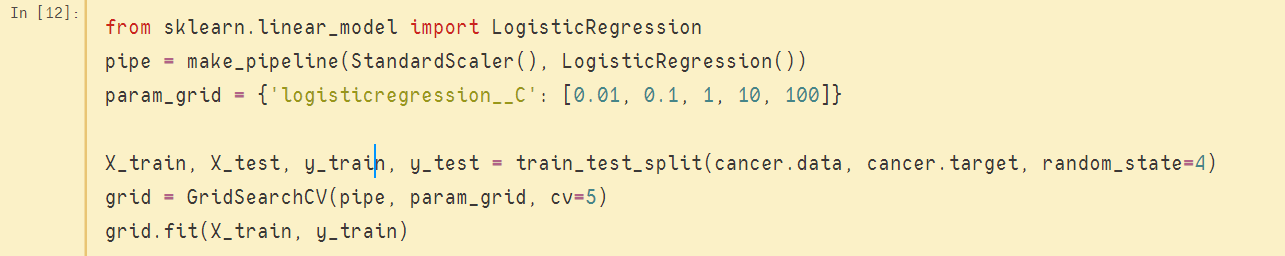
第一步,先創建由數據標準化函數和邏輯回歸分類器構成的管道,並在網格搜索的框架下進行訓練數據的擬合:
第二步:類似地,利用管道的named_steps屬性指定邏輯回歸估計器的步驟名稱,得到估計器的大體資訊和係數屬性。