搜索技術架構-押韻精靈
歡迎訪問我的押韻精靈,是一個在線查詢押韻的詩、詞、歌、字的工具網站,包含雙押多押等。
上一篇談到了如何用阿里雲搭建這樣的網站,本文記錄下該網站的整體架構,話不多說直接上圖:
搜索技術架構

數據源
數據可以直接從開源的地方下載或者自己弄個爬蟲獲取,這裡給大家推薦一個C#爬蟲和幾個java爬蟲://www.cnblogs.com/VectorZhang/p/5478711.html, //www.zhihu.com/question/31427895, 爬蟲的架構幾乎都大同小異。這裡以Abot爬蟲為例
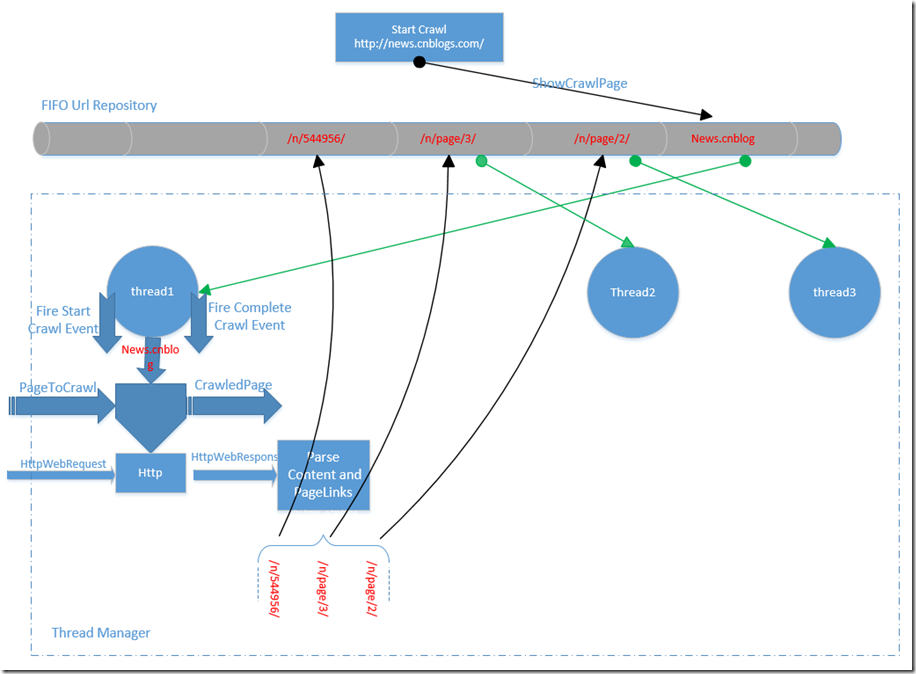
上圖中 綠色的箭頭表示執行緒從Url Repository獲取需要爬取的Url, 黑色的箭頭表示執行緒將未爬取Url放入Url Repository。
主要的模組有:
1) Url Repository 存儲所有需要爬取的Url,底層的實現採用了ConcurrentQueue,因此是執行緒安全的,也滿足了先進先出的規則。
2) Thread Manager 管理所有的爬取執行緒,執行緒個數默認是當前處理器的個數,也可以通過Config 指定。
3) Robots 處理robots.txt 的模組,Abot 直接封裝了NRobotsPatched 來解析robots.txt
4) LinkParser解析當前爬取到的page 中的鏈接,Abot 很大程度上利用了HtmlAgilityPack
5) Crawled Url Repository 存儲已經爬取的Url,Abot 內部有多個實現
6) Http download 採用了HttpWebRequest 和 HttpWebResponse
7) Memory Monitor 主要是監控記憶體使用等等,可以通過Config設置爬蟲的記憶體使用上限等
8) Event 相關,主要是在適當的時候觸發像Start Crawl 等事件
未來規劃
- 數據是一次性預處理到mysql以及一次性dump到搜索引擎,未來可以實現T+1全量dump以及通過爬蟲增量進引擎
- 干預的數據目前只有黑名單而且是召回後干預,未來需要將干預數據落到引擎
- 指標只有曝光UV和搜索UV,點擊率等指標還需要完善,列表點擊並未形成閉環
- 缺乏點擊率 和 用戶緯度的特徵,導致目前精排能力有限,成語和詞語沒有打散處理
- 用戶登錄功能缺失,未來加入微信掃描登錄功能
- 資金有限,資源有限,ES存儲的數據只保留的少數幾天,有條件了直接購買阿里雲ES服務
