Mucko: Multi-Layer Cross-Modal Knowledge Reasoning for Fact-based Visual Question Answering 論文筆記
Background
- 論文動機
- 現有的FVQA解決方案的局限性在於,它們無法精確選擇地共同嵌入各種資訊,這會引入意料之外的噪音(unexpected noises)來推斷最終答案。
- 如何從視覺,語義和知識的角度收集面向問題的資訊補充證據對於實現一般的VQA至關重要。
- 論文貢獻
- 通過包含基於視覺,語義和知識模態的多層資訊的異構圖理解影像。同時考慮了這三種模式。
- 提出了一種模態感知異構圖卷積網路,以捕獲來自不同模態的面向問題的證據。特別是,我們利用每個卷積層中的注意力運算為給定問題選擇最相關的證據,而卷積運算負責自適應特徵聚合。
- 方法的良好可解釋性,並提供了案例研究。模型通過注意力權重和門控數值的可視化,自動判斷哪種模態(視覺,語義或事實)和實體對回答問題的貢獻更大。
Model

==Visual Graph Construction== (視覺圖構建)

構建全連接的視覺圖(可能是為了儘可能找到所有的關係??)
使用Faster-RCNN識別出一組影像目標集合\mathcal{O}=\left\{o_{i}\right\}_{i=1}^{K},其中K=36,每一個目標對象都與以下向量有關:
- 視覺特徵向量的維度\boldsymbol{v}_{i} \in \mathbb{R}^{d_{v}},d_{v}=2048;
- 空間特徵向量\boldsymbol{b}_{i} \in \mathbb{R}^{d_{b}},d_{b}=4,\boldsymbol{b}_{i}=\left[x_{i}, y_{i}, w_{i}, h_{i}\right];
- 相應的標籤向量;
在\mathcal{O}上構造圖\mathcal{G}^{V}=\left(\mathcal{V}^{V}, \mathcal{E}^{V}\right),其中\mathcal{V}^{V}=\left\{v_{i}^{V}\right\}_{i=1}^{K}是節點集合(node set)
同時我們也對 edge feature(代表兩個對象之間的相對空間關係)進行編碼\boldsymbol{r}_{i j}^{V}=\left[\frac{x_{j}-x_{i}}{w_{i}}, \frac{y_{j}-y_{i}}{h_{i}}, \frac{w_{j}}{w_{i}}, \frac{h_{j}}{h_{i}}, \frac{w_{j} h_{j}}{w_{i} h_{i}}\right]
==Semantic Graph Construction==(語義圖構建)
除了視覺資訊外,自然語言(文本資訊)可以對目標對象和其之間的關係進行高級抽象(可以提供了高層的語義資訊)。這樣做的目的就是將影像中的視覺對象和question and fact 中所提到的概念聯繫起來。
在這裡我們使用dense captions生成D個影像局部(local-level)的描述,包括單個目標對象的屬性描述或者目標間的關係描述,Z=\left\{z_{i}\right\}_{i=1}^{D},每個描述z_i對應著影像中的一小部分區域。沒有用全局的image caption模型是因為可能會損失掉一些細粒度地資訊。
得到了關於影像的文本描述之後,就是如何將這些文本建成圖,這裡使用的是SPICE。SPICE是在image caption任務中用於驗證生成的caption的準確率。它會對生成的caption轉化成一個graph(下圖左邊),然後對原來的caption也轉化成graph(下圖右邊),然後計算圖的匹配程度來對生成的caption進行打分。

生成語義圖\mathcal{G}^{S}=\left(\mathcal{V}^{S}, \mathcal{E}^{S}\right),其中,v_{i}^{S} \in \mathcal{V}^{S},v_{i}^{S}從生成captions中提取到的目標對象的name或者是attribute;e_{i j}^{S} \in \mathcal{E}^{S}是v_{i}^{S},v_{j}^{S}之間的關係;我們使用averaged Glove表示。圖的表示保留了概念之間的關係資訊,並在圖域中統一表示,更好地進行跨模態的顯式推理。

==Fact Graph Construction==(事實圖構建)

為了找到合適的支撐事實,首先按照論文《Out of the box: Reasoning with graph convolution nets for factual visual question answering》中提出的基於評分的方法,從知識庫中檢索相關的候選事實。對於每一個事實<e1,r,e2>,影像的視覺概念o1,o2,...o36,我們首先計算e1,e2和o1,o2,...o36之間的餘弦相似度,其中e1,e2和o1,o2,...o36都用GloVe來表示。把所有的值求平均就得到當前事實<e1,r,e2>的分數,然後把所有的事實按照分數從高到底排序,取前100個事實,記做f_{100};
接著對f_{100}進一步的過濾。同時我們訓練了一個問題的類別分類器,輸入問題,就會預測對應事實的關係r_i,然後取前三個預測到的關係進一步過濾候選事實,得到f_{rel}。在f_{rel}的基礎上構建事實圖\mathcal{G}^{F}=\left(\mathcal{V}^{F}, \mathcal{E}^{F}\right)。其中e1,e2是圖中的節點,r是圖中的邊。節點和邊的特徵都使用GloVe詞向量來表示。這樣通過聯合考慮事實圖中的所有實體,可以有效地利用事實之間的拓撲結構。(The topological structure among facts can be effectively exploited by jointly considering all the entities in the fact graph.)
==Intra-Modal Knowledge Selection==(模態內知識選擇)

因為圖的每一層都包含與問題相關的特定於模態的知識,因此我們首先通過Visual-to-Visual Convolution, Semantic-to-Semantic Convolution和Fact-to-Fact Convolution從視覺圖,語義圖和事實圖中獨立選擇有價值的線索。我們使用使用注意力機制突出與問題最為相關的節點和邊,然後通過模態內的圖卷積對節點表示進行更新。
==These three convolutions share the common operations.==
-
Question-guided Node Attention
首先我們根據問題q(由LSTM編碼得到)對每個節點進行了attention操作。這樣每個節點就會計算得到一個權重\alpha,與問題更相關的節點,它的權重就會越高。

-
Question-guided Edge Attention
接下來根據問題對每條邊進行了attention操作。具體以每個節點v_i為中心節點,計算每個鄰居節點和它以及問題的重要程度,q』包含了中心節點和問題的特徵,v'_j包含了鄰居節點和邊的特徵。(為什麼要這麼設置呢?)


-
Intra-Modal Graph Convolution
在得到節點和邊的重要程度之後進行模態內的圖卷積操作,先對鄰居節點進行求和,然後再和本身的特徵進行融合,根據節點和邊的重要程度進行了加強。

將上述的模態內知識選擇過程分別作用在三個圖上,得到更新後的節點表示,分別記為:


==Cross-Modal Knowledge Reasoning==(跨模態知識推理)
為了正確回答問題,需要充分考慮來自視覺,語義和事實資訊之間的互補資訊。由於答案來自事實圖中的一個實體(為什麼呢?),因此我們通過跨模態卷heih積(包括visual-to-fact convolution和semantic- to-fact convolution)從視覺圖和語義圖到事實圖收集互補資訊。最後,對互補資訊進行融合,應用圖卷積操作形成全局決策。
-
Visual-to-Fact Convolution
對於事實圖中的每個節點v_{j}^F,計算視覺圖中每個節點v_{j}^V和它的相似度分數,越互補的節點它的相似度分數就越高,然後根據分數對視覺圖加權求和得到視覺的互補資訊。
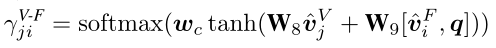

-
Semantic-to-Fact Convolution
同理可以得到語義的互補資訊。再得到語義的互補資訊和視覺的互補資訊後,使用Gate方式對視覺語義的互補資訊和實體特徵進行融合。


-
Fact-to-Fact Aggregation
給定事實圖中的一組候選實體,我們旨在全局比較所有實體並選擇一個最佳實體作為答案。現在,事實圖中每個實體從三種模態中收集了問題導向以及相互互補的資訊。為了聯合評估每個實體的可能性,我們進行類似於3.2節中介紹的基於注意力的圖卷積網路,用來匯總事實圖中的資訊並獲得更新後的實體表示。
我們迭代地進行模態內的知識選擇和模態間的知識推理過程,經過T步,獲得了最終的實體表示。


Learning(==待討論==)
每個實體只有兩種結果,是或不是答案。因此我們將事實圖中每個實體的表示和問題的嵌入拼接,然後輸入到一個二分類中,輸出概率最高的實體當做預測的答案。


Experiments
-
數據集
FVQA
-
實驗結果和消融

-
可視化推理過程
節點中的值對應模態內知識選擇的α,邊上的值對應β,虛線上的值對應跨模態卷積的γ,熱力條是通過最後融合時的gate值得到的。


