Nginx架構賞析
淘寶的某位大佬曾經做過測試,在一台24G記憶體的機器上,Nginx的最大並發連接數達到了200萬。同學們聽到這個結論後,是不是被Nginx的超高性能深深折服了,它內部的架構設計究竟是怎麼樣的呢?這篇文章就帶同學們來認識一下Nginx的架構設計吧。
本文主要參考了淘寶技術團隊寫的Nginx文章,將會從以下個方面去進行分享:
- Nginx進程模型
- Nginx事件模型
Nginx進程模型
Nginx默認以多進程的方式啟動運行,當然Nginx也是支援多執行緒的方式的,只是我們主流的方式還是多進程的方式,也是Nginx的默認方式。Nginx採用多進程的方式有很多的好處,這一點與我們大部分同學們的認知發生衝突了。大部分同學會說進程比執行緒重,進程更耗費資源等等,總之可以說出一大堆執行緒優於進程的證明。如果有同學恰恰是這樣想的,那就得擴充下認知啦。比如我們大名鼎鼎的Redis,Oracle裡邊都是有多進程概念的 ,而這些軟體無一例外都具有超高性能。所以,我們今天就主要來學習下Nginx的多進程模式。
Nginx的進程模型長個什麼樣子,廢話不多說,直接上圖。
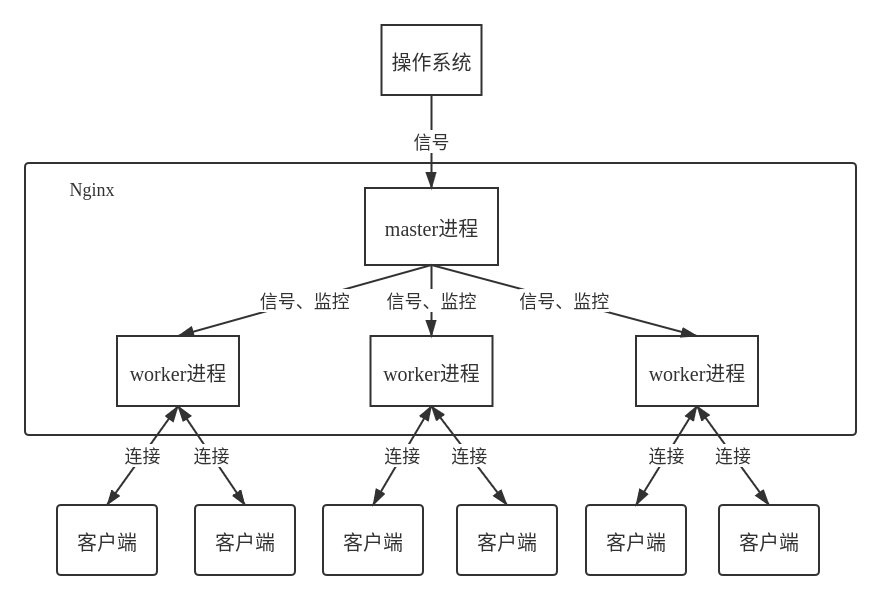
Nginx在啟動後,會有一個master進程和多個worker進程。master進程主要用來管理worker進程,包含:接收來自作業系統的訊號,向各worker進程發送訊號,監控worker進程的運行狀態,當worker進程退出後(異常情況下),會自動重新啟動新的worker進程。而基本的網路事件,則是放在worker進程中來處理了。多個worker進程之間是對等的,他們同等競爭來自客戶端的請求,各進程互相之間是獨立的。一個請求,只可能在一個worker進程中處理,一個worker進程,不可能處理其它worker進程的請求。worker進程的個數是可以設置的,一般設置與機器cpu核數一致,這裡面的原因與Nginx的進程模型以及事件處理模型是分不開的。
Nginx的多進程模型給它帶來了一大優點: 優雅重啟,服務不間斷。具體它是怎麼做到呢?從上面我們已經得知,master管理worker進程,所以我們只需要與master進程通訊就行了。master進程會接收來自作業系統發來的訊號,再根據訊號做不同的事情。所以我們要控制Nginx,只需要通過作業系統提供的kill命令向master進程發送訊號就行了。比如使用kill -HUP pid重啟Nginx,master進程在接收到HUP訊號後是怎麼做的呢?首先master進程在接到訊號後,會先重新載入配置文件,然後再啟動新的worker進程,並向所有老的worker進程發送訊號,告訴他們可以光榮退休了。新的worker在啟動後,就開始接收新的請求,而老的worker在收到來自master的訊號後,就不再接收新的請求,並且在當前進程中的所有未處理完的請求處理完成後,再退出。
我們知道了在操作Nginx的時候,Nginx內部做了些什麼事情,那麼,worker進程又是如何客戶端處理請求的呢?我們前面有提到,worker進程之間是平等的,每個進程,處理請求的機會也是一樣的。當我們提供80埠的http服務時,一個連接請求過來,每個進程都有可能處理這個連接,怎麼做到的呢?首先,每個worker進程都是從master進程fork過來,在master進程裡面,先創建好ServerSocket,開啟監聽,然後再fork出多個worker進程。所有worker進程都將和master進程持有同一份socket句柄,並且句柄會在新連接到來時變得可讀,為保證只有一個進程處理該連接,所有worker進程在註冊句柄讀事件前搶accept_mutex,搶到互斥鎖的那個進程註冊句柄讀事件,在讀事件里調用accept接受該連接。當一個worker進程在accept這個連接之後,就生成了一個新的socket,通過這個socket開始讀取請求,解析請求,處理請求,產生數據後,再返回給客戶端,最後才斷開連接,一個完整的請求就是這樣玩完了。我們可以看到,一個請求,完全由worker進程來處理,而且只在一個worker進程中處理。
那麼,Nginx採用這種進程模型有什麼好處呢?實在是太多了,重點說上幾條。首先,對於每個worker進程來說,獨立的進程,不需要加鎖,所以省掉了鎖帶來的開銷,同時在編程以及問題查找時,也會方便很多。其次,採用獨立的進程,可以讓互相之間不會影響,一個進程退出後,其它進程還在工作,服務不會中斷,master進程則很快啟動新的worker進程。當然,worker進程的異常退出,肯定是程式有bug了,異常退出,會導致當前worker上的所有請求失敗,不過不會影響到所有請求,所以降低了風險。當然,好處還有很多,同學們可以慢慢體會。
Nginx事件模型
Nginx採用了NIO的方式來處理請求,這是Nginx可以同時處理成千上萬個請求的根本原因。想想低版本Tomcat的IO模型(高版本已支援NIO),每個請求會獨佔一個工作執行緒,當並發數上到幾千時,就同時有幾千的執行緒在處理請求了。這對作業系統來說,是個不小的挑戰,執行緒帶來的記憶體佔用非常大,執行緒的上下文切換帶來的cpu開銷很大,自然性能就上不去了,而這些開銷完全是沒有意義的。
Nginx為什麼要使用NIO呢?NIO到底是怎麼回事呢?IO的本質就是讀寫事件,而當讀寫事件沒有準備好時,必然不可操作,如果不用非阻塞的方式來調用,那就得阻塞調用了,事件沒有準備好,那就只能等了,等事件準備好了,工作執行緒再繼續吧。阻塞調用會進入內核等待,cpu就會讓出去給別人用了,工作執行緒只能傻傻的睡覺等待,對單執行緒的worker來說,顯然不合適,當網路事件越多時,大家都在等待呢,cpu空閑下來沒人用,cpu利用率自然上不去了,更別談高並發了。所以,為了高性能,必須使用NIO。關於NIO,我們這裡就是一筆帶過,想詳細學習的同學可以去看我的NIO源碼分析文章。
接下來,我們使用一段偽程式碼來總結一下Nginx的事件處理模型吧。
Date now;	// 表示當前時間
while (true) {
    // 處理任務隊列里的所有任務
    for task in tasks:
        task.handler();

    flushTime(now);	// 刷新當前時間
    timeout = initValue; // 超時時間

    // waitTasks可以理解為註冊到epoll里的所有有效任務
    for task in waitTasks:
    	// 列表裡的第一個task的超時時間是最短的,如果它已經超時了,就調用超時處理函數
        if (task.time <= now) {
            task.timeoutHandler();
        } else {
            // 更新超時時間
            timeout = t.time - now;
            break;
        }

    // 通過epoll拿到已經就緒的事件
    nevents = epoll(events, timeout);
    // 挨個遍歷處理事件
    for i in nevents:
        Task task;
    	// 讀事件
        if (events[i].type == READ) {
            task.handler = readHandler;
        } else { // 寫事件
            task.handler = writeHandler;
        }
    	// 防到一個專門的執行隊列里
        tasks(task);
}
好的,文章到這裡就結束啦。希望Nginx的進程模型和事件模型的設計思想,能對朋友們以後的系統設計有所幫助。最後,喜歡我的文章的同學們,歡迎關注我的公眾號「小瑾守護執行緒」,不錯過任何有價值的乾貨。