Linux設備上沒有空間之復盤
某天前端在調介面的時候,發現登錄頁面得驗證碼介面居然沒有響應數據,顯示的是500響應碼。於是我一路排查,首先排查驗證碼介面所屬的微服務是否正常,通過lsof -i:服務埠進行排查,發現該微服務進程存在,同時我在服務註冊中心的服務管理列表也發現該服務正常註冊。結合之前遇到的問題,驗證碼介面報500,沒有及時響應數據,與Redis有關,驗證碼的數據會存放Redis,我再次排查Redis,發現Redis也正常,最後我看錯誤日誌。我排查該問題的步驟:
- 第一排查提供驗證碼的微服務是否正常;
- 第二排查服務註冊中心是否有該服務;
- 第三排查Redis是否正常運行;
- 最後查看日誌。
最後我從錯誤日誌中看到了設備上沒有空間這樣的錯誤資訊。當時我還沒有意識到,可能是Linux磁碟空間不足的原因,下意識使用程式設計師的萬能絕招」重啟」,但」重啟」並沒有從根本上解決這個問題,這裡提到的」重啟」是指重啟Java應用而不是重啟Linux伺服器。最後發現重啟也不能解決這個問題,於是我又下意識的覺得是記憶體的原因,於是便直接關閉其它無需和前端對介面的微服務,突然發現問題一下解決了。於是就沒有深究了。
而後過了一個小時左右,前端又再次回饋其它介面有問題了,不能及時響應正確的數據,全部報500,這時我開始慌了,隱隱約約覺得問題並未從根本上解決,根本不是記憶體的原因,這時我才想起用free -m命令查看一下記憶體的使用,發現還有2個多G的記憶體,排除了記憶體不足的原因,通常運行Java應用,記憶體不足會報如下異常:
Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x0000000794500000, 576716800, 0) failed; error='Cannot allocate memory' (errno=12)
這時我冷靜下來,看日誌資訊,再次發現了這句話」設備上沒有空間」。於是通過關鍵字搜索,找到了問題所在,如圖所示:

結合Windows,形象地概括,就是我的系統盤C盤滿了。
二、當時我很疑惑為什麼/dev/mapper/centos-root一下就滿了呢?
我仔細想了下,發現我將很多軟體和服務以及日誌全部放在/usr下的某個目錄里,於是我一路排查後,發現有這麼幾類文件佔用很大的空間:
- 日誌文件(Nacos日誌以及各項微服務日誌、MySQL日誌、系統日誌等足足10G以上,這時我終於明白了,為什麼日誌要實時備份傳輸以及刪除了);
- 遺留的軟體包和壓縮包(10G以上);
- 靜態文件(離線地圖,足足佔了20G以上)和其它圖片文件;
- 項目源程式碼以及打包成功後的jar(3個多G);
- Maven倉庫(足足佔了5個多G)。
三、問題已經定位到了,那麼我是如何解決這個問題的?
問題的根源在於不合理的佔用系統盤空間,將這些不合理的從系統盤空間轉移出去即可,轉移到磁碟空間充足的,也就是/dev/mapper/centos-home下。
我做了這些事情:
- 備份日誌,下載到本地(目前備份伺服器還沒有申請下來,同時關於哪些需要保留的,需要內部協商探討),原有的日誌進行刪除(這個工作可以腳本化);
- 遺留軟體包和壓縮包直接刪除;
- 靜態文件遷移至/home下的某個用戶目錄,通過配置進行映射(確保遷移後仍不影響正常的訪問);
- 項目源程式碼遷移到/home下的某個用戶目錄;
- 修改Maven配置文件,倉庫地址指向/home下的某個用戶目錄。
最終解決了這個問題,釋放了50%的空間,其中還有15%暫時不能動。
這樣一來,/dev/mapper/centos-root這個系統盤得到了充分釋放,同時/dev/mapper/centos-home也得到了充分利用(不再資源閑置)。
四、問題列表和具體解決措施
1.如何通過Linux命令知道當前磁碟空間使用情況?
命令格式如下:
du -sh 文件路徑
du -sh *
執行就能看到當前文件以及文件夾所佔用記憶體。佔用記憶體多的,可進一步查看到底是什麼原因佔用這麼多記憶體的。
下面就是我通過du -sh *命令查看記憶體佔用最多的文件或文件夾:
- Nacos;
- MySQL;
- Nginx;
- Project。
2.為什麼Nacos會佔用這麼多記憶體呢?它僅僅是一個服務註冊中心並不對外提供服務。
通過du -sh 命令,我排查到原來是nacos下的bin目錄佔用記憶體最多,其它很少,於是我進一步查看,發現bin目錄下的log目錄佔用記憶體最多,因為該log目錄下主要是nacos的訪問日誌,最後我通過du -sh 命令查看,如圖所示:
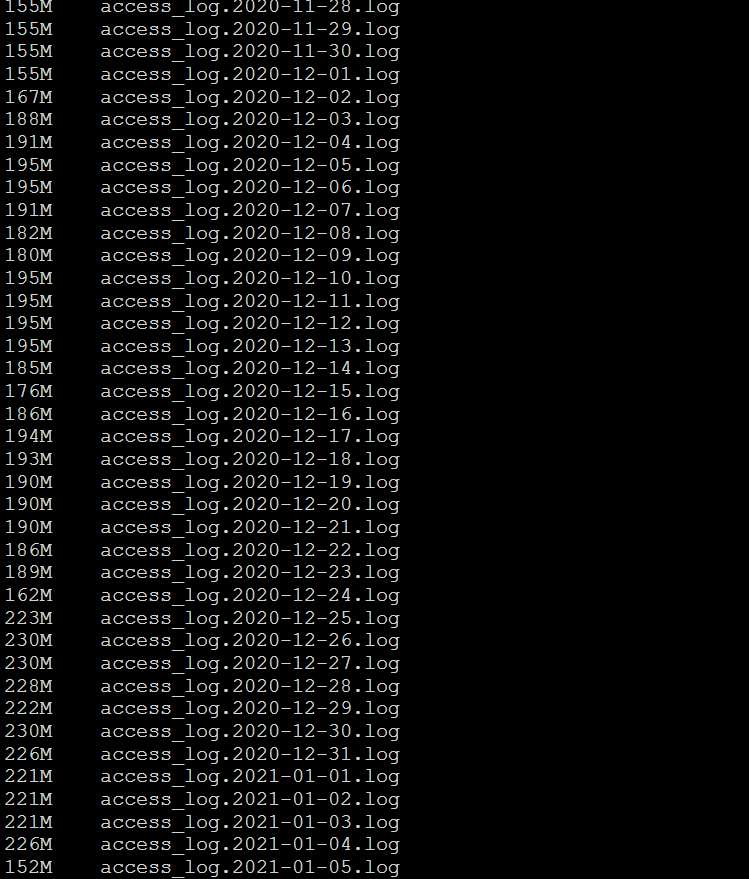
由圖可知,平均一個日誌文件就是一百多M,足足佔了十幾個G也就不足為奇了。
我的解決辦法很簡單,分為兩個方面:
第一方面是定時刪除僅保留一個和備份遷移到/home下的某個目錄;
第二個方面通過修改nacos的配置解決,具體參考如下鏈接:
Nacos系列(4)-Nacos各種日誌太多問題的終極解決辦法
3.為什麼MySQL會佔用這麼多磁碟空間?
通過命令排查(即du -sh *),我發現是MySQL下的data目錄佔用磁碟空間最大,其中有一個足足佔了4個多G,針對這樣的問題,我將其直接由/usr/software目錄下遷移到/home下,這樣一來系統盤的空間再度得到釋放,遷移後需要改mysql的配置文件(即my.cnf文件)。
4.Nginx為何佔用這麼多磁碟空間?
之所以佔用這麼多,前面我提到過是因為離線地圖,離線地圖包括街道地圖和衛星地圖,兩個加在一起足足二十多G,為此我將其遷移到/home下的某個目錄,然後修改Nginx的核心配置nginx.conf文件進行映射,這樣一來系統盤的空間再次得到釋放,同時用戶盤的空間得到了充分利用。
5.關於Project
Project主要放源程式碼和打包成功產生的jar,我還是用老辦法將其遷移(遷移到/home下的某個目錄)。
五、問題的根本原因是什麼?為什麼我需要排查這麼長時間才定位到這個原因呢?
問題的根本原因在於不規範性。正常來說,不應該將用戶磁碟空間做的事情放在系統磁碟空間(與Windows同理)。從這一刻起,我也深深意識到規範性的重要,不規範性導致的bug何止千千萬萬,仔細想來我的開發經歷,造成bug的絕大多數原因均是因為不規範,因為不規範,暴露出各種奇奇怪怪的bug。
另外從我排查問題來看也是很有問題的,問題在於沒有用正確的態度對待日誌,其實一開始仔細排查日誌,定位到這個關鍵資訊,然後將這樣的關鍵資訊複製搜索引擎來尋找解決辦法,這樣一來就不必浪費了近一個多小時來搗鼓這樣的事情。
六、如何避免這樣的問題再現?以及通過這樣的問題總結出什麼樣的原則?
首先這樣的問題屬於運維範疇,而我作為公司的兼職運維,面對這樣的問題,首先從規範入手,制定可行的規範,從根本上杜絕這樣的問題再現,對於這樣的問題,我總結的原則如下:
- (1)不同的用戶做不同的事情,保持Linux用戶的功能專一性(後面會提到一個重大bug,是因為違反這樣的原則導致的);
- (2)遇到問題,分為兩個方面來解決,見過和沒有見過,見過表示過去我遇到過這樣的問題,可以借鑒以往經驗來快速解決這個問題;沒有見過的問題,嚴格遵守的流程:復現問題->仔細查看日誌->定位問題->解決問題->總結並存入知識庫(如有必要進行定期復盤)。總而言之,最關鍵的在於定位問題(如何定位問題,可通過重複復現問題->仔細查看日誌這樣的步驟來定位;
- (3)針對常見運維需求,編寫腳本(如監控系統磁碟使用情況以及用戶磁碟使用情況,超出閾值,自動告警和人工干預),推進腳本自動化;
- (4)制定適合當下情況的運維規範(如安裝軟體安在哪個目錄、大文件放在哪個目錄、日誌存放多久並備份後自動清除、每個用戶只做自己的事情等,根據實際情況不斷增加和修訂,定期寫入文檔進行維護)。

