漫談 HTTP 連接
通過前面的 HTTP 系列文章(文章末尾有鏈接),想必大家已經知道 HTTP 協議的基本知識,了解它的報文結構,請求頭、響應頭等細節。
HTTP 的特點
所以接下來先是聊聊 HTTP 協議的特點、優點和缺點。既要看到它好的一面,也要正視它不好的一面,只有全方位、多角度了解 HTTP,才能實現「揚長避短」,更好地利用 HTTP。
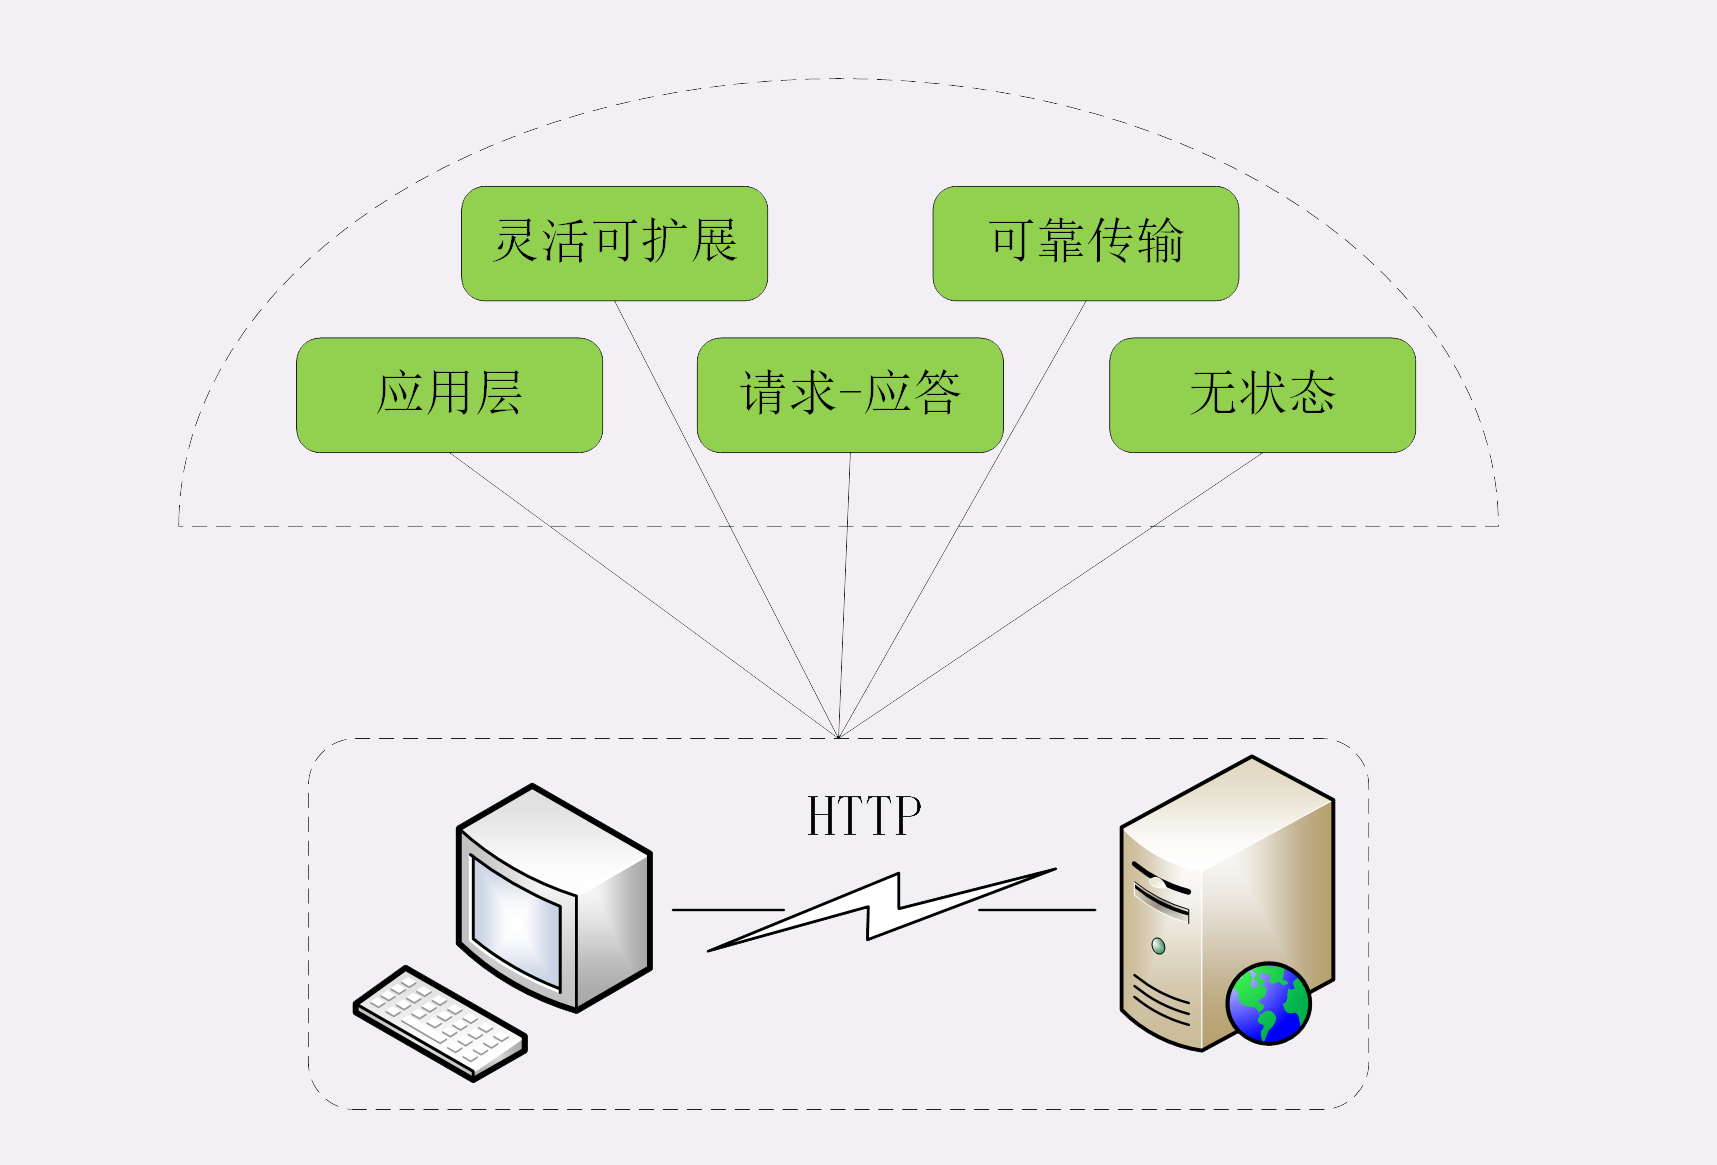
靈活可擴展
首先, HTTP 協議是一個「靈活可擴展」的傳輸協議。
HTTP 協議最初誕生的時候就比較簡單,本著開放的精神只規定了報文的基本格式,比如用空格分隔單詞,用換行分隔欄位,「header+body」等,報文里的各個組成部分都沒有做嚴格的語法語義限制,可以由開發者任意訂製。
所以,HTTP 協議就隨著互聯網的發展一同成長起來了。在這個過程中,HTTP 協議逐漸增加了請求方法、版本號、狀態碼、頭欄位等特性。而 body 也不再限於文本形式的 TXT 或 HTML,而是能夠傳輸圖片、音頻影片等任意數據,這些都是源於它的「靈活可擴展」的特點。
而那些 RFC 文檔,實際上也可以理解為是對已有擴展的「承認和標準化」,實現了「從實踐中來,到實踐中去」的良性循環。
也正是因為這個特點,HTTP 才能在三十年的歷史長河中「屹立不倒」,從最初的低速實驗網路發展到現在的遍布全球的高速互聯網,始終保持著旺盛的生命力。
可靠傳輸
第二個特點, HTTP 協議是一個「可靠」的傳輸協議。
這個特點顯而易見,因為 HTTP 協議是基於 TCP/IP 的,而 TCP 本身是一個「可靠」的傳輸協議,所以 HTTP 自然也就繼承了這個特性,能夠在請求方和應答方之間「可靠」地傳輸數據。
它的具體做法與 TCP/UDP 差不多,都是對實際傳輸的數據(entity)做了一層包裝,加上一個頭,然後調用 Socket API,通過 TCP/IP 協議棧發送或者接收。
不過我們必須正確地理解「可靠」的含義,HTTP 並不能 100% 保證數據一定能夠發送到另一端,在網路繁忙、連接品質差等惡劣的環境下,也有可能收發失敗。「可靠」只是向使用者提供了一個「承諾」,會在下層用多種手段「盡量」保證數據的完整送達。
當然,如果遇到光纖被意外挖斷這樣的極端情況,即使是神仙也不能發送成功。所以,「可靠」傳輸是指在網路基本正常的情況下數據收發必定成功,借用運維里的術語,大概就是「3 個 9」或者「4 個 9」的程度吧。
應用層協議
第三個特點,HTTP 協議是一個應用層的協議。
這個特點也是不言自明的,但卻很重要。
在 TCP/IP 誕生後的幾十年里,雖然出現了許多的應用層協議,但它們都僅關注很小的應用領域,局限在很少的應用場景。例如 FTP 只能傳輸文件、SMTP 只能發送郵件、SSH 只能遠程登錄等,在通用的數據傳輸方面「完全不能打」。
所以 HTTP 憑藉著可攜帶任意頭欄位和實體數據的報文結構,以及連接控制、快取代理等方便易用的特性,一出現就「技壓群雄」,迅速成為了應用層里的「明星」協議。只要不太苛求性能,HTTP 幾乎可以傳遞一切東西,滿足各種需求,稱得上是一個「萬能」的協議。
套用一個網上流行的段子,HTTP 完全可以用開玩笑的口吻說:「不要誤會,我不是針對 FTP,我是說在座的應用層各位,都是垃圾。」
請求 - 應答
第四個特點,HTTP 協議使用的是請求 - 應答通訊模式。
這個請求 - 應答模式是 HTTP 協議最根本的通訊模型,通俗來講就是「一發一收」「有來有去」,就像是寫程式碼時的函數調用,只要填好請求頭裡的欄位,「調用」後就會收到答覆。
請求 - 應答模式也明確了 HTTP 協議里通訊雙方的定位,永遠是請求方先發起連接和請求,是主動的,而應答方只有在收到請求後才能答覆,是被動的,如果沒有請求時不會有任何動作。
當然,請求方和應答方的角色也不是絕對的,在瀏覽器 - 伺服器的場景里,通常伺服器都是應答方,但如果將它用作代理連接後端伺服器,那麼它就可能同時扮演請求方和應答方的角色。
HTTP 的請求 - 應答模式也恰好契合了傳統的 C/S(Client/Server)系統架構,請求方作為客戶端、應答方作為伺服器。所以,隨著互聯網的發展就出現了 B/S(Browser/Server)架構,用輕量級的瀏覽器代替笨重的客戶端應用,實現零維護的「瘦」客戶端,而伺服器則擯棄私有通訊協議轉而使用 HTTP 協議。
此外,請求 - 應答模式也完全符合 RPC(Remote Procedure Call)的工作模式,可以把 HTTP 請求處理封裝成遠程函數調用,導致了 WebService、RESTful 和 gPRC 等的出現。
無狀態
第五個特點,HTTP 協議是無狀態的。
這個所謂的「狀態」應該怎麼理解呢?
「狀態」其實就是客戶端或者伺服器里保存的一些數據或者標誌,記錄了通訊過程中的一些變化資訊。
你一定知道,TCP 協議是有狀態的,一開始處於 CLOSED 狀態,連接成功後是 ESTABLISHED 狀態,斷開連接後是 FIN-WAIT 狀態,最後又是 CLOSED 狀態。
這些「狀態」就需要 TCP 在內部用一些數據結構去維護,可以簡單地想像成是個標誌量,標記當前所處的狀態,例如 0 是 CLOSED,2 是 ESTABLISHED 等等。
再來看 HTTP,那麼對比一下 TCP 就看出來了,在整個協議里沒有規定任何的「狀態」,客戶端和伺服器永遠是處在一種「無知」的狀態。建立連接前兩者互不知情,每次收發的報文也都是互相獨立的,沒有任何的聯繫。收發報文也不會對客戶端或伺服器產生任何影響,連接後也不會要求保存任何資訊。
「無狀態」形象地來說就是「沒有記憶能力」。比如,瀏覽器發了一個請求,說「我是小明,請給我 A 文件。」,伺服器收到報文後就會檢查一下許可權,看小明確實可以訪問 A 文件,於是把文件發回給瀏覽器。接著瀏覽器還想要 B 文件,但伺服器不會記錄剛才的請求狀態,不知道第二個請求和第一個請求是同一個瀏覽器發來的,所以瀏覽器必須還得重複一次自己的身份才行:「我是剛才的小明,請再給我 B 文件。」
我們可以再對比一下 UDP 協議,不過它是無連接也無狀態的,順序發包亂序收包,數據包發出去後就不管了,收到後也不會順序整理。而 HTTP 是有連接無狀態,順序發包順序收包,按照收發的順序管理報文。
但不要忘了 HTTP 是「靈活可擴展」的,雖然標準里沒有規定「狀態」,但完全能夠在協議的框架里給它「打個修補程式」,增加這個特性。
其他特點
除了以上的五大特點,其實 HTTP 協議還可以列出非常多的特點,例如傳輸的實體數據可快取可壓縮、可分段獲取數據、支援身份認證、支援國際化語言等。但這些並不能算是 HTTP 的基本特點,因為這都是由第一個「靈活可擴展」的特點所衍生出來的。
小結
-
HTTP 是靈活可擴展的,可以任意添加頭欄位實現任意功能;
-
HTTP 是可靠傳輸協議,基於 TCP/IP 協議「盡量」保證數據的送達;
-
HTTP 是應用層協議,比 FTP、SSH 等更通用功能更多,能夠傳輸任意數據;
-
HTTP 使用了請求 - 應答模式,客戶端主動發起請求,伺服器被動回復請求;
-
HTTP 本質上是無狀態的,每個請求都是互相獨立、毫無關聯的,協議不要求客戶端或伺服器記錄請求相關的資訊。
HTTP的連接管理
HTTP 的連接管理也算得上是個「老生常談」的話題了,你一定曾經聽說過「短連接」「長連接」之類的名詞,今天讓我們一起來把它們弄清楚。
短連接
HTTP 協議最初(0.9/1.0)是個非常簡單的協議,通訊過程也採用了簡單的「請求 - 應答」方式。
它底層的數據傳輸基於 TCP/IP,每次發送請求前需要先與伺服器建立連接,收到響應報文後會立即關閉連接。
因為客戶端與伺服器的整個連接過程很短暫,不會與伺服器保持長時間的連接狀態,所以就被稱為「短連接」(short-lived connections)。早期的 HTTP 協議也被稱為是「無連接」的協議。
短連接的缺點相當嚴重,因為在 TCP 協議里,建立連接和關閉連接都是非常「昂貴」的操作。TCP 建立連接要有「三次握手」,發送 3 個數據包,需要 1 個 RTT;關閉連接是「四次揮手」,4 個數據包需要 2 個 RTT。
而 HTTP 的一次簡單「請求 - 響應」通常只需要 4 個包,如果不算伺服器內部的處理時間,最多是 2 個 RTT。這麼算下來,浪費的時間就是「3÷5=60%」,有三分之二的時間被浪費掉了,傳輸效率低得驚人。
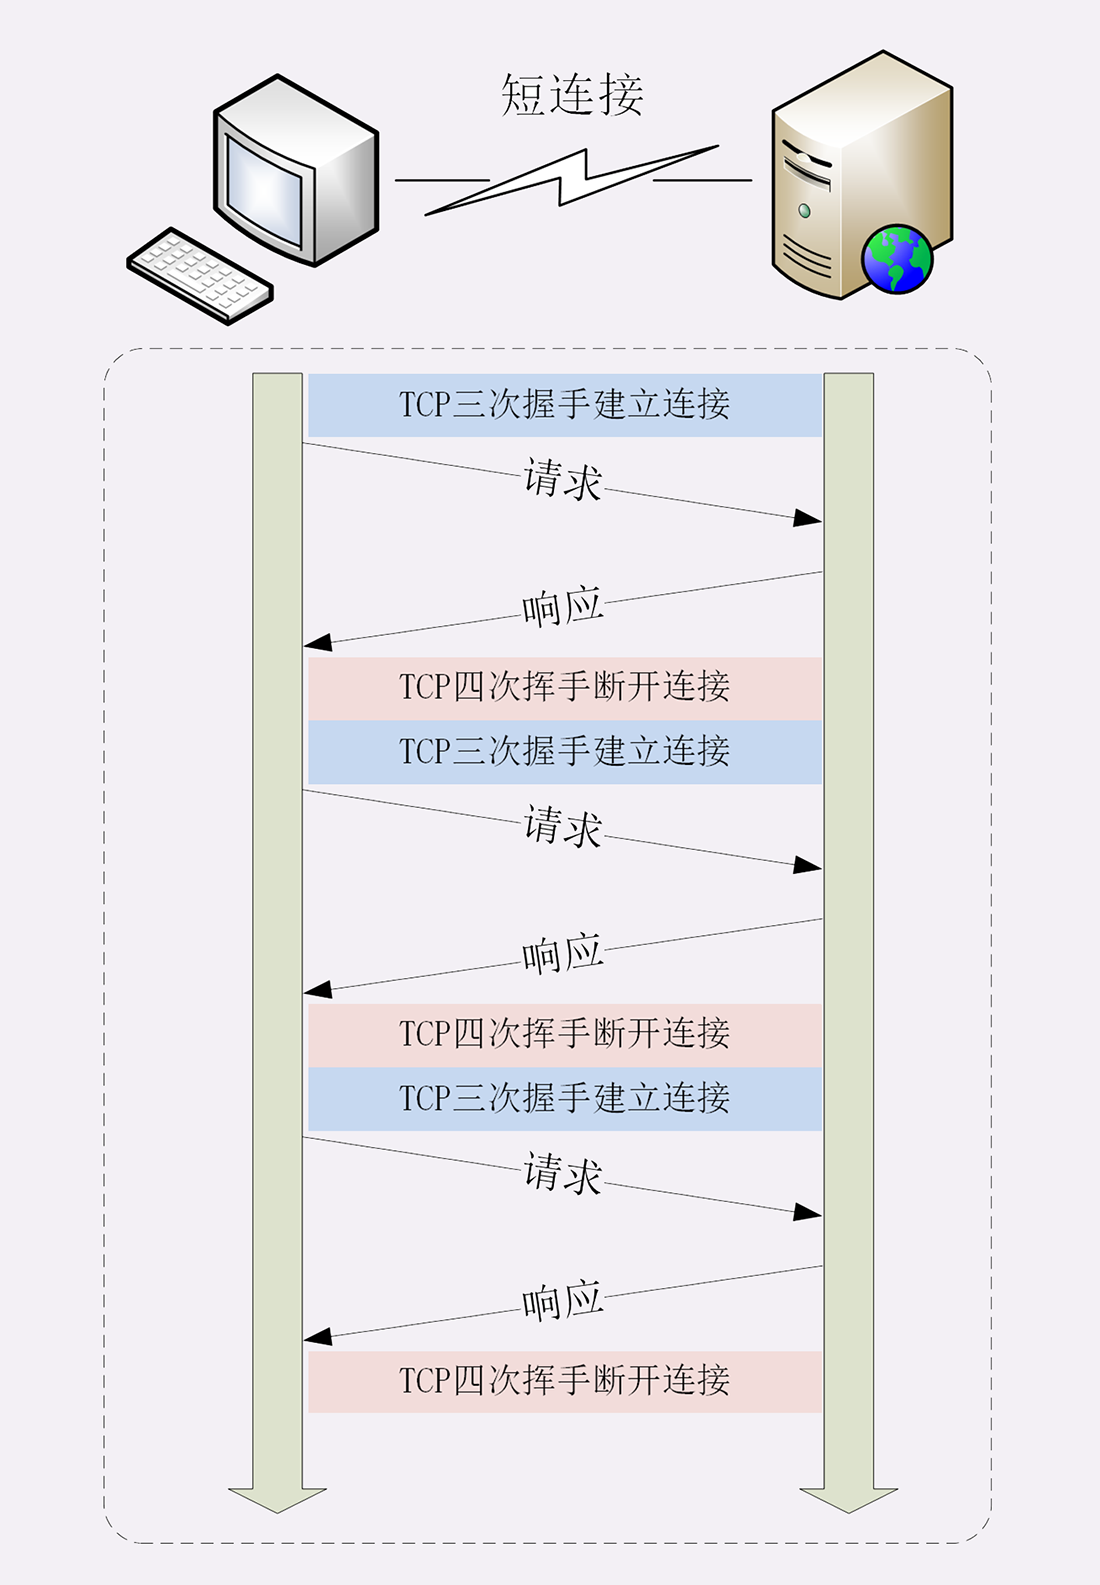
單純地從理論上講,TCP 協議你可能還不太好理解,我就拿打卡考勤機來做個形象的比喻吧。
假設你的公司買了一台打卡機,放在前台,因為這台機器比較貴,所以專門做了一個保護罩蓋著它,公司要求每次上下班打卡時都要先打開蓋子,打卡後再蓋上蓋子。
可是偏偏這個蓋子非常牢固,打開關閉要費很大力氣,打卡可能只要 1 秒鐘,而開關蓋子卻需要四五秒鐘,大部分時間都浪費在了毫無意義的開關蓋子操作上了。
可想而知,平常還好說,一到上下班的點在打卡機前就會排起長隊,每個人都要重複「開蓋 - 打卡 - 關蓋」的三個步驟,你說著急不著急。
在這個比喻里,打卡機就相當於伺服器,蓋子的開關就是 TCP 的連接與關閉,而每個打卡的人就是 HTTP 請求,很顯然,短連接的缺點嚴重製約了伺服器的服務能力,導致它無法處理更多的請求。
長連接
針對短連接暴露出的缺點,HTTP 協議就提出了「長連接」的通訊方式,也叫「持久連接」(persistent connections)、「連接保活」(keep alive)、「連接復用」(connection reuse)。
其實解決辦法也很簡單,用的就是「成本均攤」的思路,既然 TCP 的連接和關閉非常耗時間,那麼就把這個時間成本由原來的一個「請求 - 應答」均攤到多個「請求 - 應答」上。
這樣雖然不能改善 TCP 的連接效率,但基於「分母效應」,每個「請求 - 應答」的無效時間就會降低不少,整體傳輸效率也就提高了。
這裡我畫了一個短連接與長連接的對比示意圖。
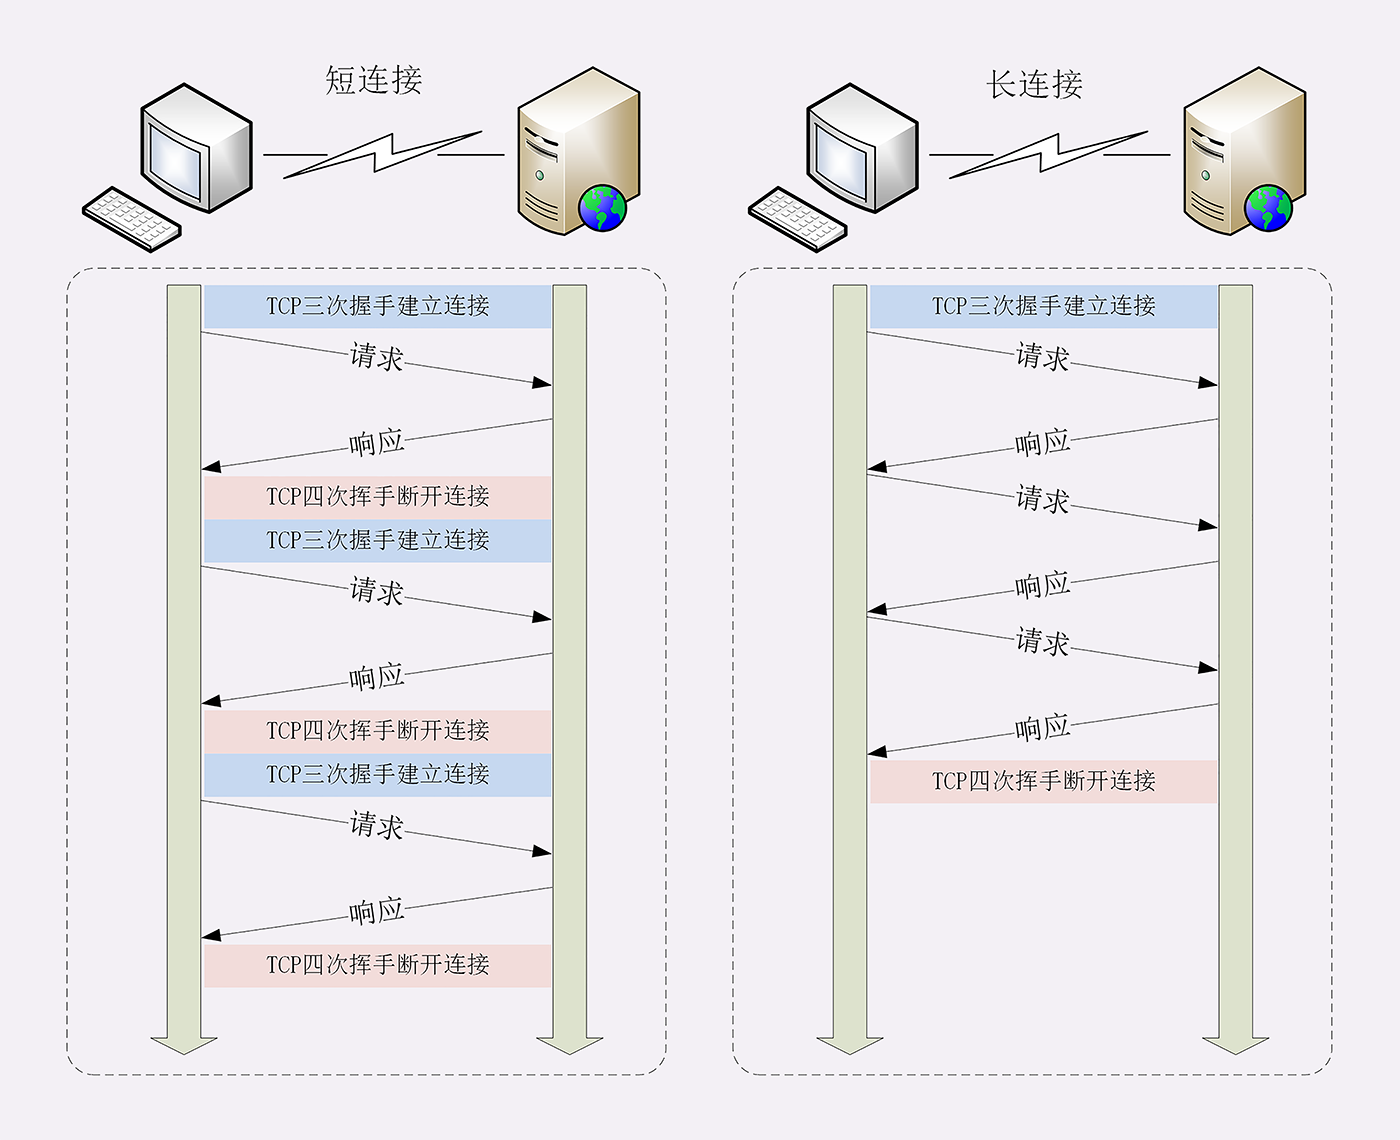
在短連接里發送了三次 HTTP「請求 - 應答」,每次都會浪費 60% 的 RTT 時間。而在長連接的情況下,同樣發送三次請求,因為只在第一次時建立連接,在最後一次時關閉連接,所以浪費率就是「3÷9≈33%」,降低了差不多一半的時間損耗。顯然,如果在這個長連接上發送的請求越多,分母就越大,利用率也就越高。
繼續用剛才的打卡機的比喻,公司也覺得這種反覆「開蓋 - 打卡 - 關蓋」的操作太「反人類」了,於是頒布了新規定,早上打開蓋子後就不用關上了,可以自由打卡,到下班後再關上蓋子。
這樣打卡的效率(即服務能力)就大幅度提升了,原來一次打卡需要五六秒鐘,現在只要一秒就可以了,上下班時排長隊的景象一去不返,大家都開心。
連接相關的頭欄位
由於長連接對性能的改善效果非常顯著,所以在 HTTP/1.1 中的連接都會默認啟用長連接。不需要用什麼特殊的頭欄位指定,只要向伺服器發送了第一次請求,後續的請求都會重複利用第一次打開的 TCP 連接,也就是長連接,在這個連接上收發數據。
當然,我們也可以在請求頭裡明確地要求使用長連接機制,使用的欄位是 Connection,值是 「keep-alive」。
不過不管客戶端是否顯式要求長連接,如果伺服器支援長連接,它總會在響應報文里放一個 「Connection: keep-alive」 欄位,告訴客戶端:「我是支援長連接的,接下來就用這個 TCP 一直收發數據吧」。
不過長連接也有一些小缺點,問題就出在它的「長」字上。
因為 TCP 連接長時間不關閉,伺服器必須在記憶體里保存它的狀態,這就佔用了伺服器的資源。如果有大量的空閑長連接只連不發,就會很快耗盡伺服器的資源,導致伺服器無法為真正有需要的用戶提供服務。
所以,長連接也需要在恰當的時間關閉,不能永遠保持與伺服器的連接,這在客戶端或者伺服器都可以做到。
在客戶端,可以在請求頭裡加上「Connection: close」欄位,告訴伺服器:「這次通訊後就關閉連接」。伺服器看到這個欄位,就知道客戶端要主動關閉連接,於是在響應報文里也加上這個欄位,發送之後就調用 Socket API 關閉 TCP 連接。
伺服器端通常不會主動關閉連接,但也可以使用一些策略。拿 Nginx 來舉例,它有兩種方式:
-
使用「keepalive_timeout」指令,設置長連接的超時時間,如果在一段時間內連接上沒有任何數據收發就主動斷開連接,避免空閑連接佔用系統資源。
-
使用「keepalive_requests」指令,設置長連接上可發送的最大請求次數。比如設置成 1000,那麼當 Nginx 在這個連接上處理了 1000 個請求後,也會主動斷開連接。
另外,客戶端和伺服器都可以在報文里附加通用頭欄位「Keep-Alive: timeout=value」,限定長連接的超時時間。但這個欄位的約束力並不強,通訊的雙方可能並不會遵守,所以不太常見。
隊頭阻塞
看完了短連接和長連接,接下來就要說到著名的「隊頭阻塞」(Head-of-line blocking,也叫「隊首阻塞」)了。
「隊頭阻塞」與短連接和長連接無關,而是由 HTTP 基本的「請求 - 應答」模型所導致的。
因為 HTTP 規定報文必須是「一發一收」,這就形成了一個先進先出的「串列」隊列。隊列里的請求沒有輕重緩急的優先順序,只有入隊的先後順序,排在最前面的請求被最優先處理。
如果隊首的請求因為處理的太慢耽誤了時間,那麼隊列里後面的所有請求也不得不跟著一起等待,結果就是其他的請求承擔了不應有的時間成本。
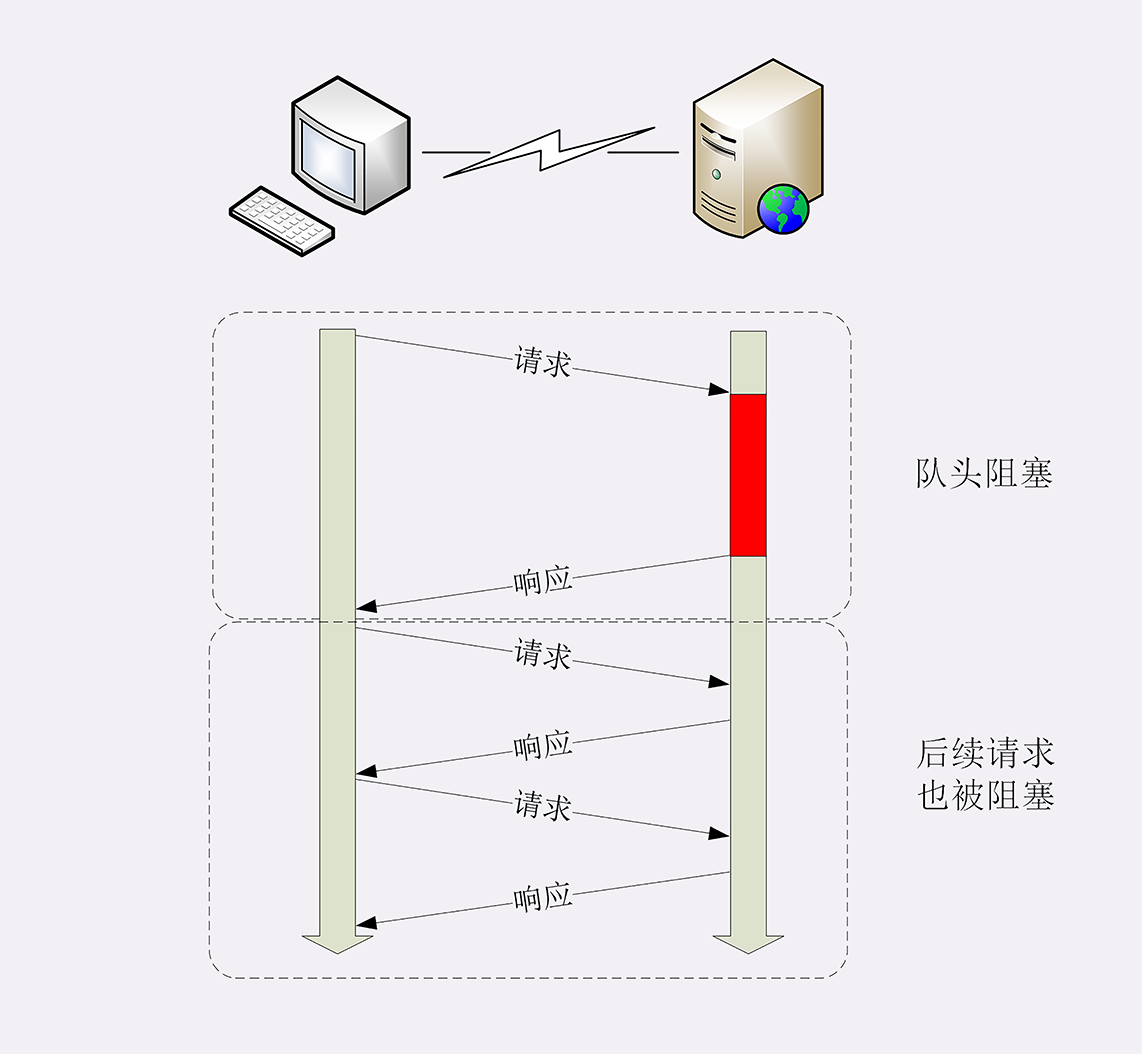
還是用打卡機做個比喻。
上班的時間點上,大家都在排隊打卡,可這個時候偏偏最前面的那個人遇到了打卡機故障,怎麼也不能打卡成功,急得滿頭大汗。等找人把打卡機修好,後面排隊的所有人全遲到了。
性能優化
因為「請求 - 應答」模型不能變,所以「隊頭阻塞」問題在 HTTP/1.1 里無法解決,只能緩解,有什麼辦法呢?
公司里可以再多買幾台打卡機放在前台,這樣大家可以不用擠在一個隊伍里,分散打卡,一個隊伍偶爾阻塞也不要緊,可以改換到其他不阻塞的隊伍。
這在 HTTP 里就是「並發連接」(concurrent connections),也就是同時對一個域名發起多個長連接,用數量來解決品質的問題。
但這種方式也存在缺陷。如果每個客戶端都想自己快,建立很多個連接,用戶數×並發數就會是個天文數字。伺服器的資源根本就扛不住,或者被伺服器認為是惡意攻擊,反而會造成「拒絕服務」。
所以,HTTP 協議建議客戶端使用並發,但不能「濫用」並發。RFC2616 里明確限制每個客戶端最多並發 2 個連接。不過實踐證明這個數字實在是太小了,眾多瀏覽器都「無視」標準,把這個上限提高到了 6~8。後來修訂的 RFC7230 也就「順水推舟」,取消了這個「2」的限制。
但「並發連接」所壓榨出的性能也跟不上高速發展的互聯網無止境的需求,還有什麼別的辦法嗎?
公司發展的太快了,員工越來越多,上下班打卡成了迫在眉睫的大問題。前台空間有限,放不下更多的打卡機了,怎麼辦?那就多開幾個打卡的地方,每個樓層、辦公區的入口也放上三四台打卡機,把人進一步分流,不要都往前台擠。
這個就是「域名分片」(domain sharding)技術,還是用數量來解決品質的思路。
HTTP 協議和瀏覽器不是限制並發連接數量嗎?好,那我就多開幾個域名,比如 shard1.chrono.com、shard2.chrono.com,而這些域名都指向同一台伺服器 www.chrono.com,這樣實際長連接的數量就又上去了,真是「美滋滋」。不過實在是有點「上有政策,下有對策」的味道。
小結
這一講中我們學習了 HTTP 協議里的短連接和長連接,簡單小結一下今天的內容:
-
早期的 HTTP 協議使用短連接,收到響應後就立即關閉連接,效率很低;
-
HTTP/1.1 默認啟用長連接,在一個連接上收發多個請求響應,提高了傳輸效率;
-
伺服器會發送「Connection: keep-alive」欄位表示啟用了長連接;
-
報文頭裡如果有「Connection: close」就意味著長連接即將關閉;
-
過多的長連接會佔用伺服器資源,所以伺服器會用一些策略有選擇地關閉長連接;
-
「隊頭阻塞」問題會導致性能下降,可以用「並發連接」和「域名分片」技術緩解。

