演算法(Java實現)—— KMP演算法
KMP演算法
應用場景
字元串匹配問題
有一個字元串str1 = 「 hello hello llo hhello lloh helo」
一個子串str2 = 「hello」
現要判斷str1是否含有str2,如果存在,就返回第一次出現的位置,如果不存在就返回-1.
暴力匹配演算法
思路:
假設str1匹配到i位置,str2匹配到j位置,則有:
-
如果當前字元匹配成功(str1[i] = str2[j]),則i++,j++ 繼續匹配下一個字元
-
後面如果匹配失敗,回到str1從當前位置向後匹配,重複上述步驟
-
直到在str1中匹配到和str2相同的字串
程式碼實現
package whyAlgorithm.kmp;
/**
* @Description TODO 暴力匹配演算法
* @Author why
* @Date 2020/12/16 18:50
* Version 1.0
**/
public class ViolentMatch {
public static void main(String[] args) {
String str1 = "hhellohellollohhellollohhelo";
String str2 = "hello";
ViolentMatch violentMatch = new ViolentMatch();
int match = violentMatch.getMatch(str1, str2);
System.out.println(match);
}
/**
* 暴力匹配演算法
* 匹配到返回第一個字元的下標否則返回-1
* @param str1
* @param str2
* @return
*/
public int getMatch(String str1,String str2){
//將字元串轉成字元數組
char[] chars1 = str1.toCharArray();
char[] chars2 = str2.toCharArray();
int s1Len = chars1.length;
int s2Len = chars2.length;
int i = 0;//指向chars1
int j = 0;//指向chars2
while (i < s1Len && j < s2Len){//保證匹配時不越界
if (chars1[i] == chars2[j]) {//匹配成功
i++;
j++;
}else {
i = i -(j-1);
j = 0;
}
}
if (j == s2Len){//匹配成功
return i - j;
}else{
return -1;
}
}
}
KMP演算法
KMP演算法介紹
-
KMP演算法時一個解決模式串在文本串是否出現過,如果出現過,返回最早出現的位置的經典演算法
-
Knuth-Morris-Pratt字元串查找演算法,簡稱KMP演算法
-
KMP演算法通過利用之前判斷該資訊,通過一個next數組,保存模式串中前後最長公共子序列的長度,每次回溯時,通過next數組找到,前面匹配過的位置,省去大量時間
演算法圖解
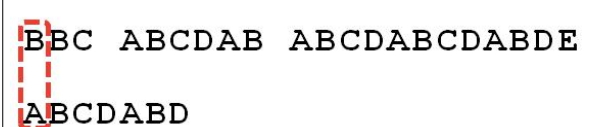
舉例來說,有一個字元串 Str1 = 「BBC ABCDAB ABCDABCDABDE」,判斷,裡面是否包含另一個字元串 Str2 = 「ABCDABD」?
-
首先,用 Str1 的第一個字元和 Str2 的第一個字元去比較,不符合,關鍵詞向後移動一位
-
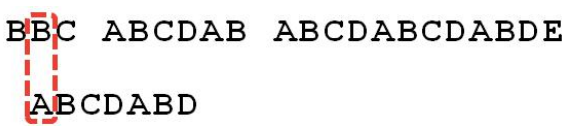
重複第一步,還是不符合,再後移
-
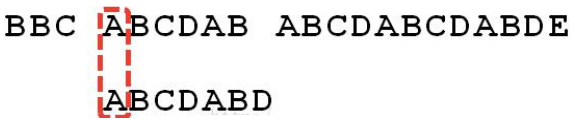
一直重複,直到str1有一個字元域str2的第一個字元符合為止
-
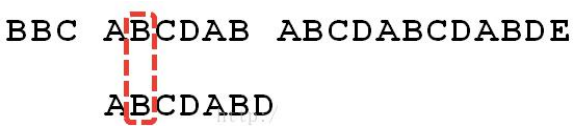
接著比較字元串和搜索詞的下一個字元,還是符合
-
遇到str1有一個字元與str2對應的字元不符合
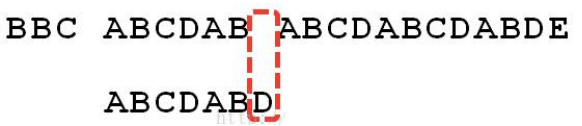
-
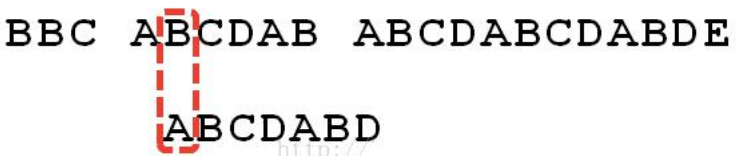
這時候,想到的是繼續遍歷 Str1 的下一個字元,重複第 1 步。(其實是很不明智的,因為此時 BCD 已經比較過了, 沒有必要再做重複的工作,一個基本事實是,當空格與 D 不匹配時,你其實知道前面六個字元是」ABCDAB」。 KMP 演算法的想法是,設法利用這個已知資訊,不要把」搜索位置」移回已經比較過的位置,繼續把它向後移,這 樣就提高了效率。)
-
怎麼做到把剛剛重複的步驟省略掉?可以對 Str2 計算出一張《部分匹配表》,這張表怎麼產生的後面介紹

-
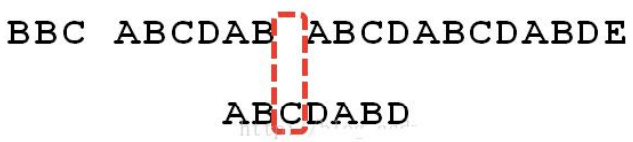
.已知空格與 D 不匹配時,前面六個字元」ABCDAB」是匹配的。查表可知,最後一個匹配字元 B 對應的」部分 匹配值」為 2,因此按照下面的公式算出向後移動的位數: 移動位數 = 已匹配的字元數 - 對應的部分匹配值 因為 6 - 2 等於 4,所以將搜索詞向後移動 4 位。
-
.因為空格與C不匹配,搜索詞還要繼續往後移。這時,已匹配的字元數為 2(」AB」),對應的」部分匹配值」 為 0。所以,移動位數 = 2 - 0,結果為 2,於是將搜索詞向後移 2 位。
-
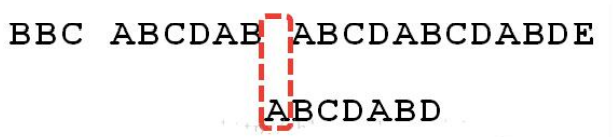
因為空格與 A 不匹配,繼續後移一位。
-
逐位比較,直到發現 C 與 D 不匹配。於是,移動位數 = 6 - 2,繼續將搜索詞向後移動 4 位。
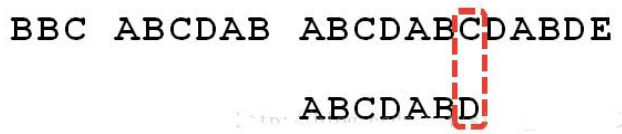
-
逐位比較,直到搜索詞的最後一位,發現完全匹配,於是搜索完成。如果還要繼續搜索(即找出全部匹配), 移動位數 = 7 - 0,再將搜索詞向後移動 7 位,這裡就不再重複了。
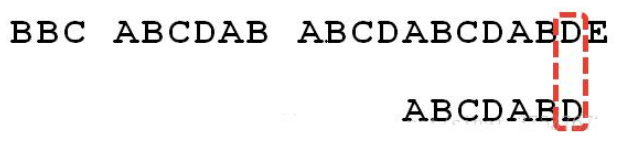

部分匹配表的產生
-
介紹《部分匹配表》怎麼產生的 先介紹前綴,後綴是什麼
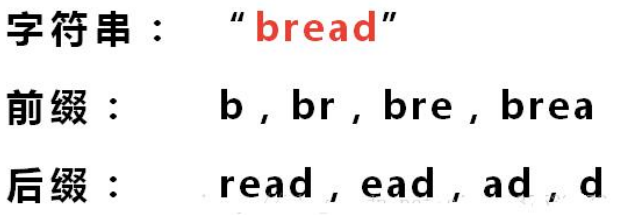
「部分匹配值」就是」前綴」和」後綴」的最長的共有元素的長度。以」ABCDABD」為例,
-」A」的前綴和後綴都為空集,共有元素的長度為 0; -」AB」的前綴為[A],後綴為[B],共有元素的長度為 0; -」ABC」的前綴為 [A, AB],後綴為[BC, C],共有元素的長度 0;
-」ABCD」的前綴為[A, AB, ABC],後綴為[BCD, CD, D],共有元素的長度為 0;
-」ABCDA」的前綴為[A, AB, ABC, ABCD],後綴為[BCDA, CDA, DA, A],共有元素為」A」,長度為 1;
-」ABCDAB」的前綴為[A, AB, ABC, ABCD, ABCDA],後綴為[BCDAB, CDAB, DAB, AB, B],共有元素為」AB」, 長度為 2;
-」ABCDABD」的前綴為[A, AB, ABC, ABCD, ABCDA, ABCDAB],後綴為[BCDABD, CDABD, DABD, ABD, BD, D],共有元素的 長度為 0。
-
」部分匹配」的實質是,有時候,字元串頭部和尾部會有重複。比如,」ABCDAB」之中有兩個」AB」,那麼 它的」部分匹配值」就是 2(」AB」的長度)。搜索詞移動的時候,第一個」AB」向後移動 4 位(字元串長度- 部分匹配值),就可以來到第二個」AB」的位置。
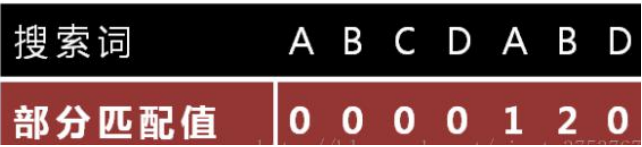
程式碼實現
package whyAlgorithm.kmp;
import java.util.Arrays;
/**
* @Description TODO KMP演算法
* @Author why
* @Date 2020/12/16 20:15
* Version 1.0
**/
public class KMPAlgorithm {
public static void main(String[] args) {
String str1 = "BBC ABCDAB ABCDABCDABDE";
String str2 = "ABCDABD";
kmp(str1, str2);
}
public static void kmp(String str1, String str2) {
int[] next = kmpNext(str2);
System.out.println("部分匹配表:");
System.out.println(Arrays.toString(next));
int index = kmpSearch(str1, str2, next);
if (index == -1){
System.out.println("未找到");
}else {
System.out.println("初始位置:" + index);
}
}
/**
* kmp匹配演算法
* @param str1 原字元串
* @param str2 子串
* @param next 部分匹配表
* @return 如果是-1,沒有匹配到,匹配到返回第一個匹配的位置
*/
public static int kmpSearch(String str1, String str2, int[] next) {
//遍歷
for(int i = 0, j = 0; i < str1.length(); i++) {
//需要處理 str1.charAt(i) != str2.charAt(j), 去調整j的大小
//KMP演算法核心點, 可以驗證...
while( j > 0 && str1.charAt(i) != str2.charAt(j)) {
j = next[j-1];
}
if(str1.charAt(i) == str2.charAt(j)) {
j++;
}
if(j == str2.length()) {//找到了 // j = 3 i
return i - j + 1;
}
}
return -1;
}
/**
* 獲取字元串的部分匹配表
* @param dest
* @return
*/
public static int[] kmpNext(String dest) {
//創建一個next 數組保存部分匹配值
int[] next = new int[