《Java 8 in Action》Chapter 7:並行數據處理與性能
- 2019 年 10 月 3 日
- 筆記
在Java 7之前,並行處理數據集合非常麻煩。第一,你得明確地把包含數據的數據結構分成若干子部分。第二,你要給每個子部分分配一個獨立的執行緒。第三,你需要在恰當的時候對它們進行同步來避免不希望出現的競爭條件,等待所有執行緒完成,最後把這些部分結果合併起來。Java 7引入了一個叫作分支/合併的框架,讓這些操作更穩定、更不易出錯。
Stream介面讓你不用太費力氣就能對數據集執行並行操作。它允許你聲明性地將順序流變為並行流。此外,你將看到Java是如何變戲法的,或者更實際地來說, 流是如何在幕後應用Java 7引入的分支/合併框架的。
1. 並行流
並行流就是一個把內容分成多個數據塊,並用不同的執行緒分別處理每個數據塊的流。
public static long sequentialSum(long n) { return Stream.iterate(1L, i -> i + 1) .limit(n) .reduce(0L, Long::sum); } 傳統寫法: public static long iterativeSum(long n) { long result = 0; for (long i = 1L; i <= n; i++) { result += i; } return result; }1.1 將順序流轉換為並行流
可以把流轉換成並行流,從而讓前面的函數歸約過程(也就是求和)並行運行——對順序流調用parallel方法:
public static long parallelSum(long n) { return Stream.iterate(1L, i -> i + 1) .limit(n) .parallel() .reduce(0L, Long::sum); }在現實中,對順序流調用parallel方法並不意味著流本身有任何實際的變化。它在內部實際上就是設了一個boolean標誌,表示你想讓調用parallel之後進行的所有操作都並行執行。類似地,你只需要對並行流調用sequential方法就可以把它變成順序流。請注意,你可能以為把這兩個方法結合起來,就可以更細化地控制在遍歷流時哪些操作要並行執行,哪些要順序執行。
配置並行流使用的執行緒池
看看流的parallel方法,你可能會想,並行流用的執行緒是從哪來的?有多少個?怎麼自定義這個過程呢?
並行流內部使用了默認的ForkJoinPool,它默認的執行緒數量就是你的處理器數量,這個值是由Runtime.getRuntime().available- Processors()得到的。
但是你可以通過系統屬性 java.util.concurrent.ForkJoinPool.common.parallelism來改變執行緒池大小,如下所示:
System.setProperty("java.util.concurrent.ForkJoinPool.common.parallelism","12");
這是一個全局設置,因此它將影響程式碼中所有的並行流。反過來說,目前還無法專為某個並行流指定這個值。一般而言,讓ForkJoinPool的大小等於處理器數量是個不錯的默認值,
除非你有很好的理由,否則我們強烈建議你不要修改它。
1.2 測量流性能
並行編程可能很複雜,有時候甚至有點違反直覺。如果用得不對(比如採用了一 個不易並行化的操作,如iterate),它甚至可能讓程式的整體性能更差,所以在調用那個看似神奇的parallel操作時,了解背後到底發生了什麼是很有必要的。
並行化並不是沒有代價的。並行化過程本身需要對流做遞歸劃分,把每個子流的歸納操作分配到不同的執行緒,然後把這些操作的結果合併成一個值。但在多個內核之間移動數據的代價也可能比你想的要大,所以很重要的一點是要保證在內核中並行執行工作的時間比在內核之間傳輸數據的時間長。總而言之,很多情況下不可能或不方便並行化。然而,在使用 並行Stream加速程式碼之前,你必須確保用得對;如果結果錯了,算得快就毫無意義了。
1.3 正確使用並行流
錯用並行流而產生錯誤的首要原因,就是使用的演算法改變了某些共享狀態。下面是另一種實現對前n個自然數求和的方法,但這會改變一個共享累加器:
public static long sideEffectSum(long n) { Accumulator accumulator = new Accumulator(); LongStream.rangeClosed(1, n).forEach(accumulator::add) return accumulator.total; } public class Accumulator { public long total = 0; public void add(long value) { total += value; } }這段程式碼本身上就是順序的,因為每次訪問total都會出現數據競爭。接下來將這段程式碼改為並行:
public static long sideEffectParallelSum(long n) { Accumulator accumulator = new Accumulator(); LongStream.rangeClosed(1, n).parallel().forEach(accumulator::add); return accumulator.total;} System.out.println("SideEffect parallel sum done in: " + measurePerf(ParallelStreams::sideEffectParallelSum, 10_000_000L) +" msecs" ); Result: 5959989000692 Result: 7425264100768 Result: 6827235020033 Result: 7192970417739 Result: 6714157975331 Result: 7715125932481 SideEffect parallel sum done in: 49 msecs這回方法的性能無關緊要了,唯一要緊的是每次執行都會返回不同的結果,都離正確值50000005000000差很遠。這是由於多個執行緒在同時訪問累加器,執行total += value,而這一句?然看似簡單,卻不是一個原子操作。問題的根源在於,forEach中調用的方法有副作用,它會改變多個執行緒共享的對象的可變狀態。要是你想用並行Stream又不想引發類似的意外,就必須避免這種情況。現在你知道了,共享可變狀態會影響並行流以及並行計算。
1.4 高效使用並行流
- 如果有疑問,測量。把順序流轉成並行流輕而易舉,但卻不一定是好事。我們在本節中已經指出,並行流並不總是比順序流快。此外,並行流有時候會和你的直覺不一致,所以在考慮選擇順序流還是並行流時,第一個也是最重要的建議就是用適當的基準來檢查其性能。
- 留意裝箱。自動裝箱和拆箱操作會大大降低性能。Java 8中有原始類型流(IntStream、 LongStream、DoubleStream)來避免這種操作,但凡有可能都應該用這些流。
- 有些操作本身在並行流上的性能就比順序流差。特別是limit和findFirst等依賴於元素順序的操作,它們在並行流上執行的代價非常大。例如,findAny會比findFirst性能好,因為它不一定要按順序來執行。你總是可以調用unordered方法來把有序流變成無序流。那麼,如果你需要流中的n個元素而不是專門要前n個的話,對無序並行流調用 limit可能會比單個有序流(比如數據源是一個List)更高效。
- 還要考慮流的操作流水線的總計算成本。設N是要處理的元素的總數,Q是一個元素通過 流水線的大致處理成本,則N*Q就是這個對成本的一個粗略的定性估計。Q值較高就意味著使用並行流時性能好的可能性比較大。
- 對於較小的數據量,選擇並行流幾乎從來都不是一個好的決定。並行處理少數幾個元素的好處還抵不上並行化造成的額外開銷。
- 要考慮流背後的數據結構是否易於分解。例如,ArrayList的拆分效?比LinkedList 高得多,因為前者用不著遍歷就可以平均拆分,而後者則必須遍歷。另外,用range工廠方法創建的原始類型流也可以快速分解。最後,你將在7.3節中學到,你可以自己實現Spliterator來完全掌握分解過程。
- 流自身的特點,以及流水線中的中間操作修改流的方式,都可能會改變分解過程的性能。例如,一個SIZED流可以分成大小相等的兩部分,這樣每個部分都可以比較高效地並行處理,但篩選操作可能丟棄的元素個數卻無法預測,導致流本身的大小未知。
- 還要考慮終?操作中合併步驟的代價是大是小(例如Collector中的combiner方法)。 如果這一步代價很大,那麼組合每個子流產生的部分結果所付出的代價就可能會超出通過並行流得到的性能提升。

並行流背後使用的基礎架構是Java 7中引入的分支/合併框架。
2. 分支/合併框架
分支/合併框架的目的是以遞歸方式將可以並行的任務拆分成更小的任務,然後將每個子任務的結果合併起來生成整體結果。它是ExecutorService介面的一個實現,它把子任務分配給執行緒池(稱為ForkJoinPool)中的工作執行緒。
2.1 使用RecursiveTask
要把任務提交到這個池,必須創建RecursiveTask
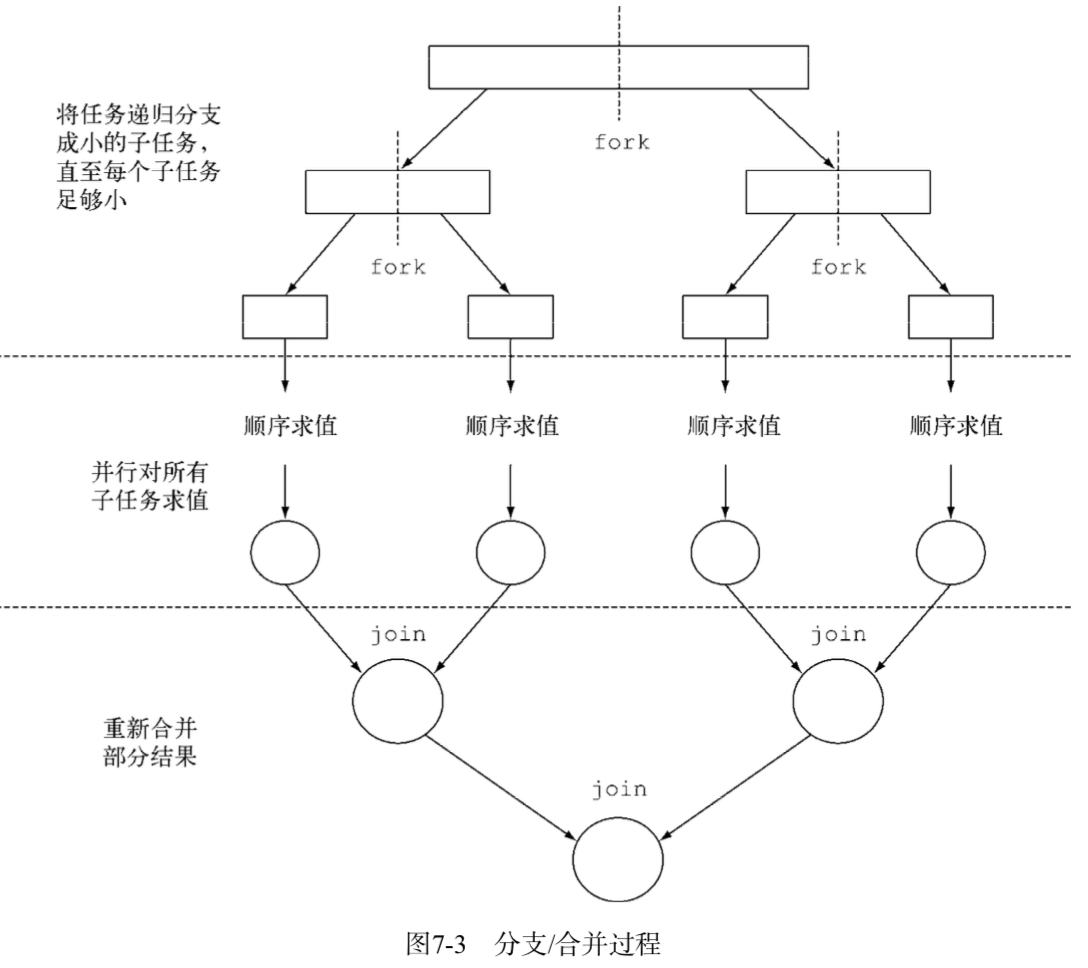
protected abstract R compute();這個方法同時定義了將任務拆分成子任務的邏輯,以及無法再拆分或不方便再拆分時,生成單個子任務結果的邏輯。下圖表示了遞歸任務的拆分過程:
讓我們試著用這個框架為一個數字範圍(這裡用一個 long[]數組表示)求和。如前所述,你需要先為RecursiveTask類做一個實現,就是下面程式碼清單中的ForkJoinSumCalculator。
public class ForkJoinSumCalculator extends RecursiveTask<Long> { private final long[] numbers; private final int start; private final int end; public static final long THRESHOLD = 10_000; public ForkJoinSumCalculator(long[] numbers) { this(numbers, 0, numbers.length); } public ForkJoinSumCalculator(long[] numbers, int start, int end) { this.numbers = numbers; this.start = start; this.end = end; } @Override protected Long compute() { int length = end - start; if (length <= THRESHOLD) { return computeSequentially(); } ForkJoinSumCalculator leftTask = new ForkJoinSumCalculator(numbers, start, start + length / 2); leftTask.fork(); ForkJoinSumCalculator rightTask = new ForkJoinSumCalculator(numbers, start + length / 2, end); Long rightResult = rightTask.compute(); Long leftResult = leftTask.join(); return leftResult + rightResult; } private long computeSequentially() { long sum = 0; for (int i = start; i < end; i++) { sum += numbers[i]; } return sum; } }這裡用了一個LongStream來生成包含前n個自然數的數組,然後創建一個ForkJoinTask (RecursiveTask的父類),並把數組傳遞給程式碼清單7-2所示ForkJoinSumCalculator的公共構造函數。最後,你創建了一個新的ForkJoinPool,並把任務傳給它的調用方法 。在ForkJoinPool中執行時,最後一個方法返回的值就是ForkJoinSumCalculator類定義的任務結果。
請注意在實際應用時,使用多個ForkJoinPool是沒有什麼意義的。正是出於這個原因,一般來說把它實例化一次,然後把實例保存在靜態欄位中,使之成為單例,這樣就可以在軟體中任何部分方便地重用了。這裡創建時用了其默認的無參數構造函數,這意味著想讓執行緒池使用JVM能夠使用的所有處理器。更確切地說,該構造函數將使用Runtime.availableProcessors的返回值來決定執行緒?使用的執行緒數。請注意availableProcessors方法雖然看起來是處理器, 但它實際上返回的是可用內核的數量,包括超執行緒生成的虛擬內核。
當把ForkJoinSumCalculator任務傳給ForkJoinPool時,這個任務就由?中的一個執行緒 執行,這個執行緒會調用任務的compute方法。該方法會檢查任務是否小到足以順序執行,如果不夠小則會把要求和的數組分成兩半,分給兩個新的ForkJoinSumCalculator,而它們也由ForkJoinPool安排執行。因此,這一過程可以遞歸重複,把原任務分為更小的任務,直到滿足不方便或不可能再進一步拆分的條件(本例中是求和的項目數小於等於10000)。這時會順序計算每個任務的結果,然後由分支過程創建的(隱含的)任務二叉樹遍歷回到它的根。接下來會合併每個子任務的部分結果,從而得到總任務的結果。這一過程如下圖所示。

2.2 使用分支/合併框架的最佳做法
- 對一個任務調用join方法會阻塞調用方,直到該任務做出結果。因此,有必要在兩個子任務的計算都開始之後再調用它。否則,你得到的版本會比原始的順序演算法更慢更複雜,因為每個子任務都必須等待另一個子任務完成才能啟動。
- 不應該在RecursiveTask內部使用ForkJoinPool的invoke方法。相反,你應該始終直接調用compute或fork方法,只有順序程式碼才應該用invoke來啟動並行計算。
- 對子任務調用fork方法可以把它排進ForkJoinPool。同時對左邊和右邊的子任務調用它似乎很自然,但這樣做的效?要比直接對其中一個調用compute低。這樣做你可以為其中一個子任務重用同一執行緒,從而避免在執行緒池中多分配一個任務造成的開銷。
- 調試使用分支/合併框架的並行計算可能有點棘手。特別是你平常都在你喜歡的IDE裡面看棧跟蹤(stack trace)來找問題,但放在分支-合併並計算上就不行了,因為調用compute的執行緒並不是概念上的調用方,後者是調用fork的那個。
- 和並行流一樣,你不應理所當然地認為在多核處理器上使用分支/合併框架就比順序計算快。我們已經說過,一個任務可以分解成多個獨立的子任務,才能讓性能在並行化時有所提升。所有這些子任務的運行時間都應該比分出新任務所花的時間長;一個慣用方法是把輸入/輸出放在一個子任務里,計算放在另一個里,這樣計算就可以和輸入/輸出同時進行。此外,在比較同一演算法的順序和並行版本的性能時還有別的因素要考慮。就像任何其他Java程式碼一樣,分支/合併框架需要「預熱」或者說要執行幾遍才會被JIT編譯器優化。這就是為什麼在測量性能之前跑幾遍程式很重要,我們的測試框架就是這麼做的。同時還要知道,編譯器內置的優化可能會為順序版本帶來一些優?(例如執行死碼分析——刪去從未被使用的計算)。
2.3 工作竊取
實際中,每個子任務所花的時間可能天差地別,要麼是因為劃分策略效率低,要麼是有不可預知的原因,比如磁碟訪問慢,或是需要和外部任務協調執行。分支/合併框架工程用一種稱為工作竊取(work stealing)的技術來解決這個問題。
在實際應用中,這意味著這些任務差不多被平均分配到ForkJoinPool中的所有執行緒上。每個執行緒都為分配給它的任務保存一個雙向鏈式隊列,每完成一個任務,就會從隊列頭上取出下一個任務開始執行。基於前面所述的原因,某個執行緒可能早早完成了分配給它的所有任務,也就是它的隊列已經空了,而其他的執行緒還很忙。這時,這個執行緒並沒有閑下來,而是隨機選了一個別的執行緒,從隊列的尾巴上「偷走」一個任務。這個過程一直繼續下去,直到所有的任務都執行完畢,所有的隊列都清空。這就是為什麼要劃成許多小任務而不是少數幾個大任務,這有助於更好地在工作執行緒之間平衡負載。一般來說,這種工作竊取演算法用於在池中的工作執行緒之間重新分配和平衡任務。

3. Spliterator
Spliterator是Java 8中加入的另一個新介面;這個名字代表「可分迭代器」(splitable iterator)。和Iterator一樣,Spliterator也用於遍曆數據源中的元素,但它是為了並行執行而設計的。
public interface Spliterator<T> { boolean tryAdvance(Consumer<? super T> action); Spliterator<T> trySplit(); long estimateSize(); int characteristics(); }與往常一樣,T是Spliterator遍歷的元素的類型。tryAdvance方法的行為類似於普通的 Iterator,因為它會按順序一個一個使用Spliterator中的元素,並且如果還有其他元素要遍歷就返回true。但trySplit是專為Spliterator介面設計的,因為它可以把一些元素划出去分給第二個Spliterator(由該方法返回),讓它們兩個並行處理。Spliterator還可通過 estimateSize方法估計還剩下多少元素要遍歷,因為即使不那麼確切,能快速算出來是一個值也有助於讓拆分均勻一點。
3.1 拆分過程
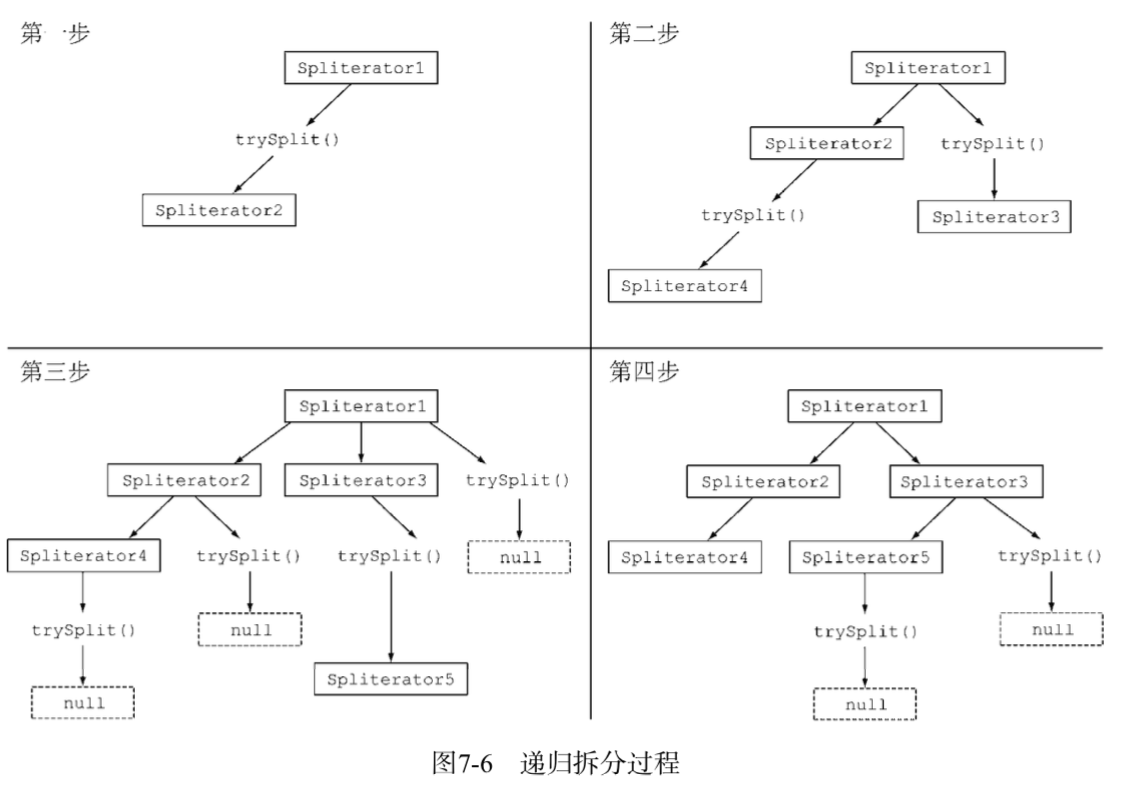
將Stream拆分成多個部分的演算法是一個遞?過程,如圖7-6所示。第一步是對第一個 Spliterator調用trySplit,生成第二個Spliterator。第二步對這兩個Spliterator調用 trysplit,這樣總共就有了四個Spliterator。這個框架不斷對Spliterator調用trySplit直到它返回null,表明它處理的數據結構不能再分割,如第三步所示。最後,這個遞歸拆分過程到第四步就終止了,這時所有的Spliterator在調用trySplit時都返回了null。
Spliterator的特性 Spliterator介面聲明的最後一個抽象方法是characteristics,它將返回一個int,代 表Spliterator本身特性集的編碼。 使用Spliterator的客戶可以用這些特性來更好地控制和優化它的使用。 表7-2總結了這些特性。(不幸的是,雖然它們在概念上與收集器的特性有重疊,編碼卻不一樣。)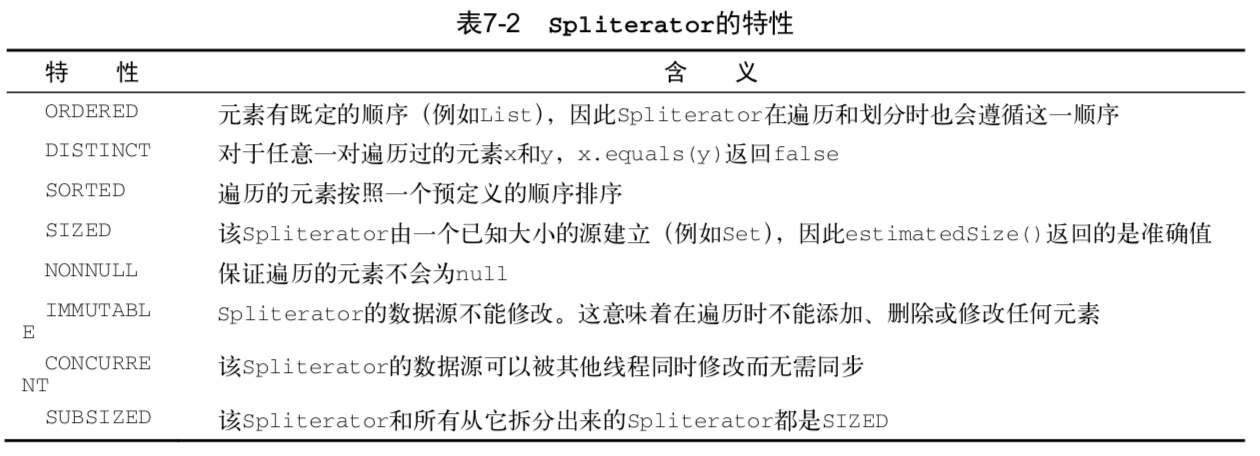
3.2 實現自定義Spliterator
略
4. 小結
在本章中,你了解了以下內容。
- 內部迭代讓你可以並行處理一個流,而無需在程式碼中顯式使用和?調不同的執行緒。
- 雖然並行處理一個流很容易,卻不能保證程式在所有情況下都運行得更快。並行軟體的行為和性能有時是違反直覺的,因此一定要測量,確保你並沒有把程式拖得更慢。
- 像並行流那樣對一個數據集並行執行操作可以提升性能,特別是要處理的元素數量龐大,或處理單個元素特別耗時的時候。
- 從性能角度來看,使用正確的數據結構,如儘可能利用原始流而不是一般化的流,幾乎總是比嘗試並行化某些操作更為重要。
- 分支/合併框架讓你得以用遞歸方式將可以並行的任務拆分成更小的任務,在不同的執行緒上執行,然後將各個子任務的結果合併起來生成整體結果。
- Spliterator定義了並行流如何拆分它要遍歷的數據。
資源獲取
- 公眾號回復 : Java8 即可獲取《Java 8 in Action》中英文版!
Tips
- 歡迎收藏和轉發,感謝你的支援!(๑•̀ㅂ•́)و✧
- 歡迎關注我的公眾號:莊裡程式猿,讀書筆記教程資源第一時間獲得!