AI晶片:高性能卷積計算中的數據復用
- 2019 年 10 月 3 日
- 筆記
隨著深度學習的飛速發展,對處理器的性能要求也變得越來越高,隨之湧現出了很多針對神經網路加速設計的AI晶片。卷積計算是神經網路中最重要的一類計算,本文分析了高性能卷積計算中的數據復用,這是AI晶片設計中需要優化的重點之一,具體思路如下
- 數據復用的動機
- 存儲-計算分離框架下,針對卷積計算的優化思路
- 針對卷積計算的硬體架構設計分析
- 已經面臨的挑戰和解決方向
- 神經網路中數據復用的未來
1. 高性能卷積計算中數據復用的動機
深度學習的發展過程中,較高的計算量是制約其應用的因素之一。卷積神經網路中,主要計算為三維的卷積計算(後簡稱為卷積),現有的主串流處理器難以高性能,高效能的完成卷積計算。相比一般的通用計算,卷積計算中存在的大量數據復用以及計算的規則性,在硬體的微架構(後簡稱為架構)設計和計算優化上有很大的優化空間,由此誕生了眾多針對深度學習加速的AI晶片。卷積計算過程可以表示如下
for i = 1 : Ho for j = 1 : Wo for k = 1 : Co for l = 1 : Hf for m = 1 : Wf for n = 1 : Ci out[i,j,k] += In[i*s+l.j*s+m,n]*F[l,m,n];其中各參數的含義如下表
| 數據維度 | 描述 |
|---|---|
| Ho/Wo | 輸出feature map的高和寬 |
| Co | 輸出的channel數目 |
| Hf/Wf | filter的高和寬 |
| Ci | 輸入的channel數目 |
| s | 卷積計算的stride |
據此可推算出輸入輸出數據的數據復用關係,如下表
| Type | Mem Refs | Ops | Ops/Memory |
|---|---|---|---|
| Filter | (H_f W_f C_i C_o) | (H_o W_o C_o H_f W_f C_i) | (H_oW_o) |
| Input | (H_o W_o C_i s^2) | (H_o W_o C_o H_f W_f C_i) | (H_fW_fC_o/s^2) |
| Output | (H_o W_o C_o) | (H_o W_o C_o H_f W_f C_i) | (H_f W_f C_i) |
可以看出,卷積計算過程中對Filter,Input和Output的數據均有很高的數據復用;充分利用計算過程中的數據復用是達到高性能和高效能的關鍵,這主要有以下幾個方面原因
- 利用數據復用更容易達到設計的峰值性能
- 利用數據復用可以降低記憶體訪問,降低功耗
- 廣義來看,卷積中規則的數據復用,可以降低處理器設計中快取/控制邏輯的設計複雜度,提高總體的性能
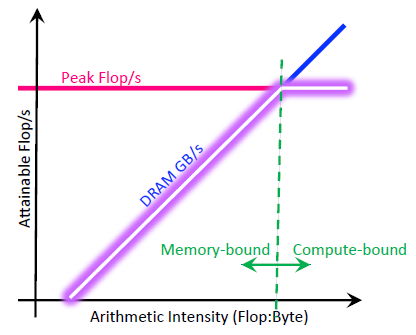
根據Roofline模型很容易解釋第一點原因。Roofline模型是一種面向吞吐量的性能評價模型,它指出在理想情況下,處理器性能的理論上界。如下圖(Ref. CS217_Lec6)所示,在數據復用不高的情況下,峰值性能受限於記憶體(Memory-bound)。
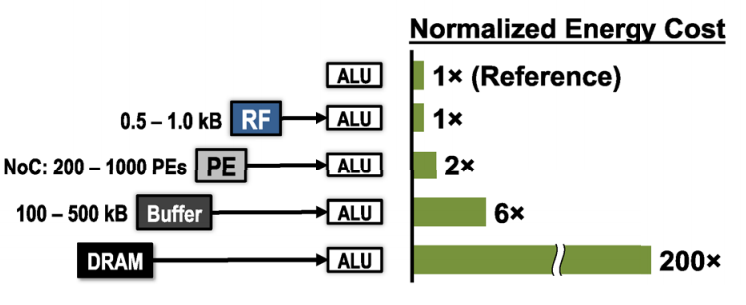
訪問不同存儲的歸一化能耗比(Ref. 6)可以解釋第二點原因。充分利用數據復用,使得訪存多發生在RF等靠近ALU的存儲上,可以極大降低功耗。
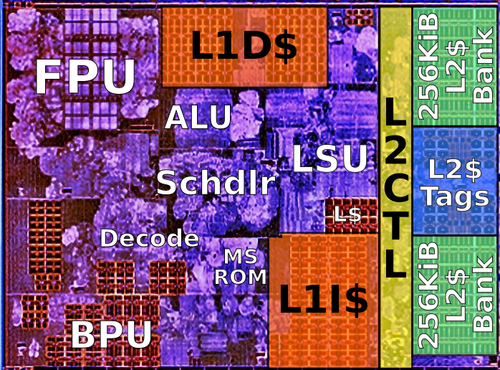
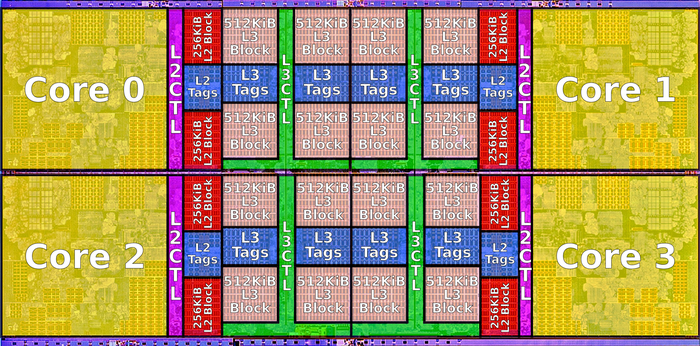
針對第三點,以AMD ZEN系列CPU為例,Die的結構如下圖所示(Ref. https://en.wikichip.org/wiki/amd/microarchitectures/zen)。可以看出FPU和ALU只佔CPU面積的很小一部分。大部分面積是控制邏輯的快取。這意味著如果針對卷積計算這種規則的,具有時間和空間強相關性的,且沒有分支跳轉的計算設計專門的硬體,可以拋開專用處理器中複雜的控制和快取設計,減小晶片面積,提升性能,降低功耗。
這些特性表明,卷積計算有很大的優化空間;專門針對卷積計算設計的晶片能極大的提高性能和效能 。
2. 高性能卷積的計算方法
2.1 卷積即矩陣乘法
矩陣-矩陣乘法的應用已經非常廣泛,很多線性代數庫充分結合了矩陣計算中的數據復用關係和處理器快取的層次設計結構,對矩陣-矩陣乘法進行了充分的優化(GEMM,通用矩陣乘法)。(C = AB + C)的矩陣乘法可以表示為
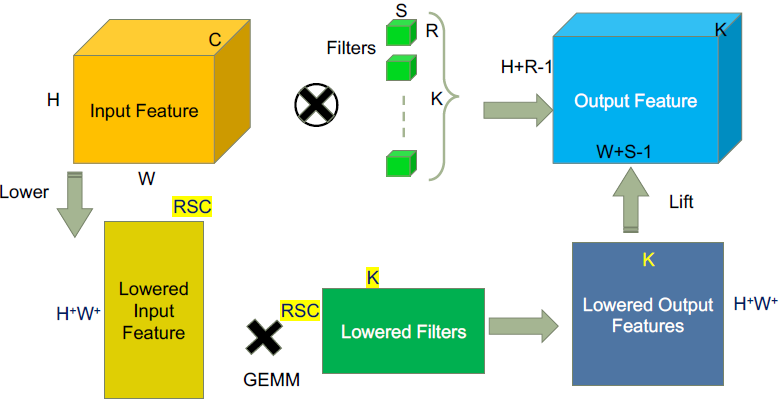
for i = 1 : m for j = 1 : n for k = 1 : t C(i,j) = A(i,k)*B(k,j) + C(i,j)這一形式和第1節中卷積的計算方式極其類似。實際上,針對三維的Tensor進行展開(即將卷積計算中的六層循環的內三層進行合併),很容易將卷積計算轉化為矩陣乘法計算(im2col)。 其中一種展開方式如下圖 (Ref. CS217_Lec9)
下圖也給出了一個具體的例子(Ref. 在 Caffe 中如何計算卷積?,原始鏈接High Performance Convolutional Neural Networks for
Document Processing)
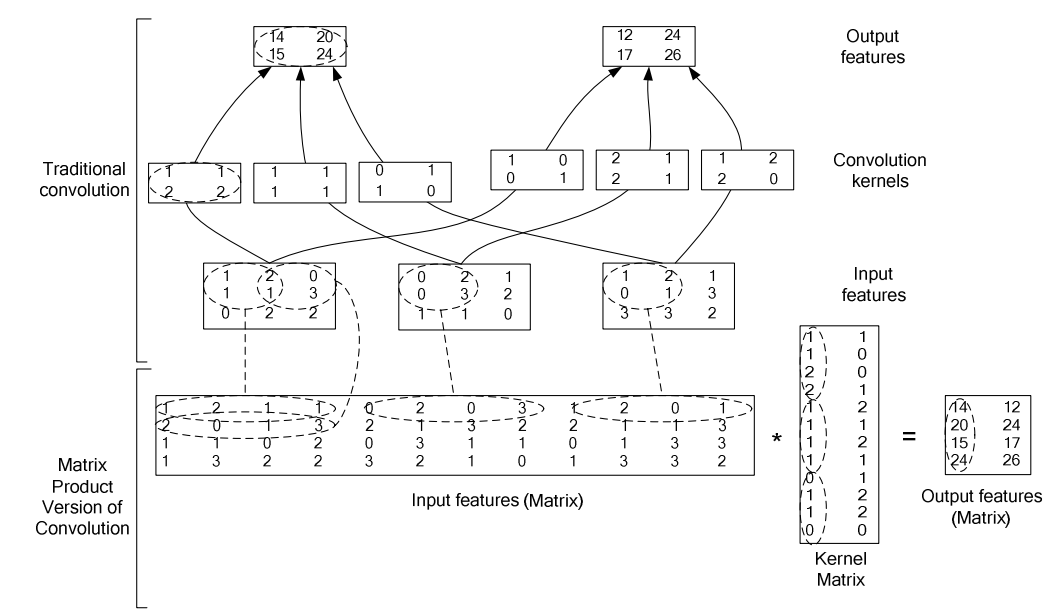
此時,卷積計算等價為矩陣乘法計算;而卷積計算中的數據復用關係等價為了矩陣計算中的數據復用關係。矩陣-矩陣乘的複雜度如下所示
Ex. | Mem Refs | Ops | Ops/Memory
-| - | - | -
Matrix-Matrix Mult | (4n^2) | (2n^3) | (n/2)
現有的處理器架構從存儲和計算之間的關係上來看都是類似的,處理器計算性能的上限可以通過計算單元及其運行頻率確定。為了高性能的完成矩陣計算,即使得性能達到Roofline模型中峰值,需要對矩陣計算的三層循環進行優化。在進行分析之前,需要明確兩點固有的特性
- 處理器的存儲是分層設計的,越靠近計算的單元,頻寬越大,容量越小
- Roofline模型和訪存的頻寬有關,如下圖所示
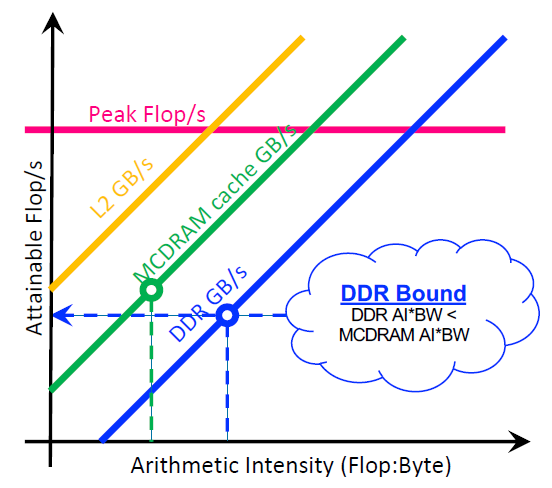
如果矩陣存儲在記憶體中(DDR),直接按三層循環進行矩陣計算,那麼每個周期需要訪問(a,b,c)三個數,此時性能會受限於DDR頻寬。將矩陣放在片上的Cache中是一個好的選擇,但是片上Cache的容量往往較小。解決這一個矛盾的方法是對大的矩陣進行分塊,此時矩陣計算可以表示為
for i = 1 : MR : m // step MR for j = 1 : NR : n // step NR for k = 1 : KC : c // step KC // block-dot product in cache // Csub_{NR*MR} += Asub_{MR*KC}*B_sub(KC*NR) // opt. mirco kernel for ir = 1:MR for jr = 1:NR for kr = 1: KC Csub(ir,jr) += Asub(ir,kr)*Bsub(kr,jr);採用這一分塊方式,假設矩陣存儲在DDR,分塊後的矩陣存儲在片上Cache;完成(MRtimes NRtimes NC)次乘法計算只需要從DDR獲取(MRtimes NR + NR times NC + MRtimes NC) 個數據,合理的分塊能降低對DDR的訪問。
針對具有不同存儲層次的處理器以及不同大小的矩陣計算而言,有不同的分塊方式以達到峰值性能。雖然這一方法針對矩陣計算進行了很好的優化,但對於卷積計算而言,依舊存在缺陷
- im2col計算過程中針對Tensor進行了Reshape和Duplicate,這會增加頻寬的消耗
- 轉化得到的矩陣乘法和傳統的矩陣計算維度相差較大,可能無法獲得好的性能
由於這些缺陷存在,如果沒有針對硬體架構進行特殊的設計,卷積即矩陣乘法的設計思路往往無法達到峰值性能。
2.2 卷積即卷積
採用矩陣-矩陣乘法進行卷積計算忽略了卷積本身的特性。卷積計算實際上是一類很特殊的計算,以一維的離散卷積為例,函數(f,g)之間的卷積可表示為
[ (f*g)[n]=sum_{m=-infty}^{infty}f[m]g[n-m] ]
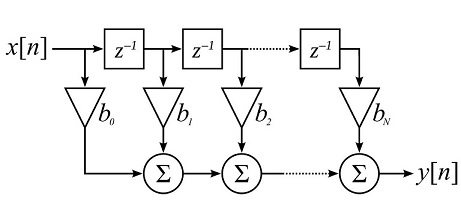
以有限長脈衝響應(Finite impulse response,FIR)濾波器作為離散卷積的一維特例,可表示為
[ y[n]=sum_{i=0}^{N}b_i cdot x[n-i] ]
一維的脈動陣列FIR濾波器的一種實現方式,其實現結構如下圖(Ref. Wikipedia),採用這種結構,每輸入一個(x[n]),就能計算得到一個(y[n])。這種特殊的數據復用是根據卷積計算的特殊性質得到的。
在卷積神經網路中,卷積層的計算一般也存在這種數據復用關係(除kernelsize <= stide情況外)。如果能用好這一特性,不再將卷積轉化為矩陣乘法,直接計算卷積,能獲得更高的性能。為了達到這一目標,和分析矩陣乘法類似,對卷積的六層循環進行分析
for i = 1 : Ho for j = 1 : Wo for k = 1 : Co for l = 1 : Hf for m = 1 : Wf for n = 1 : Ci out[i,j,k] += In[i*s+l.j*s+m,n]*F[l,m,n];類似GEMM,最內層循環會被並行化,為了達到更好的性能,可以對循環順序進行調整(Ref.9)
- 為了提高並行性,由於Co循環的各個計算之間相互獨立,將其放置到最內層循環
- 由於Wf,Hf可能會很小,為了保證並行性,將Wo放到Co循環外
完成調整之後,對卷積計算進行分塊(Ref. 9)
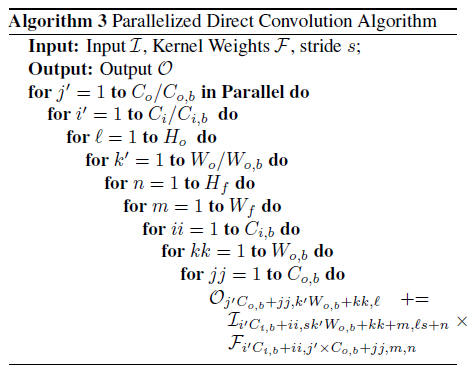
為了進一步提高訪存的效率,Input/Ouput/Filter在記憶體中的排布方式也需要進行相應的調整,可參見參考文獻9,此處不再描述。
無論是將卷積轉化為矩陣計算,或者直接計算卷積,都能夠通過分塊的方式相對高效的完成卷積計算;由於將卷積轉化為矩陣計算有一定開銷,其性能可能會受到一定影響,但矩陣計算具有更高的靈活性。
3. 高性能卷積的架構設計
3.1 GEMM加速器
顯然,實現一個硬的GEMM加速器可以加速矩陣計算,進而加速卷積計算。針對GEMM的分塊矩陣(即內層循環)進行硬體加速是一種簡單,高效且相對靈活的選擇,其優勢包括
- 簡單,計算單元實現GEMM的mirco kernel即可,易於集成
- 靈活,支援所有可用GEMM加速的演算法(理論上)
- 編譯器設計和調度有很多參考實現
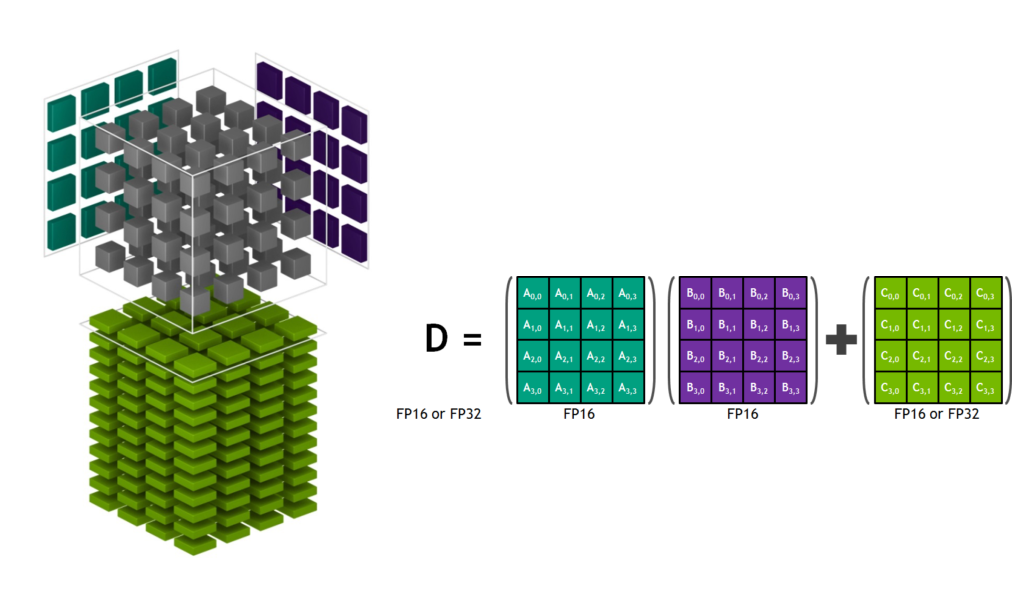
類似設計包括Nvidia的Volta架構,其加速核心被稱為Tensor Core;以及華為的達芬奇架構(Davinci Core),其卷積的計算核心被稱為CUBE Core。
其中,Nvidia的每個Tensor Core是一個(4times4times4) 的MAC陣列。計算(C = AB + C) 時,矩陣(A,B) 中的元素廣播到4個不同的MAC上,同時每個四個乘法的結構累加到一起,如下圖所示(Ref.Volta Tensor Core GPU Achieves New AI Performance Milestones)
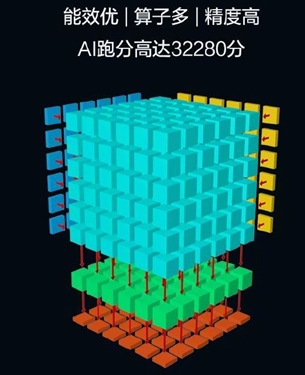
達芬奇中的CUBE Core是一個(16times16times16)的MAC陣列(以Davinci Max為例),如下圖所示(hotchips31),具有更高的數據復用關係。
Nvidia Volta架構中,Tensor Core僅僅只是一個特殊的計算單元,其地位和FP計算單元一致。
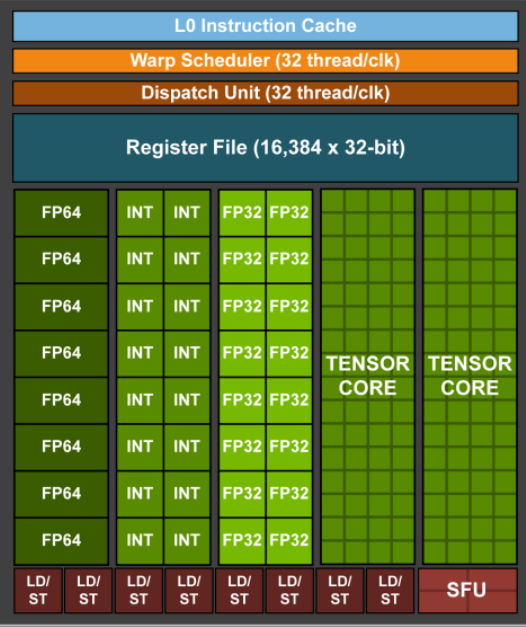
為了保證計算單元之外設計的統一性,送入計算單元的數據位寬完全一致,和普通的FP32計算單元比,Tensor Core在算力上有很大的優勢。由下表可以看出,由於數據復用和精度的降低,Tesnor Core的理論性能是FP32的8倍(同頻,其中兩倍受益於精度的降低)。
| Ex. | DataWidth | Data Num | Ops |
|---|---|---|---|
| FP32 | 256 | 8 | 16 |
| Tensor Core | 256 | 16 | 128 |
Davinci Core進行了更多的設計,配合完成高性能的卷積計算。MTE中的img2col表明其進行了3D Tensor到Matrix的轉換。(Ref. 華為在hotchips詳細介紹了達芬奇架構)
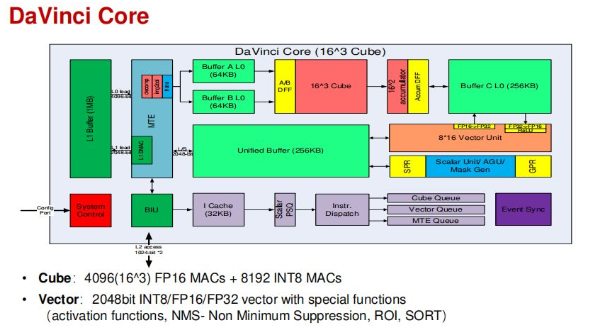
前文提到「卷積即矩陣乘法的設計思路無法達到峰值性能」,但有了硬體架構的聯合設計,這一結論不再成立。譬如在Davinci Core中,在L0 Buffer進行Img2col可以降低由於im2col增加的訪存頻寬,合理設計的L0 BufferA/B/C也能應對卷積操作中大量的中間結果。
3.2 脈動陣列
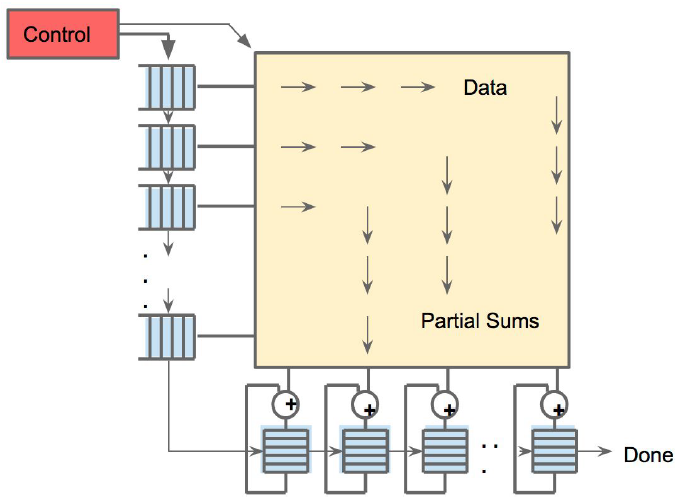
脈動陣列的典型代表是Google TPU,Google TPU中設計的脈動陣列也是針對矩陣乘法設計(雖然有的脈動陣列也可直接計算卷積,但TPU並沒有採用這一類設計)。之前的文章有對Google TPU進行細緻的分析(動手寫一個簡單版的GoogleTPU),並實現了一個小規模的基於VLIW+Vector Architecture的TPU(SimpleTPU,VLIW+向量體系結構),可以作為進一步參考。Google TPU的其計算核心為一個(256times 256)的二維脈動陣列,如下圖所示(Ref. 4)
另一個類似的設計時Telsa(特斯拉)的Full self-driving(FSD) computer,其內部的Nerual Network Accelerator(NNA)也實現了一個大規模的矩陣乘法器(NNA也可能時直接採用廣播的形式,而非脈動形式進行輸入)。參考其專利中的說明,其具體實現和Google TPU略有差異。
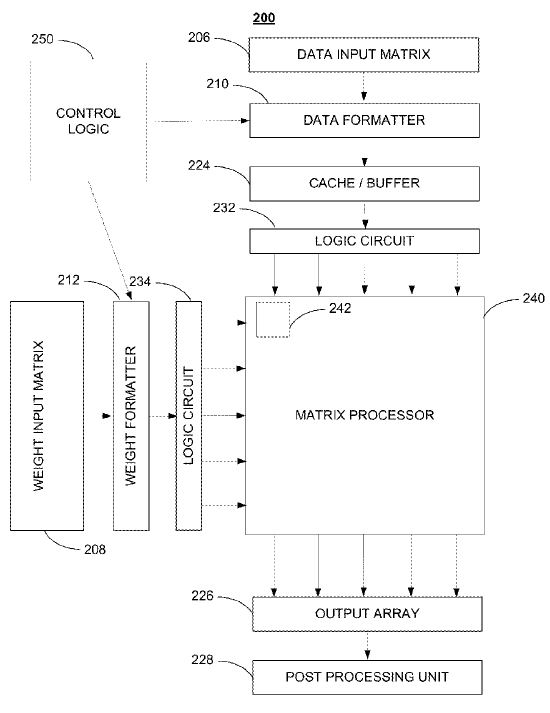
根據描述,FSD NNA中的Wieght和Activation均通過DATA FORMATTER後送入到MATRIX PROCESSOR中。乘法的結果在MATRIX PROCESSOR中進行累加,計算出最終結果後依次向下移位輸出。FSD中有兩個NNA,其中MATRIX PROCESSOR的大小均為(96times 96),和TPU1相比,FSD的主要差異表現在
- 計算過程中,TPU的weight保持不變,而FSD的partial sum保持不變
- TPU中的weight保持在DRAM中(片外),FSD保留在SRAM中
- 由於FSD的weight存儲在片上,為了滿足輸入的數據排布要求,增加了在線的Weight Formatter模組
- FSD的輸入寬度為96,是3的倍數,這是應為在Data Formatter時對kernel進行了展開((3times 3)的kernel中有因子3);而TPU1的寬度為256是2的冪次,kernel的展開很有可能是時間上隱式進行的
針對TPU和FSD這種在數據流中的差異,可以分為Weight Stationary,Output Stationary和No Local Reuse等(Ref. 6)。這種針對Dataflow的分類方法也涉及到數據復用,但主要針對Register File上的復用進行分析,和本文針對計算中存在的數據復用關係進行分析有所不同(一個典型的差別是Ref.6中歸類為no local reuse的情況在本文認為是有數據復用的)。
3.3 直接卷積加速器
Eyeriss是一種直接針對卷積計算優化的加速器,和其他加速器不同,Eyeriss針對Convolution Reuse進行了優化。按Ref.6的分類標準,是一種Row Stationary。(Ref. 7)
由於卷積神經網路計算卷積時C方向的特殊性,Convolution Reuse僅在H和W方向存在。以kernelsiz=3,stride=1為例,卷積計算中row方向的數據復用如下圖(Ref. 7)
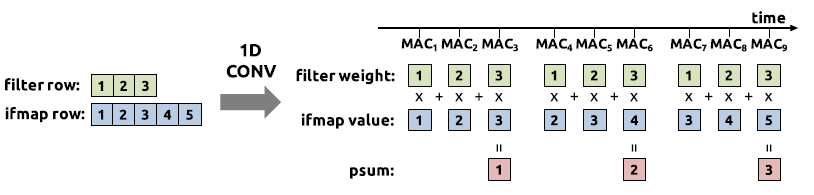
此時ifmap中的元素3被利用了三次,只需要從存儲中訪問一次元素3,就能完成3次計算。當擴展為二維時,有(Ref. 7)
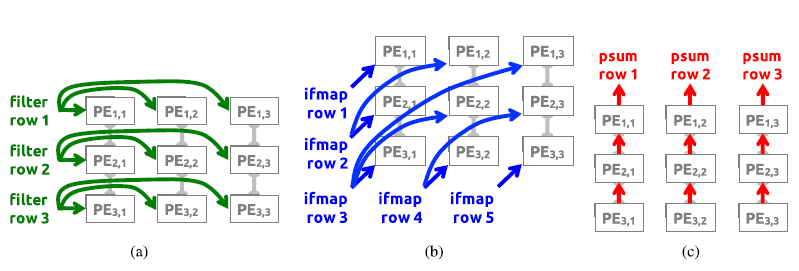
即ifmap的row方向在不同PE之間進行復用;而實際上ifmap的col方向的數據會暫存在PE內的RF上,col方向的數據也在RF上進行復用。
Eyeriss利用了convolution resue,同時也可以利用其他resue的手段。譬如上圖中的filter在水平PE之間復用,psum在垂直的若干個PE之間復用。這意味這Eyeriss相比其他結構做到了更多的數據復用,可以進一步降低功耗。
3.4 基於變化域的卷積計算
一維卷積的計算複雜度為(O(n^2)),由於時域卷積等於頻域相乘,對於離散訊號而言,可以通過快速傅里葉變換(Fast Fourier Transform,FFT)及其逆變換將訊號在時域和頻域之間變換。而FFT的計算複雜度為(O(nlogn)),當(n)取值較大時,其計算複雜度會遠低於直接計算一維卷積。
類似的,可以考慮在其他域進行二維/三維卷積的計算;針對卷積神經網路中的加速,有
- FFT based Method (Fast training of convolutional networks through FFTs)
- Winograd Method (Fast Algorithms for Convolutional Neural Networks)
但若想取得一定的加速比,這些方法對卷積核的大小和步長均有要求;這一類方法均難以適應卷積核日益小型化的發展趨勢。
4. 輕量化網路帶來的新的設計挑戰
當大多數AI晶片中的神經網路加速器還在使用AlexNet/VGG/ResNet跑benchmark時,新的網路層出不窮。一些為了運行在嵌入式設備上而設計的輕量化網路通過壓縮卷積中各個維度的計算來降低計算量,這很大程度影響了卷積計算中的數據復用關係。考慮在輕量化網路中使用的Point Wise Conv和Depth Wise Conv,以及延時受限系統中Batch=1的全連接層,有下表
| Type | Ops/Memory |
|---|---|
| Point-Wise Convolution Layer | Input: (C_o/s^2)Filter: (H_oW_o) Output:(C_i) |
| Depth-Wise Convolution Layer | Input: (H_fW_f/s^2)Filter: (H_oW_o) Output:(H_f W_f) |
| Batch=1 Fully Connect Layer | Input: (C_o)Filter: (1) Output:(C_i) |
而第三節中一些典型的基於數據復用的加速其設計中,若想達到最優性能,對數據復用的要求是
| Architectures | Input1 | Input2 | Output |
|---|---|---|---|
| (16times16times16) Cube Core | 16 | 16 | 16 |
| (256times256) Systolic Array | 256 | 1350 | 256 |
| Eyeriss V1(Theo. low bound) | 168 | 42 | 42 |
數據復用關係的失配會讓這些加速器在運行這些特定的Layer時出現嚴重的效率問題。譬如TPU V1在計算(3times3) Depthwise Conv時效率不可能超過(9/256=3.5%)。這樣低的效率使得這些設計良好的網路帶來的數量級的計算量下降變得毫無意義。
從根源上看,Cube Core或者Systolic Array的優化目標都是Matrix-Matrix乘法,而Batch=1得FC和Depthwise Conv更貼近於Matrix-Vector乘法,這在本質上就是不同的。即使在軟體層面的優化上,這兩個運算也是分別進行優化的(GEMM和GEMV)。
而對於晶片設計而言,已經面臨的挑戰是如何設計一個在多變的復用關係下均能保證較高效率的神經網路加速器。完成這一目標,至少有兩種不同的設計方向
- 具有靈活互聯結構的可重構加速器
- 標量+矢量+向量的異構加速器
4.1 具有靈活互聯結構的可重構加速器
上述的幾乎所有的討論和設計,都能歸結到降低數據頻寬上。一旦數據頻寬降低後,其靈活性就受到了很大的限制,這是無法計算GEMV的原因之一。如果需要加速器能夠在各種情況下有良好的表現,最直接的解決方案就是在設計上提供高的頻寬和靈活性。
Eyeriss V2就採用這種思路對Eyeriss V1進行改進,以高效支援MobileNet。為了提供高頻寬,Eyeriss設計了層次化2D Mesh的Noc(Ref. 8)
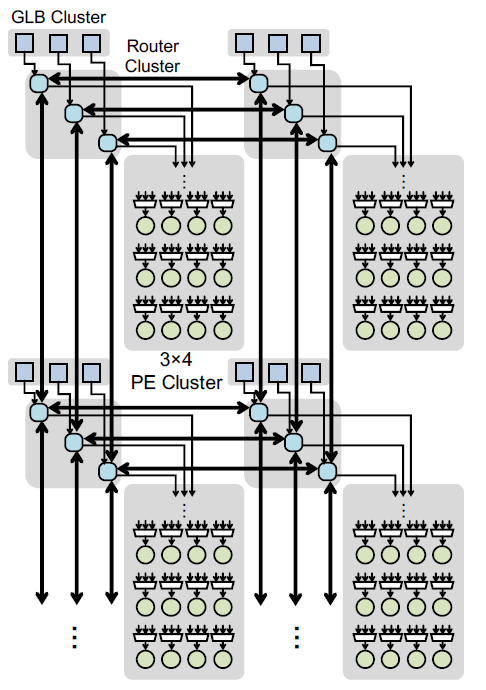
設計中一個PE Cluster具有12個PE,12個PE之間互相連接;PE Cluster通過一個2D Mesh進行互聯。Global Buffer到PE之間具有豐富的連線,在不同計算模式下可以以Multicast,broadcast和unicast進行數據傳輸,充分滿足不同計算下的數據需求。
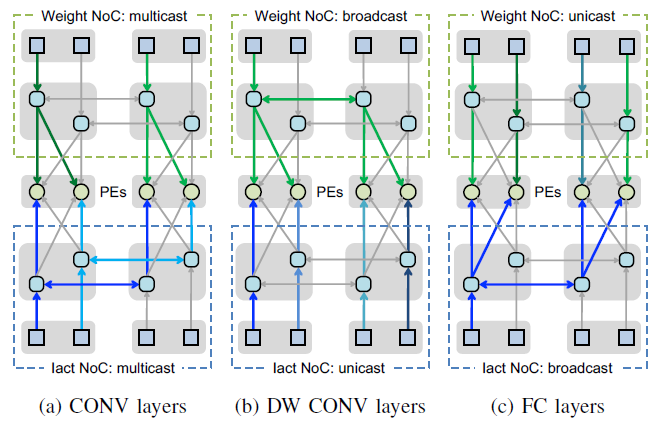
儘管Eyeriss V2中並沒有提到可重構,但其Noc在計算不同網路時有不同的選通路徑,和可重構的思想一致。一般談到硬體可重構,一般會想到FPGA(Field-Programmable Gate Array,現場可編程大規模邏輯門陣列)。通過FPGA片上豐富的的互聯結構和查找表,FPGA理論上可以用於實現各種形式的電路。
FPGA可以創造出各種可能,但FPGA設計上有很多冗餘,在布局布線和載入上也會花費較多時間。究其本因,是因為FPGA採用了很底層的基本單元來構建整個電路。與FPGA這種細粒度可重構相對應的是粗粒度可重構網路,粗細度可重構不像FPGA一樣可以控制每一個bit的選通,而是提供了一系列基本的計算單元和互聯結構。根據演算法的需求,可以採用不同的方式構建這些計算單元。譬如Plasticine中的PCU中,每個FU由前向,回饋等多種路徑,可以構建不同的計算單元。(Ref. 11)
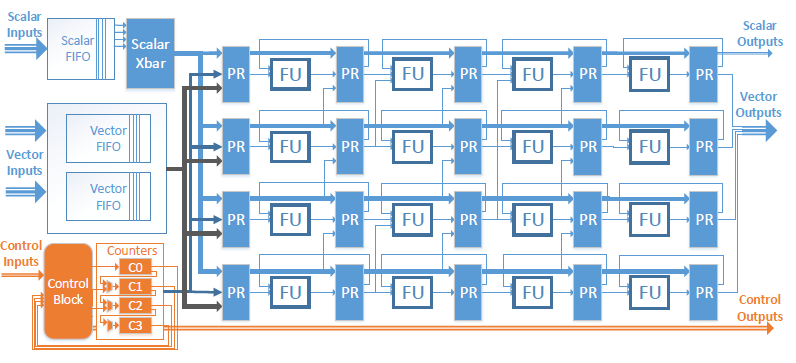
多個PCU之間通過交換網路和其他PCU及PMU(Memory)相連,可以配合完成不同的操作。這些都以增加片上各個單元之間的互聯性為基礎。(Ref. 11)
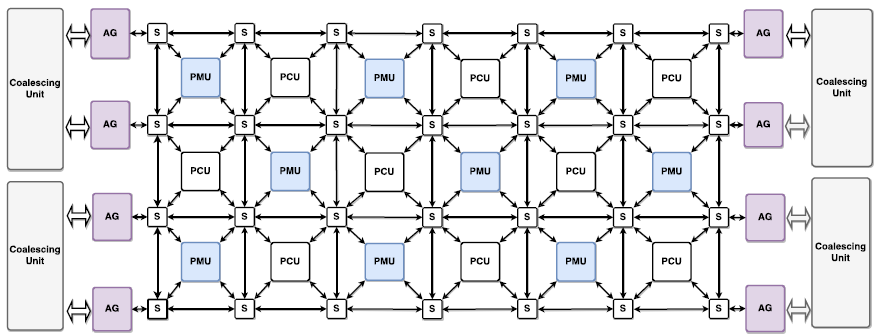
採用可重構設計的還有清華大學微電子系設計的Thinker晶片,具體可參考A High Energy Efficient Reconfigurable Hybrid Neural Network Processor for Deep Learning Applications(Ref11)。這樣的具有靈活互聯結構的可重構加速器,可以支援矩陣-矩陣乘法,矩陣-向量乘法以及更多的其他計算,具有較強的靈活性。
4.2 標量+矢量+向量的異構加速器
另一種思路是對某些運算做到極致的支援,其他的運算通過CPU或者其他的Core來計算;從華為達芬奇架構,到Google TPU2/3的設計上,都有的體現,華為的達芬奇架構可參見3.1節,Google V2/3的框圖如下
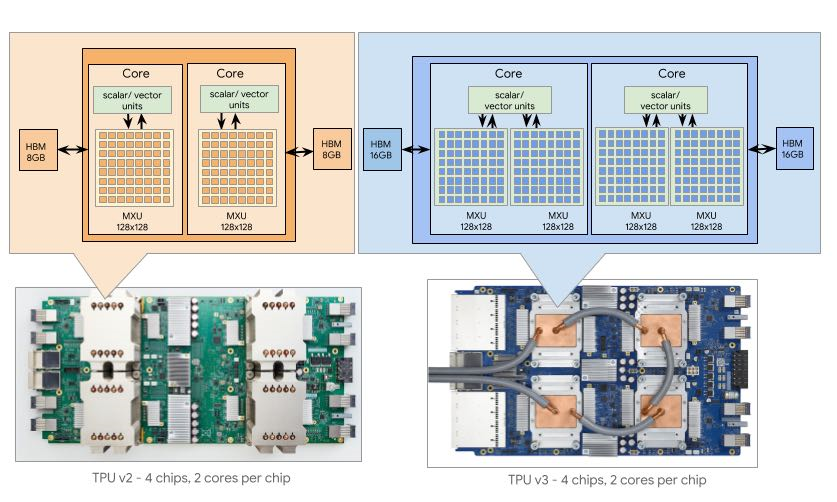
Google的框圖並沒有透露太多的細節,僅僅表面TPU中由於MXU和scalar/vector units;華為的達芬奇架構則指出了
- Vector:2048bit vector with special functions(activation functions,NMS,ROI,SORT)
- Cube:4096 FP16 MACs
雖然Vector Unit似乎並不能計算FC Layer或者Depthwise Conv Layer,但這也代表了一種設計方向。當採用3D Matrix Unit進行矩陣計算時,隨著(N)取值的增加,數據輸入頻寬隨(N^2)增長,而MACs的數量隨(N^3)增長,這表面針對特定的計算進行優化結果可能會更優。當然,這樣的設計也有一些缺陷
- 不同計算單元之間負載可能不均衡,導致計算出現瓶頸
- 不同計算單元之間的數據傳輸,調度會變得複雜
當然,這種設計思想並不意味一個加速Core只能加速很受限的計算類型,依舊可以對單個的加速Core進行兼容設計,本節的討論和4.1並不完全衝突。譬如依舊有一些簡單方法可以讓一個三維的MAC陣列(類似Cube Core)同時支援GEMM和GEMV操作,但依舊會有一些限制,由於數據復用的不同,這兩類運算始終落在Roofline模型的不同位置。
但不管從哪個角度去解決面臨的新的挑戰,暫時都沒有看到一個完美的解決方案。或許我們並不需要一個真正完美的解決方案,能解決一部分問題,創造價值就已經足夠了。這裡引用Cloud TPU(TPU V2/3)的一些說明
Cloud TPU適合以下工作負載
- 由矩陣計算主導的模型
- 主循環內沒有自定義TensorFlow操作的模型
- 需要訓練數周或數月的模型
- 有效批量非常大的大型和極大型模型
Cloud TPU不適合以下工作負載
- 需要頻繁分支或逐項代數主導的現有代數程式
- 稀疏方式訪問記憶體的工作負載可能不適用於TPU
- 需要高精度演算法的工作負載
顯然,Cloud TPU聚焦在大型和極大型模型的加速上,輕量化模型不在考慮範圍之內;Cloud TPU甚至明確指出了暫不支援Depthwise Convolution計算。但這些都不影響Cloud TPU的應用和創造價值。
而正因為沒有完美的設計,選擇和取捨會變得尤為重要。
5. 神經網路中數據復用的展望
雖然在AI晶片設計過程中,都針對演算法進行了深度的優化;同時演算法也針對晶片實現進行了定點化和低比特量化等工作:這些看似是一個聯合優化的過程。但是歸根到底,既然是選擇為AI應用設計晶片,在設計過程中,演算法永遠佔主導地位。從長遠來看,還需要把握演算法的發展趨勢。
站在硬體設計的角度來看,由於在電腦誕生之初就有了高性能並行計算的需求,很多設計實際上以及出現了很長時間,譬如數據並行的向量體系結構,VLIW,脈動陣列,稀疏計算都有40年以上的歷史,2D Mesh互聯也至少有30年。從設計上看,新的東西並不是很多,架構成功的關鍵在於是否順應了時代的潮流,包括演算法/需求的發展和底層硬體技術的發展。
在發展過程中演算法和現有的硬體上的分歧往往是存在的,以本文討論的卷積計算的數據復用為例,這和網路稀疏化的發展方向相悖。如果以極度稀疏化為目標,那麼網路計算過程中的數據復用會越來越低。
神經網路中數據復用的未來如何,完全取決於演算法的發展。
參考
- Hardware Accelerators for Machine Learning (CS 217)
- volta-architecture-whitepaper.pdf
- Scalable unified architecture for Neural Network computing (Hotchips 31)
- In-Datacenter Performance Analysis of a Tensor Processing Unit
- ACCELERATED MATHEMATICAL ENGINE(Telsa,US20190026078)
- V. Sze, T.-J. Yang, Y.-H. Chen, J. Emer, "Efficient Processing of Deep Neural Networks: A Tutorial and Survey," Proceedings of the IEEE, vol. 105, no. 12, pp. 2295-2329, December 2017
- Y.-H. Chen, T. Krishna, J. Emer, V. Sze, "Eyeriss: An Energy-Efficient Reconfigurable Accelerator for Deep Convolutional Neural Networks," IEEE Journal of Solid State Circuits (JSSC), ISSCC Special Issue, Vol. 52, No. 1, pp. 127-138, January 2017.
- Y.-H. Chen, T.-J Yang, J. Emer, V. Sze, "Eyeriss v2: A Flexible Accelerator for Emerging Deep Neural Networks on Mobile Devices," to appear in IEEE Journal on Emerging and Selected Topics in Circuits and Systems (JETCAS), June 2019.
- Zhang J , Franchetti F , Low T M . High Performance Zero-Memory Overhead Direct Convolutions[J]. 2018.
- 華為在hotchips詳細介紹了達芬奇架構
- Prabhakar R, Zhang Y, Koeplinger D, et al. Plasticine: A Reconfigurable Architecture For Parallel Paterns[C]// Acm/ieee International Symposium on Computer Architecture. 2017.
- A High Energy Efficient Reconfigurable Hybrid Neural Network Processor for Deep Learning Applications[J]. IEEE Journal of Solid-State Circuits, 2018, 53(4):968-982.