【Redis】Redis 持久化之 RDB 與 AOF 詳解
一、Redis 持久化
我們知道Redis的數據是全部存儲在記憶體中的,如果機器突然GG,那麼數據就會全部丟失,因此需要有持久化機制來保證數據不會一位宕機而丟失。Redis 為我們提供了兩種持久化方案,一種是基於快照,另外一種是基於 AOF 日誌。接下來就來了解一下這兩種方案。
1. 作業系統與磁碟
首先我們需要知道 Redis 資料庫在持久化中扮演了什麼樣的角色,為此我們先來了解數據從 Redis 中到磁碟的這一過程:
- 客戶端向資料庫發起 write 指令(數據在客戶端的記憶體中);
- 資料庫收到 write 指令和對應的寫數據(數據在服務端記憶體中);
- 資料庫調用將數據寫入磁碟的系統調用函數(數據在系統內核緩衝區);
- 作業系統將寫入緩衝區中的數據寫到磁碟控制器中(數據在磁碟緩衝區中);
- 磁碟控制器將磁碟緩衝區中的數據寫入磁碟的物理介質中(數據真正寫入磁碟中)。
上面只是簡要介紹了一下過程,畢竟真實的快取級別只會比這更多。不過我們可以從上面了解到,資料庫在持久化的過程中主要應該去實現步驟3,也就是將原本在記憶體中的數據持久化到作業系統的內核緩衝區中。至於下面的兩步,則是作業系統需要關心的事,資料庫無能為力。資料庫通常僅在必要的時候會去調用將數據從記憶體寫入磁碟的系統調用。
2. 持久化方案
對於上面我們所述的持久化過程,Redis 提供了以下幾種不同的持久化方案:
- 利用 RDB 持久化在指定的時間間隔生成數據集的時間點快照(point-in-time );
- 利用 AOF 持久化將伺服器收到的所有寫操作命令記錄下來,並在伺服器重新啟動的時候,利用這些命令來恢複數據集。AOF 的命令使用的是與 Redis 本身協議的命令一致,通過追加的方式將數據寫入備份文件中,同時當備份文件過大時,Redis 也能對備份文件進行重壓縮。
- 如果僅希望數據只在資料庫運行時存在,那麼還可以完全禁用掉持久化機制;
- Redis還可以同時使用 AOF 持久化和 RDB 持久化。在這種情況下,當 AOF 重啟時,會優先使用 AOF 文件去恢復原始數據。因為 AOF 中保存的數據通常比 RDB 中保存的數據更加完整。
接下來就重點講解 RDB 持久化方案與 AOF 持久化方案之間的異同。
二、RDB 持久化
RDB(Redis Database) 通過快照的形式將數據保存到磁碟中。所謂快照,可以理解為在某一時間點將數據集拍照並保存下來。Redis 通過這種方式可以在指定的時間間隔或者執行特定命令時將當前系統中的數據保存備份,以二進位的形式寫入磁碟中,默認文件名為dump.rdb。
RDB 的觸發有三種機制,執行save命令;執行bgsave命令;在redis.config中配置自動化。
1. save 觸發
Redis是單執行緒程式,這個執行緒要同時負責多個客戶端套接字的並發讀寫操作和記憶體結構的邏輯讀寫。而save命令會阻塞當前的Redis伺服器,在執行該命令期間,Redis無法處理其他的命令,直到整個RDB過程完成為止,用一張圖描述以下:

當這條指令執行完畢,將RDB文件保存下來後,才能繼續去響應請求。這種方式用於新機器上數據的備份還好,如果用在生產上,那麼簡直是災難,數據量過於龐大,阻塞的時間點過長。這種方式並不可取。
2. bgsave 觸發
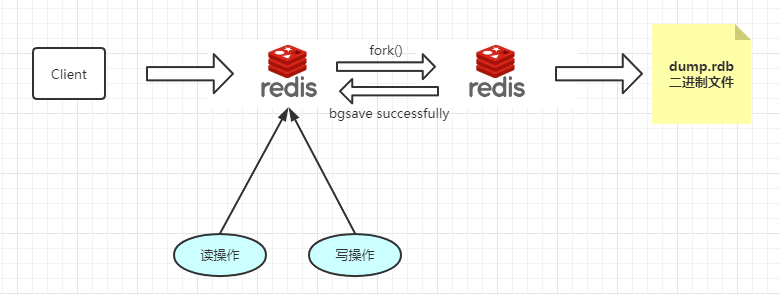
為了不阻塞線上的業務,那麼Redis就必須一邊持久化,一邊響應客戶端的請求。所以在執行bgsave時可以通過fork一個子進程,然後通過這個子進程來處理接下來所有的保存工作,父進程就可以繼續響應請求而無需去關心I/O操作。
3. redis.config 配置
上述兩種方式都需要我們在客戶端中去執行save或者bgsave命令,在生產情況下我們更多地需要是自動化的觸發機制,那麼Redis就提供了這種機制,我們可以在redus.config中對持久化進行配置:
################################ SNAPSHOTTING  ################################
#
# Save the DB on disk:
#
#   save <seconds> <changes>
#
#   Will save the DB if both the given number of seconds and the given
#   number of write operations against the DB occurred.
#
#   In the example below the behaviour will be to save:
#   after 900 sec (15 min) if at least 1 key changed
#   after 300 sec (5 min) if at least 10 keys changed
#   after 60 sec if at least 10000 keys changed
#
#   Note: you can disable saving completely by commenting out all "save" lines.
#
#   It is also possible to remove all the previously configured save
#   points by adding a save directive with a single empty string argument
#   like in the following example:
#
#   save ""

save 900 1
save 300 10
save 60 10000
像上述這樣在redis.config中進行配置,如save 900 1 是指在 900 秒內,如果有一個或一個以上的修改操作,那麼就自動進行一次自動化備份;save 300 10同樣意味著在 300 秒內如果有十次或以上的修改操作,那麼就進行數據備份,依次類推。
如果你不想進行數據持久化,只希望數據只在資料庫運行時存在於記憶體中,那麼你可以通過 save ""禁止掉數據持久化。
這裡再介紹幾個在配置文件中與 RDB 持久化相關的係數:
stop-writes-on-bgsave-error:默認值為yes,即當最後一次 RDB 持久化保存文件失敗後,拒絕接收數據。這樣做的好處是可以讓用戶意識到數據並沒有被成功地持久化,避免後續更嚴重的業務問題的發生;rdbcompression:默認值為yes,即代表將存儲到磁碟中的快照進行壓縮處理;rdbchecksum:默認值為yes,在快照存儲完成後,我們還可以通過CRC64演算法來對數據進行校驗,這會提升一定的性能消耗;dbfilename:默認值為dump.rdb,即將快照存儲命名為dump.rdb;dir:設置快照的存儲路徑。
4. COW機制
先前提到了Redis為了不阻塞線上業務,所以需要一邊持久化一邊響應客戶端的請求,因此fork出一個子進程來處理這些保存工作。那麼具體這個fork出來的子進程是如何做到使得Redis可以一邊做持久化操作,一邊做響應工作呢?這就涉及到COW (Copy On Write)機制,那我們具體講解以下這個COW機制。
Redis在持久化的時候會去調用glibc的函數fork出一個子進程,快照持久化完成交由子進程來處理,父進程繼續響應客戶端的請求。而在子進程剛剛產生時,它其實使用的是父進程中的程式碼段和數據段。所以fork之後,kernel會將父進程中所有的記憶體頁的許可權都設置為read-only,然後子進程的地址空間指向父進程的地址空間。當父進程寫記憶體時,CPU硬體檢測到記憶體頁是read-only的,就會觸發頁異常中斷(page-fault),陷入 kernel 的一個中斷常式。中斷常式中,kernel就會把觸發的異常的頁複製一份,於是父子進程各自持有獨立的一份。而此時子進程相應的數據還是沒有發生變化,依舊是進程產生時那一瞬間的數據,故而子進程可以安心地遍曆數據,進行序列化寫入磁碟了。
隨著父進程修改操作的持續進行,越來越多的共享頁面將會被分離出來,記憶體就會持續增長,但是也不會超過原有數據記憶體的兩倍大小(Redis實例里的冷數據占的比例往往是比較高的,所以很少出現所有頁面都被分離的情況)。
COW機制的好處很明顯:首先可以減少分配和複製時帶來的瞬時延遲,還可以減少不必要的資源分配。但是缺點也很明顯:如果父進程接收到大量的寫操作,那麼將會產生大量的分頁錯誤(頁異常中斷page-fault)。
5. RDB的優劣
相信通過上面內容的講解,對於RDB持久化以該有一個大致的了解,那麼接下來簡單總結下RDB的優勢以及它的劣勢:
優勢:
- RDB 是一個非常緊湊(compact)的文件(保存二進位數據),它保存了 Redis 在某個時間點上的數據集。 這種文件非常適合用於進行備份: 比如說,你可以在最近的 24 小時內,每小時備份一次 RDB 文件,並且在每個月的每一天,也備份一個 RDB 文件。 這樣的話,即使遇上問題,也可以隨時將數據集還原到不同的版本;
- RDB 非常適用於災難恢復(disaster recovery):它只有一個文件,並且內容都非常緊湊,可以(在加密後)將它傳送到別的數據中心;
- RDB 可以最大化 Redis 的性能:父進程在保存 RDB 文件時唯一要做的就是
fork出一個子進程,然後這個子進程就會處理接下來的所有保存工作,父進程無須執行任何磁碟 I/O 操作; - RDB 在恢復大數據集時的速度比 AOF 的恢復速度要快。
劣勢:
- 如果業務上需要盡量避免在伺服器故障時丟失數據,那麼 RDB 並不適合。 雖然 Redis 允許在設置不同的保存點(save point)來控制保存 RDB 文件的頻率, 但是, 由於 RDB 文件需要保存整個數據集的狀態, 所以這個過程並不快,可能會至少 5 分鐘才能完成一次 RDB 文件保存。 在這種情況下, 一旦發生故障停機, 就可能會丟失好幾分鐘的數據。
- 每次保存 RDB 的時候,Redis 都要
fork()出一個子進程,並由子進程來進行實際的持久化工作。 在數據集比較龐大時,fork()可能會非常耗時,造成伺服器在某某毫秒內停止處理客戶端; 如果數據集非常巨大,並且 CPU 時間非常緊張的話,那麼這種停止時間甚至可能會長達整整一秒。 雖然 AOF 重寫也需要進行fork(),但無論 AOF 重寫的執行間隔有多長,數據的耐久性都不會有任何損失。
三、AOF 持久化
The AOF persistence logs every write operation received by the server, that will be played again at server startup, reconstructing the original dataset. Commands are logged using the same format as the Redis protocol itself, in an append-only fashion. Redis is able to rewrite the log in the background when it gets too big.
RDB 持久化是全量備份,比較耗時,所以Redis就提供了一種更為高效地AOF(Append Only-file)持久化方案,簡單描述它的工作原理:AOF日誌存儲的是Redis伺服器指令序列,AOF只記錄對記憶體進行修改的指令記錄。
在伺服器從新啟動時,Redis就會利用 AOF 日誌中記錄的這些操作從新構建原始數據集。
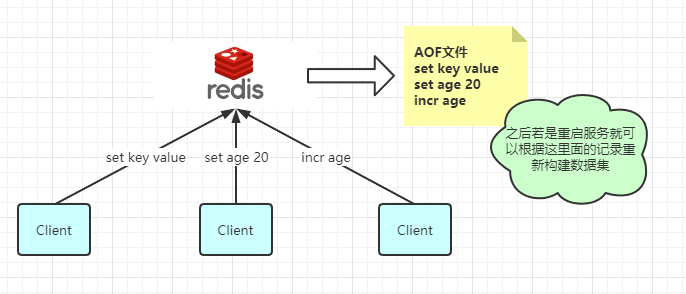
Redis會在收到客戶端修改指令後,進行參數修改、邏輯處理,如果沒有問題,就立即將該指令文本存儲到 AOF 日誌中,也就是說,先執行指令才將日誌存檔。這點不同於 leveldb、hbase等存儲引擎,它們都是先存儲日誌再做邏輯處理。
1. AOF 的觸發配置
AOF也有不同的觸發方案,這裡簡要描述以下三種觸發方案:
- always:每次發生數據修改就會立即記錄到磁碟文件中,這種方案的完整性好但是IO開銷很大,性能較差;
- everysec:在每一秒中進行同步,速度有所提升。但是如果在一秒內宕機的話可能失去這一秒內的數據;
- no:默認配置,即不使用 AOF 持久化方案。
可以在redis.config中進行配置,appendonly no改換為yes,再通過注釋或解注釋appendfsync配置需要的方案:
############################## APPEND ONLY MODE ###############################

# By default Redis asynchronously dumps the dataset on disk. This mode is
# good enough in many applications, but an issue with the Redis process or
# a power outage may result into a few minutes of writes lost (depending on
# the configured save points).
#
# The Append Only File is an alternative persistence mode that provides
# much better durability. For instance using the default data fsync policy
# (see later in the config file) Redis can lose just one second of writes in a
# dramatic event like a server power outage, or a single write if something
# wrong with the Redis process itself happens, but the operating system is
# still running correctly.
#
# AOF and RDB persistence can be enabled at the same time without problems.
# If the AOF is enabled on startup Redis will load the AOF, that is the file
# with the better durability guarantees.
#
# Please check //redis.io/topics/persistence for more information.

appendonly no

# The name of the append only file (default: "appendonly.aof")

appendfilename "appendonly.aof"

# ... 省略

# appendfsync always
appendfsync everysec
# appendfsync no
2. AOF 重寫機制
隨著Redis的運行,AOF的日誌會越來越長,如果實例宕機重啟,那麼重放整個AOF將會變得十分耗時,而在日誌記錄中,又有很多無意義的記錄,比如我現在將一個數據 incr 一千次,那麼就不需要去記錄這1000次修改,只需要記錄最後的值即可。所以就需要進行 AOF 重寫。
Redis 提供了bgrewriteaof指令用於對AOF日誌進行重寫,該指令運行時會開闢一個子進程對記憶體進行遍歷,然後將其轉換為一系列的 Redis 的操作指令,再序列化到一個日誌文件中。完成後再替換原有的AOF文件,至此完成。
同樣的也可以在redis.config中對重寫機制的觸發進行配置:
通過將no-appendfsync-on-rewrite設置為yes,開啟重寫機制;auto-aof-rewrite-percentage 100意為比上次從寫後文件大小增長了100%再次觸發重寫;
auto-aof-rewrite-min-size 64mb意為當文件至少要達到64mb才會觸發制動重寫。
# ... 省略

no-appendfsync-on-rewrite no

# Automatic rewrite of the append only file.
# ... 省略

auto-aof-rewrite-percentage 100
auto-aof-rewrite-min-size 64mb
重寫也是會耗費資源的,所以當磁碟空間足夠的時候,這裡可以將 64mb 調整更大寫,降低重寫的頻率,達到優化效果。
3. fsync 函數
再將AOF配置為appendfsync everysec之後,Redis在處理一條命令後,並不直接立即調用write將數據寫入 AOF 文件,而是先將數據寫入AOF buffer(server.aof_buf)。調用write和命令處理是分開的,Redis只在每次進入epoll_wait之前做 write 操作。
/* Write the append only file buffer on disk.
 *
 * Since we are required to write the AOF before replying to the client,
 * and the only way the client socket can get a write is entering when the
 * the event loop, we accumulate all the AOF writes in a memory
 * buffer and write it on disk using this function just before entering
 * the event loop again.
 *
 * About the 'force' argument:
 *
 * When the fsync policy is set to 'everysec' we may delay the flush if there
 * is still an fsync() going on in the background thread, since for instance
 * on Linux write(2) will be blocked by the background fsync anyway.
 * When this happens we remember that there is some aof buffer to be
 * flushed ASAP, and will try to do that in the serverCron() function.
 *
 * However if force is set to 1 we'll write regardless of the background
 * fsync. */
#define AOF_WRITE_LOG_ERROR_RATE 30 /* Seconds between errors logging. */
void flushAppendOnlyFile(int force) {
    // aofWrite 調用 write 將AOF buffer寫入到AOF文件,處理了ENTR,其它沒什麼
    ssize_t nwritten = aofWrite(server.aof_fd,server.aof_buf,sdslen(server.aof_buf));

        /* Handle the AOF write error. */
        if (server.aof_fsync == AOF_FSYNC_ALWAYS) {
            /* We can't recover when the fsync policy is ALWAYS since the
         	 * reply for the client is already in the output buffers, and we
         	 * have the contract with the user that on acknowledged write data
         	 * is synced on disk. */
            serverLog(LL_WARNING,"Can't recover from AOF write error when the AOF fsync policy is 'always'. Exiting...");
            exit(1);
        } else {
            return; /* We'll try again on the next call... */
        } else {
            /* Successful write(2). If AOF was in error state, restore the
         * OK state and log the event. */
        }

        /* Perform the fsync if needed. */
        if (server.aof_fsync == AOF_FSYNC_ALWAYS) {
            // redis_fsync是一個宏,Linux實際為fdatasync,其它為fsync
            // 所以最好不要將redis.conf中的appendfsync設置為always,這極影響性能
            redis_fsync(server.aof_fd); /* Let's try to get this data on the disk */
        }

    else if ((server.aof_fsync == AOF_FSYNC_EVERYSEC && server.unixtime > server.aof_last_fsync)) {
        // 如果已在sync狀態,則不再重複
        // BIO執行緒會間隔設置sync_in_progress
        // if (server.aof_fsync == AOF_FSYNC_EVERYSEC)
        //     sync_in_progress = bioPendingJobsOfType(BIO_AOF_FSYNC) != 0;
        if (!sync_in_progress)
            // everysec性能並不那麼糟糕,因為它:後台方式執行fsync。
            // Redis並不是嚴格意義上的單執行緒,實際上它創建一組BIO執行緒,專門處理阻塞和慢操作
            // 這些操作就包括FSYNC,另外還有關閉文件和記憶體的free兩個操作。
            // 不像always,EVERYSEC模式並不立即調用fsync,
            // 而是將這個操作丟給了BIO執行緒非同步執行,
            // BIO執行緒在進程啟動時被創建,兩者間通過bio_jobs和bio_pending兩個
            // 全局對象交互,其中主執行緒負責寫,BIO執行緒負責消費。
            aof_background_fsync(server.aof_fd);
        server.aof_last_fsync = server.unixtime;
    }
}
Redis另外的兩種策略,一個是永不調用 fsync,讓作業系統來決定合適同步磁碟,這樣做很不安全;另一個是來一個指令就調用 fsync 一次,這種導致結果非常慢。這兩種策略在生產環境中基本都不會使用,了解一下即可。
4. AOF 的優劣
- AOF 持久化的默認策略為每秒鐘
fsync一次,在這種配置下,Redis 仍然可以保持良好的性能,並且就算髮生故障停機,也最多也只會丟失掉一秒鐘內的數據; - AOF 文件是一個只進行追加操作的日誌文件(append only log), 因此對 AOF 文件的寫入不需要進行
seek, 即使日誌因為某些原因而包含了未寫入完整的命令(比如寫入時磁碟已滿,寫入中途停機,等等),redis-check-aof工具也可以輕易地修復這種問題。 - Redis 可以在 AOF 文件體積變得過大時,自動地在後台對 AOF 進行重寫: 重寫後的新 AOF 文件包含了恢復當前數據集所需的最小命令集合。 整個重寫操作是絕對安全的,因為 Redis 在創建新 AOF 文件的過程中,會繼續將命令追加到現有的 AOF 文件裡面,即使重寫過程中發生停機,現有的 AOF 文件也不會丟失。 而一旦新 AOF 文件創建完畢,Redis 就會從舊 AOF 文件切換到新 AOF 文件,並開始對新 AOF 文件進行追加操作。
- AOF 文件有序地保存了對資料庫執行的所有寫入操作, 這些寫入操作以 Redis 協議的格式保存, 因此 AOF 文件的內容非常容易被人讀懂, 對文件進行分析(parse)也很輕鬆。 導出(export) AOF 文件也非常簡單: 舉個例子, 如果你不小心執行了 FLUSHALL 命令, 但只要 AOF 文件未被重寫, 那麼只要停止伺服器, 移除 AOF 文件末尾的 FLUSHALL 命令, 並重啟 Redis , 就可以將數據集恢復到 FLUSHALL 執行之前的狀態。
AOF 的缺點
- 對於相同的數據集來說,AOF 文件的體積通常要大於 RDB 文件的體積。
- 根據所使用的
fsync策略,AOF 的速度可能會慢於 RDB 。 在一般情況下, 每秒fsync的性能依然非常高, 而關閉fsync可以讓 AOF 的速度和 RDB 一樣快, 即使在高負荷之下也是如此。 不過在處理巨大的寫入載入時,RDB 可以提供更有保證的最大延遲時間(latency)。 - AOF 在過去曾經發生過這樣的 bug : 因為個別命令的原因,導致 AOF 文件在重新載入時,無法將數據集恢復成保存時的原樣。
四、混合持久化
重啟 Redis 時,如果使用 RDB 來恢復記憶體狀態,會丟失大量數據。而如果只使用 AOF 日誌重放,那麼效率又太過於低下。Redis 4.0 提供了混合持久化方案,將 RDB 文件的內容和增量的 AOF 日誌文件存在一起。這裡的 AOF 日誌不再是全量的日誌,而是自 RDB 持久化開始到持久化結束這段時間發生的增量 AOF 日誌,通常這部分日誌很小。

於是在 Redis 重啟的時候,可以先載入 RDB 的內容,然後再重放增量 AOF 日誌,就可以完全替代之前的 AOF 全量重放,重啟效率因此得到大幅提升。
參考文章:
- 【Redis Persistence】;
- 【Redis persistence demystified】;
- 【Redis的appendfsync參數詳解】;
- 《Redis深度歷險 核心原理與應用實踐》;