[斯坦福大學2014機器學習教程筆記]第六章-代價函數(Cost function)
在這節中主要講的是如何更好地擬合邏輯回歸模型的參數θ.具體來說,要定義用來擬合參數的優化目標或者叫代價函數,這便是監督學習問題中的邏輯回歸模型的擬合問題。
我們有一個訓練集,訓練集中有m個訓練樣本:{(x(1),y(1)),(x(2),y(2)),...,(x(m),y(m))},像之前一樣,每個樣本用n+1維特徵向量表示,如下:
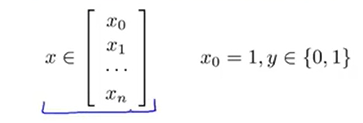
和以前一樣x0=1,第0個特徵一直是1.而且因為這是一個分類問題的訓練集,所以所有的標籤y不是0就是1.假設函數如下所示,它的參數是θ.
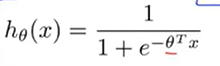
下面要講的問題是,對於這個函數如何選定合適的參數θ.
回歸一下之前講線性回歸模型的時候,使用了如下的代價函數。
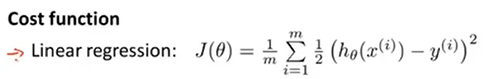
下面將對這個函數換一種寫法:
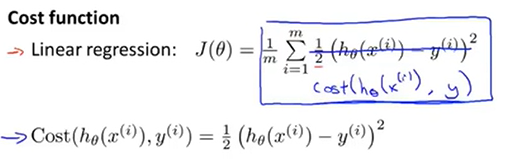
那麼此時代價函數等於1/m * 這個Cost項在訓練集範圍上的求和。可以除去上標來對該公式簡化。它是在輸出的預測值是h(x),但實際值是y的時候我們的學習演算法付出的代價。去掉上標之後,這個代價值就是 1/2 * 預測值與實際值差的平方。這個代價函數在線性回歸裡面是十分好用的,但是我們現在要用在邏輯回歸里。如果我們要最小化代價函數J,它也能工作。但是如果我們這樣做的話它就會變成參數θ的非凸函數。
當我們把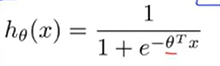 代入J(θ)中,因為hθ(x)是一個很複雜的非線性函數,我們很有可能得到的函數影像如下,它有很多局部最優值。
 代入J(θ)中,因為hθ(x)是一個很複雜的非線性函數,我們很有可能得到的函數影像如下,它有很多局部最優值。
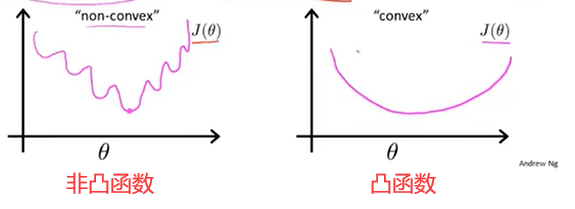
如果我們對非凸函數用梯度下降法,並不能保證可以收斂到全局最小值。我們更希望得到的是一個凸函數,這樣對它使用梯度下降法的話就可以收斂到該函數的全局最小值。所以,我們重新定義這個演算法要付出的代價。
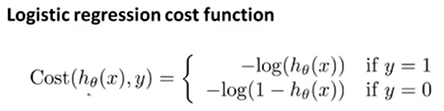
這看起來是一個很複雜的函數,我們畫出這個函數。影像如下:
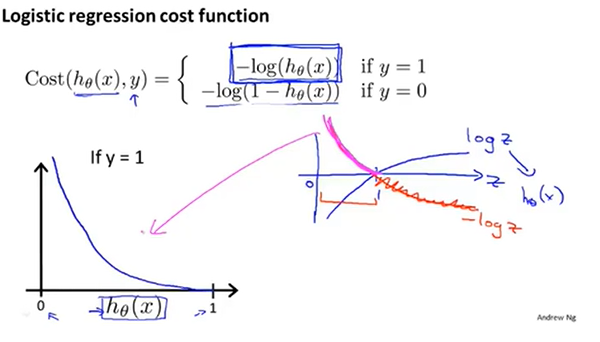
這個函數的性質有:
如果y=1而且hθ(x)=1,那麼代價值就為0.但是如果y=1但是預測值hθ(x)=0的時候,此時代價值趨於∞.
上面為y=1的情況。下面來看y=0的情況。
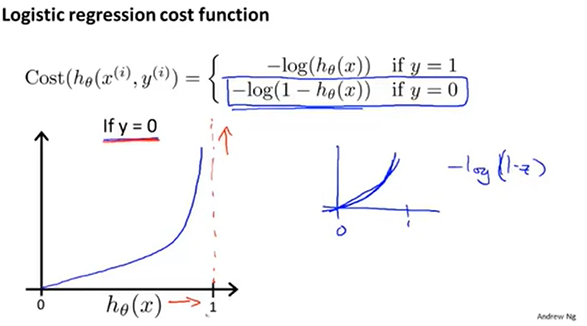
當實際值y=0時,預測值hθ(x)=0的情況下付出的代價值就為0,預測值hθ(x)=1的情況下付出的代價值趨於∞.以上講的主要是單訓練樣本的代價函數。下面將將其推廣得到整個訓練樣本的代價函數,接著對其運用梯度下降法。
python程式碼:
1 import numpy as np
2 def cost(theta, X, y):
3   theta = np.matrix(theta)
4   X = np.matrix(X)
5   y = np.matrix(y)
6   first = np.multiply(-y, np.log(sigmoid(X* theta.T)))
7   second = np.multiply((1 - y), np.log(1 - sigmoid(X* theta.T)))
8   return np.sum(first - second) / (len(X))

