提高「性能」的主要方式是優化,而優化的其中一個主要手段就是添加快取!
在軟體工程里有這麼一句話:「沒有銀彈」!就是說由於軟體工程的複雜性,沒有任何一種技術或方法能解決所有問題!軟體工程是複雜的,沒有銀彈!但是,軟體工程中的某一個問題,是有銀彈的!
「 電腦科學領域的任何問題都可以通過增加一個間接的中間層來解決」!而「快取層」可以說是添加得最多的層!主要目的就是為了提高性能!所以,快取可以說是「性能銀彈」!
本文將探討如下內容:
- 快取的作用
- 快取的種類
- 快取演算法
- 分散式快取
- 快取的使用
- 網路中的快取
- 應用快取
- 資料庫快取
- 電腦中的快取
從程式碼說起
fn longRunningOperations(){ ... // 很耗時}let result = longRunningOperations();// do other thing
我們來看上面這段偽程式碼,longRunningOperations是個很耗時的方法(調用一次要幾十秒甚至幾分鐘),比如:
- 複雜的業務邏輯計算
- 複雜的數據查詢
- 耗時的網路操作等
對於這個方法,如果每次都去調用一次的話,會非常的影響性能,用戶體驗也非常的不好。
那我們該如何處理呢?
一般有幾種優化方案:
- 優化業務程式碼,比如:更快的數據結構和演算法,更快的IO模型,建立資料庫索引等
- 簡化業務邏輯,導致耗時的原因可能是業務過於複雜,可以通過簡化業務邏輯的方式來減少耗時
- 將操作的結果存儲起來。例如:對於某些統計類的結果,可以先用日終定時的去執行,將結果存儲到統計結果表中,查找時,直接從結果中查詢即可;對於某些臨時操作,可以將結果存儲在記憶體中,再次調用時,直接從記憶體中獲取即可。
本文主要聊聊第三種方案:使用「快取」!
主動快取與被動快取
一般我們使用快取來存儲一些內容,這些內容有如下一些特點(符合一條或多條):
- 使用較頻繁
- 變更不頻繁
- 獲取較耗時
- 多系統訪問
比如,
- 字典數據:系統很多地方都會使用字典數據,而字典數據配置完成後一般不會修改,雖然從資料庫中直接獲取字典數據不是很耗時,但是多了查詢和網路傳輸,性能上還是不如直接從快取裡面取快速
- 秒殺商品資訊:在秒殺時訪問量很大,從快取(靜態文件、CDN等)獲取要比從資料庫查詢要快得多
- 其它訪問頻次較多的資訊:此處的其它資訊是因為其快取的處理方式與上面的字典處理有差異,下面詳細說明。
對於字典數據來說,一般我們的做法是在系統啟動時,將字典數據直接載入到快取中,此類快取數據一般沒有過期時間;當修改字典時,會同時更新快取中的內容。此類快取稱為「主動快取」,因為其快取數據是由用戶的主動修改來觸發更新的。
而對於某些資訊來說,因為資訊量太大,不能一次性全部載入到快取中,且也不是太清楚哪些數據訪問頻次高、哪些數據訪問頻次低。對於這樣的數據,一般的做法是:
- 先到快取中查找是否有訪問的數據,如果有則直接返回給用戶
- 如果沒有,則去溯源查找
- 找到後將其添加到快取中
- 最後返回給用戶
此類快取稱為「被動快取」!其快取的數據的過期由系統來控制。那系統如何控制呢?這就涉及到快取置換演算法!
快取置換演算法
上面說了,對於被動快取來說,由於資訊量太大,數據不能一次全部載入到快取中,當快取滿了以後,需要新增數據時,就需要確定哪些數據要從快取里清除,給新數據騰出空間。
用於判斷哪些數據優先從快取中剔除的演算法稱為「快取(頁面)置換演算法」!
Wiki中列出了如下置換演算法:
- RR(Random replacement)
- FIFO(First in first out)
- LIFO(Last in first out)
- MRU(Most recently used)
- LFU(Least-frequently used)
- LRU(Least recently used)
- TLRU(Time aware least recently used)
- PLRU(Pseudo-LRU)
- LRU-K
- SLRU(Segmented LRU)
- MQ(Multi queue)
- LFRU(Least frequent recently used)
- LFUDA(LFU with dynamic aging)
- LIRS(Low inter-reference recency set)
- ARC(Adaptive replacement cache)
- CAR(Clock with adaptive replacement)
- Pannier(Container-based caching algorithm for compound objects)
一般情況下我們不會自己去實現個快取,市面上有不少開源的快取中間件,比如:redis,memcached。這裡只簡單的梳理幾個常用的置換演算法。
FIFO
FIFO應該算是最簡單的置換演算法了:
- 它使用一個隊列來維護數據
- 數據按照載入到快取的順序進行排列,先載入的數據在隊列頭部,後載入的數據在隊列尾部
- 當快取滿了以後,從隊列頭部清除數據,給需要載入的數據騰出空間
- 新數據加到隊列的尾部
FIFO的實現很簡單,但是其性能並不總是很好。舉個簡單的例子,假設一個系統需要10個快取數據,恰巧此時5個數據在隊列頭部,另外5個數據不在快取中,又恰巧此時隊列又滿了。按照FIFO演算法,5條不在記憶體中的數據被載入到了快取中,而之前的5條數據被清除了。這就需要再次將被清除的5條數據載入到快取中。這就影響了性能。
這個問題可能會隨著所分配的快取大小的增加而增加,原本我們使用快取是為了提高性能的,現在可能會影響性能,這種現象稱為「Belady現象」!
LIFO和FIFO很類似,這裡就不贅述了。
LRU
目前比較常用的置換演算法稱為LRU置換演算法:優先替換掉「最近最少使用」的數據
- 每個數據都被關聯了該數據上次使用的時間
- 當需要置換數據的時候,LRU選擇最長時間沒有使用的數據
LRU的變體有很多,例如:
- TLRU(Time aware least recently used):大部分快取數據是有過期時間的。PLRU從最少使用和過期時間兩個維度來置換數據
- LRU-K:多維護一個隊列,用於記錄所有快取數據被訪問的次數。當數據的訪問次數達到K次的時候,才將數據放入快取。當需要淘汰數據時,LRU-K會淘汰第K次訪問時間距當前時間最大的數據。
- SLRU(Segmented LRU)2Queue?:一個FIFO隊列,一個LRU隊列。當數據第一次訪問時,將數據快取在FIFO隊列裡面,當數據第二次被訪問時,則將數據從FIFO隊列移到LRU隊列裡面,兩個隊列各自按照自己的方法淘汰數據。
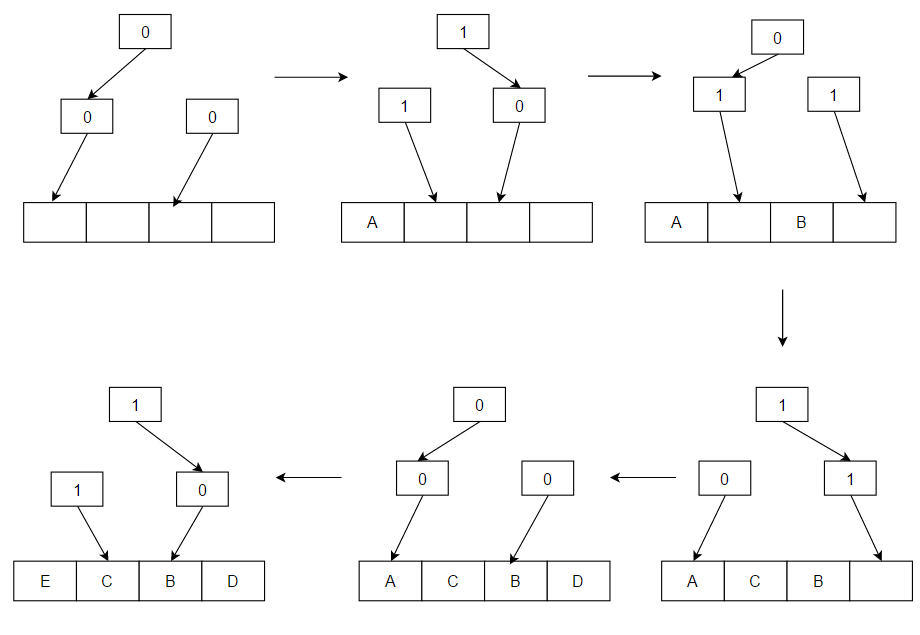
- PLRU(Pseudo-LRU):LRU需要維護數據訪問時間,佔用了額外的空間,對於空間很小的設備來說,此演算法太過浪費空間了。PLRU每個快取數據只需要1bit來存儲數據資訊,可以達到LRU的效果。具體流程見下圖:
還有和LRU類似的MRU,LFU這裡不在贅述!
快取集群
為了提高快取的可用性,一般我們至少會對快取做個主備,即一個主快取,一個從快取。
- 快取的寫入只可以寫到主快取
- 主快取同步數據到從快取中
- 可以從主快取讀取數據。也可以從從快取讀取數據(不必須)
- 當主快取掛掉了,從快取升級為主快取
再安全一點的做法就是做快取集群:
- 多台機器快取了相同的數據,其中一台為主快取
- 快取的寫入只可以寫到主快取
- 主快取同步數據到其它快取
- 可以從主快取讀取數據。也可以從其它快取中讀取數據(不必須)
- 當主快取掛掉了,會從其它快取服務中選擇一個作為新的主快取
分散式快取
無論是單機快取,主從備份還是快取集群,都沒法解決快取大小限制的問題。因為一般快取會使用記憶體,而一台機器的記憶體大小是有限的。當需要快取的數據遠遠超過一台機器的記憶體大小的時候,就需要將快取的數據分布到多台機器上。每台機器只快取一部分數據,這就是分散式快取。
分散式快取可以解決一台機器快取數據有限的問題,但是也引入了新的問題:
- 哪些數據該快取在哪台伺服器上
- 如何保證每台伺服器快取的數據量基本相同
一般做法是對key進行hash,然後對伺服器數量進行取余,來確定數據在哪台伺服器上。這解決了「哪些數據該快取在哪台伺服器上」的問題,但是卻無法保證「每台伺服器快取的數據量基本相同」,因為可能多個key的hash取余後都落到了同一個伺服器上,這就可能導致其中一台伺服器快取的數量很多,其它伺服器快取的數據量很少。快取數據量多的伺服器可能會記憶體不夠用,觸發數據置換,進而導致性能下降。
可以使用一致性hash環來保證伺服器快取的數據量基本相同,大致邏輯如下:
- 將0~2^32個點均勻分配到一個圓上
- 每個點對應一台快取伺服器
- 快取伺服器數量是遠小於2^32個的,所以多個節點對應一台快取伺服器,多出來的節點稱為虛擬節點
- 確保快取伺服器的分布均勻
- 同樣是對key進行hash
- 對2^32進行求余
- 結果對應到hash環上
- 如果正好落到節點上,則數據就快取到對應的快取伺服器上
- 否則就存到落點前面的那個節點所對應的快取伺服器上
無處不在的快取
上面聊的主要是應用快取,實際上,快取無處不在。
下面通過我們訪問網站的流程,來簡單梳理一下,整個過程中,哪些地方可能會用到快取。
網路快取
當我們在瀏覽器中輸入URL,按下回車後。
首先,需要查找域名所對應的IP!這裡就有各種快取!
- 瀏覽器快取:瀏覽器會快取DNS記錄一段時間,首先會從瀏覽器快取里去找對應的IP。
- 系統快取:如果在瀏覽器快取里沒有找到需要的記錄,就會到系統快取中查找記錄
- 路由器快取:如果系統快取中也沒找到,就會到路由器快取中查找記錄
- ISP DNS 快取:如果還是找不到,就到ISP快取DNS的伺服器里查找。在這一般都能找到相應的快取記錄。
- 遞歸搜索:如果上面的快取都找不到,就需要從根域名伺服器開始遞歸查找了
找到IP後,還不一定要發請求,因為你訪問的資源可能之前已經訪問過,已經被快取到了瀏覽器快取中。此時,瀏覽器直接返回快取,而不會發送請求。
如果沒有快取,則發送請求獲取資源。
後面可能會達到CDN。CDN是一種邊緣快取。在用戶訪問網站時,利用GSLB(Global Server Load Balance,全局負載均衡)技術將用戶的訪問指向距離最近的工作正常的快取伺服器上,由快取伺服器直接響應用戶請求。如果CDN中找不到需要的資源,則請求可能就到了反向代理。
某些反向代理能夠做到和用戶來自同一個網路,那麼用戶訪問反向代理伺服器的時候,就會得到很高品質的響應速度,這樣的反向代理快取一般稱為邊緣快取,而CDN在邊緣快取的基礎上,使用了GSLB
一般反向代理有兩個功能:
- 隱藏源伺服器,防止伺服器惡意攻擊。客戶端感知不到代理伺服器和源伺服器的區別
- 快取,將原始伺服器數據進行快取,減少源伺服器的訪問壓力
如果反向代理中也找不到需要的資源,請求才到達源伺服器來獲取資源。
服務端與資料庫快取
一般情況下,Server接收到請求後,會根據請求,組裝出響應,進行返回。這個過程可能需要查詢資料庫、進行業務邏輯計算、頁面渲染等操作。這裡的每一步都可以引入快取。
對於資料庫查詢來說,目前一般的持久化框架都會提供查詢快取。即對於相同的sql,第二次查詢開始,可以不用再查詢資料庫,直接從快取中獲取第一次查詢所返回的數據。節省了調用資料庫查詢的時間消耗。對於某些訪問量很大的數據,也可以將其快取到快取中間件中。後續直接從快取中間件中獲取。
而資料庫本身也有快取!
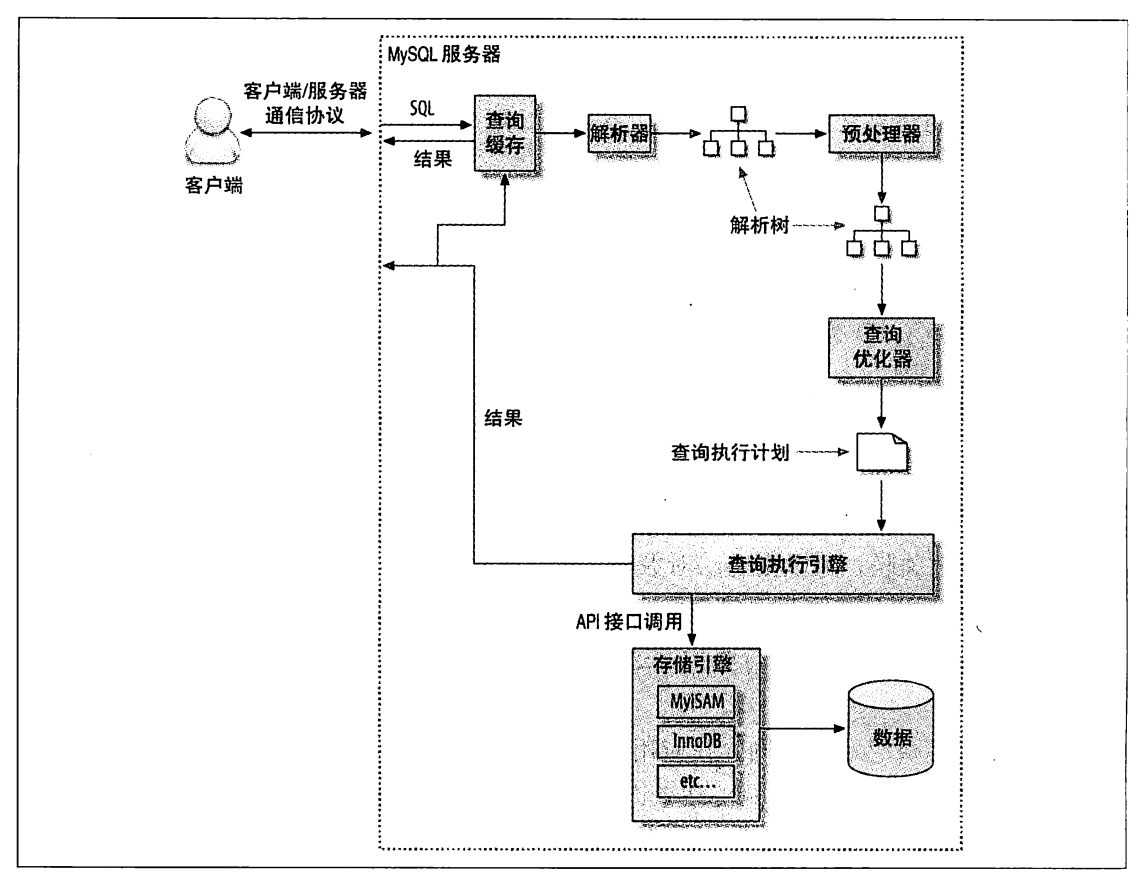
- 客戶端發送一條查詢給服務端
- 服務端檢查查詢快取,如果命中快取,則立刻返回快取中的結果。如果沒找到,則
- 進行sql解析、預處理、再由優化器生成對應的執行計劃
- 根據執行計劃,調用存儲引擎的API執行查詢
- 將結果返回給客戶端
mysql的查詢快取可能會降低效率。首先,寫快取是獨佔模式寫入。其次,假設一個查詢結果被快取了,當涉及到的其中一張表數據更新,該快取都會被置為無效。對於頻繁修改的數據,使用快取就會降低效率。
對於業務邏輯計算來說,如果某些業務邏輯很複雜,那麼可以針對結果進行快取。可以將結果快取到資料庫或快取中間件中。對於相同的參數的請求,第二次請求時,就不必進行計算,直接從快取中返回結果即可。
對於頁面渲染來說,某些訪問量很大的頁面,且數據基本不變的情況下,可以對頁面進行靜態化。即生成靜態的頁面,不必每次訪問的時候都動態生成頁面進行返回,而是預先生成好頁面,將其存到磁碟上,當訪問該頁面的時候,直接從磁碟獲取頁面進行返回即可。或者直接將頁面內容快取到快取中間件中,進一步提高性能。
另外,對於需要登錄的Server來說,用戶資訊其實也是快取下來的。不論是存到伺服器Session中,還是存到了快取中間件中。否則,每次用戶訪問Server都需要到資料庫獲取用戶資訊,會影響Server端性能!
電腦快取
最後,運行系統的電腦本身也有很多的快取!
我們都知道,一般電腦由CPU、記憶體、主板、硬碟、顯示卡、顯示器、滑鼠、鍵盤、網卡等組成!其中存儲類設備包括了:雲存儲(例如:百度雲盤,NAS等)、本地硬碟、記憶體、CPU中的高速快取(我們常說的一級快取、二級快取和三級快取)以及CPU暫存器。它們的速度各異,差異達數個量級。下圖顯示了各個設備的訪問速率。
- CPU暫存器最快,達到1ns,但只能存儲幾百個位元組,造價也最貴
- 高速快取次之,也達到了10ns,可存儲幾十兆,造價次之。其中L1,L2,L3速度越來越慢。
- 然後是記憶體,為100ns,可達GB級別,造價比快取便宜(不過這兩年的記憶體價格貴得離譜)
- 硬碟訪問速率為10ms級別,可達TB級別,造價可以說是白菜價了
- 而雲存儲則達到了秒級,基本可以無限擴展,只要錢夠
我們都知道CPU的高速快取是「快取」,實際上上面的設備,上層設備都可以說是下層設備的「快取」!
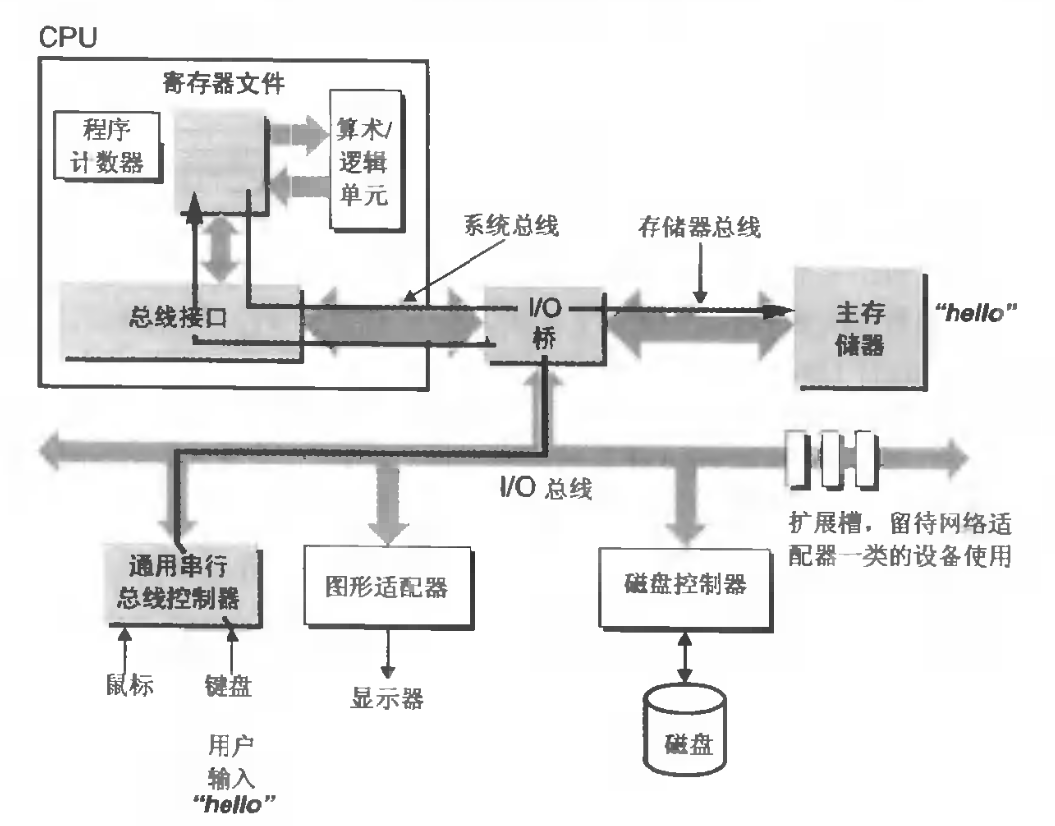
在《深入理解電腦》一書中,簡單的介紹了電腦執行C語言的hello world程式時的電腦流程。
- 通過滑鼠、鍵盤輸入執行命令'./hello'
- 輸入的內容從鍵盤通過匯流排,進入暫存器,在進入記憶體

- 當按下回車後
- 通過DMA技術,將目標文件,從硬碟中直接讀取到記憶體中
- 最後執行程式
- 將hello world拷貝到暫存器
- 再從暫存器拷貝到顯示器顯示
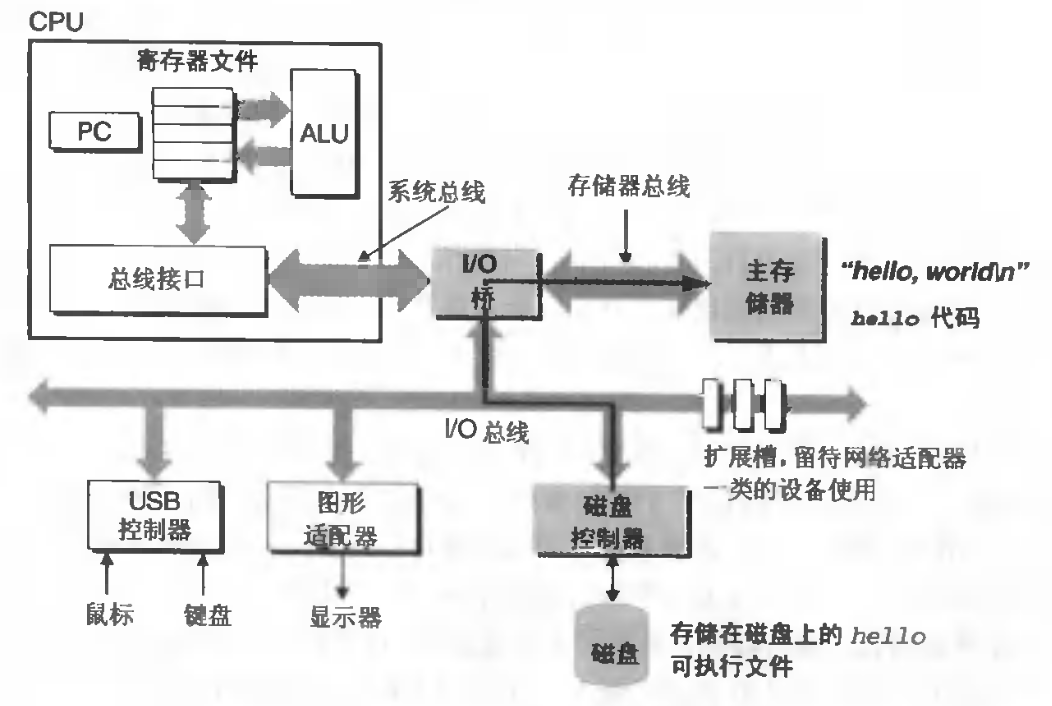
可以看到,絕大部分的操作,都是數據的拷貝!最終被CPU執行,為了數據能更快的到達CPU,就有了一層一層的「快取」!
- CPU暫存器里的數據是直接給CPU使用的,相當於是L1的快取
- L1又是L2的快取,L2又是L3的快取
- L3是記憶體的快取
- 記憶體又是硬碟的快取。例如:一般硬碟中的數據,都需要先載入到記憶體中才能被CPU使用。另外硬碟的「HMB記憶體緩衝技術」,可以借用記憶體作為硬碟的快取。
- 硬碟本身也是有快取的,這是為了減少IO操作,批量的進行讀寫。
- 硬碟也可以是雲存儲的快取。例如在網路不太好的情況下,我們可以把電影先下載下來再看,這樣就不會有卡頓的情況
總結
性能是架構設計時需要著重考慮的一個非功能性約束,而引入快取是提高系統性能的一個簡單且直接的方法。
本文從一個簡單的偽程式碼開始,簡單闡述了,快取的作用,涉及的技術以及目前快取的使用場景,以期能對架構設計提供一些參考。
END
為了更高的交流,歡迎大家關注我的公眾號,掃描下面二維碼即可關注,謝謝:


