Java虛擬機之垃圾回收
- 2019 年 11 月 10 日
- 筆記
簡述
Java與那些較傳統的語言比如C++有個很大不同就是垃圾回收策略了。前者通常是虛擬機自動幫我們做了,而後者就需要我們手動來完成。
Java虛擬機幫我們完成了垃圾回收,是不是意味著我們就不用完全去管它了呢?當然不是的。在很多場景下,虛擬機默認做的並不能使我們滿意。比如某個java應用較大時,頻繁產生GC,就會非常影響我們應用的響應速度。這時候就需要我們根據自身需要,進行相應的調整。那麼如何調整呢?這就需要我們對虛擬機的垃圾回收機制有所了解了。
找到將要回收的對象
如何找到要回收的對象呢?這裡主要有兩個演算法:
引用計數法
演算法大概思路就是給對象中添加一個引用計數器,每當一個地方引用它時,計數器值就加1;當引用失效時,計數器值就減1;任何時刻計數器值為0的對象就是不可能再被使用的。
但它的問題在於:很難解決對象之間相互引用的問題。比如對象A引用對象B,同時對象B又引用了對象A,但沒有其他對象引用這兩個對象,也就是說A和B這個整體是孤立的對象。按理說他們應該是被回收的,但是他們的計數器值並不為0,所以也就不能被回收了。
可達性分析演算法
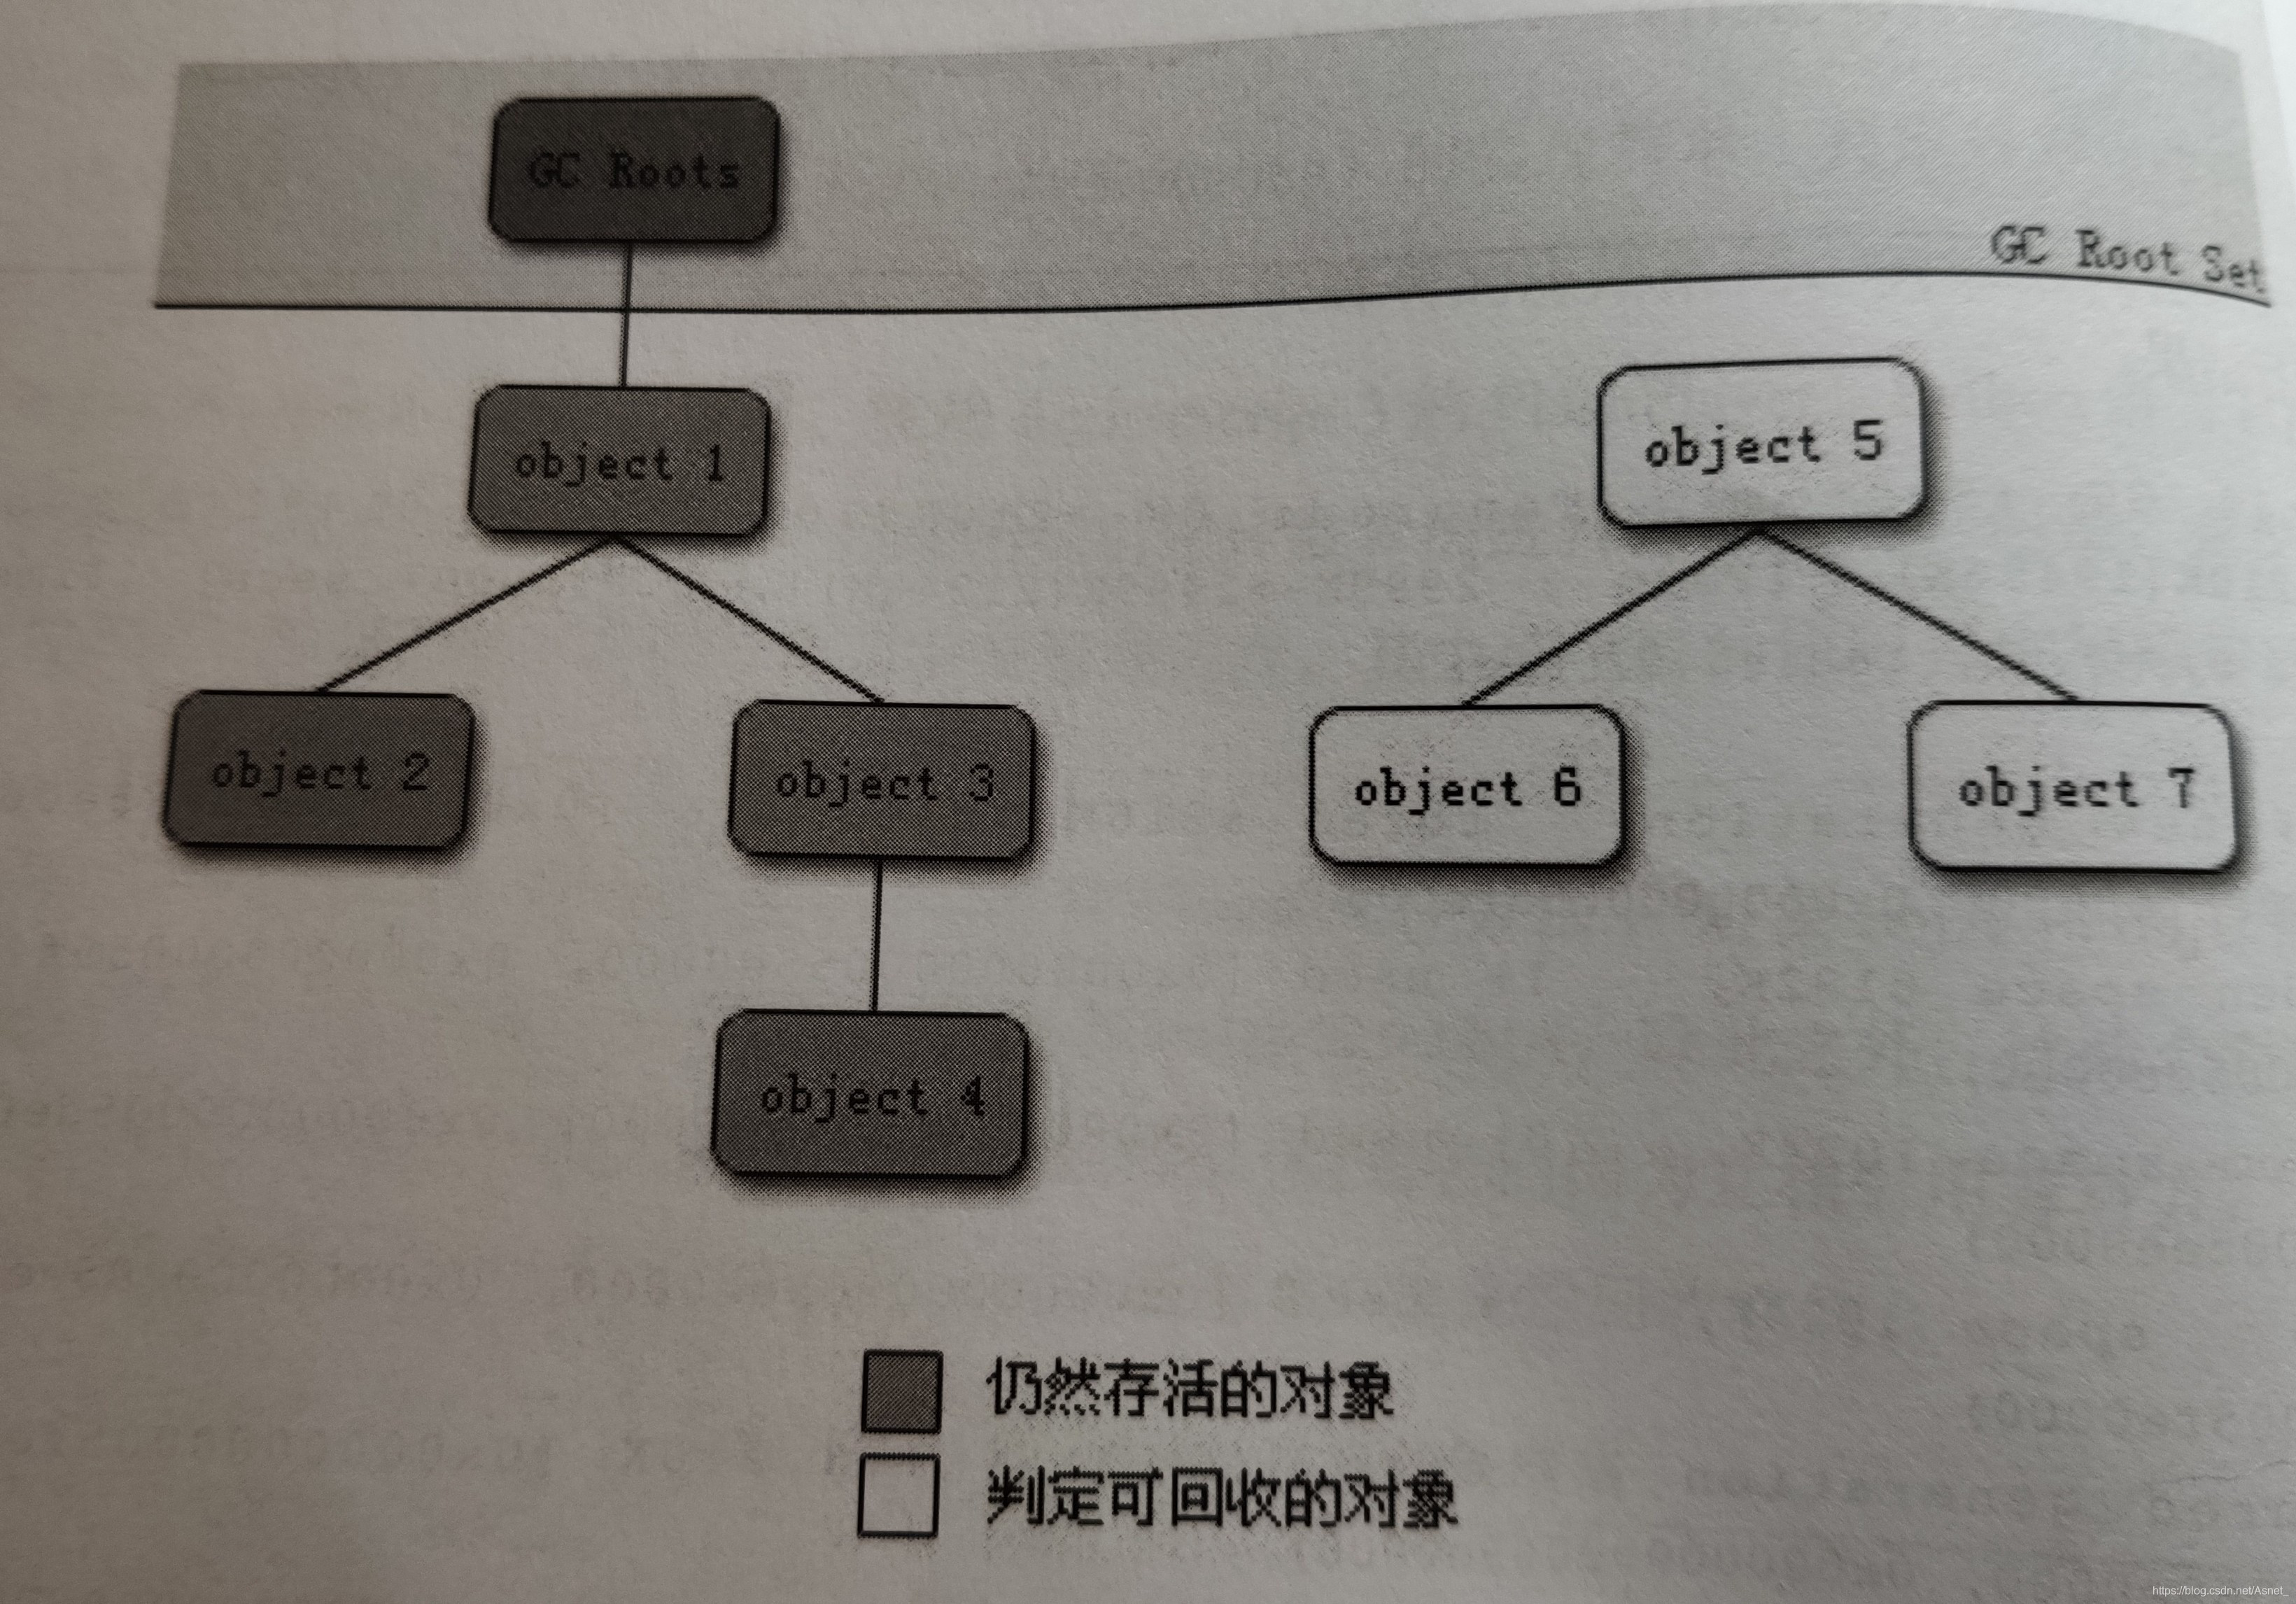
該演算法主要思路就是通過一系列的稱為「GC Roots」的對象作為起始點,從這些節點開始向下搜索,搜索所走的路徑稱為引用鏈(Refererce Chain),當一個對象到GC Roots沒有任何引用鏈相連時,則證明此對象時不可用的。下圖為例,即使對象5和對象6、7相連,但它到GC Roots是不可達的,所以對象5、6、7也是要被回收的。這裡就解決了前面引用計數法所存在的那個問題。所以該演算法目前也是大多數商用程式語言的主流實現。
垃圾收集演算法
垃圾收集演算法主要有以下四種,不過基本上後面都是前面的改進或者結合。
標記-清除演算法
最基礎的當數「標記-清除」(Mark-Sweep)演算法了。演算法分兩個階段:「標記」和「清除」。其中「標記」就是找到可以沒有被引用的對象,「清除」就是收集該對象。如下圖所示(圖片湊合看下吧):
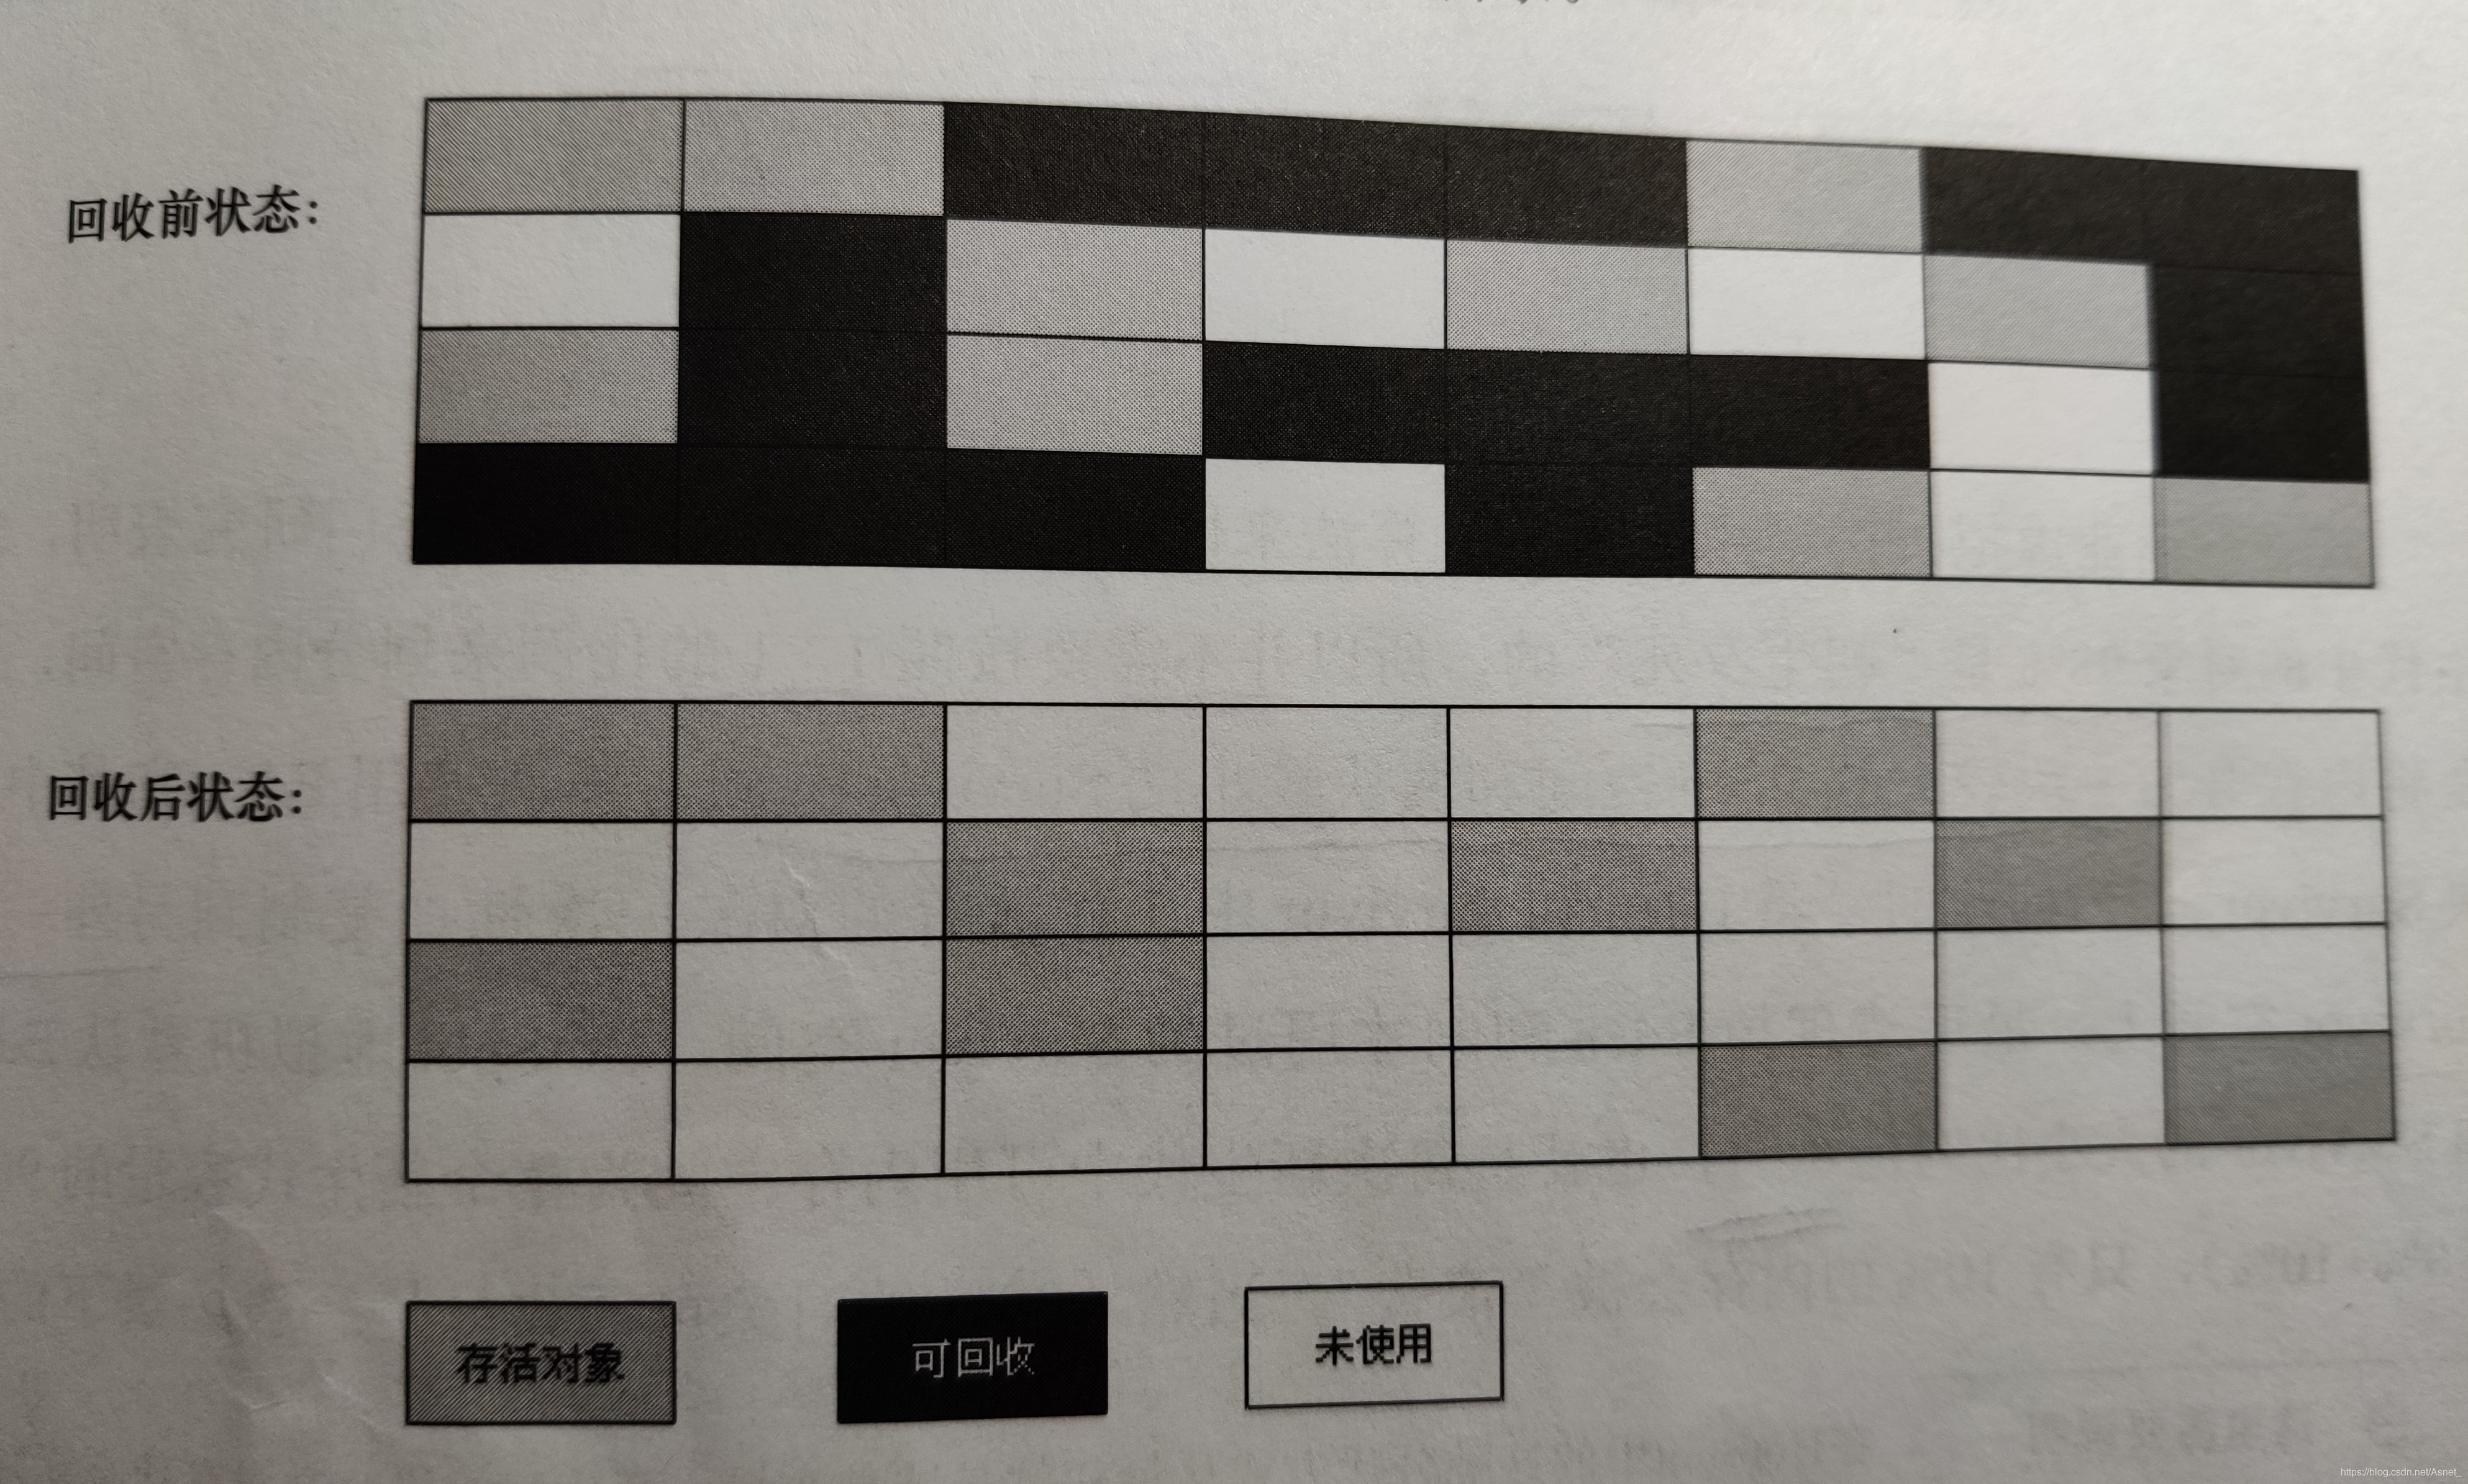
該演算法的的缺點很明顯:效率問題、空間問題。前者是因為標記和清除兩個過程效率都不高。後者是因為會產生大量不連續的記憶體碎片,從而導致後續需要分配大對象時找不到足夠的連續空間而提前觸發另一次收集動作。
複製演算法
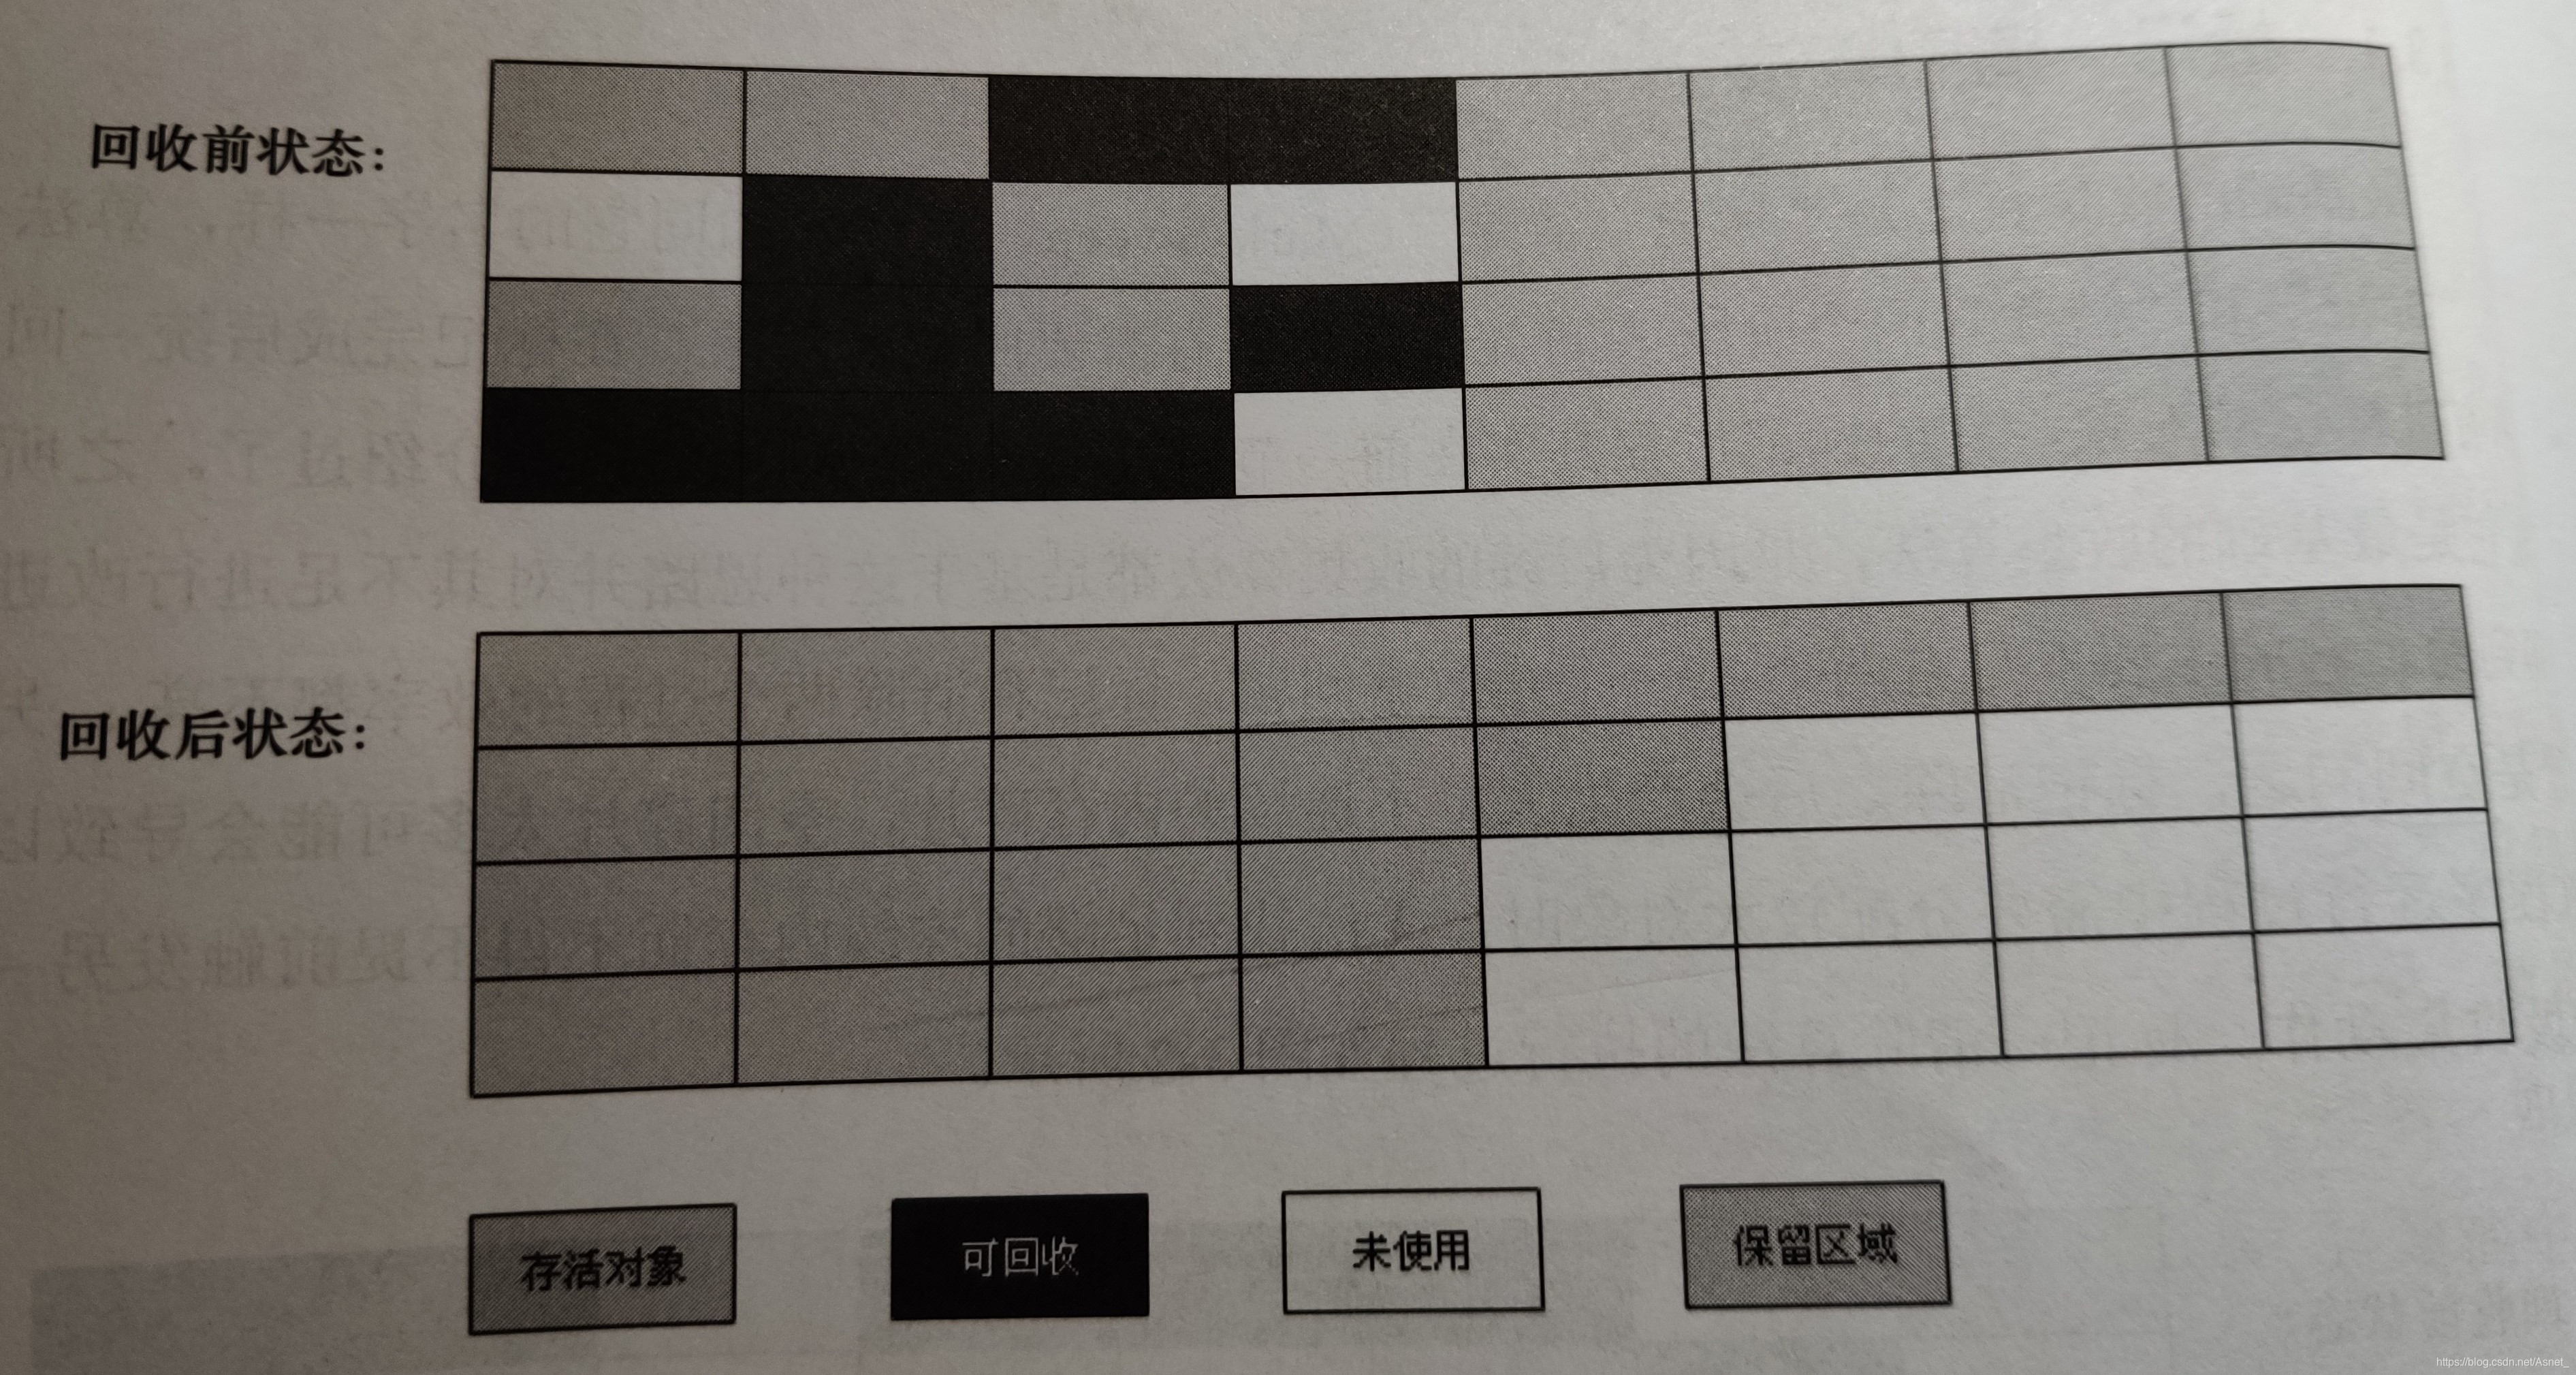
複製(Copying)演算法主要時為了解決前面的效率問題。它將可用的容量分為大小相等的兩塊,每次只使用其中一塊。其中一塊快用完了,就將存活的對象複製到另外一塊上,在把原來那塊使用過的空間清理掉。如下圖所示(顏色有點混了,格子中間水平分為相等的兩部分)。
主要問題:浪費了太多記憶體。
目前多數商業虛擬機都採用該演算法來回收新生代。但並不是嚴格按照1:1的比例分割記憶體,而是將它分為一塊較大的Eden空間和兩塊較小的Survivor空間。一塊Eden和一塊Survivor比例大概為8:1 。每次使用Eden和一塊Survivor空間,回收時將所有存活的對象複製到另外一塊未使用的Survivor空間上。
標記-整理演算法
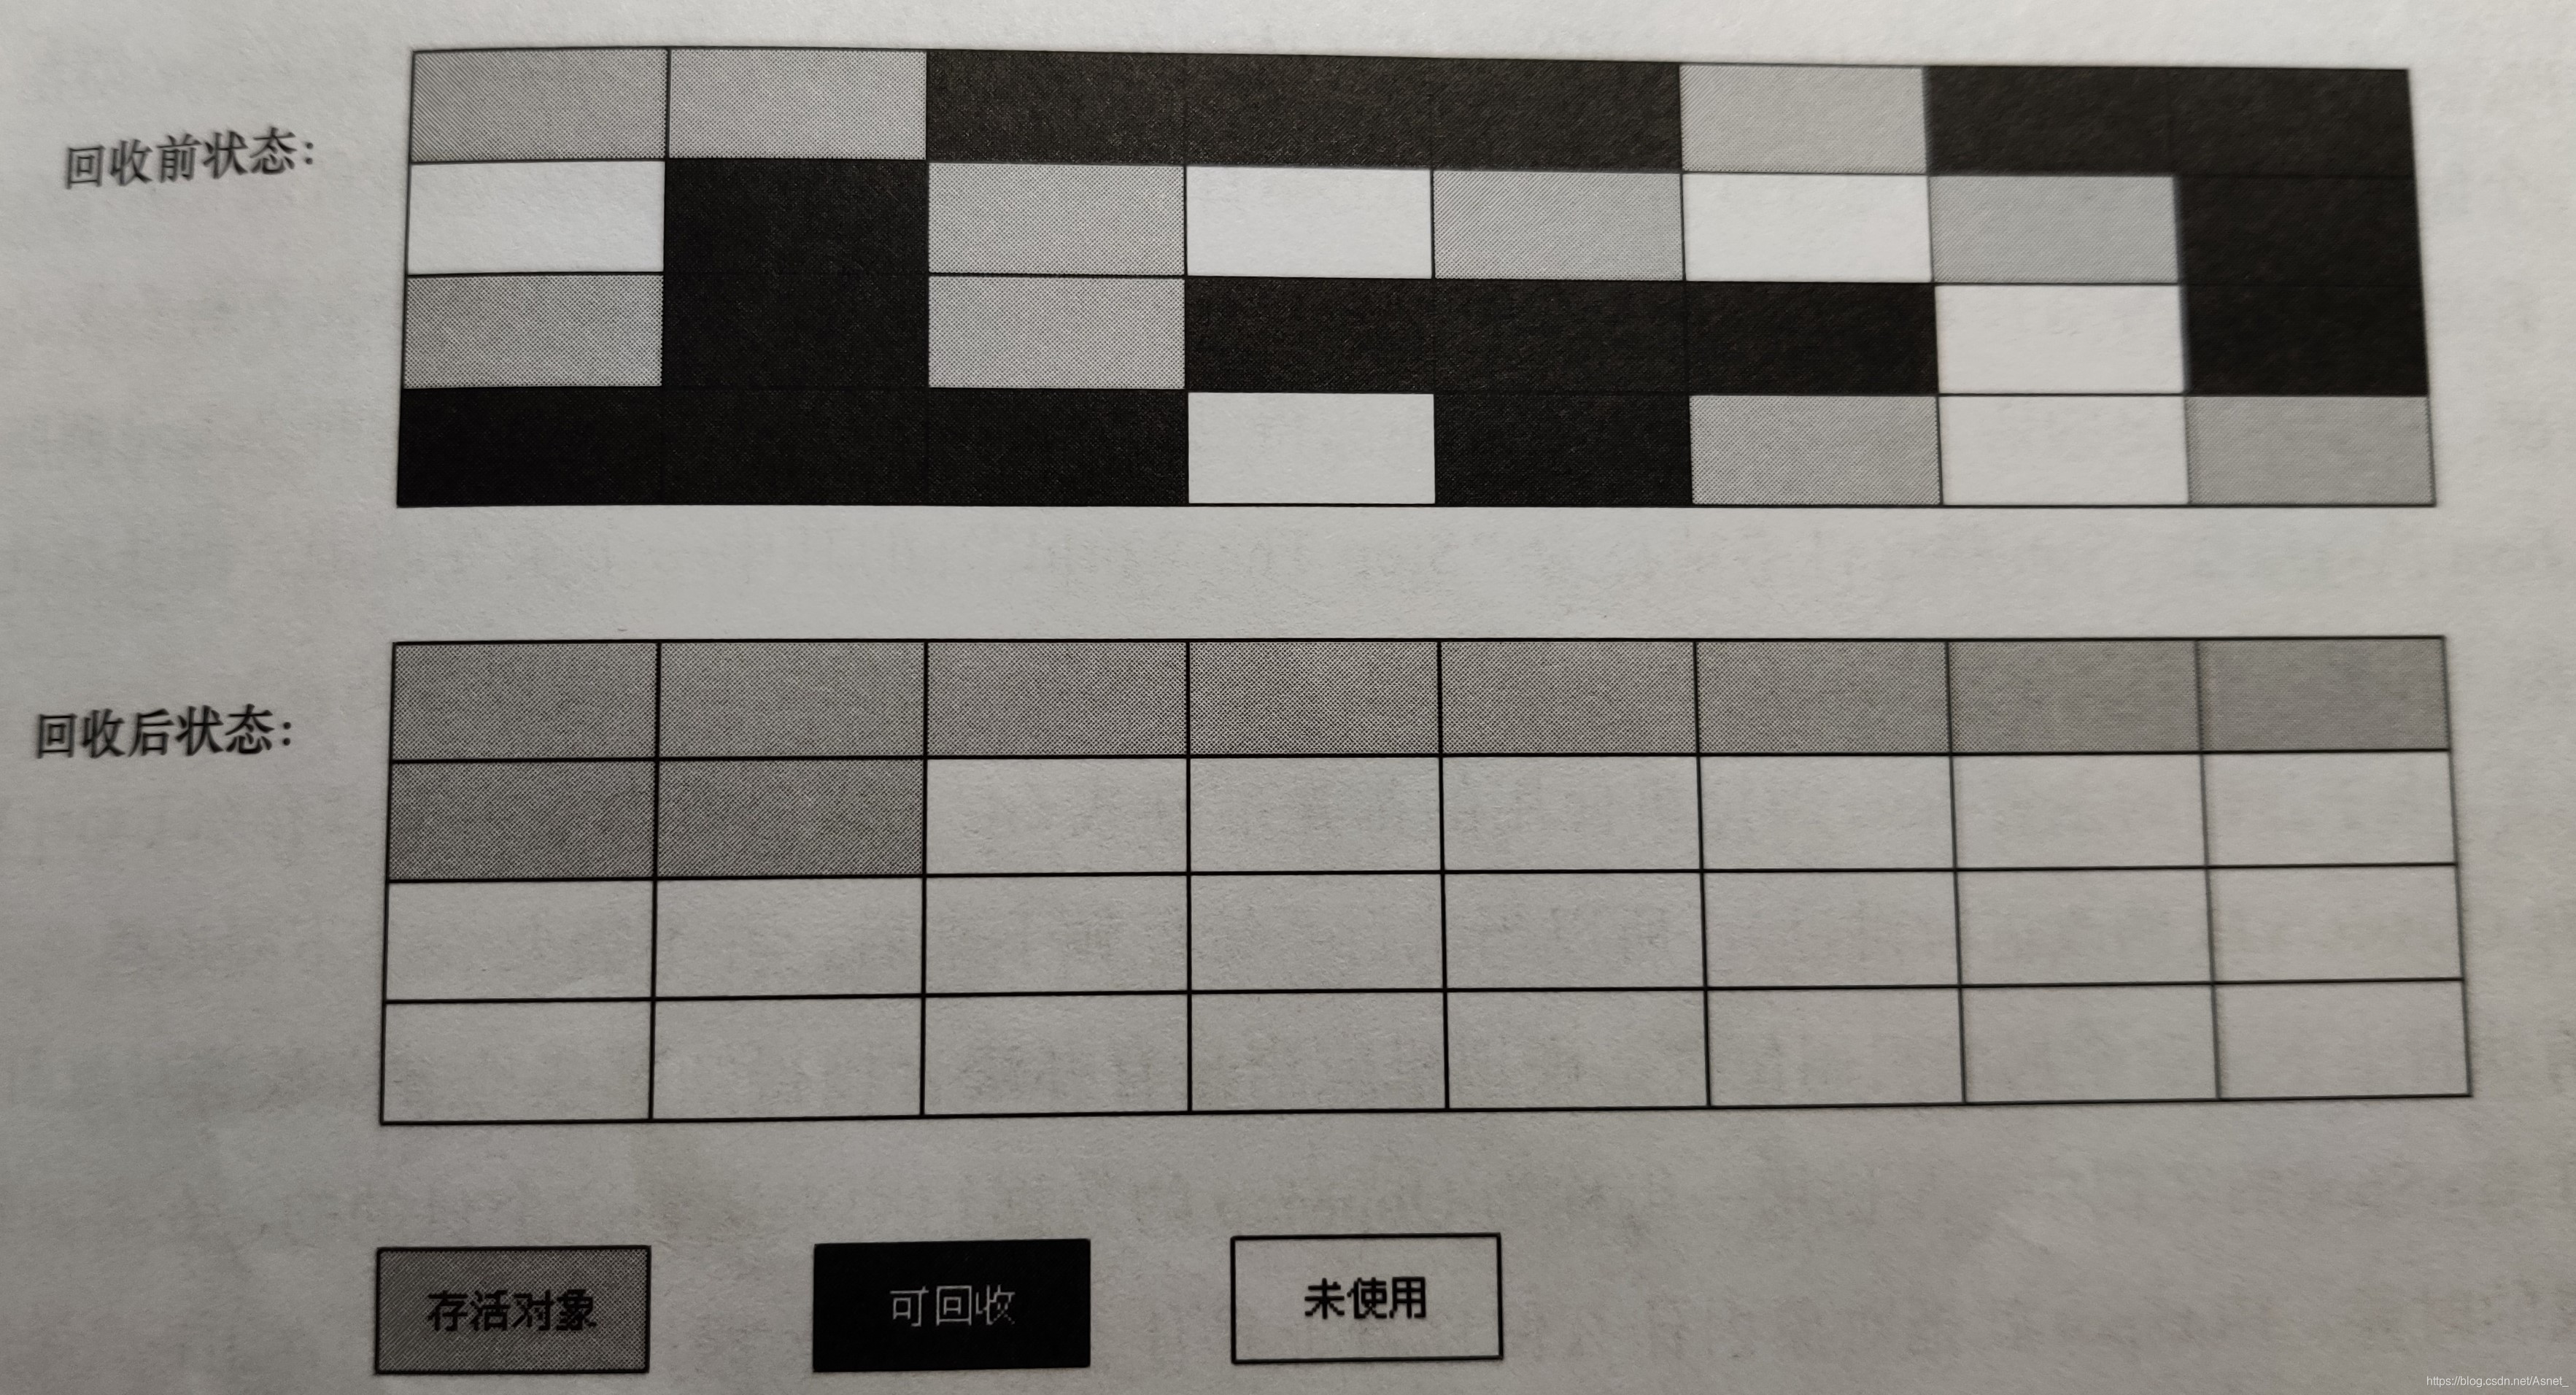
標記-整理(Mark-Compact)演算法,主要適用於對象存活率較高的情況,而前面的複製演算法適用於存活率較低的情況。演算法大概思路就是先標記要回收的對象,然後清除掉掉這些對象,最後將存活的對象複製整理到一起。也就是在前面標記-清除演算法的基礎上多了整理的步驟。
分代收集演算法
分代收集(Generational Collection)演算法主要是將記憶體劃分為新生代和老年代,不同塊採用不同的演算法。新生代對象存活率較低,就採用複製演算法;老年代對象存活率較高,就採用標記-整理演算法。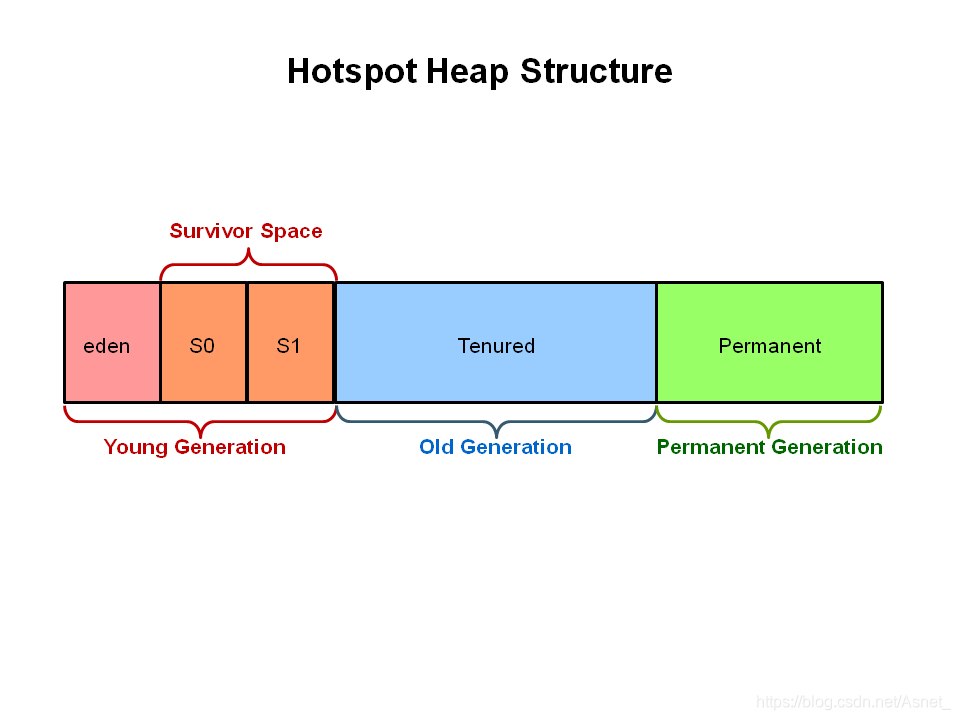
垃圾收集器
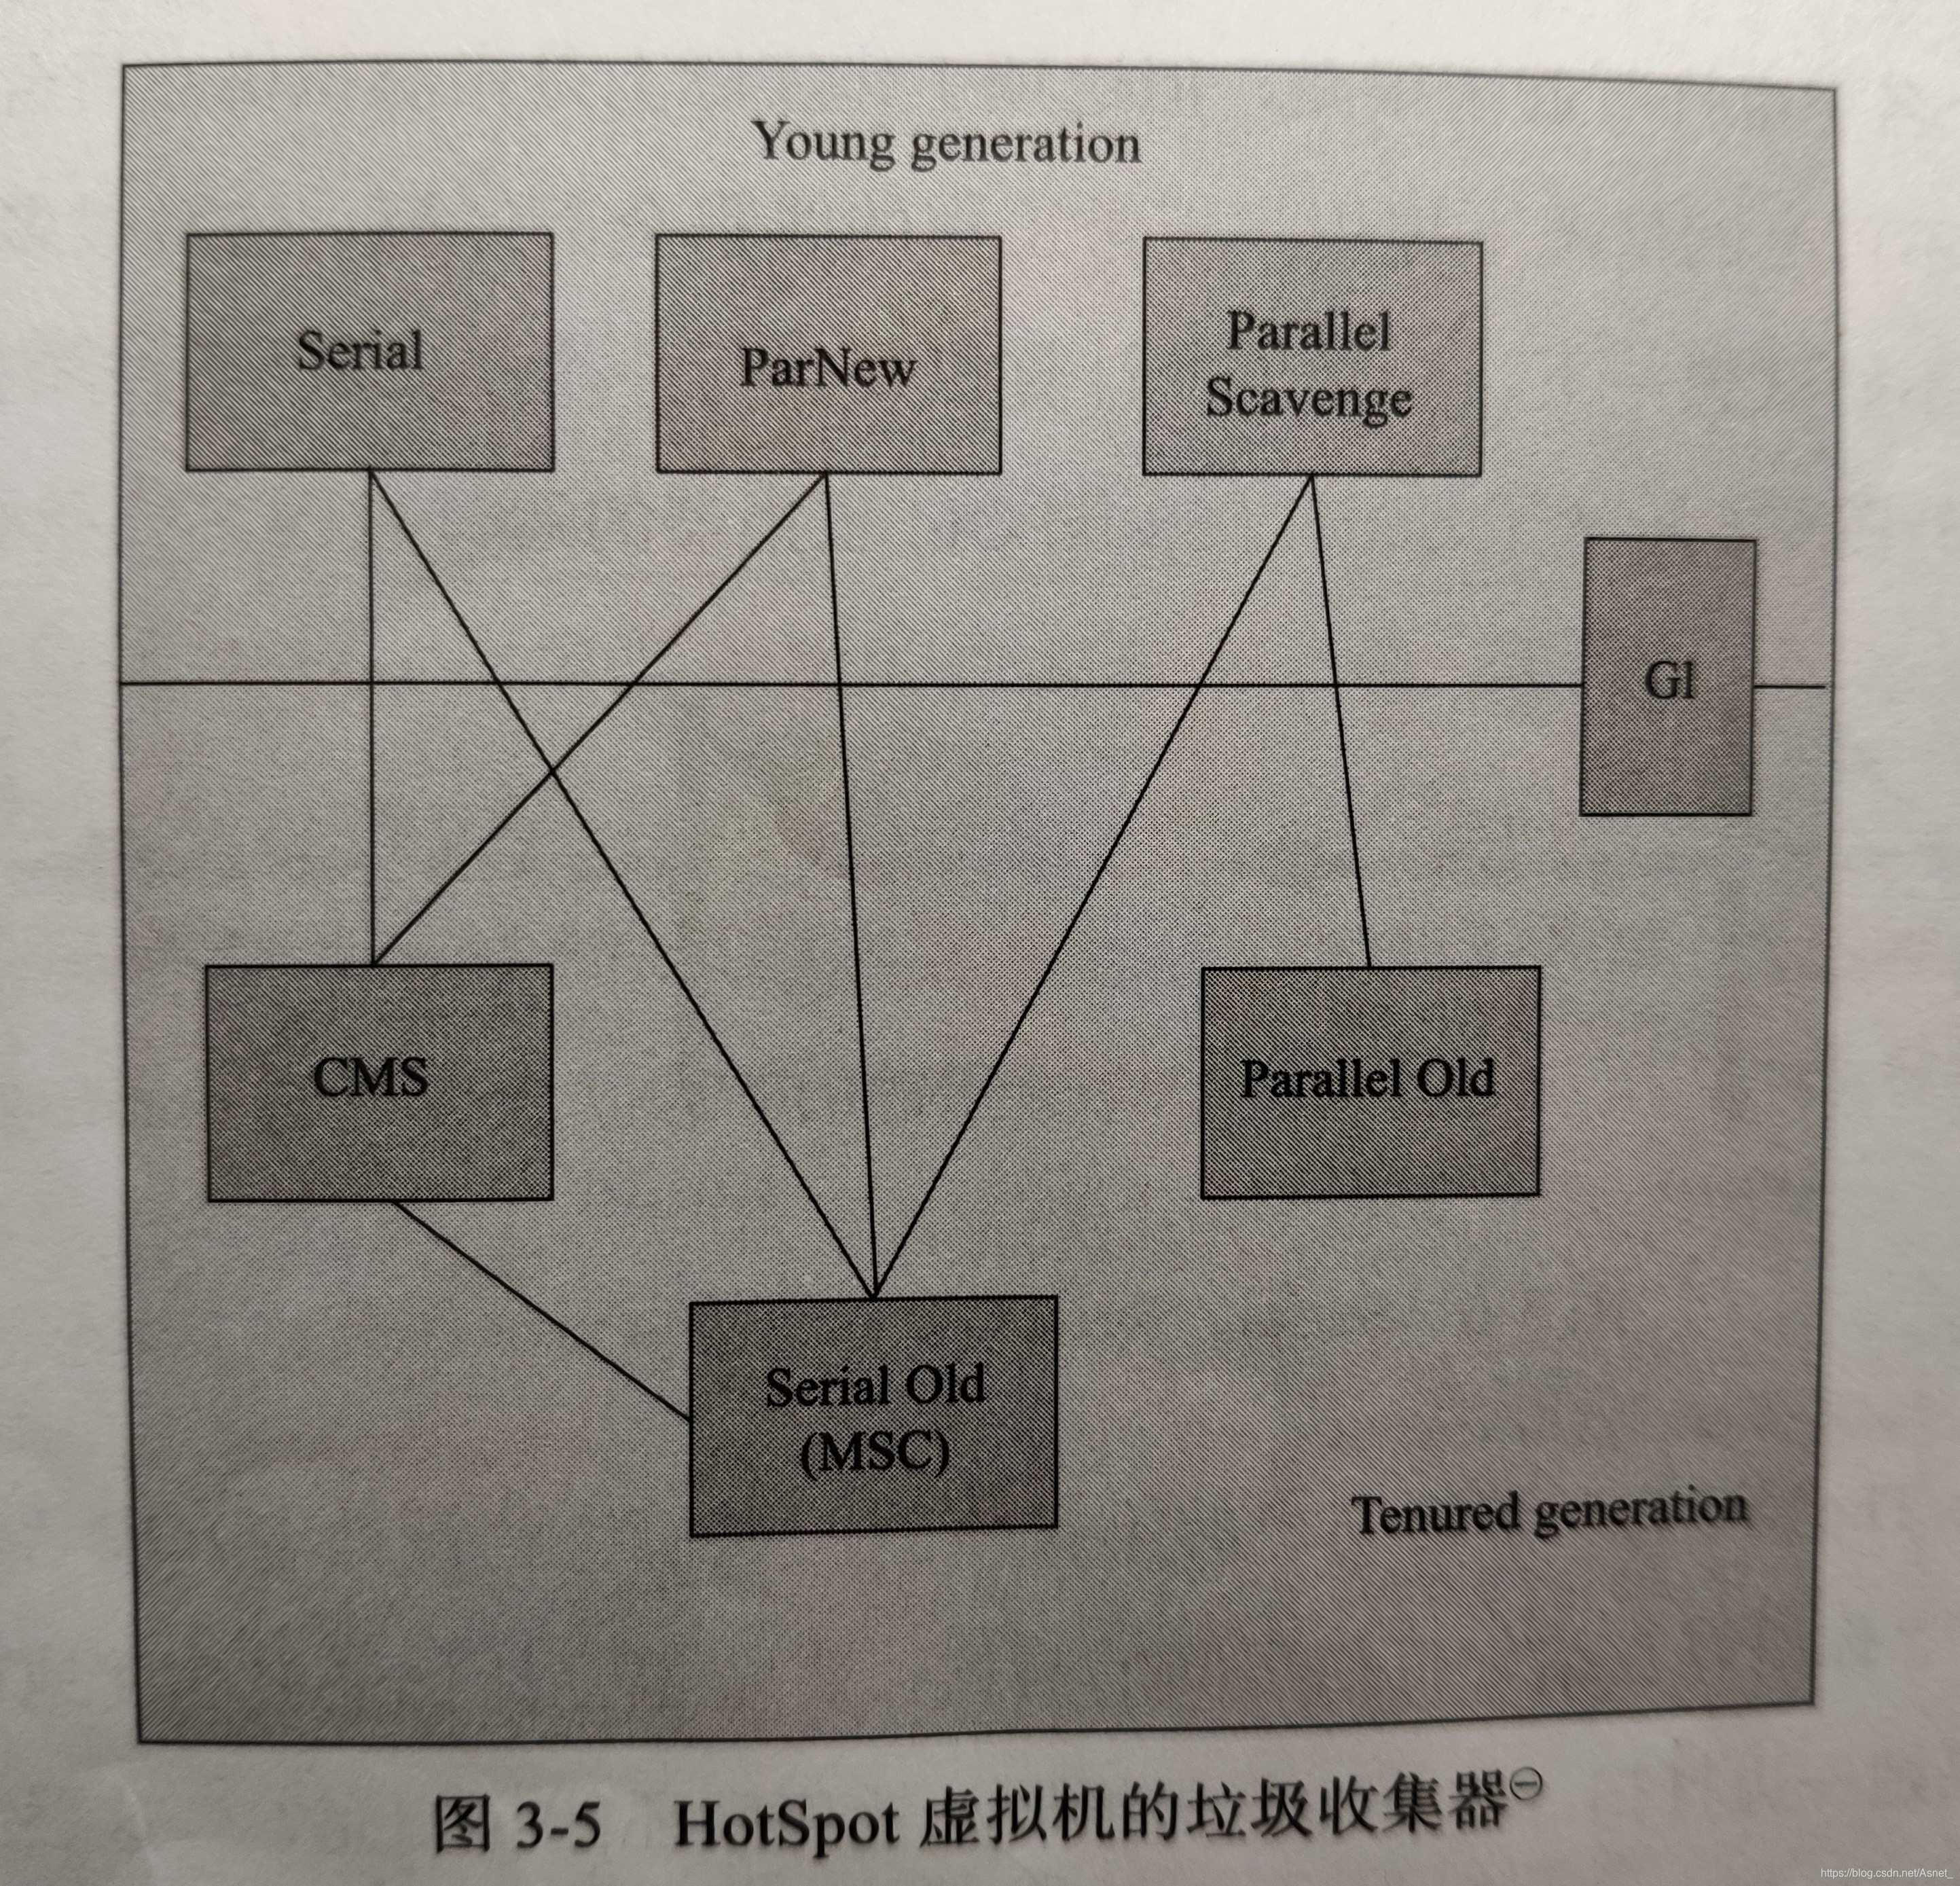
垃圾收集器就相當於前面介紹的那些演算法的具體實現了。
新生代收集器使用的收集器:Serial、PraNew、Parallel Scavenge
老年代收集器使用的收集器:Serial Old、Parallel Old、CMS
Serial收集器(複製演算法)
新生代單執行緒收集器,標記和清理都是單執行緒,優點是簡單高效。
Serial Old收集器(標記-整理演算法)
老年代單執行緒收集器,Serial收集器的老年代版本。
ParNew收集器(停止-複製演算法)
新生代收集器,可以認為是Serial收集器的多執行緒版本,在多核CPU環境下有著比Serial更好的表現。
Parallel Scavenge收集器(停止-複製演算法)
並行收集器,追求高吞吐量,高效利用CPU。吞吐量一般為99%, 吞吐量= 用戶執行緒時間/(用戶執行緒時間+GC執行緒時間)。適合後台應用等對交互相應要求不高的場景。
Parallel Old收集器(停止-複製演算法)
Parallel Scavenge收集器的老年代版本,並行收集器,吞吐量優先
CMS(Concurrent Mark Sweep)收集器(標記-清理演算法)
高並發、低停頓,追求最短GC回收停頓時間,cpu佔用比較高,響應時間快,停頓時間短,多核cpu 追求高響應時間的選擇
引用:
《深入理解Java虛擬機》 第二版 周志明