Hive 系列(八)—— Hive 數據查詢詳解
- 2019 年 10 月 3 日
- 筆記
一、數據準備
為了演示查詢操作,這裡需要預先創建三張表,並載入測試數據。
數據文件 emp.txt 和 dept.txt 可以從本倉庫的resources 目錄下載。
1.1 員工表
-- 建表語句 CREATE TABLE emp( empno INT, -- 員工表編號 ename STRING, -- 員工姓名 job STRING, -- 職位類型 mgr INT, hiredate TIMESTAMP, --僱傭日期 sal DECIMAL(7,2), --工資 comm DECIMAL(7,2), deptno INT) --部門編號 ROW FORMAT DELIMITED FIELDS TERMINATED BY "t"; --載入數據 LOAD DATA LOCAL INPATH "/usr/file/emp.txt" OVERWRITE INTO TABLE emp;1.2 部門表
-- 建表語句 CREATE TABLE dept( deptno INT, --部門編號 dname STRING, --部門名稱 loc STRING --部門所在的城市 ) ROW FORMAT DELIMITED FIELDS TERMINATED BY "t"; --載入數據 LOAD DATA LOCAL INPATH "/usr/file/dept.txt" OVERWRITE INTO TABLE dept;1.3 分區表
這裡需要額外創建一張分區表,主要是為了演示分區查詢:
CREATE EXTERNAL TABLE emp_ptn( empno INT, ename STRING, job STRING, mgr INT, hiredate TIMESTAMP, sal DECIMAL(7,2), comm DECIMAL(7,2) ) PARTITIONED BY (deptno INT) -- 按照部門編號進行分區 ROW FORMAT DELIMITED FIELDS TERMINATED BY "t"; --載入數據 LOAD DATA LOCAL INPATH "/usr/file/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=20) LOAD DATA LOCAL INPATH "/usr/file/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=30) LOAD DATA LOCAL INPATH "/usr/file/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=40) LOAD DATA LOCAL INPATH "/usr/file/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=50)二、單表查詢
2.1 SELECT
-- 查詢表中全部數據 SELECT * FROM emp;2.2 WHERE
-- 查詢 10 號部門中員工編號大於 7782 的員工資訊 SELECT * FROM emp WHERE empno > 7782 AND deptno = 10;2.3 DISTINCT
Hive 支援使用 DISTINCT 關鍵字去重。
-- 查詢所有工作類型 SELECT DISTINCT job FROM emp;2.4 分區查詢
分區查詢 (Partition Based Queries),可以指定某個分區或者分區範圍。
-- 查詢分區表中部門編號在[20,40]之間的員工 SELECT emp_ptn.* FROM emp_ptn WHERE emp_ptn.deptno >= 20 AND emp_ptn.deptno <= 40;2.5 LIMIT
-- 查詢薪資最高的 5 名員工 SELECT * FROM emp ORDER BY sal DESC LIMIT 5;2.6 GROUP BY
Hive 支援使用 GROUP BY 進行分組聚合操作。
set hive.map.aggr=true; -- 查詢各個部門薪酬綜合 SELECT deptno,SUM(sal) FROM emp GROUP BY deptno;hive.map.aggr 控制程式如何進行聚合。默認值為 false。如果設置為 true,Hive 會在 map 階段就執行一次聚合。這可以提高聚合效率,但需要消耗更多記憶體。
2.7 ORDER AND SORT
可以使用 ORDER BY 或者 Sort BY 對查詢結果進行排序,排序欄位可以是整型也可以是字元串:如果是整型,則按照大小排序;如果是字元串,則按照字典序排序。ORDER BY 和 SORT BY 的區別如下:
- 使用 ORDER BY 時會有一個 Reducer 對全部查詢結果進行排序,可以保證數據的全局有序性;
- 使用 SORT BY 時只會在每個 Reducer 中進行排序,這可以保證每個 Reducer 的輸出數據是有序的,但不能保證全局有序。
由於 ORDER BY 的時間可能很長,如果你設置了嚴格模式 (hive.mapred.mode = strict),則其後面必須再跟一個 limit 子句。
注 :hive.mapred.mode 默認值是 nonstrict ,也就是非嚴格模式。
-- 查詢員工工資,結果按照部門升序,按照工資降序排列 SELECT empno, deptno, sal FROM emp ORDER BY deptno ASC, sal DESC;2.8 HAVING
可以使用 HAVING 對分組數據進行過濾。
-- 查詢工資總和大於 9000 的所有部門 SELECT deptno,SUM(sal) FROM emp GROUP BY deptno HAVING SUM(sal)>9000;2.9 DISTRIBUTE BY
默認情況下,MapReduce 程式會對 Map 輸出結果的 Key 值進行散列,並均勻分發到所有 Reducer 上。如果想要把具有相同 Key 值的數據分發到同一個 Reducer 進行處理,這就需要使用 DISTRIBUTE BY 字句。
需要注意的是,DISTRIBUTE BY 雖然能保證具有相同 Key 值的數據分發到同一個 Reducer,但是不能保證數據在 Reducer 上是有序的。情況如下:
把以下 5 個數據發送到兩個 Reducer 上進行處理:
k1 k2 k4 k3 k1Reducer1 得到如下亂序數據:
k1 k2 k1Reducer2 得到數據如下:
k4 k3如果想讓 Reducer 上的數據時有序的,可以結合 SORT BY 使用 (示例如下),或者使用下面我們將要介紹的 CLUSTER BY。
-- 將數據按照部門分發到對應的 Reducer 上處理 SELECT empno, deptno, sal FROM emp DISTRIBUTE BY deptno SORT BY deptno ASC;2.10 CLUSTER BY
如果 SORT BY 和 DISTRIBUTE BY 指定的是相同欄位,且 SORT BY 排序規則是 ASC,此時可以使用 CLUSTER BY 進行替換,同時 CLUSTER BY 可以保證數據在全局是有序的。
SELECT empno, deptno, sal FROM emp CLUSTER BY deptno ;三、多表聯結查詢
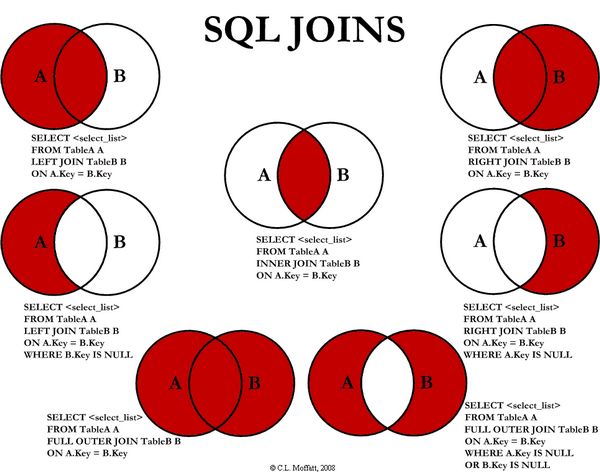
Hive 支援內連接,外連接,左外連接,右外連接,笛卡爾連接,這和傳統資料庫中的概念是一致的,可以參見下圖。
需要特彆強調:JOIN 語句的關聯條件必須用 ON 指定,不能用 WHERE 指定,否則就會先做笛卡爾積,再過濾,這會導致你得不到預期的結果 (下面的演示會有說明)。
3.1 INNER JOIN
-- 查詢員工編號為 7369 的員工的詳細資訊 SELECT e.*,d.* FROM emp e JOIN dept d ON e.deptno = d.deptno WHERE empno=7369; --如果是三表或者更多表連接,語法如下 SELECT a.val, b.val, c.val FROM a JOIN b ON (a.key = b.key1) JOIN c ON (c.key = b.key1)3.2 LEFT OUTER JOIN
LEFT OUTER JOIN 和 LEFT JOIN 是等價的。
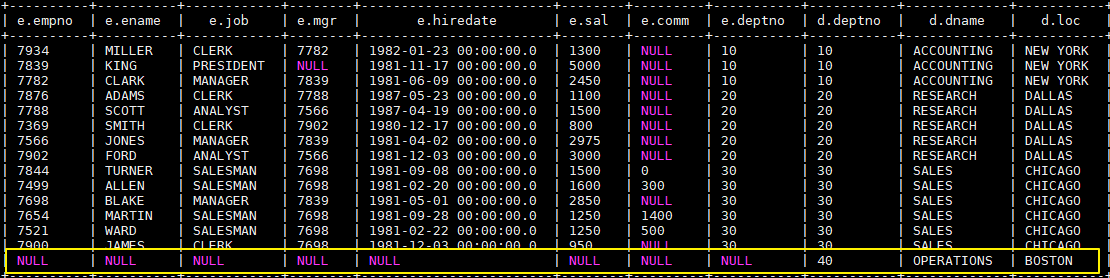
-- 左連接 SELECT e.*,d.* FROM emp e LEFT OUTER JOIN dept d ON e.deptno = d.deptno;3.3 RIGHT OUTER JOIN
--右連接 SELECT e.*,d.* FROM emp e RIGHT OUTER JOIN dept d ON e.deptno = d.deptno;執行右連接後,由於 40 號部門下沒有任何員工,所以此時員工資訊為 NULL。這個查詢可以很好的複述上面提到的——JOIN 語句的關聯條件必須用 ON 指定,不能用 WHERE 指定。你可以把 ON 改成 WHERE,你會發現無論如何都查不出 40 號部門這條數據,因為笛卡爾運算不會有 (NULL, 40) 這種情況。
3.4 FULL OUTER JOIN
SELECT e.*,d.* FROM emp e FULL OUTER JOIN dept d ON e.deptno = d.deptno;3.5 LEFT SEMI JOIN
LEFT SEMI JOIN (左半連接)是 IN/EXISTS 子查詢的一種更高效的實現。
- JOIN 子句中右邊的表只能在 ON 子句中設置過濾條件;
- 查詢結果只包含左邊表的數據,所以只能 SELECT 左表中的列。
-- 查詢在紐約辦公的所有員工資訊 SELECT emp.* FROM emp LEFT SEMI JOIN dept ON emp.deptno = dept.deptno AND dept.loc="NEW YORK"; --上面的語句就等價於 SELECT emp.* FROM emp WHERE emp.deptno IN (SELECT deptno FROM dept WHERE loc="NEW YORK");3.6 JOIN
笛卡爾積連接,這個連接日常的開發中可能很少遇到,且性能消耗比較大,基於這個原因,如果在嚴格模式下 (hive.mapred.mode = strict),Hive 會阻止用戶執行此操作。
SELECT * FROM emp JOIN dept;四、JOIN優化
4.1 STREAMTABLE
在多表進行聯結的時候,如果每個 ON 字句都使用到共同的列(如下面的 b.key),此時 Hive 會進行優化,將多表 JOIN 在同一個 map / reduce 作業上進行。同時假定查詢的最後一個表(如下面的 c 表)是最大的一個表,在對每行記錄進行 JOIN 操作時,它將嘗試將其他的錶快取起來,然後掃描最後那個表進行計算。因此用戶需要保證查詢的表的大小從左到右是依次增加的。
`SELECT a.val, b.val, c.val FROM a JOIN b ON (a.key = b.key) JOIN c ON (c.key = b.key)`然後,用戶並非需要總是把最大的表放在查詢語句的最後面,Hive 提供了 /*+ STREAMTABLE() */ 標誌,用於標識最大的表,示例如下:
SELECT /*+ STREAMTABLE(d) */ e.*,d.* FROM emp e JOIN dept d ON e.deptno = d.deptno WHERE job='CLERK';4.2 MAPJOIN
如果所有表中只有一張表是小表,那麼 Hive 把這張小表載入到記憶體中。這時候程式會在 map 階段直接拿另外一個表的數據和記憶體中表數據做匹配,由於在 map 就進行了 JOIN 操作,從而可以省略 reduce 過程,這樣效率可以提升很多。Hive 中提供了 /*+ MAPJOIN() */ 來標記小表,示例如下:
SELECT /*+ MAPJOIN(d) */ e.*,d.* FROM emp e JOIN dept d ON e.deptno = d.deptno WHERE job='CLERK';五、SELECT的其他用途
查看當前資料庫:
SELECT current_database()六、本地模式
在上面演示的語句中,大多數都會觸發 MapReduce, 少部分不會觸發,比如 select * from emp limit 5 就不會觸發 MR,此時 Hive 只是簡單的讀取數據文件中的內容,然後格式化後進行輸出。在需要執行 MapReduce 的查詢中,你會發現執行時間可能會很長,這時候你可以選擇開啟本地模式。
--本地模式默認關閉,需要手動開啟此功能 SET hive.exec.mode.local.auto=true;啟用後,Hive 將分析查詢中每個 map-reduce 作業的大小,如果滿足以下條件,則可以在本地運行它:
- 作業的總輸入大小低於:hive.exec.mode.local.auto.inputbytes.max(默認為 128MB);
- map-tasks 的總數小於:hive.exec.mode.local.auto.tasks.max(默認為 4);
- 所需的 reduce 任務總數為 1 或 0。
因為我們測試的數據集很小,所以你再次去執行上面涉及 MR 操作的查詢,你會發現速度會有顯著的提升。
參考資料
- LanguageManual Select
- LanguageManual Joins
- LanguageManual GroupBy
-
更多大數據系列文章可以參見 GitHub 開源項目: 大數據入門指南