Hive 系列(七)—— Hive 常用 DML 操作
- 2019 年 10 月 3 日
- 筆記
一、載入文件數據到表
1.1 語法
LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename [PARTITION (partcol1=val1, partcol2=val2 ...)]LOCAL關鍵字代表從本地文件系統載入文件,省略則代表從 HDFS 上載入文件:從本地文件系統載入文件時,
filepath可以是絕對路徑也可以是相對路徑 (建議使用絕對路徑);從 HDFS 載入文件時候,
filepath為文件完整的 URL 地址:如hdfs://namenode:port/user/hive/project/ data1filepath可以是文件路徑 (在這種情況下 Hive 會將文件移動到表中),也可以目錄路徑 (在這種情況下,Hive 會將該目錄中的所有文件移動到表中);如果使用 OVERWRITE 關鍵字,則將刪除目標表(或分區)的內容,使用新的數據填充;不使用此關鍵字,則數據以追加的方式加入;
載入的目標可以是表或分區。如果是分區表,則必須指定載入數據的分區;
載入文件的格式必須與建表時使用
STORED AS指定的存儲格式相同。
使用建議:
不論是本地路徑還是 URL 都建議使用完整的。雖然可以使用不完整的 URL 地址,此時 Hive 將使用 hadoop 中的 fs.default.name 配置來推斷地址,但是為避免不必要的錯誤,建議使用完整的本地路徑或 URL 地址;
載入對象是分區表時建議顯示指定分區。在 Hive 3.0 之後,內部將載入 (LOAD) 重寫為 INSERT AS SELECT,此時如果不指定分區,INSERT AS SELECT 將假設最後一組列是分區列,如果該列不是表定義的分區,它將拋出錯誤。為避免錯誤,還是建議顯示指定分區。
1.2 示例
新建分區表:
CREATE TABLE emp_ptn( empno INT, ename STRING, job STRING, mgr INT, hiredate TIMESTAMP, sal DECIMAL(7,2), comm DECIMAL(7,2) ) PARTITIONED BY (deptno INT) -- 按照部門編號進行分區 ROW FORMAT DELIMITED FIELDS TERMINATED BY "t";從 HDFS 上載入數據到分區表:
LOAD DATA INPATH "hdfs://hadoop001:8020/mydir/emp.txt" OVERWRITE INTO TABLE emp_ptn PARTITION (deptno=20);emp.txt 文件可在本倉庫的 resources 目錄中下載
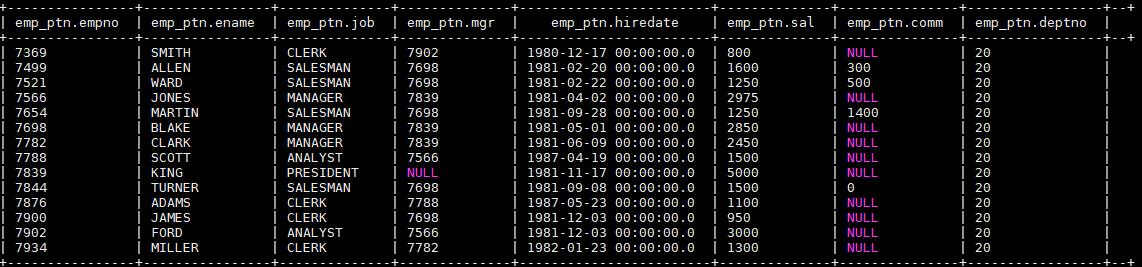
載入後表中數據如下,分區列 deptno 全部賦值成 20:
二、查詢結果插入到表
2.1 語法
INSERT OVERWRITE TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...) [IF NOT EXISTS]] select_statement1 FROM from_statement; INSERT INTO TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...)] select_statement1 FROM from_statement;Hive 0.13.0 開始,建表時可以通過使用 TBLPROPERTIES(「immutable」=「true」)來創建不可變表 (immutable table) ,如果不可以變表中存在數據,則 INSERT INTO 失敗。(註:INSERT OVERWRITE 的語句不受
immutable屬性的影響);可以對錶或分區執行插入操作。如果表已分區,則必須通過指定所有分區列的值來指定表的特定分區;
從 Hive 1.1.0 開始,TABLE 關鍵字是可選的;
從 Hive 1.2.0 開始 ,可以採用 INSERT INTO tablename(z,x,c1) 指明插入列;
可以將 SELECT 語句的查詢結果插入多個表(或分區),稱為多表插入。語法如下:
FROM from_statement INSERT OVERWRITE TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...) [IF NOT EXISTS]] select_statement1 [INSERT OVERWRITE TABLE tablename2 [PARTITION ... [IF NOT EXISTS]] select_statement2] [INSERT INTO TABLE tablename2 [PARTITION ...] select_statement2] ...;
2.2 動態插入分區
INSERT OVERWRITE TABLE tablename PARTITION (partcol1[=val1], partcol2[=val2] ...) select_statement FROM from_statement; INSERT INTO TABLE tablename PARTITION (partcol1[=val1], partcol2[=val2] ...) select_statement FROM from_statement;在向分區表插入數據時候,分區列名是必須的,但是列值是可選的。如果給出了分區列值,我們將其稱為靜態分區,否則它是動態分區。動態分區列必須在 SELECT 語句的列中最後指定,並且與它們在 PARTITION() 子句中出現的順序相同。
注意:Hive 0.9.0 之前的版本動態分區插入是默認禁用的,而 0.9.0 之後的版本則默認啟用。以下是動態分區的相關配置:
| 配置 | 默認值 | 說明 |
|---|---|---|
hive.exec.dynamic.partition | true | 需要設置為 true 才能啟用動態分區插入 |
hive.exec.dynamic.partition.mode | strict | 在嚴格模式 (strict) 下,用戶必須至少指定一個靜態分區,以防用戶意外覆蓋所有分區,在非嚴格模式下,允許所有分區都是動態的 |
hive.exec.max.dynamic.partitions.pernode | 100 | 允許在每個 mapper/reducer 節點中創建的最大動態分區數 |
hive.exec.max.dynamic.partitions | 1000 | 允許總共創建的最大動態分區數 |
hive.exec.max.created.files | 100000 | 作業中所有 mapper/reducer 創建的 HDFS 文件的最大數量 |
hive.error.on.empty.partition | false | 如果動態分區插入生成空結果,是否拋出異常 |
2.3 示例
- 新建 emp 表,作為查詢對象表
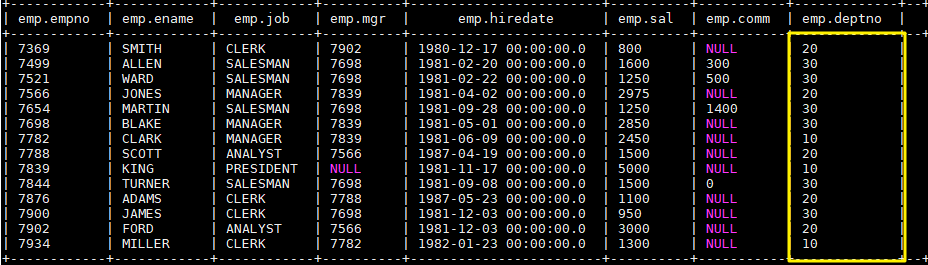
CREATE TABLE emp( empno INT, ename STRING, job STRING, mgr INT, hiredate TIMESTAMP, sal DECIMAL(7,2), comm DECIMAL(7,2), deptno INT) ROW FORMAT DELIMITED FIELDS TERMINATED BY "t"; -- 載入數據到 emp 表中 這裡直接從本地載入 load data local inpath "/usr/file/emp.txt" into table emp; 完成後 emp 表中數據如下:
- 為清晰演示,先清空
emp_ptn表中載入的數據:
TRUNCATE TABLE emp_ptn;- 靜態分區演示:從
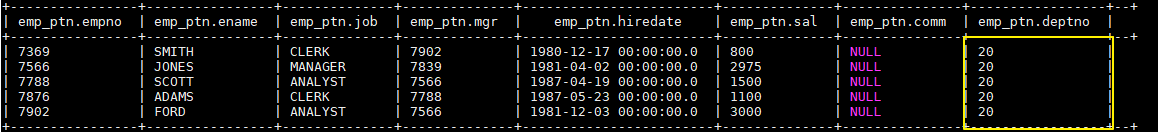
emp表中查詢部門編號為 20 的員工數據,並插入emp_ptn表中,語句如下:
INSERT OVERWRITE TABLE emp_ptn PARTITION (deptno=20) SELECT empno,ename,job,mgr,hiredate,sal,comm FROM emp WHERE deptno=20; 完成後 emp_ptn 表中數據如下:
- 接著演示動態分區:
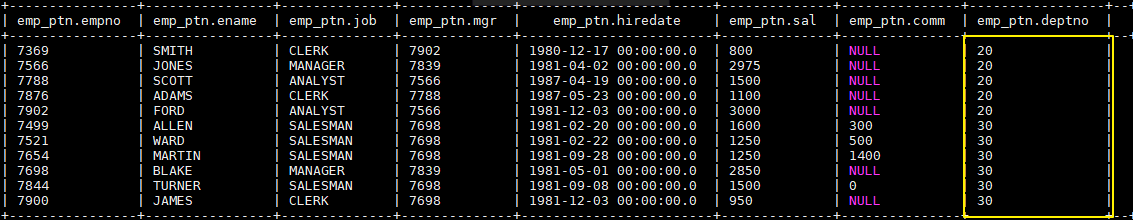
-- 由於我們只有一個分區,且還是動態分區,所以需要關閉嚴格默認。因為在嚴格模式下,用戶必須至少指定一個靜態分區 set hive.exec.dynamic.partition.mode=nonstrict; -- 動態分區 此時查詢語句的最後一列為動態分區列,即 deptno INSERT OVERWRITE TABLE emp_ptn PARTITION (deptno) SELECT empno,ename,job,mgr,hiredate,sal,comm,deptno FROM emp WHERE deptno=30; 完成後 emp_ptn 表中數據如下:
三、使用SQL語句插入值
INSERT INTO TABLE tablename [PARTITION (partcol1[=val1], partcol2[=val2] ...)] VALUES ( value [, value ...] )- 使用時必須為表中的每個列都提供值。不支援只向部分列插入值(可以為預設值的列提供空值來消除這個弊端);
- 如果目標表表支援 ACID 及其事務管理器,則插入後自動提交;
- 不支援支援複雜類型 (array, map, struct, union) 的插入。
四、更新和刪除數據
4.1 語法
更新和刪除的語法比較簡單,和關係型資料庫一致。需要注意的是這兩個操作都只能在支援 ACID 的表,也就是事務表上才能執行。
-- 更新 UPDATE tablename SET column = value [, column = value ...] [WHERE expression] --刪除 DELETE FROM tablename [WHERE expression]4.2 示例
1. 修改配置
首先需要更改 hive-site.xml,添加如下配置,開啟事務支援,配置完成後需要重啟 Hive 服務。
<property> <name>hive.support.concurrency</name> <value>true</value> </property> <property> <name>hive.enforce.bucketing</name> <value>true</value> </property> <property> <name>hive.exec.dynamic.partition.mode</name> <value>nonstrict</value> </property> <property> <name>hive.txn.manager</name> <value>org.apache.hadoop.hive.ql.lockmgr.DbTxnManager</value> </property> <property> <name>hive.compactor.initiator.on</name> <value>true</value> </property> <property> <name>hive.in.test</name> <value>true</value> </property>2. 創建測試表
創建用於測試的事務表,建表時候指定屬性 transactional = true 則代表該表是事務表。需要注意的是,按照官方文檔 的說明,目前 Hive 中的事務表有以下限制:
- 必須是 buckets Table;
- 僅支援 ORC 文件格式;
- 不支援 LOAD DATA ...語句。
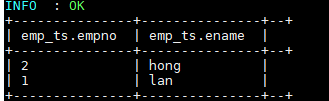
CREATE TABLE emp_ts( empno int, ename String ) CLUSTERED BY (empno) INTO 2 BUCKETS STORED AS ORC TBLPROPERTIES ("transactional"="true");3. 插入測試數據
INSERT INTO TABLE emp_ts VALUES (1,"ming"),(2,"hong");插入數據依靠的是 MapReduce 作業,執行成功後數據如下:
4. 測試更新和刪除
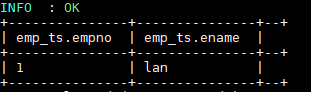
--更新數據 UPDATE emp_ts SET ename = "lan" WHERE empno=1; --刪除數據 DELETE FROM emp_ts WHERE empno=2;更新和刪除數據依靠的也是 MapReduce 作業,執行成功後數據如下:
五、查詢結果寫出到文件系統
5.1 語法
INSERT OVERWRITE [LOCAL] DIRECTORY directory1 [ROW FORMAT row_format] [STORED AS file_format] SELECT ... FROM ...OVERWRITE 關鍵字表示輸出文件存在時,先刪除後再重新寫入;
和 Load 語句一樣,建議無論是本地路徑還是 URL 地址都使用完整的;
寫入文件系統的數據被序列化為文本,其中列默認由^A 分隔,行由換行符分隔。如果列不是基本類型,則將其序列化為 JSON 格式。其中行分隔符不允許自定義,但列分隔符可以自定義,如下:
-- 定義列分隔符為't' insert overwrite local directory './test-04' row format delimited FIELDS TERMINATED BY 't' COLLECTION ITEMS TERMINATED BY ',' MAP KEYS TERMINATED BY ':' select * from src;
5.2 示例
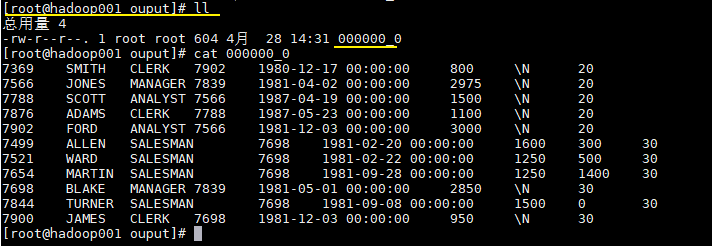
這裡我們將上面創建的 emp_ptn 表導出到本地文件系統,語句如下:
INSERT OVERWRITE LOCAL DIRECTORY '/usr/file/ouput' ROW FORMAT DELIMITED FIELDS TERMINATED BY 't' SELECT * FROM emp_ptn;導出結果如下:
參考資料
更多大數據系列文章可以參見 GitHub 開源項目: 大數據入門指南