Redis深入淺出
一、基礎使用
- 常用命令
keys,expire(過期),ttl(查看生存時間),set,select,dbsize,flushdb(刪除當前庫),flushall(刪除所有),
get,append,strlen,setnx(不存在了加),incr(增1),decr,incrby(增n)
mset(同時設置多個,同時成功,同時失敗)
getrange k1 0 4(獲取k1 0-4位的字元),
setrange(設置指定位以後的值),
setex k1 10 sad 設置k1值是sad 10秒過期,
getset一邊查一邊賦值
HyperLogLog 計數器 (pfadd 和 pfcount)
scan 0 match key99* count 1000
scan 參數提供了三個參數,第一個是 cursor 整數值,第二個是 key 的正則模式,第三個是遍歷的 limit hint。
第一次遍歷時,cursor 值為 0,然後將返回結果中第一個整數值作為下一次遍歷的 cursor。一直遍歷到返回的 cursor 值為 0 時結束。
這個 limit 不是限定返回結果的數量,而是限定伺服器單次遍歷的字典槽位數量(約等於)
- 遠程連接
redis-cli -h 127.0.0.1 -p 6379 -a "mypass"
config get *,config set requirepass "123456"
auth + 密碼
- 數據結構
-
- List
lpush/rpush 從左/右插入值
lpop/rpop 從左/右吐值
rpoplpush k1 k2
lrange k1 0 -1取所有
lindex k1 0 取第0個
linsert k1 before 4 A 在4前面插入A
lrem k1 2 A 刪除兩個A)
- Set
sadd 只插入不存在的無序,不重複
smembers k1 取所有
sismember k1 v1 是否存在v1
scard k1 獲取長度
srem k1 ...刪除
spop k1 隨機吐出一個值
srandmember k1 n 隨機取出n個值,
sinter,sunion,sdiff 交集並集差集)
- Hash
hset hbc:1010 name cjy,
hget,hmset,hexists,
hkeys 獲取所有field,
hvals 獲取所有values, hincrby增量,
hsetnx hbc:1010 age 25 不存在時設置值, ) - Zset
zadd k1 100 a 插入評分為100的a
zrange k1 0 -1 查看所有
zrangebyscore k1 100 200 在評分範圍的查找
zrevrangebyscore k1 200 100倒序
zincrby k1 1000 a 給值a的評分增加1000
zcount k1 100 200 在評分範圍的數量
zrevrange k1 0 9 withscores顯示前10名從大到小
- List
二、程式使用
- stringRedisTemplate
redisTemplate.opsForValue();  //操作字元串
redisTemplate.opsForHash();   //操作hash
redisTemplate.opsForList();   //操作list
redisTemplate.opsForSet();    //操作set
redisTemplate.opsForZSet();   //操作有序set
- 常用操作
stringRedisTemplate.opsForValue().set("test", "100",60*10,TimeUnit.SECONDS);//向redis里存入數據和設置快取時間 stringRedisTemplate.boundValueOps("test").increment(-1);//val做-1操作 stringRedisTemplate.opsForValue().get("test")//根據key獲取快取中的val stringRedisTemplate.boundValueOps("test").increment(1);//val +1 stringRedisTemplate.getExpire("test")//根據key獲取過期時間 stringRedisTemplate.getExpire("test",TimeUnit.SECONDS)//根據key獲取過期時間並換算成指定單位 stringRedisTemplate.delete("test");//根據key刪除快取 stringRedisTemplate.hasKey("546545");//檢查key是否存在,返回boolean值 stringRedisTemplate.opsForSet().add("red_123", "1","2","3");//向指定key中存放set集合 stringRedisTemplate.expire("red_123",1000 , TimeUnit.MILLISECONDS);//設置過期時間 stringRedisTemplate.opsForSet().isMember("red_123", "1")//根據key查看集合中是否存在指定數據 stringRedisTemplate.opsForSet().members("red_123");//根據key獲取set集合 - StringRedisTemplate與RedisTemplate區別點
StringRedisTemplate繼承RedisTemplate
數據是不共通的。
RedisTemplate使用的是JdkSerializationRedisSerializer    存入數據會將數據先序列化成位元組數組然後在存入Redis資料庫。
StringRedisTemplate使用的是StringRedisSerializer
三、原理&深入
- RDB vs AOF
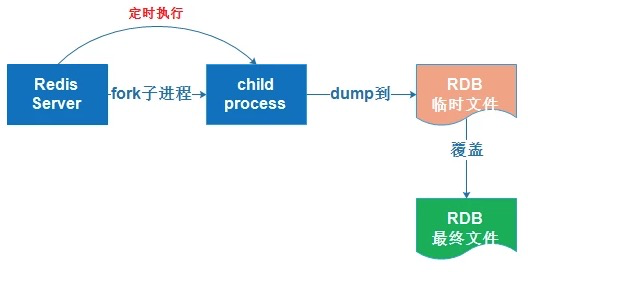
RDB持久化是指在指定的時間間隔內將記憶體中的數據集快照寫入磁碟,實際操作過程是fork一個子進程,先將數據集寫入臨時文件,寫入成功後,再替換之前的文件,用二進位壓縮存儲。
RDB的優勢和劣勢:
RDB存在哪些優勢呢?
1). 一旦採用該方式,那麼你的整個Redis資料庫將只包含一個文件,這對於文件備份而言是非常完美的。比如,你可能打算每個小時歸檔一次最近24小時的數據,同時還要每天歸檔一次最近30天的數據。通過這樣的備份策略,一旦系統出現災難性故障,我們可以非常容易的進行恢復。
2). 對於災難恢復而言,RDB是非常不錯的選擇。因為我們可以非常輕鬆的將一個單獨的文件壓縮後再轉移到其它存儲介質上。
3). 性能最大化。對於Redis的服務進程而言,在開始持久化時,它唯一需要做的只是fork出子進程,之後再由子進程完成這些持久化的工作,這樣就可以極大的避免服務進程執行IO操作了。
4). 相比於AOF機制,如果數據集很大,RDB的啟動效率會更高。

RDB又存在哪些劣勢呢?
1). 如果你想保證數據的高可用性,即最大限度的避免數據丟失,那麼RDB將不是一個很好的選擇。因為系統一旦在定時持久化之前出現宕機現象,此前沒有來得及寫入磁碟的數據都將丟失。
2). 由於RDB是通過fork子進程來協助完成數據持久化工作的,因此,如果當數據集較大時,可能會導致整個伺服器停止服務幾百毫秒,甚至是1秒鐘。
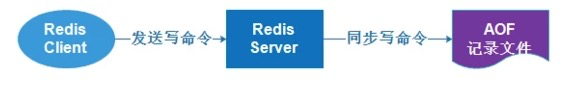
AOF持久化以日誌的形式記錄伺服器所處理的每一個寫、刪除操作,查詢操作不會記錄,以文本的方式記錄,可以打開文件看到詳細的操作記錄。
AOF的優勢和劣勢:
AOF的優勢有哪些呢?
1). 該機制可以帶來更高的數據安全性,即數據持久性。Redis中提供了3中同步策略,即每秒同步、每修改同步和不同步。事實上,每秒同步也是非同步完成的,其效率也是非常高的,所差的是一旦系統出現宕機現象,那麼這一秒鐘之內修改的數據將會丟失。而每修改同步,我們可以將其視為同步持久化,即每次發生的數據變化都會被立即記錄到磁碟中。可以預見,這種方式在效率上是最低的。至於無同步,無需多言,我想大家都能正確的理解它。
2). 由於該機制對日誌文件的寫入操作採用的是append模式,因此在寫入過程中即使出現宕機現象,也不會破壞日誌文件中已經存在的內容。然而如果我們本次操作只是寫入了一半數據就出現了系統崩潰問題,不用擔心,在Redis下一次啟動之前,我們可以通過redis-check-aof工具來幫助我們解決數據一致性的問題。
3). 如果日誌過大,Redis可以自動啟用rewrite機制。即Redis以append模式不斷的將修改數據寫入到老的磁碟文件中,同時Redis還會創建一個新的文件用於記錄此期間有哪些修改命令被執行。因此在進行rewrite切換時可以更好的保證數據安全性。
4). AOF包含一個格式清晰、易於理解的日誌文件用於記錄所有的修改操作。事實上,我們也可以通過該文件完成數據的重建。

AOF的劣勢有哪些呢?
1). 對於相同數量的數據集而言,AOF文件通常要大於RDB文件。RDB 在恢復大數據集時的速度比 AOF 的恢復速度要快。
2). 根據同步策略的不同,AOF在運行效率上往往會慢於RDB。總之,每秒同步策略的效率是比較高的,同步禁用策略的效率和RDB一樣高效。
-
持久化配置
-
- RDB持久化配置
Redis會將數據集的快照dump到dump.rdb文件中。此外,我們也可以通過配置文件來修改Redis伺服器dump快照的頻率,在打開6379.conf文件之後,我們搜索save,可以看到下面的配置資訊:
save 900 1              #在900秒(15分鐘)之後,如果至少有1個key發生變化,則dump記憶體快照。
save 300 10            #在300秒(5分鐘)之後,如果至少有10個key發生變化,則dump記憶體快照。
save 60 10000        #在60秒(1分鐘)之後,如果至少有10000個key發生變化,則dump記憶體快照。
- AOF持久化配置
在Redis的配置文件中存在三種同步方式,它們分別是:
appendfsync always     #每次有數據修改發生時都會寫入AOF文件。
appendfsync everysec  #每秒鐘同步一次,該策略為AOF的預設策略。
appendfsync no          #從不同步。高效但是數據不會被持久化。
- RDB持久化配置
3. 哨兵模式
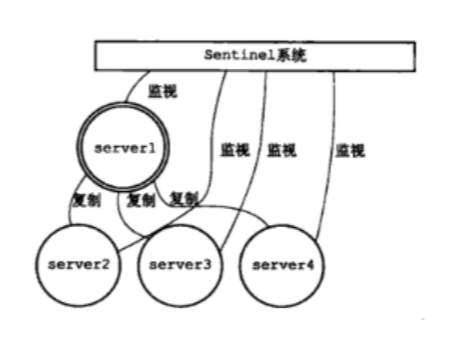
1. 哨兵模式,就類似於zookeeper的選舉模式一樣,5個伺服器需要一個管理的主機,他們需要選舉出來,這就是哨兵模式

2. 集群分片 比如 5主5從,也就是說 數據過來之後會均勻的分配到5台伺服器上面,5台伺服器上面的數據是不同的,但是每個伺服器都有一個從伺服器,上面的數據跟這一台主伺服器的數據是一樣的;
也就是說,對於這5對伺服器總體來說,這就是集群分片模式,而對於這5對伺服器的每一對,都是一個主從模式
四、問題解決方案
- 快取
-
- 快取穿透
key對應的數據在數據源並不存在,每次針對此key的請求從快取獲取不到,請求都會到數據源,從而可能壓垮數據源。
比如用一個不存在的用戶id獲取用戶資訊,不論快取還是資料庫都沒有,若黑客利用此漏洞進行攻擊可能壓垮資料庫。
解決方案:
布隆過濾器 : key hash到一個bitmap中,每次key判斷在bitmap是否存在
空值也做快取,快取時間短
- 快取擊穿
key對應的數據存在,但在redis中過期,此時若有大量並發請求過來,
這些請求發現快取過期一般都會從後端DB載入數據並回設到快取,這個時候大並發的請求可能會瞬間把後端DB壓垮。
解決方案:
mutex key: public String get(key) { String value = redis.get(key); if (value == null) { //代表快取值過期 //設置3min的超時,防止del操作失敗的時候,下次快取過期一直不能load db if (redis.setnx(key_mutex, 1, 3 * 60) == 1) { //代表設置成功 value = db.get(key); redis.set(key, value, expire_secs); redis.del(key_mutex); } else { //這個時候代表同時候的其他執行緒已經load db並回設到快取了,這時候重試獲取快取值即可 sleep(50); get(key); //重試 } } else { return value; } } - 快取雪崩
當快取伺服器重啟或者大量快取集中在某一個時間段失效,這樣在失效的時候,也會給後端系統(比如DB)帶來很大壓力。
解決方案:
三種方案:使用鎖或隊列、設置過期標誌更新快取、為key設置不同的快取失效時間,還有一種被稱為「二級快取」的解決方法。
事前解決方案
* 保證快取層服務高可用性
事中解決方案:
* 對快取訪問進行 資源隔離(熔斷)、Fail Silent 降級
* ehcache本地快取
* 對源服務訪問進行 限流、資源隔離(熔斷)、Stubbed 降級。
事後解決方案
* Redis數據備份和恢復
* 快速快取預熱
- 快取穿透
2. redis事務
-
-
multi/exec/discard。multi 指示事務的開始,exec 指示事務的執行,discard 指示事務的丟棄。
-
轉載請註明地址://www.cnblogs.com/handsomecui/