二分查找技巧---字節跳動2018校招演算法方向(第二批)---用戶喜好
- 2019 年 11 月 5 日
- 筆記
[編程題]用戶喜好
時間限制:3秒
空間限制:262144K
為了不斷優化推薦效果,今日頭條每天要存儲和處理海量數據。假設有這樣一種場景:我們對用戶按照它們的註冊時間先後來標號,對於一類文章,每個用戶都有不同的喜好值,我們會想知道某一段時間內註冊的用戶(標號相連的一批用戶)中,有多少用戶對這類文章喜好值為k。因為一些特殊的原因,不會出現一個查詢的用戶區間完全覆蓋另一個查詢的用戶區間(不存在L1<=L2<=R2<=R1)。
輸入描述:
輸入: 第1行為n代表用戶的個數 第2行為n個整數,第i個代表用戶標號為i的用戶對某類文章的喜好度 第3行為一個正整數q代表查詢的組數 第4行到第(3+q)行,每行包含3個整數l,r,k代表一組查詢,即標號為l<=i<=r的用戶中對這類文章喜好值為k的用戶的個數。 數據範圍n <= 300000,q<=300000 k是整型
輸出描述:
輸出:一共q行,每行一個整數代表喜好值為k的用戶的個數
輸入例子1:
5 1 2 3 3 5 3 1 2 1 2 4 5 3 5 3
輸出例子1:
1 0 2
例子說明1:
樣例解釋:  有5個用戶,喜好值為分別為1、2、3、3、5,  第一組詢問對於標號[1,2]的用戶喜好值為1的用戶的個數是1  第二組詢問對於標號[2,4]的用戶喜好值為5的用戶的個數是0  第三組詢問對於標號[3,5]的用戶喜好值為3的用戶的個數是2

解題思路:
剛開始看到題目,覺得是區間查詢的題目,於是想線段樹、RMQ那些,結果發現查找的k值不能預先存為狀態。搜了一下題解發現只是用到二分查找的技巧,看看下圖就明白了:
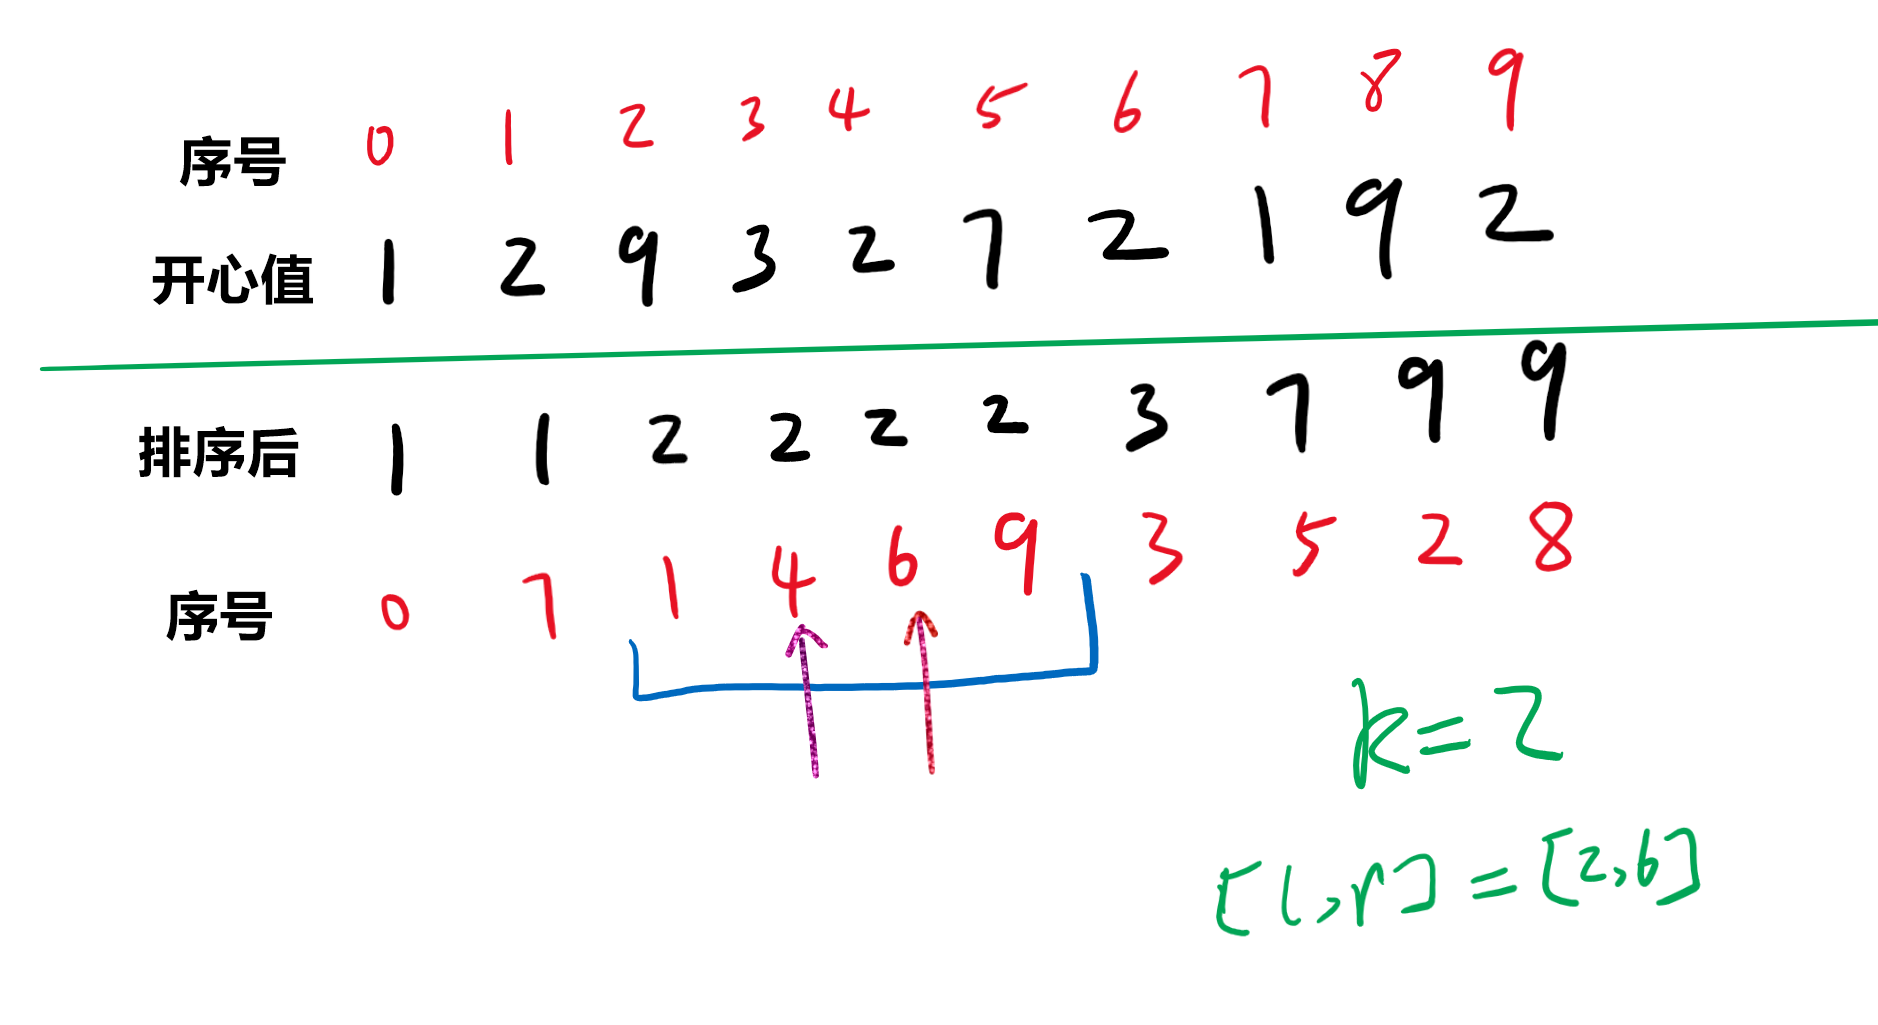
為了進行二分查找,我們對喜好值進行排序,但是注意到有查詢區間,所以標號也必須一起排序。需要注意的是在喜好值相等的片段里標號也要排成遞增次序,這個可以寫個結構體(記為Num)然後重寫比較函數。那麼在標號按遞增次序後,我們可以發現,如果要查找[2,6]區間里喜好值為2的人數,只需要二分查找k=2,L=2的上界,以及k=2,R=6的下界。
(也可以理解為先二分查找k所在的區間,然後二分查找L和R的位置,然後取其長度,但實際上只需要兩次二分查找就行了,畢竟排序函數如果可以用比較函數把數組排好序,那麼同樣可以只用一次二分查找把邊界找出來,因為它們都用到自定義的比較函數)
如圖找到下界4和上界6,那麼上界與下界之間的長度即為[2,6]之間的喜好值為2的人數。
需要用到的是二分查找的函數,這裡複習一下:
用lower_bound找到第一個大於或等於左端點的位置,
用upper_bound找到最後一個小於或等於右端點的位置
1 #include<iostream> 2 #include<cstdio> 3 #include<algorithm> 4 using namespace std; 5 6 const int maxn=300000+5; 7 8 struct Num{ 9 int id; 10 int val; 11 bool operator<(const Num &b)const{ 12 if(val==b.val)return id<b.id; 13 else return val<b.val; 14 } 15 }num[maxn]; 16 17 int main() 18 { 19 int n; 20 scanf("%d",&n); 21 for(int i=0;i<n;i++){ 22 scanf("%d",&num[i].val); 23 num[i].id=i; 24 } 25 sort(num,num+n); 26 int q; 27 scanf("%d",&q); 28 while(q--){ 29 int l,r,k; 30 scanf("%d%d%d",&l,&r,&k); 31 l--; r--; 32 Num L,R; 33 L.id=l; R.id=r; 34 L.val=R.val=k; 35 int ansL=lower_bound(num,num+n,L)-num; 36 int ansR=upper_bound(num,num+n,R)-num; 37 printf("%dn",ansR-ansL); 38 } 39 40 return 0; 41 }