Netty學習筆記-入門版
Netty學習筆記
前言
本文簡單介紹下netty的基本原理,I/O模型,Reactor執行緒模型以及架構設計等相關知識點。
什麼是Netty
Netty是由JBOSS提供的一個Java開源框架。Netty提供非同步的、事件驅動的網路應用程式框架和工具,用以快速開發高性能、高可靠性的網路伺服器和客戶端程式。
Netty 是一個基於NIO的客戶、伺服器端編程框架,使用Netty 可以確保你快速和簡單的開發出一個網路應用,例如實現了某種協議的客戶,服務端應用。Netty相當簡化和流線化了網路應用的編程開發過程,例如,TCP和UDP的socket服務開發。

Netty是由NIO演進而來,使用過NIO編程的用戶就知道NIO編程非常繁重,Netty是能夠能跟好的使用NIO
IO基礎
概念說明
IO簡單介紹

IO在電腦中指Input/Output,也就是輸入和輸出。由於程式和運行時數據是在記憶體中駐留,由CPU這個超快的計算核心來執行,涉及到數據交換的地方,通常是磁碟、網路等,就需要IO介面。
比如你打開瀏覽器,訪問新浪首頁,瀏覽器這個程式就需要通過網路IO獲取新浪的網頁。瀏覽器首先會發送數據給新浪伺服器,告訴它我想要首頁的HTML,這個動作是往外發數據,叫Output,隨後新浪伺服器把網頁發過來,這個動作是從外面接收數據,叫Input。所以,通常,程式完成IO操作會有Input和Output兩個數據流。當然也有只用一個的情況,比如,從磁碟讀取文件到記憶體,就只有Input操作,反過來,把數據寫到磁碟文件里,就只是一個Output操作。
用戶空間與內核空間

現在作業系統都是採用虛擬存儲器,那麼對32位作業系統而言,它的定址空間(虛擬存儲空間)為4G(2的32次方)作業系統的核心是內核,獨立於普通的應用程式,可以訪問受保護的記憶體空間,也有訪問底層硬體設備(例如負責磁碟IO的設備)的所有許可權。為了保證用戶進程不能直接操作內核(kernel),保證內核的安全,作業系統將虛擬空間劃分為兩部分,一部分為內核空間,一部分為用戶空間。
針對linux作業系統而言,將最高的1G位元組(從虛擬地址0xC0000000到0xFFFFFFFF),供內核使用,稱為內核空間,而將較低的3G位元組(從虛擬地址0×00000000到0xBFFFFFFF),供各個進程使用,稱為用戶空間。
進程(Process)
是電腦中的程式關於某數據集合上的一次運行活動,是系統進行資源分配和調度的基本單位,是作業系統結構的基礎。
在當代面向執行緒設計的電腦結構中,進程是執行緒的容器。程式是指令、數據及其組織形式的描述,進程是程式的實體。是電腦中的程式關於某數據集合上的一次運行活動,是系統進行資源分配和調度的基本單位,是作業系統結構的基礎。程式是指令、數據及其組織形式的描述,進程是程式的實體。
執行緒(thread)
是作業系統能夠進行運算調度的最小單位。它被包含在進程之中,是進程中的實際運作單位。一條執行緒指的是進程中一個單一順序的控制流,一個進程中可以並發多個執行緒,每條執行緒並行執行不同的任務。
程式和進程
1個程式可以對應多個進程,但1個進程只能對應1個程式。
說白了就是,一個程式可以重複運行,開幾個窗口,比如網遊的「雙開」,一個進程可以對應多個程式就是一個DLL文件可一被多個程式運用,比如DirectX9的動態鏈接庫,就是,許多遊戲都要有它才能運行。

我們簡單總結下:
進程包含執行緒。
進程:指在系統中正在運行的一個應用程式;程式一旦運行就是進程;進程——資源分配的最小單位。
執行緒:系統分配處理器時間資源的基本單元,或者說進程之內獨立執行的一個單元執行流。執行緒——程式執行的最小單位。
進程切換
為了控制進程的執行,內核必須有能力掛起正在CPU上運行的進程,並恢復以前掛起的某個進程的執行。這種行為被稱為進程切換。因此可以說,任何進程都是在作業系統內核的支援下運行的,是與內核緊密相關的。
從一個進程的運行轉到另一個進程上運行,這個過程中經過下面這些變化:
- 保存處理機上下文,包括程式計數器和其他暫存器。
- 更新PCB資訊。
- 把進程的PCB移入相應的隊列,如就緒、在某事件阻塞等隊列。
- 選擇另一個進程執行,並更新其PCB。
- 更新記憶體管理的數據結構。
- 恢復處理機上下文。
註:總而言之就是很耗資源
進程阻塞
正在執行的進程,由於期待的某些事件未發生,如請求系統資源失敗、等待某種操作的完成、新數據尚未到達或無新工作做等,則由系統自動執行阻塞原語(Block),使自己由運行狀態變為阻塞狀態。可見,進程的阻塞是進程自身的一種主動行為,也因此只有處於運行態的進程(獲得CPU),才可能將其轉為阻塞狀態。當進程進入阻塞狀態,是不佔用CPU資源的。
文件描述符
簡單理解:一個指向文件本身的指針(由系統所管理的引用標識,該標識可以被系統重新定位到一個記憶體地址上,間接訪問對象 ),值是非負整數。
文件描述符(File descriptor,簡稱fd)是電腦科學中的一個術語,是一個用於表述指向文件的引用的抽象化概念。
文件描述符在形式上是一個非負整數。實際上,它是一個索引值,指向內核為每一個進程所維護的該進程打開文件的記錄表。當程式打開一個現有文件或者創建一個新文件時,內核向進程返回一個文件描述符。在程式設計中,一些涉及底層的程式編寫往往會圍繞著文件描述符展開。但是文件描述符這一概念往往只適用於UNIX、Linux這樣的作業系統。
文件句柄
Windows下的概念。句柄是Windows下各種對象的標識符,比如文件、資源、菜單、游標等等。文件句柄和文件描述符類似,它也是一個非負整數,也用於定位文件數據在記憶體中的位置。
快取IO
大多數文件系統的默認IO都是快取IO。過程是:數據先被拷貝到作業系統的內核緩衝區(頁快取 page cache)中,然後再拷貝到應用程式的地址空間。
Linux 網路I/O模型
同步、非同步、阻塞、非阻塞的概念
同步
所謂同步,發起一個功能調用的時候,在沒有得到結果之前,該調用不返回,也就是必須一件事一件事的做,等前一件做完了,才能做下一件。
main函數
int main(){
add();
sout();
}
int add(){
return 1+1;
}
非同步

main函數

int main(){

ajax();

sout();

}


int ajax(){

return 1+1;

}
調用發出後,調用者不能立刻得到結果,而是實際處理這個調用的函數完成之後,通過狀態、通知和回調來通知調用者。
比如ajax:
請求通過事件觸發->伺服器處理(這是瀏覽器仍然可以作其他事情)->處理完畢
(在伺服器處理的時候,客戶端還可以干其他的事)
阻塞
指調用結果返回之前,當前執行緒會被掛起(CPU不給執行緒分配時間片),函數只能在得到結果之後才會返回。
(阻塞調用和同步調用的區別)同步調用的時候,當前執行緒仍然可能是激活的,只是在邏輯上當前函數沒有返回。例如:在Socket中調用recv函數,如果緩衝區沒有數據,這個函數會一直等待,知道數據返回。而在此時,這個執行緒還是可以處理其他消息的。
非阻塞
非阻塞調用指在不能立刻得到結果之前,該調用不會阻塞當前執行緒。
總結
同步是指A調用了B函數,B函數需要等處理完事情才會給A返回一個結果。A拿到結果繼續執行。
非同步是指A調用了B函數,A的任務就完成了,去繼續執行別的事了,等B處理完了事情,才會通知A。
阻塞是指,A調用了B函數,在B沒有返回結果的時候,A執行緒被CPU掛起,不能執行任何操作(這個執行緒不會被分配時間片)
非阻塞是指,A調用了B函數,A不用一直等待B返回結果,可以先去干別的事。
舉個例子
老張愛喝茶,廢話不說,煮開水。 出場人物:老張,水壺兩把(普通水壺,簡稱水壺;會響的水壺,簡稱響水壺)。
- 老張把水壺放到火上,立等水開。(同步阻塞) 老張覺得自己有點傻
- 老張把水壺放到火上,去客廳看電視,時不時去廚房看看水開沒有。(同步非阻塞) 老張還是覺得自己有點傻,於是變高端了,買了把會響笛的那種水壺。水開之後,能大聲發出嘀~~~~的噪音。
- 老張把響水壺放到火上,立等水開。(非同步阻塞) 老張覺得這樣傻等意義不大
- 老張把響水壺放到火上,去客廳看電視,水壺響之前不再去看它了,響了再去拿壺。(非同步非阻塞) 老張覺得自己聰明了。
所謂同步非同步,只是對於水壺而言。
普通水壺,同步;響水壺,非同步。雖然都能幹活,但響水壺可以在自己完工之後,提示老張水開了。這是普通水壺所不能及的。同步只能讓調用者去輪詢自己(情況2中),造成老張效率的低下。
所謂阻塞非阻塞,僅僅對於老張而言。立等的老張,阻塞;看電視的老張,非阻塞。情況1和情況3中老張就是阻塞的,媳婦喊他都不知道。雖然3中響水壺是非同步的,可對於立等的老張沒有太大的意義。所以一般非同步是配合非阻塞使用的,這樣才能發揮非同步的效用。
I/O模型
recvfrom函數用於從(已連接)套介面上接收數據,並捕獲數據發送源的地址。
本函數用於從(已連接)套介面上接收數據,並捕獲數據發送源的地址。
(簡單理解就是客戶端等待服務端給數據的函數)

舉個例子,其中的角色,客人(小明)對應內核執行緒,服務員對應的是用戶執行緒。現在大黃在南亭新開了一家黃燜雞,小明(客人)覺得很新鮮,準備喊上幾個基友去南亭搓一頓黃燜雞。
小明到店裡了,如果小明成功點餐則需要經過兩個步驟,第一步是思考要點什麼吃的,第二步是跟服務員說要吃什麼。
該模型的內核執行緒分為兩個階段
- 數據準備階段:(等待點餐)未阻塞,當數據準備完成之後,會主動的通知用戶進程數據已經準備完成,對用戶進程做一個回調。
- 數據拷貝階段:(進行點餐)阻塞用戶進程,等待數據拷貝。
阻塞 I/O(blocking IO)

現在黃燜雞的老闆大黃給每個客人都配一個服務員,只要有一個客人來的話,就在旁邊等客人思考吃什麼並且進行點餐。只要客人還沒有點餐完畢,對應的這個服務員就不能離開去做別的事情。
映射到Linux作業系統中,這就是阻塞的IO模型。在linux中,默認情況下所有的socket都是blocking,一個典型的讀操作流程大概是這樣:
用戶執行緒(服務員) 內核執行緒(客人)

當用戶進程調用了recvfrom這個系統調用,kernel就開始了IO的兩個階段:
準備數據(對於網路IO來說,很多時候數據在一開始還沒有到達。比如,還沒有收到一個完整的UDP包。這個時候kernel就要等待足夠的數據到來)。這個過程需要等待,也就是說數據被拷貝到作業系統內核的緩衝區中是需要一個過程的。而在用戶進程這邊,整個進程會被阻塞(當然,是進程自己選擇的阻塞)。- 當kernel一直等到數據準備好了,它就會
將數據從kernel中拷貝到用戶記憶體,然後kernel返回結果,用戶進程才解除block的狀態,重新運行起來。
所以,blocking IO的特點就是在IO執行的兩個階段(等待IO(準備IO)和執行IO)都被block了。
非阻塞 I/O(nonblocking IO)
現在隨著有些大學生月初拿到零花錢,開始浪了,黃燜雞的生意也變得越來越火爆了,來吃飯的客人越來越多,要配的服務員也越來越多,黃燜雞的老闆大黃心想這不對勁啊,要是突然同時來100個客人,就要有100個服務員,肯定巨虧啊,得想個法子提高效率。這時候老闆大黃想到,在客人想點什麼吃的時候,服務員完全可以去做別的事情,例如去給別的桌的客人點餐,只要偶爾過來問下客人是否要點餐了,一旦發現客人需要點餐了,就開始點餐。
映射到Linux作業系統中,這就是非阻塞的IO模型。linux下,可以通過設置socket使其變為non-blocking。當對一個non-blocking socket執行讀操作時,流程是這個樣子:

- 當用戶進程發出read操作時,如果kernel中的數據還沒有準備好,那麼它並不會block用戶進程,而是立刻返回一個error。從用戶進程角度講 ,它發起一個read操作後,並不需要等待,而是馬上就得到了一個結果。用戶進程判斷結果是一個error時,它就知道數據還沒有準備好,於是它可以再次發送read操作。
- 一旦kernel中的數據準備好了,並且又再次收到了用戶進程的system call,那麼它馬上就將數據拷貝到了用戶記憶體,然後返回。
所以,nonblocking IO的特點是用戶進程需要不斷的主動詢問kernel數據好了沒有。
訊號驅動I/O( signal driven IO )
過了一段時間,客人們好多都反應,你們服務員太煩人了,整天問我是不是可以點餐了,客人說我們乾脆要點餐的時候就叫服務員過來好了,老闆大黃心想這樣也不錯,能提高餐廳的運行效率,賺多點錢,便答應了(這時候的服務員還在客人旁邊傻乎乎的站著,只等著客人喊他點餐)。
映射到Linux作業系統中,這就是訊號驅動I/O。當數據報準備好的時候,內核會嚮應用程式發送一個訊號,進程對訊號進行捕捉,並且調用訊號處理函數來獲取數據報。

I/O 多路復用( IO multiplexing)
老闆大黃巡查店內情況,看到了服務員大多都傻乎乎的站著等客人喊他點餐,作為資本家的大黃,當然是要充分利用勞動力的。所以老闆給服務員們開了個會,安排他們一個人負責一個區域(多個客人)的客人點餐需求,等到客人喊他點餐時,就過去點餐。
映射到Linux作業系統中,這就是I/O 多路復用。IO multiplexing就是我們說的select,poll,epoll,有些地方也稱這種IO方式為event driven IO。select/epoll的好處就在於單個process就可以同時處理多個網路連接的IO。它的基本原理就是select,poll,epoll這個function會不斷的輪詢所負責的所有socket,當某個socket有數據到達了,就通知用戶進程。

當用戶進程調用了select,那麼整個進程會被block,而同時,kernel會「監視」所有select負責的socket,當任何一個socket中的數據準備好了,select就會返回。這個時候用戶進程再調用read操作,將數據從kernel拷貝到用戶進程。
所以,I/O 多路復用的特點是通過一種機制
一個進程能同時等待多個文件描述符,而這些文件描述符(套接字描述符)其中的任意一個進入讀就緒狀態,select()函數就可以返回。
這個圖和blocking IO的圖其實並沒有太大的不同,事實上,還更差一些。因為這裡需要使用兩個system call (select 和 recvfrom),而blocking IO只調用了一個system call (recvfrom)。但是,用select的優勢在於它可以同時處理多個connection。
所以,如果處理的連接數不是很高的話,使用select/epoll的web server不一定比使用multi-threading + blocking IO的web server性能更好,可能延遲還更大。select/epoll的優勢並不是對於單個連接能處理得更快,而是在於能處理更多的連接。)
在IO multiplexing Model中,實際中,對於每一個socket,一般都設置成為non-blocking,但是,如上圖所示,整個用戶的process其實是一直被block的。只不過process是被select這個函數block,而不是被socket IO給block。
非同步 I/O(asynchronous IO)
後來,隨著黃燜雞的味道大家都比較喜愛,口碑逐漸建立了起來,生意越發地火爆,常常座無虛席,大黃也開始夢想著多久能實現一個小目標。大學城裡有些創業團隊看到了黃燜雞的火爆程度,看到服務員有很多時候是在給客人點餐,他們結合自己的專業知識,跟老闆說給老闆開發個手機點餐系統,客人通過手機就能點餐,服務員只需要查看系統的點餐情況進行上菜就好,老闆大黃一看,秒啊,急忙答應了,通過點餐系統,餐廳運行效率更高了,接待的客人也越來越多,離一個小目標的夢想也越來越近了。
映射到Linux作業系統中,這就是非同步 I/O。Linux下的asynchronous IO其實用得很少。先看一下它的流程:
用戶進程發起read操作之後,立刻就可以開始去做其它的事。而另一方面,從kernel的角度,當它受到一個asynchronous read之後,首先它會立刻返回,所以不會對用戶進程產生任何block。然後,kernel會等待數據準備完成,然後將數據拷貝到用戶記憶體,當這一切都完成之後,kernel會給用戶進程發送一個signal,告訴它read操作完成了。
用戶進程只需要知道內核執行緒處理的結果
5中I/O模型對比

IO多路復用的三種機制
select
數組(長度1024)存儲所有的fd
說的通俗一點就是各個客戶端連接的文件描述符也就是套接字,都被放到了一個集合中,調用select函數之後會一直監視這些文件描述符中有哪些可讀,如果有可讀的描述符那麼我們的工作進程就去讀取資源。
select 在一個進程內可以維持最多 1024 個連接
poll
鏈表存儲所有的fd
poll 和 select 的實現非常類似,本質上的區別就是存放 fd 集合的數據結構不一樣。poll 在select基礎上做了加強,可以維持任意數量的連接。
但 select 和 poll 方式有一個很大的問題就是,我們不難看出來 select和poll 是通過輪循的方式來查找是否可讀或者可寫,打個比方,如果同時有100萬個連接都沒有斷開,而只有一個客戶端發送了數據,所以這裡它還是需要循環這麼多次,造成資源浪費。
epoll
鏈表存儲ready的fd
不需要遍歷全部fd去找ready的,其全部的fd放在一個紅黑樹中加以維護。
epoll 是 select 和 poll 的增強版,epoll 同 poll 一樣,文件描述符數量無限制。
epoll是基於內核的反射機制,在有活躍的 socket 時,系統會調用我們提前設置的回調函數。而 poll 和 select 都是遍歷。
但是也並不是所有情況下 epoll 都比 select/poll 好,比如在如下場景:
在大多數客戶端都很活躍的情況下,系統會把所有的回調函數都喚醒,所以會導致負載較高。既然要處理這麼多的連接,那倒不如 select 遍歷簡單有效。
NIO入門
引言
在Java中提供了三種IO模型:BIO、NIO、AIO,模型的選擇決定了程式通訊的性能。
使用場景
-
BIO
BIO適用於連接數比較小的應用,這種IO模型對伺服器資源要求比較高。 -
NIO
NIO適用於連接數目多、連接時間短的應用,比如聊天、彈幕、伺服器間通訊等應用。 -
AIO
AIO適用於連接數目多、連接時間長的應用,比如相冊伺服器。
BIO
同步阻塞式
無腦創建執行緒

偽非同步I/O阻塞式
改用執行緒池

NIO
同步非阻塞模型,伺服器端用一個執行緒處理多個連接,客戶端發送的連接請求會註冊到多路復用器上,多路復用器輪詢到連接有IO請求就進行處理:

NIO的非阻塞模式,使得一個執行緒從某通道發送請求或者讀取數據時,如果目前沒有可用的數據,不會使執行緒阻塞,在數據可讀之前,該執行緒可以做其他的事情。
NIO有三大核心部分:
- Channel(通道)
- Buffer(緩衝區)
- Selector(選擇器)


由圖可知:
- 每個Channel對應一個Buffer。
- Selector對應一個執行緒,一個執行緒對應多個Channel。
- Selector會根據不同的事件,在各個通道上切換。
- Buffer是記憶體塊,底層是數據。
緩衝區(Buffer)
本質是可以讀寫數據的記憶體塊,Channel讀取或者寫入的數據必須通過Buffer:

java.nio.Buffer抽象類的屬性:
複製程式碼
// Invariants: mark <= position <= limit <= capacity
private int mark = -1;
private int position = 0;
private int limit;
private int capacity;
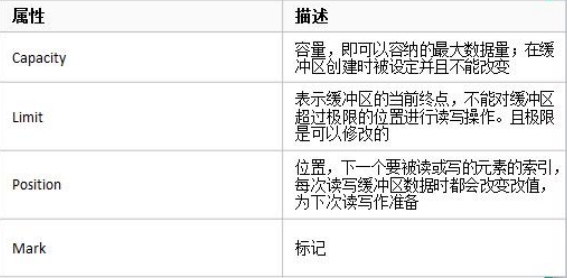
讀寫交換要使用flip方法。
通道(Channel)
通道是雙向的,可以讀操作、也可以寫操作。
java.nio.channels.Channel介面的常用實現類:

FileChannel用於文件的數據讀寫,DatagramChannel用於UDP的數據讀寫,ServerSocketChannel和SocketChannel用於TCP的數據讀寫。
選擇器(Selector)
Selector選擇器使用一個執行緒來維護。多個Channel會以事件的方式註冊到同一個Selector,當有事件發生時,Selector會獲取事件,然後針對每個事件進行響應的處理。這樣就不必為每個連接創建一個執行緒,不用維護多執行緒,也不會有多執行緒之間的上下文切換導致的系統的開銷。
Selector示意圖:

AIO
非同步非阻塞模型,AIO引入非同步通道的概念,使用了Proactor,只有有效的請求才啟動執行緒,特點是先由作業系統完成後,才通知伺服器端程式啟動執行緒去處理,一般適用於連接數較多且連接時間較長的應用。
對比

Reactor執行緒模型
Reactor執行緒模型是基於同步非阻塞IO實現的。對於非同步非阻塞IO的實現是Proactor模型。
Netty就是基於Reactor執行緒模型開發的,我們今天來簡單分析下:
Reactor模型中的三種角色及含義:
    Reactor:將I/O事件分配給對應的handler。
    Acceptor:處理客戶端新連接,並分派請求到處理器鏈中。
    Handlers:執行非阻塞讀寫任務。

Reactor常用的執行緒模型有三種

Reactor單執行緒模型
單執行緒模型簡圖

單執行緒模型就是指所有的I/O操作都是在一個執行緒中處理完成,NIO的執行緒需要接受客戶端的Tcp連接,並且向客戶端發送Tcp連接,讀取通訊兩端的請求或應答,發送請求和應答。
單執行緒模型詳細圖解

大致了解了後,讓我們看下這個詳細流程,當客戶端發起連接,Acceptor負責接收客戶端的Tcp請求,鏈路建立成功後,通過Dispatcher將對應的ByteBuffer派發到指定的Hnadler上進行消息解碼,用戶Handler通過NIO執行緒將消息發送給客戶端。單執行緒模型其實就是Acceptor的處理和Handler的處理都處在同一個執行緒中,當其中的一個Hnadler阻塞時,會導致其它的client和handler無法執行,甚至整個服務不能接受新的請求。
單執行緒模型缺點:不適用於高負載,高並發的場景。
因為一個NIO執行緒如果同時處理很多的鏈路,則機器在性能上無法滿足海量的消息的編碼,解碼,讀取和發送。如果NIO執行緒負載過重,處理速度變慢,會導致大量的客戶端請求超時,甚至導致整個通訊模組不可用。
Reactor多執行緒模型
為了解決單執行緒模型的缺點,設計出了多執行緒模型。如下簡圖:
多執行緒模型簡圖

如圖所示在多執行緒模型下,用一個專門的NIO執行緒Acceptor來監聽客戶端的Tcp請求,對於網路I/O的讀寫操作和消息的讀取、編碼、解碼、發送等使用NIO執行緒池來完成。因為客戶端請求數量大於NIO執行緒池中的執行緒,一個NIO執行緒可以同時處理多條鏈路請求,但是一個鏈路請求只對應一個NIO執行緒。Reactor多執行緒模型能夠大多數的使用場景,但是當客戶端的並發連接非常的多,或者是服務端需要對客戶端進行安全認證等,單個Acceptor執行緒可能會存在性能不足的問題。
主從Reactor多執行緒模型

Reactor的主從多執行緒模型
如圖所示,從這個簡圖可以看出,服務端用於監聽和接收客戶端連接的不再是單個執行緒,而是分配了一個執行緒池。Acceptor執行緒池接收了客戶端的請求連接並處理完成後(可能包含了許可權認證等),後續的I/O操作再由NIO執行緒池來完成。這樣就解決了多執行緒中客戶端請求太多或者需要認證時一個Acceptor可能處理不過來的性能問題。
netty的執行緒模型
netty的執行緒模型是可以通過設置啟動類的參數來配置的,設置不同的啟動參數,netty支援Reactor單執行緒模型、多執行緒模型和主從Reactor多執行緒模型。
server端工作原理

NettyServer整體架構圖.png
server端啟動時綁定本地某個埠,將自己NioServerSocketChannel註冊到某個boss NioEventLoop的selector上。
server端包含1個boss NioEventLoopGroup和1個worker NioEventLoopGroup,NioEventLoopGroup相當於1個事件循環組,這個組裡包含多個事件循環NioEventLoop,每個NioEventLoop包含1個selector和1個事件循環執行緒。
每個boss NioEventLoop循環執行的任務包含3步:
- 第1步:輪詢accept事件;
- 第2步:處理io任務,即accept事件,與client建立連接,生成NioSocketChannel,並將NioSocketChannel註冊到某個worker NioEventLoop的selector上;
- 第3步:處理任務隊列中的任務,runAllTasks。任務隊列中的任務包括用戶調用eventloop.execute或schedule執行的任務,或者其它執行緒提交到該eventloop的任務。
每個worker NioEventLoop循環執行的任務包含3步:
- 第1步:輪詢read、write事件;
- 第2步:處理io任務,即read、write事件,在NioSocketChannel可讀、可寫事件發生時進行處理;
- 第3步:處理任務隊列中的任務,runAllTasks。
client端工作原理

NettyClient整體架構圖.png
client端啟動時connect到server,建立NioSocketChannel,並註冊到某個NioEventLoop的selector上。
client端只包含1個NioEventLoopGroup,每個NioEventLoop循環執行的任務包含3步:
- 第1步:輪詢connect、read、write事件;
- 第2步:處理io任務,即connect、read、write事件,在NioSocketChannel連接建立、可讀、可寫事件發生時進行處理;
- 第3步:處理非io任務,runAllTasks。
服務端啟動時創建了兩個NioEventLoopGroup,一個是boss,一個是worker。實際上他們是兩個獨立的Reactor執行緒池,一個用於接收客戶端的TCP連接,另一個用於處理Io相關的讀寫操作,或者執行系統/定時任務的task。
簡單版


boss執行緒池作用:
(1)接收客戶端的連接,初始化Channel參數
(2)將鏈路狀態變更時間通知給ChannelPipeline
worker執行緒池作用:
(1)非同步讀取通訊對端的數據報,發送讀事件到ChannelPipeline
(2)非同步發送消息到通訊對端,調用ChannelPipeline的消息發送介面
(3)執行系統調用Task
(4)執行定時任務Task
通過配置boss和worker執行緒池的執行緒個數以及是否共享執行緒池等方式,netty的執行緒模型可以在單執行緒、多執行緒、主從執行緒之間切換。
為了提升性能,netty在很多地方都進行了無鎖設計。比如在IO執行緒內部進行串列操作,避免多執行緒競爭造成的性能問題。表面上似乎串列化設計似乎CPU利用率不高,但是通過調整NIO執行緒池的執行緒參數,可以同時啟動多個串列化的執行緒並行運行,這種局部無鎖串列執行緒設計性能更優。
nettyd的NioEventLoop讀取到消息之後,直接調用ChannelPipeline的fireChannelRead(Object msg),只要用戶不主動切換執行緒,一直都是由NioEventLoop調用用戶的Handler,期間不進行執行緒切換,這種串列化設計避免了多執行緒操作導致的鎖競爭,性能角度看是最優的。
Netty 的三層架構設計
Netty 採用了典型的三層網路架構進行設計和開發,其邏輯架構圖如下所示。

通訊調度層 Reactor
它由一系列輔助類完成,包括 Reactor 執行緒 NioEventLoop 及其父類,NioSocketChannel / NioServerSocketChannel 及其父類,Buffer 組件,Unsafe 組件 等。該層的主要職責就是監聽網路的讀寫和連接操作,負責將網路層的數據讀取到記憶體緩衝區,然後觸發各種網路事件,例如連接創建、連接激活、讀事件、寫事件等,將這些事件觸發到 PipeLine 中,由 PipeLine 管理的責任鏈來進行後續的處理。
責任鏈層 Pipeline
它負責上述的各種網路事件在責任鏈中的有序傳播,同時負責動態地編排責任鏈。責任鏈可以選擇監聽和處理自己關心的事件,它可以攔截處理事件,以及向前向後傳播事件。不同應用的 Handler 節點 的功能也不同,通常情況下,往往會開發編解碼 Hanlder 用於消息的編解碼,可以將外部的協議消息轉換成 內部的 POJO 對象,這樣上層業務則只需要關心處理業務邏輯即可,不需要感知底層的協議差異和執行緒模型差異,實現了架構層面的分層隔離。
業務邏輯編排層 Service ChannelHandler
業務邏輯編排層通常有兩類:一類是純粹的業務邏輯編排,還有一類是其他的應用層協議插件,用於特定協議相關的會話和鏈路管理。例如,CMPP 協議,用於管理和中國移動簡訊系統的對接。
架構的不同層面,需要關心和處理的對象都不同,通常情況下,對於業務開發者,只需要關心責任鏈的攔截和業務 Handler 的編排。因為應用層協議棧往往是開發一次,到處運行,所以實際上對於業務開發者來說,只需要關心服務層的業務邏輯開發即可。各種應用協議以插件的形式提供,只有協議開發人員需要關注協議插件,對於其他業務開發人員來說,只需關心業務邏輯訂製。這種分層的架構設計理念實現了 NIO 框架 各層之間的解耦,便於上層業務協議棧的開發和業務邏輯的訂製。
正是由於 Netty 的分層架構設計非常合理,基於 Netty 的各種應用伺服器和協議棧開發才能夠如雨後春筍般得到快速發展。
參考資料
《Netty權威指南》
(22 封私信 / 21 條消息) 怎樣理解阻塞非阻塞與同步非同步的區別? - 知乎
linux的五種IO模型 - lovejune - 部落格園
Linux 下的五種 IO 模型詳細介紹_Linux_腳本之家
Linux IO模式及 select、poll、epoll詳解 - 人云思雲 - SegmentFault 思否
(2條消息)從bio到nio到netty實現原理淺析_嘎嘎的部落格-CSDN部落格_netty nio
深入了解Netty【一】BIO、NIO、AIO簡單介紹 - clawhub - 部落格園
Reactor 執行緒模型以及在netty中的應用 - balfish - 部落格園

