Spark 系列(十一)—— Spark SQL 聚合函數 Aggregations
- 2019 年 10 月 3 日
- 筆記
一、簡單聚合
1.1 數據準備
// 需要導入 spark sql 內置的函數包 import org.apache.spark.sql.functions._ val spark = SparkSession.builder().appName("aggregations").master("local[2]").getOrCreate() val empDF = spark.read.json("/usr/file/json/emp.json") // 註冊為臨時視圖,用於後面演示 SQL 查詢 empDF.createOrReplaceTempView("emp") empDF.show()註:emp.json 可以從本倉庫的resources 目錄下載。
1.2 count
// 計算員工人數 empDF.select(count("ename")).show()1.3 countDistinct
// 計算姓名不重複的員工人數 empDF.select(countDistinct("deptno")).show()1.4 approx_count_distinct
通常在使用大型數據集時,你可能關注的只是近似值而不是準確值,這時可以使用 approx_count_distinct 函數,並可以使用第二個參數指定最大允許誤差。
empDF.select(approx_count_distinct ("ename",0.1)).show()1.5 first & last
獲取 DataFrame 中指定列的第一個值或者最後一個值。
empDF.select(first("ename"),last("job")).show()1.6 min & max
獲取 DataFrame 中指定列的最小值或者最大值。
empDF.select(min("sal"),max("sal")).show()1.7 sum & sumDistinct
求和以及求指定列所有不相同的值的和。
empDF.select(sum("sal")).show() empDF.select(sumDistinct("sal")).show()1.8 avg
內置的求平均數的函數。
empDF.select(avg("sal")).show()1.9 數學函數
Spark SQL 中還支援多種數學聚合函數,用於通常的數學計算,以下是一些常用的例子:
// 1.計算總體方差、均方差、總體標準差、樣本標準差 empDF.select(var_pop("sal"), var_samp("sal"), stddev_pop("sal"), stddev_samp("sal")).show() // 2.計算偏度和峰度 empDF.select(skewness("sal"), kurtosis("sal")).show() // 3. 計算兩列的皮爾遜相關係數、樣本協方差、總體協方差。(這裡只是演示,員工編號和薪資兩列實際上並沒有什麼關聯關係) empDF.select(corr("empno", "sal"), covar_samp("empno", "sal"),covar_pop("empno", "sal")).show()1.10 聚合數據到集合
scala> empDF.agg(collect_set("job"), collect_list("ename")).show() 輸出: +--------------------+--------------------+ | collect_set(job)| collect_list(ename)| +--------------------+--------------------+ |[MANAGER, SALESMA...|[SMITH, ALLEN, WA...| +--------------------+--------------------+二、分組聚合
2.1 簡單分組
empDF.groupBy("deptno", "job").count().show() //等價 SQL spark.sql("SELECT deptno, job, count(*) FROM emp GROUP BY deptno, job").show() 輸出: +------+---------+-----+ |deptno| job|count| +------+---------+-----+ | 10|PRESIDENT| 1| | 30| CLERK| 1| | 10| MANAGER| 1| | 30| MANAGER| 1| | 20| CLERK| 2| | 30| SALESMAN| 4| | 20| ANALYST| 2| | 10| CLERK| 1| | 20| MANAGER| 1| +------+---------+-----+2.2 分組聚合
empDF.groupBy("deptno").agg(count("ename").alias("人數"), sum("sal").alias("總工資")).show() // 等價語法 empDF.groupBy("deptno").agg("ename"->"count","sal"->"sum").show() // 等價 SQL spark.sql("SELECT deptno, count(ename) ,sum(sal) FROM emp GROUP BY deptno").show() 輸出: +------+----+------+ |deptno|人數|總工資| +------+----+------+ | 10| 3|8750.0| | 30| 6|9400.0| | 20| 5|9375.0| +------+----+------+三、自定義聚合函數
Scala 提供了兩種自定義聚合函數的方法,分別如下:
- 有類型的自定義聚合函數,主要適用於 DataSet;
- 無類型的自定義聚合函數,主要適用於 DataFrame。
以下分別使用兩種方式來自定義一個求平均值的聚合函數,這裡以計算員工平均工資為例。兩種自定義方式分別如下:
3.1 有類型的自定義函數
import org.apache.spark.sql.expressions.Aggregator import org.apache.spark.sql.{Encoder, Encoders, SparkSession, functions} // 1.定義員工類,對於可能存在 null 值的欄位需要使用 Option 進行包裝 case class Emp(ename: String, comm: scala.Option[Double], deptno: Long, empno: Long, hiredate: String, job: String, mgr: scala.Option[Long], sal: Double) // 2.定義聚合操作的中間輸出類型 case class SumAndCount(var sum: Double, var count: Long) /* 3.自定義聚合函數 * @IN 聚合操作的輸入類型 * @BUF reduction 操作輸出值的類型 * @OUT 聚合操作的輸出類型 */ object MyAverage extends Aggregator[Emp, SumAndCount, Double] { // 4.用於聚合操作的的初始零值 override def zero: SumAndCount = SumAndCount(0, 0) // 5.同一分區中的 reduce 操作 override def reduce(avg: SumAndCount, emp: Emp): SumAndCount = { avg.sum += emp.sal avg.count += 1 avg } // 6.不同分區中的 merge 操作 override def merge(avg1: SumAndCount, avg2: SumAndCount): SumAndCount = { avg1.sum += avg2.sum avg1.count += avg2.count avg1 } // 7.定義最終的輸出類型 override def finish(reduction: SumAndCount): Double = reduction.sum / reduction.count // 8.中間類型的編碼轉換 override def bufferEncoder: Encoder[SumAndCount] = Encoders.product // 9.輸出類型的編碼轉換 override def outputEncoder: Encoder[Double] = Encoders.scalaDouble } object SparkSqlApp { // 測試方法 def main(args: Array[String]): Unit = { val spark = SparkSession.builder().appName("Spark-SQL").master("local[2]").getOrCreate() import spark.implicits._ val ds = spark.read.json("file/emp.json").as[Emp] // 10.使用內置 avg() 函數和自定義函數分別進行計算,驗證自定義函數是否正確 val myAvg = ds.select(MyAverage.toColumn.name("average_sal")).first() val avg = ds.select(functions.avg(ds.col("sal"))).first().get(0) println("自定義 average 函數 : " + myAvg) println("內置的 average 函數 : " + avg) } }自定義聚合函數需要實現的方法比較多,這裡以繪圖的方式來演示其執行流程,以及每個方法的作用:
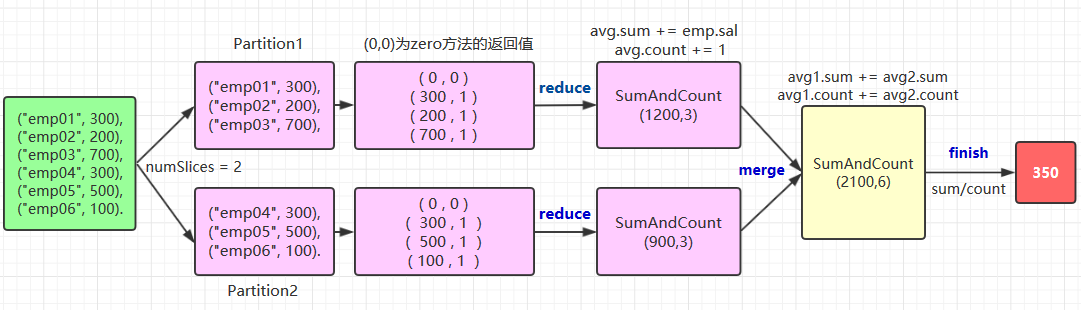
關於 zero,reduce,merge,finish 方法的作用在上圖都有說明,這裡解釋一下中間類型和輸出類型的編碼轉換,這個寫法比較固定,基本上就是兩種情況:
- 自定義類型 Case Class 或者元組就使用
Encoders.product方法; - 基本類型就使用其對應名稱的方法,如
scalaByte,scalaFloat,scalaShort等,示例如下:
override def bufferEncoder: Encoder[SumAndCount] = Encoders.product override def outputEncoder: Encoder[Double] = Encoders.scalaDouble3.2 無類型的自定義聚合函數
理解了有類型的自定義聚合函數後,無類型的定義方式也基本相同,程式碼如下:
import org.apache.spark.sql.expressions.{MutableAggregationBuffer, UserDefinedAggregateFunction} import org.apache.spark.sql.types._ import org.apache.spark.sql.{Row, SparkSession} object MyAverage extends UserDefinedAggregateFunction { // 1.聚合操作輸入參數的類型,欄位名稱可以自定義 def inputSchema: StructType = StructType(StructField("MyInputColumn", LongType) :: Nil) // 2.聚合操作中間值的類型,欄位名稱可以自定義 def bufferSchema: StructType = { StructType(StructField("sum", LongType) :: StructField("MyCount", LongType) :: Nil) } // 3.聚合操作輸出參數的類型 def dataType: DataType = DoubleType // 4.此函數是否始終在相同輸入上返回相同的輸出,通常為 true def deterministic: Boolean = true // 5.定義零值 def initialize(buffer: MutableAggregationBuffer): Unit = { buffer(0) = 0L buffer(1) = 0L } // 6.同一分區中的 reduce 操作 def update(buffer: MutableAggregationBuffer, input: Row): Unit = { if (!input.isNullAt(0)) { buffer(0) = buffer.getLong(0) + input.getLong(0) buffer(1) = buffer.getLong(1) + 1 } } // 7.不同分區中的 merge 操作 def merge(buffer1: MutableAggregationBuffer, buffer2: Row): Unit = { buffer1(0) = buffer1.getLong(0) + buffer2.getLong(0) buffer1(1) = buffer1.getLong(1) + buffer2.getLong(1) } // 8.計算最終的輸出值 def evaluate(buffer: Row): Double = buffer.getLong(0).toDouble / buffer.getLong(1) } object SparkSqlApp { // 測試方法 def main(args: Array[String]): Unit = { val spark = SparkSession.builder().appName("Spark-SQL").master("local[2]").getOrCreate() // 9.註冊自定義的聚合函數 spark.udf.register("myAverage", MyAverage) val df = spark.read.json("file/emp.json") df.createOrReplaceTempView("emp") // 10.使用自定義函數和內置函數分別進行計算 val myAvg = spark.sql("SELECT myAverage(sal) as avg_sal FROM emp").first() val avg = spark.sql("SELECT avg(sal) as avg_sal FROM emp").first() println("自定義 average 函數 : " + myAvg) println("內置的 average 函數 : " + avg) } }參考資料
- Matei Zaharia, Bill Chambers . Spark: The Definitive Guide[M] . 2018-02
更多大數據系列文章可以參見 GitHub 開源項目: 大數據入門指南