Elasticsearch集群搭建
- 2019 年 10 月 16 日
- 筆記
Elasticsearch單機版安裝:https://www.cnblogs.com/biehongli/p/11643482.html
1、Elasticsearch集群版安裝,這裡進行模擬,是偽集群版的安裝,我使用一台機器,通過修改埠號的方式進行偽集群的搭建。
注意:由於單機版的安裝過程中出現了各種錯誤,所以集群版我是直接複製修改好的單機版的(注意:home/hadoop/soft/el_slave/elasticsearch-5.4.3-slaver1/data裡面有一個nodes文件夾,將該文件夾刪除即可,下面也會提及)。我沒有再次通過解壓縮安裝包的方式,因為單機版報了不少錯誤,所以用解決完錯誤的更快些。
Elasticsearch集群版的搭建,是一主二從的方式,即一個master主節點,兩個slaver從節點。(備註,我第一次搭建的作為了主節點了,請自行腦補)。
我這裡先創建一個el_slave文件夾,然後將第一次單機版的Elasticsearch複製兩份,備用。
1 [elsearch@slaver4 soft]$ mkdir el_slave 2 [elsearch@slaver4 soft]$ ls 3 elasticsearch-5.4.3 elasticsearch-head-master el_slave node-v8.16.2-linux-x64 4 [elsearch@slaver4 soft]$ cp -r elasticsearch-5.4.3/ el_slave/ 5 [elsearch@slaver4 soft]$ ls 6 elasticsearch-5.4.3 elasticsearch-head-master el_slave node-v8.16.2-linux-x64 7 [elsearch@slaver4 soft]$ cd el_slave/ 8 [elsearch@slaver4 el_slave]$ ls 9 elasticsearch-5.4.3 10 [elsearch@slaver4 el_slave]$ mv elasticsearch-5.4.3/ elasticsearch-5.4.3-slaver1 11 [elsearch@slaver4 el_slave]$ cp -r elasticsearch-5.4.3-slaver1/ elasticsearch-5.4.3-slaver2 12 [elsearch@slaver4 el_slave]$ ls 13 elasticsearch-5.4.3-slaver1 elasticsearch-5.4.3-slaver2 14 [elsearch@slaver4 el_slave]$
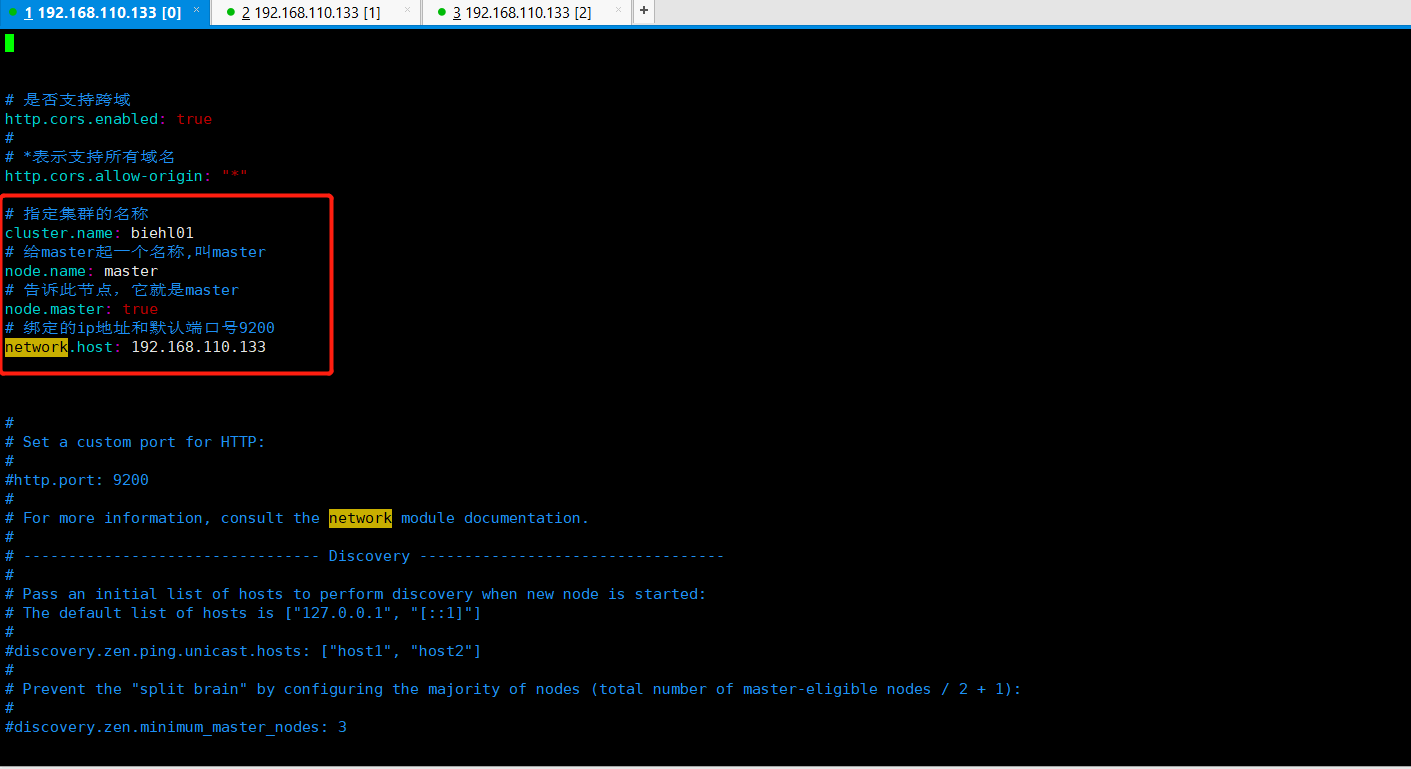
2、開始zao起來,修改主節點的配置文件/home/hadoop/soft/elasticsearch-5.4.3/config/elasticsearch.yml。添加如下所示的內容。
1 # 指定集群的名稱 2 cluster.name: biehl01 3 # 給master起一個名稱,叫master 4 node.name: master 5 # 告訴此節點,它就是master 6 node.master: true 7 # 綁定的ip地址和默認埠號9200 8 network.host: 192.168.110.133
操作如下所示:
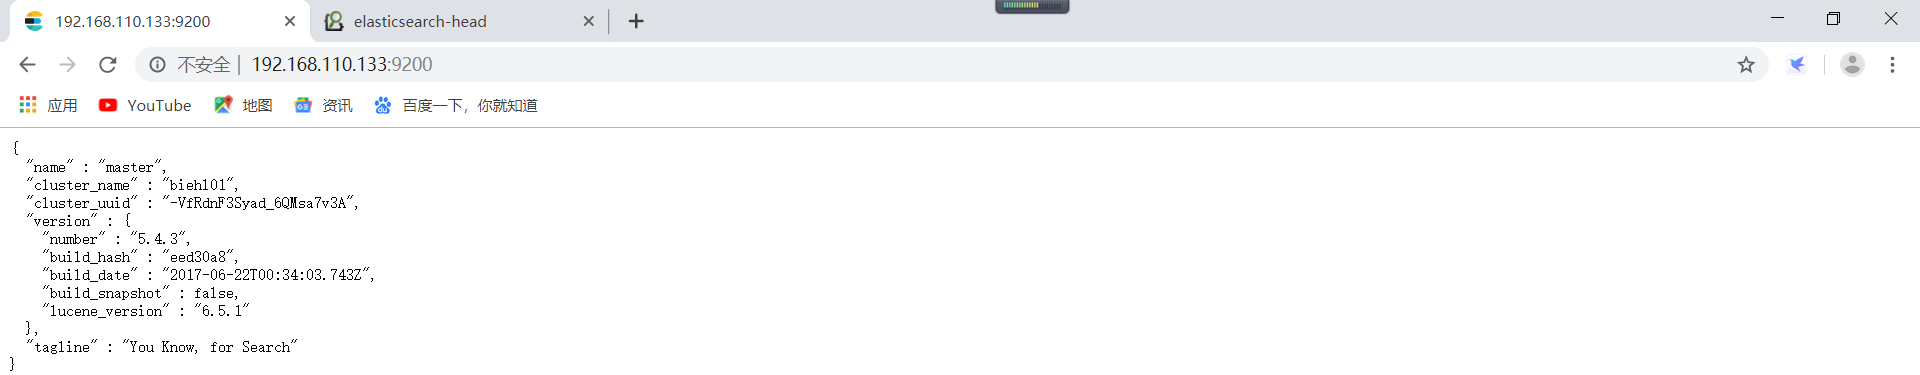
修改主節點配置文件,以後重啟一下elasticsearch,查看效果,如下所示:
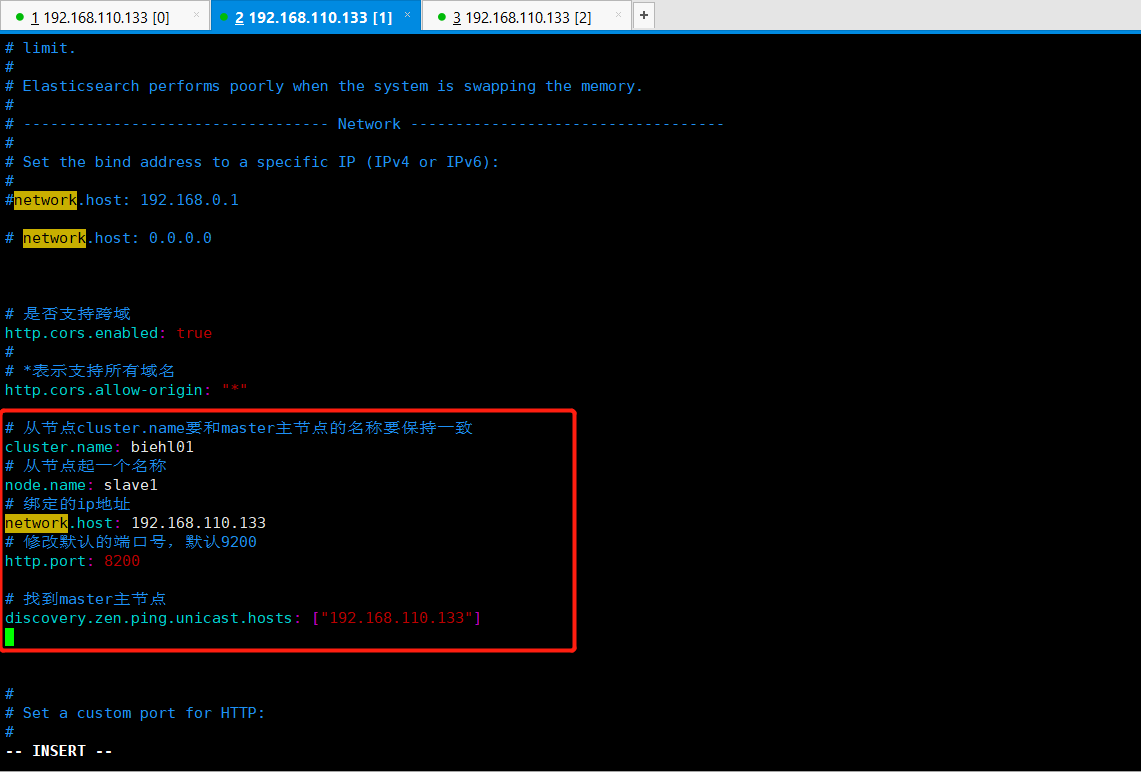
3、主節點修改,完畢開始修改從節點的配置文件,修改內容如下所示:
1 # 從節點cluster.name要和master主節點的名稱要保持一致 2 cluster.name: biehl01 3 # 從節點起一個名稱 4 node.name: slave1 5 # 綁定的ip地址 6 network.host: 192.168.110.133 7 # 修改默認的埠號,默認9200 8 http.port: 8200 9 10 # 找到master主節點 11 discovery.zen.ping.unicast.hosts: ["192.168.110.133"]
從節點一配置如下所示:
從節點二配置文件裡面添加如下所示內容:
1 # 從節點cluster.name要和master主節點的名稱要保持一致 2 cluster.name: biehl01 3 # # 從節點起一個名稱 4 node.name: slave2 5 # # 綁定的ip地址 6 network.host: 192.168.110.133 7 # # 修改默認的埠號,默認9200 8 http.port: 7200 9 # 10 # # 找到master主節點,discovery.zen.minimum_master_nodes的值計算是節點總數/2 + 1(三個節點就是寫2即可) 11 # discovery.zen.minimum_master_nodes: 2 12 discovery.zen.ping.unicast.hosts: ["192.168.110.133"]
從節點二配置如下所示:
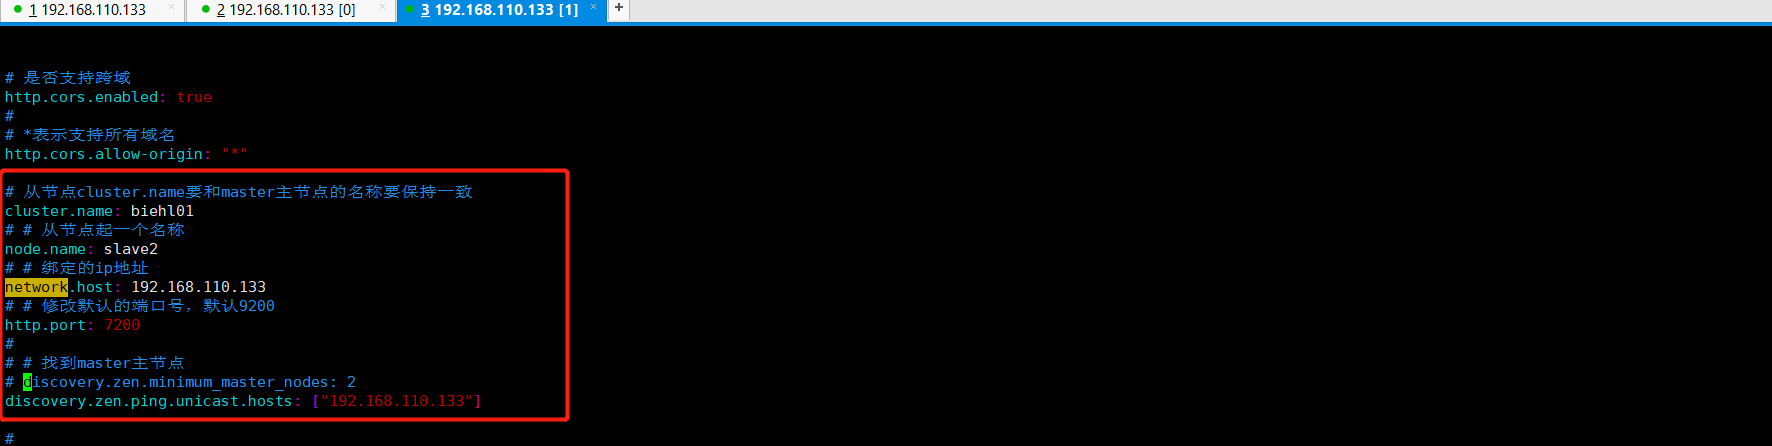
修改完畢,主節點,從節點一二,開始啟動,三個節點,發現自己有點單蠢了呢。開始三個節點後台啟動,使用jps顯示三個進程,但是介面就是顯示不了從節點一二,主要造成這個的原因是我複製了主節點,然後分析一下原因,我前台啟動,發現報錯了,錯誤如下所示:
1 # 主節點的報錯 2 [master] failed to send join request to master [{slave1}{rYUCm8sMRzaXu84zRj3duQ}{qL5ICfOKQKyDTaRytL5vGg}{192.168.110.133}{192.168.110.133:9301}], reason [RemoteTransportException[[slave1][192.168.110.133:9301][internal:discovery/zen/join]]; nested: NotMasterException[Node [{slave1}{rYUCm8sMRzaXu84zRj3duQ}{qL5ICfOKQKyDTaRytL5vGg}{192.168.110.133}{192.168.110.133:9301}] not master for join request]; ], tried [3] times 3 4 # 從節點的報錯 5 [slave1] failed to send join request to master [{slave2}{rYUCm8sMRzaXu84zRj3duQ}{jY1TxxwdSkaZkQqdsNTGaQ}{192.168.110.133}{192.168.110.133:9302}], reason [RemoteTransportException[[slave2][192.168.110.133:9302][internal:discovery/zen/join]]; nested: NotMasterException[Node [{slave2}{rYUCm8sMRzaXu84zRj3duQ}{jY1TxxwdSkaZkQqdsNTGaQ}{192.168.110.133}{192.168.110.133:9302}] not master for join request]; ], tried [3] times
錯誤原因:每個節點索引分片的分配在每新增一個節點都要重新進行一次分配。
在home/hadoop/soft/el_slave/elasticsearch-5.4.3-slaver1/data裡面有一個nodes文件夾,將該文件夾刪除即可。然後重啟從節點一,從節點二,問題解決。
1 [elsearch@slaver4 elasticsearch-5.4.3-slaver1]$ ls 2 bin config data hs_err_pid11491.log lib LICENSE.txt logs modules NOTICE.txt plugins README.textile 3 [elsearch@slaver4 elasticsearch-5.4.3-slaver1]$ cd data/ 4 [elsearch@slaver4 data]$ ls 5 nodes 6 [elsearch@slaver4 data]$ rm -rf nodes/ 7 [elsearch@slaver4 data]$ ls
1 [elsearch@slaver4 elasticsearch-5.4.3-slaver2]$ ls 2 bin config data hs_err_pid11491.log lib LICENSE.txt logs modules NOTICE.txt plugins README.textile 3 [elsearch@slaver4 elasticsearch-5.4.3-slaver2]$ cd data/ 4 [elsearch@slaver4 data]$ ls 5 nodes 6 [elsearch@slaver4 data]$ rm -rf nodes/ 7 [elsearch@slaver4 data]$ ls
重新啟動三個節點,啟動以後如下所示:
注意:elasticsearch 集群搭建起來,為什麼head只顯示master?(為什麼我啟動三個es後 head中只顯示了一個master節點)。這種問題,我估計就是自己是複製的主節點的,需要將home/hadoop/soft/el_slave/elasticsearch-5.4.3-slaver1/data/nodes,這個nodes文件夾刪除,重新生成,我是這樣操作的。
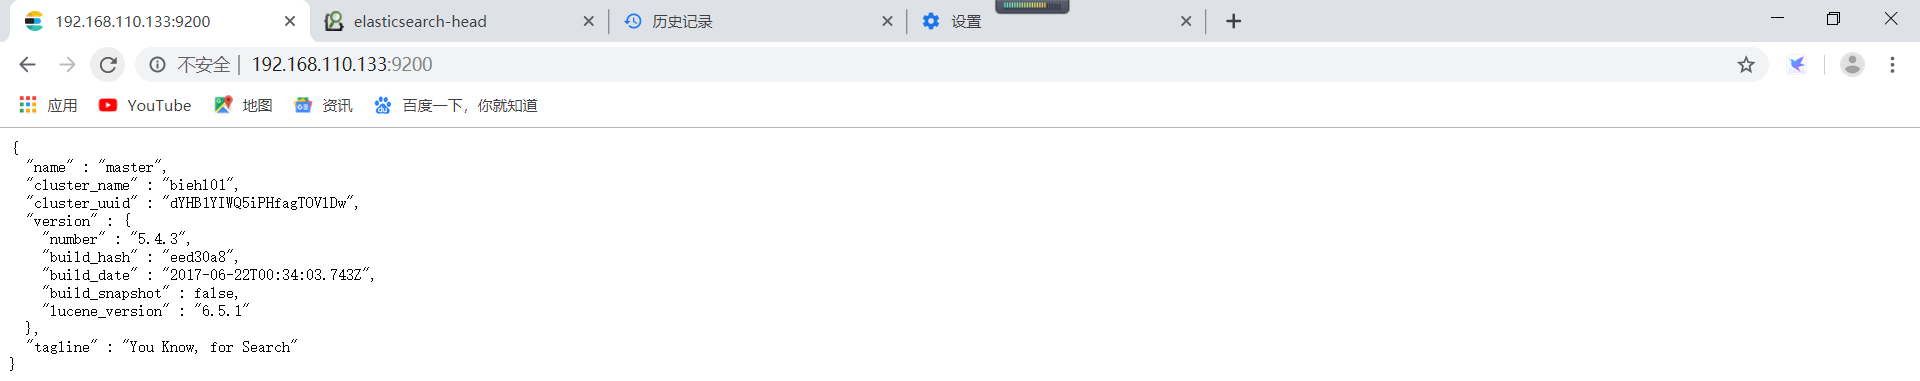
Elasticsearch-head插件的web介面效果如下所示:

至此,ElasticSearch的集群版就已經搭建完畢了。ElasticSearch集群的搭建可以使用更多的參數。你可以通過新增更多的參數配置,來實驗ElasticSearch集群版的搭建。
4、elasticsearch的基礎概念總結:
1)、elasticsearch集群:elasticsearch集群是由一個或者多個節點組成的集合。每一個集群都有一個唯一的名稱。默認是elasticsearch,我們可以自己設置的cluster_name的值,cluster_name的值非常重要,一個節點就是通過集群的名稱加入集群的。然後,每一個節點都有自己的名稱。節點是可以存儲數據,參與集群索引數據,以及搜索數據的獨立服務。
2)、索引,是含有相同屬性的文檔集合。
3)、類型,索引可以定義一個或者多個類型,文檔必須屬於一個類型。
4)、文檔,文檔是可以被索引的基本數據單位。索引在elasticsearch中是通過一個名稱來識別的,必須是英文字母小寫的,且不含中劃線的,我們通過這個索引來對文檔進行增刪查改的操作。
5)、索引、類型、文檔之間的關係,索引相當於資料庫裡面的database即資料庫,類型相當於資料庫裡面的table即數據表,文檔相當於資料庫SQL裡面的一行記錄。
6)、分片,每個索引都有多個分片,每個分片是一個Lucene索引。
7)、備份,拷貝一份分片就完成了分片的備份。
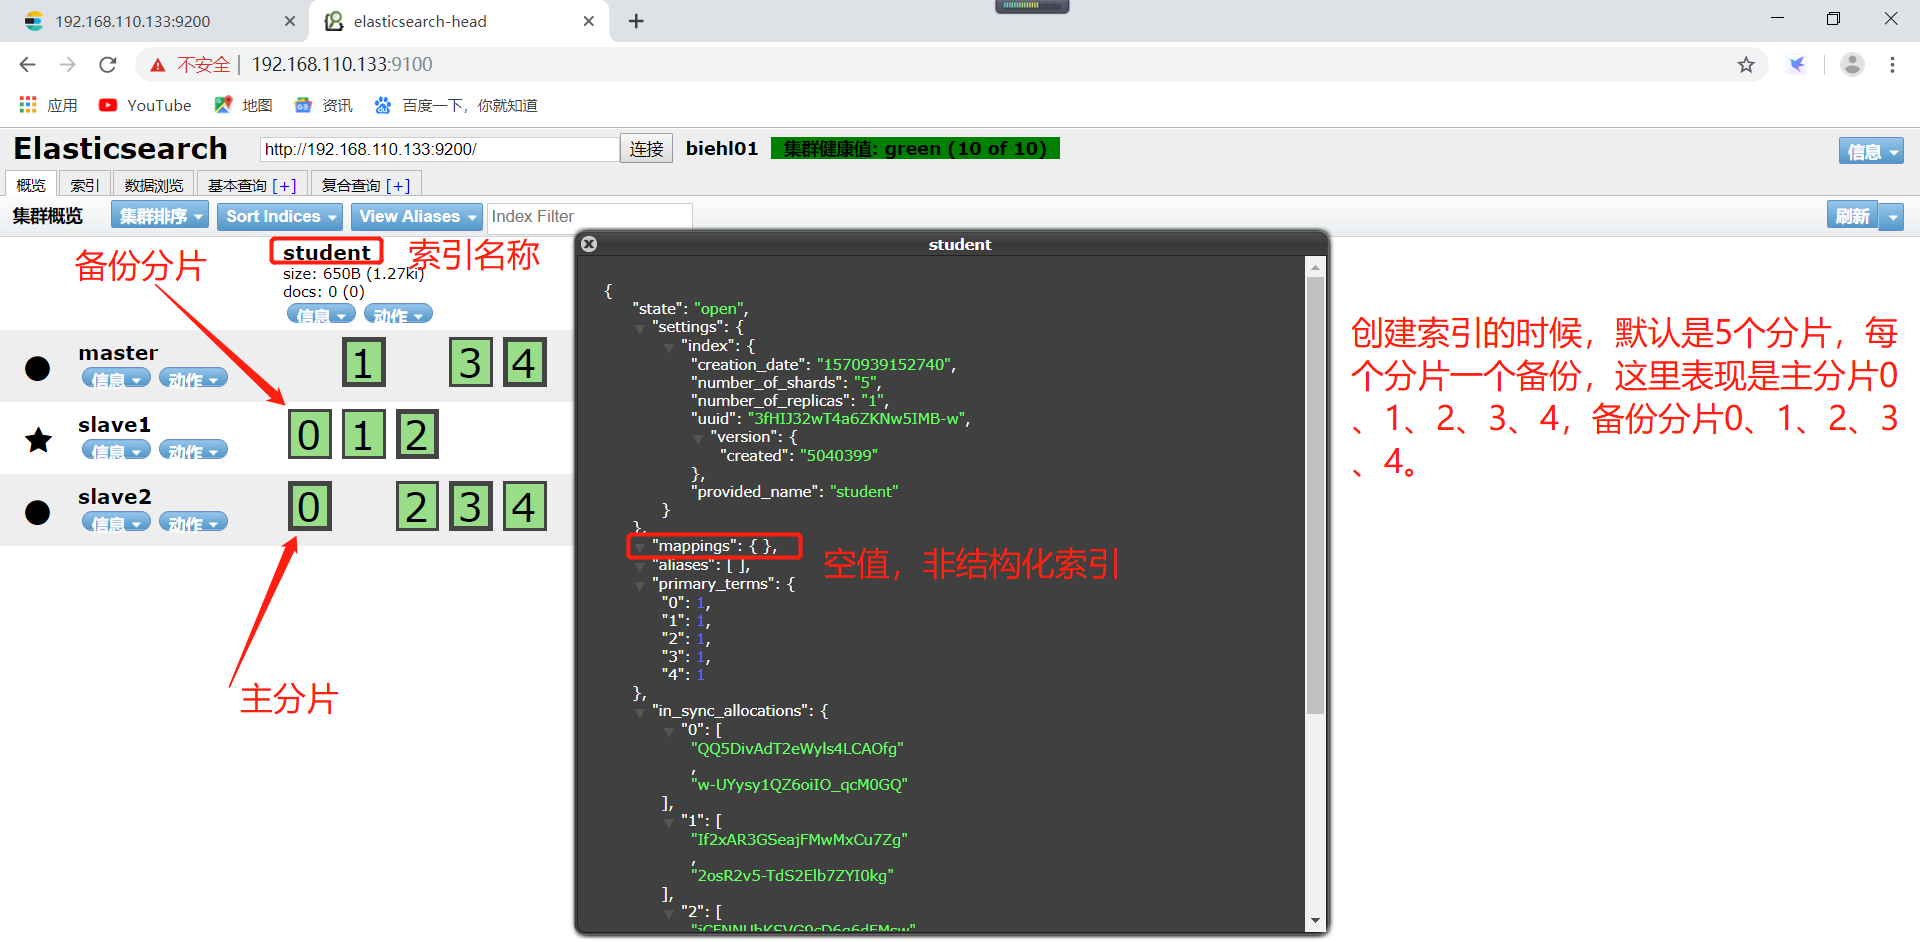
注意:elasticsearch在創建索引的時候,默認創建5個分片,一份備份,這個數據可以進行修改。分片的數量只能在創建索引的時候進行指定,不能在後期進行修改,備份可以進行動態修改的。
5、Elasticsearch的基本用法,基本操作,基本使用。
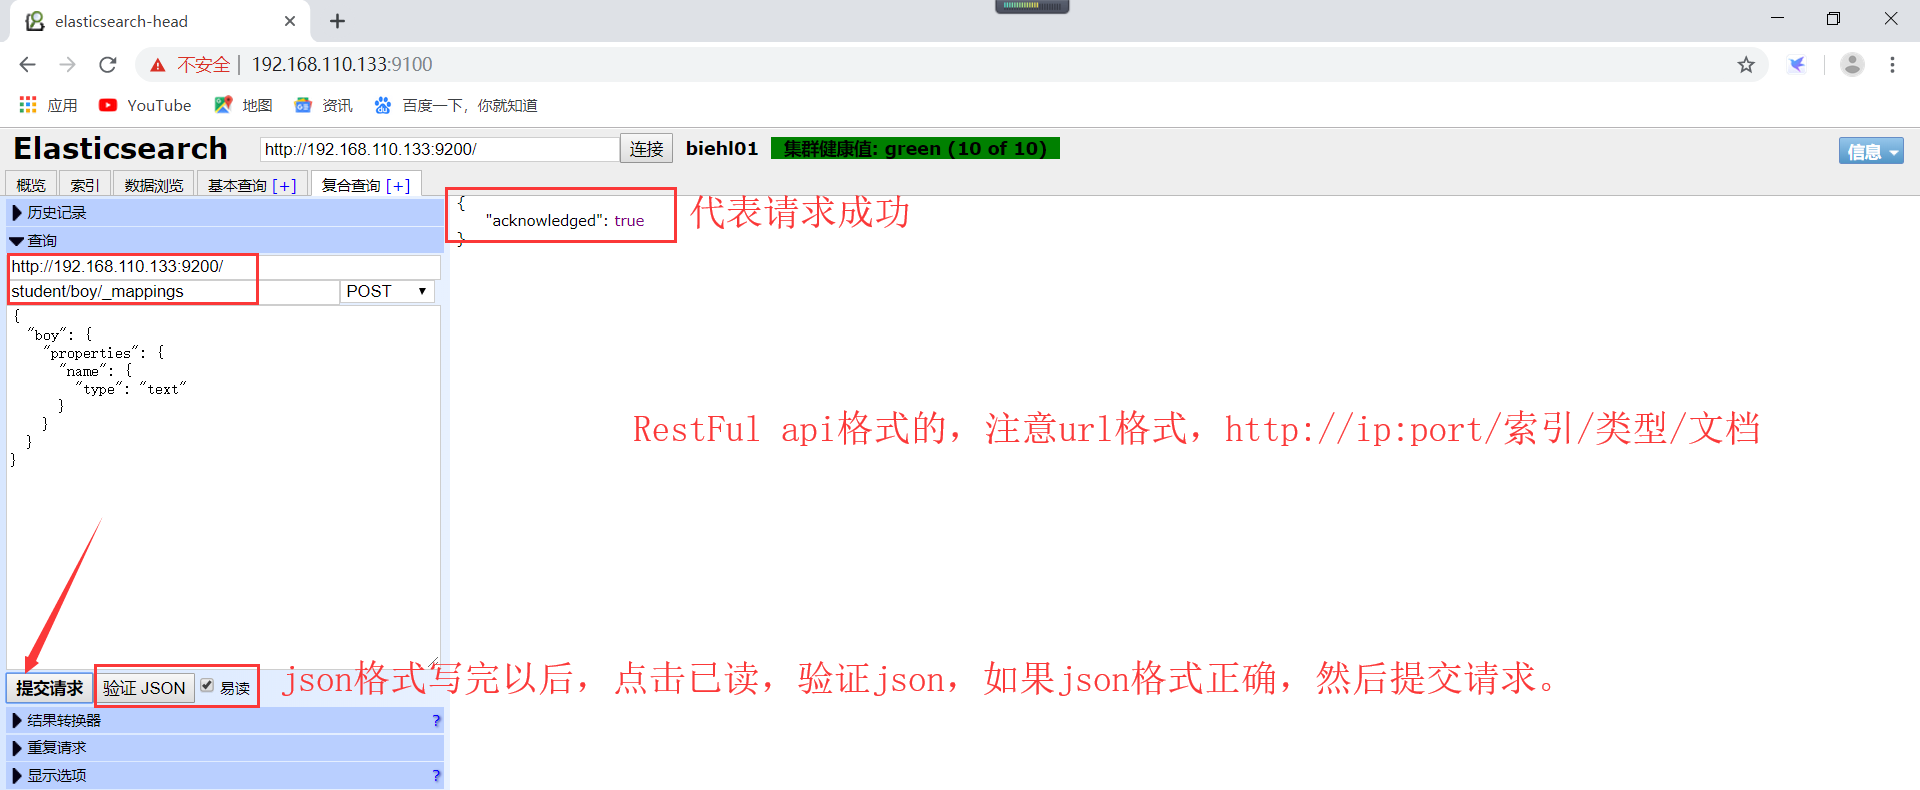
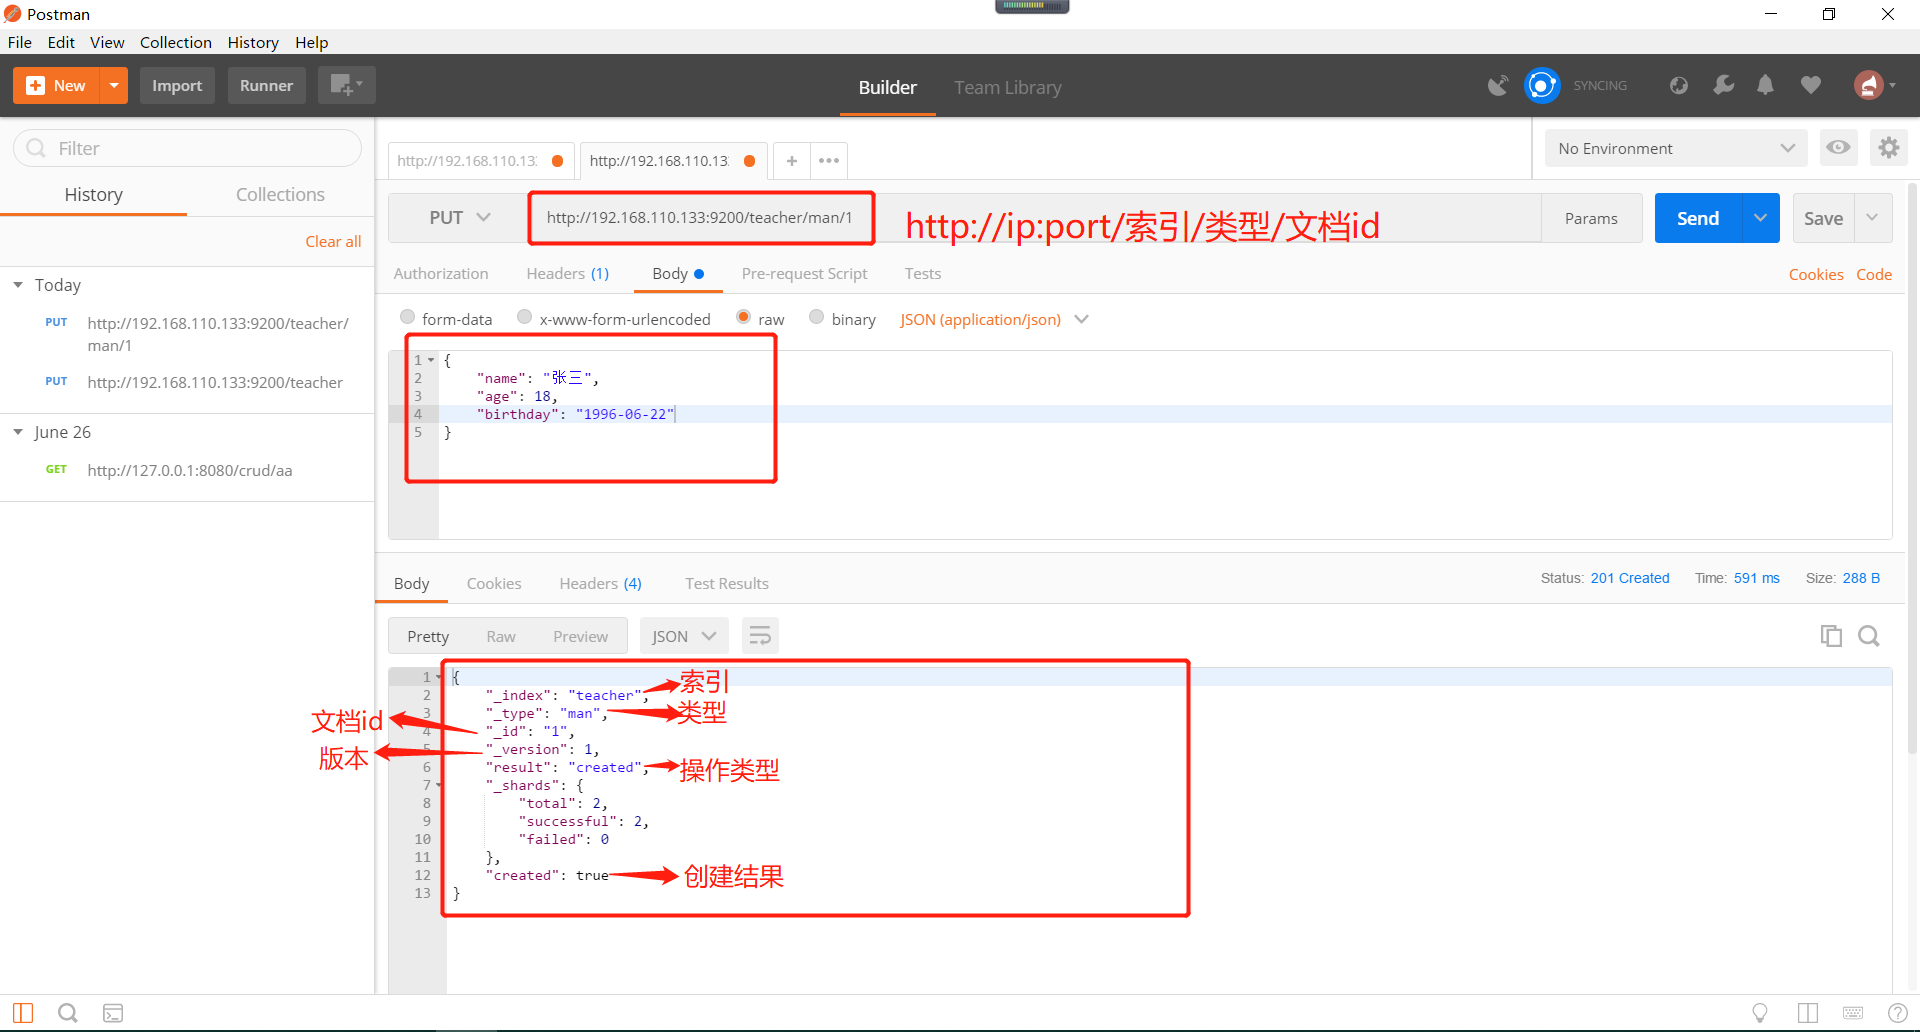
elasticsearch是以RESTFul api風格來命名自己的api的。api的基本格式,http://<ip地址>:<port埠號>/<索引>/<類型>/<文檔id>
注意:api的url裡面的元素基本都是elasticsearch的基本概念都是名詞,elasticsearch的動作都是常用http動詞get/put/post/delete來決定的。
6、索引的創建分為非結構化創建("mappings": { }的json格式值是空的)、結構化創建("mappings": { }的json格式值非空的)。
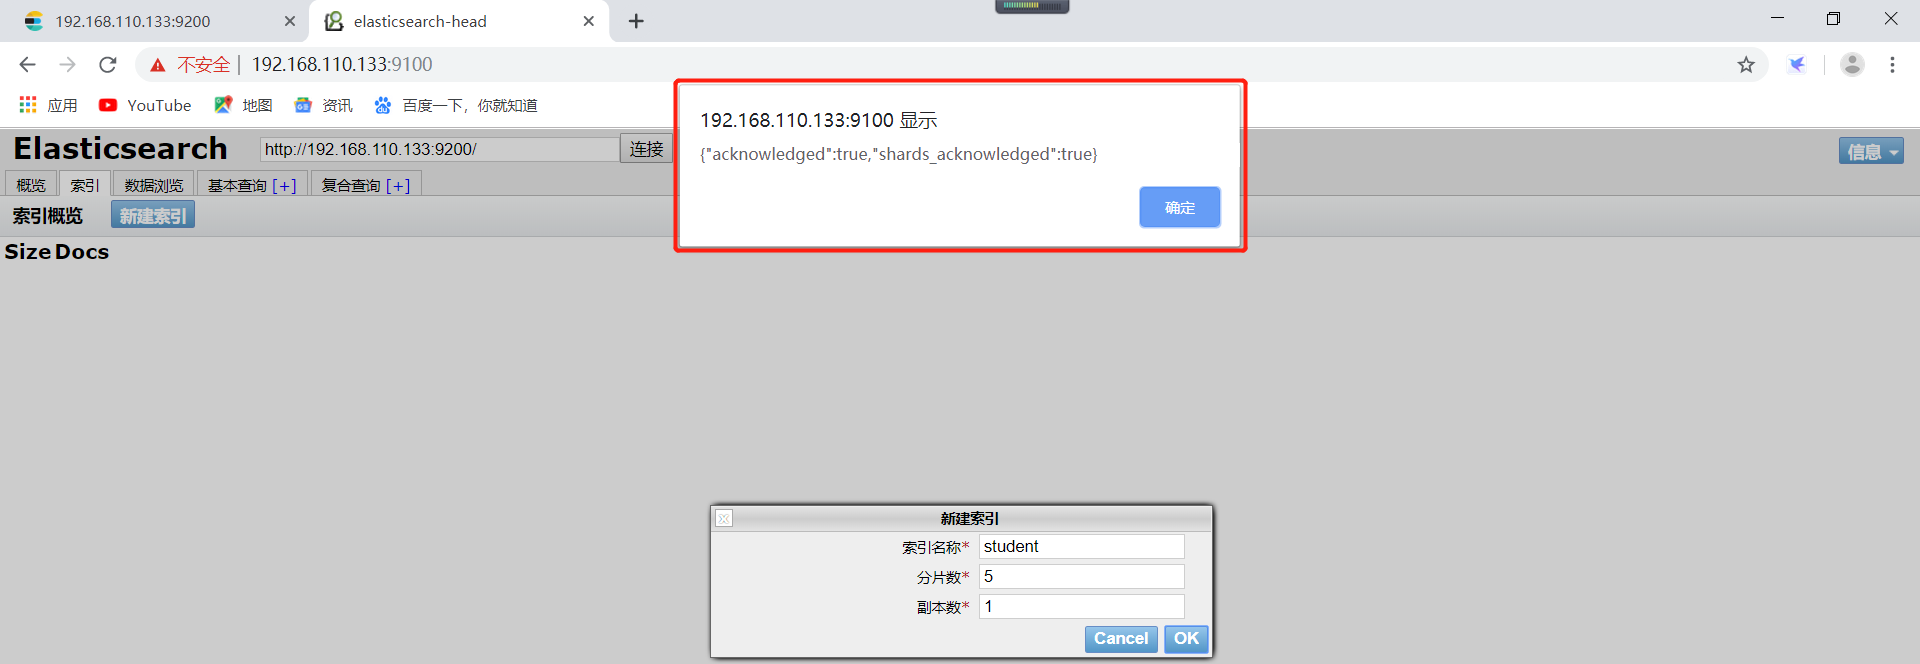
1)、創建非結構化索引,操作如下所示(注意:這裡使用head插件進行創建非結構化索引的哦):

創建完畢以後可以看到一個彈出框,表示創建成功了。
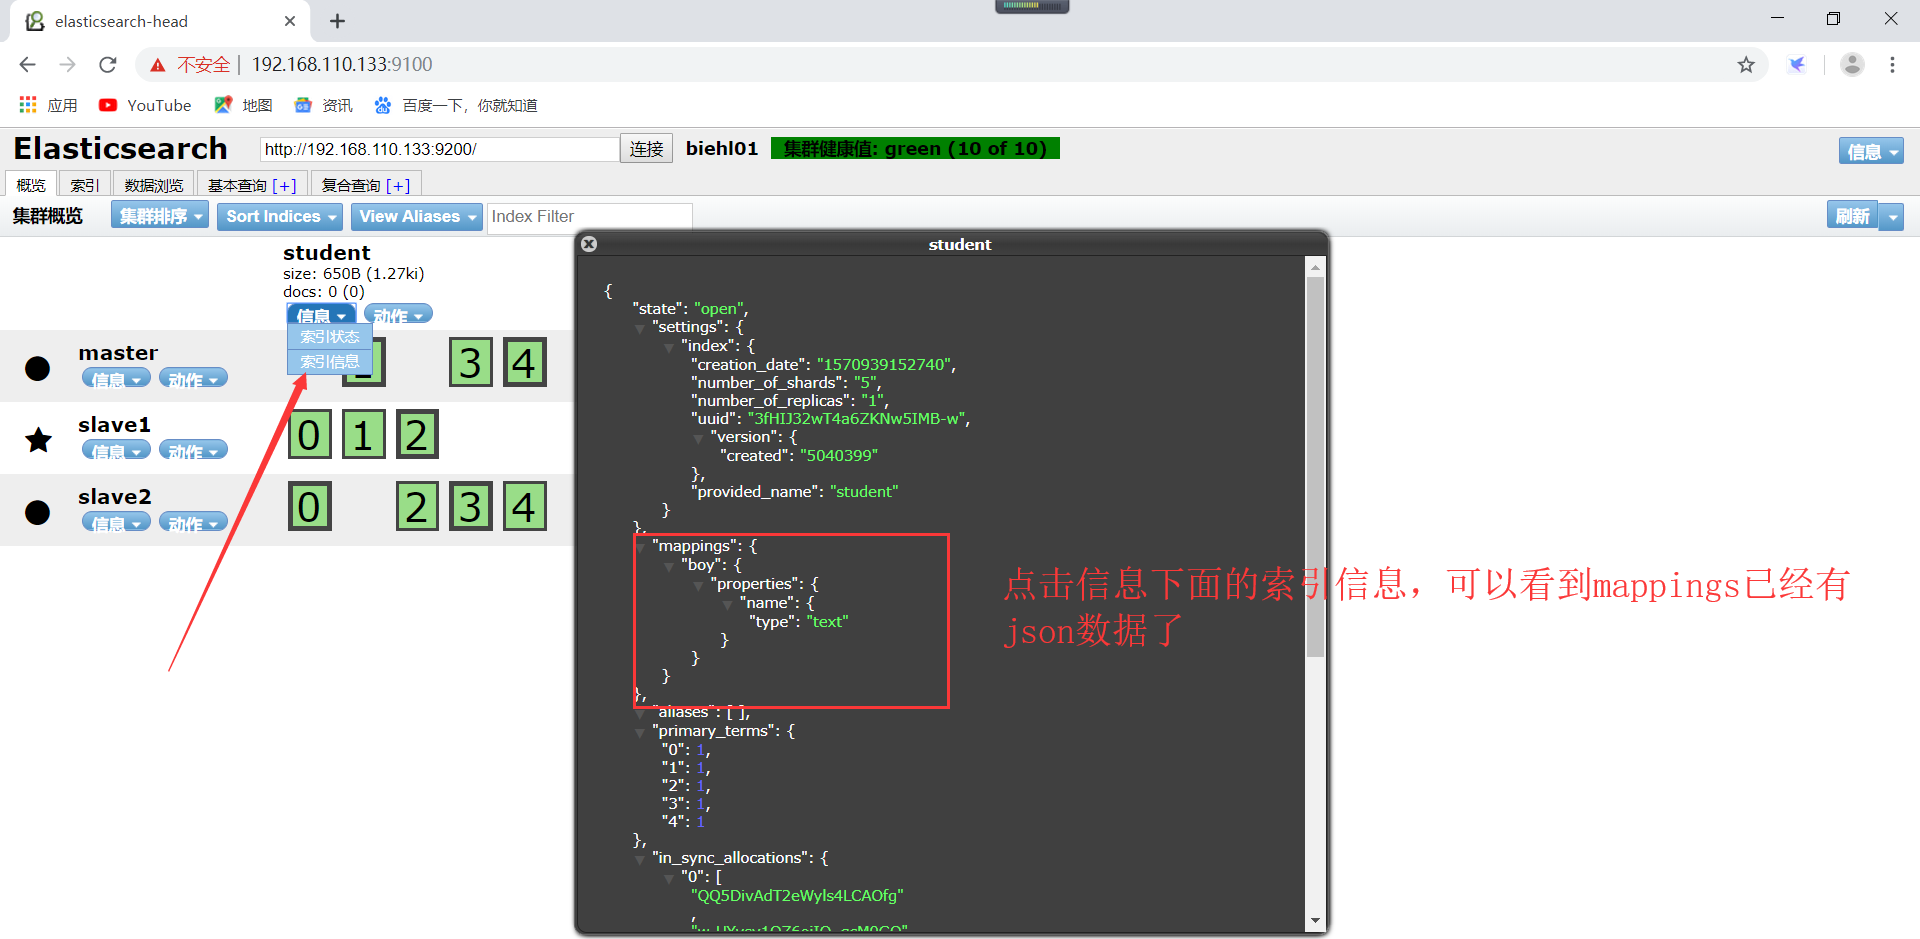
創建的索引,在概覽可以看到自己創建的索引了,student是創建的索引的名稱(切記,索引名稱小寫,不可以出現中劃線)。每一個方框就是elasticsearch的分片,粗線方框是es的主分片,主分片旁邊細線方框是es的備份分片,對應關係,粗線方框0的備份分片是細線方框0。依次類推。
2)、創建非結構化索引,操作如下所示(注意:這裡使用head插件進行創建結構化索引的哦):
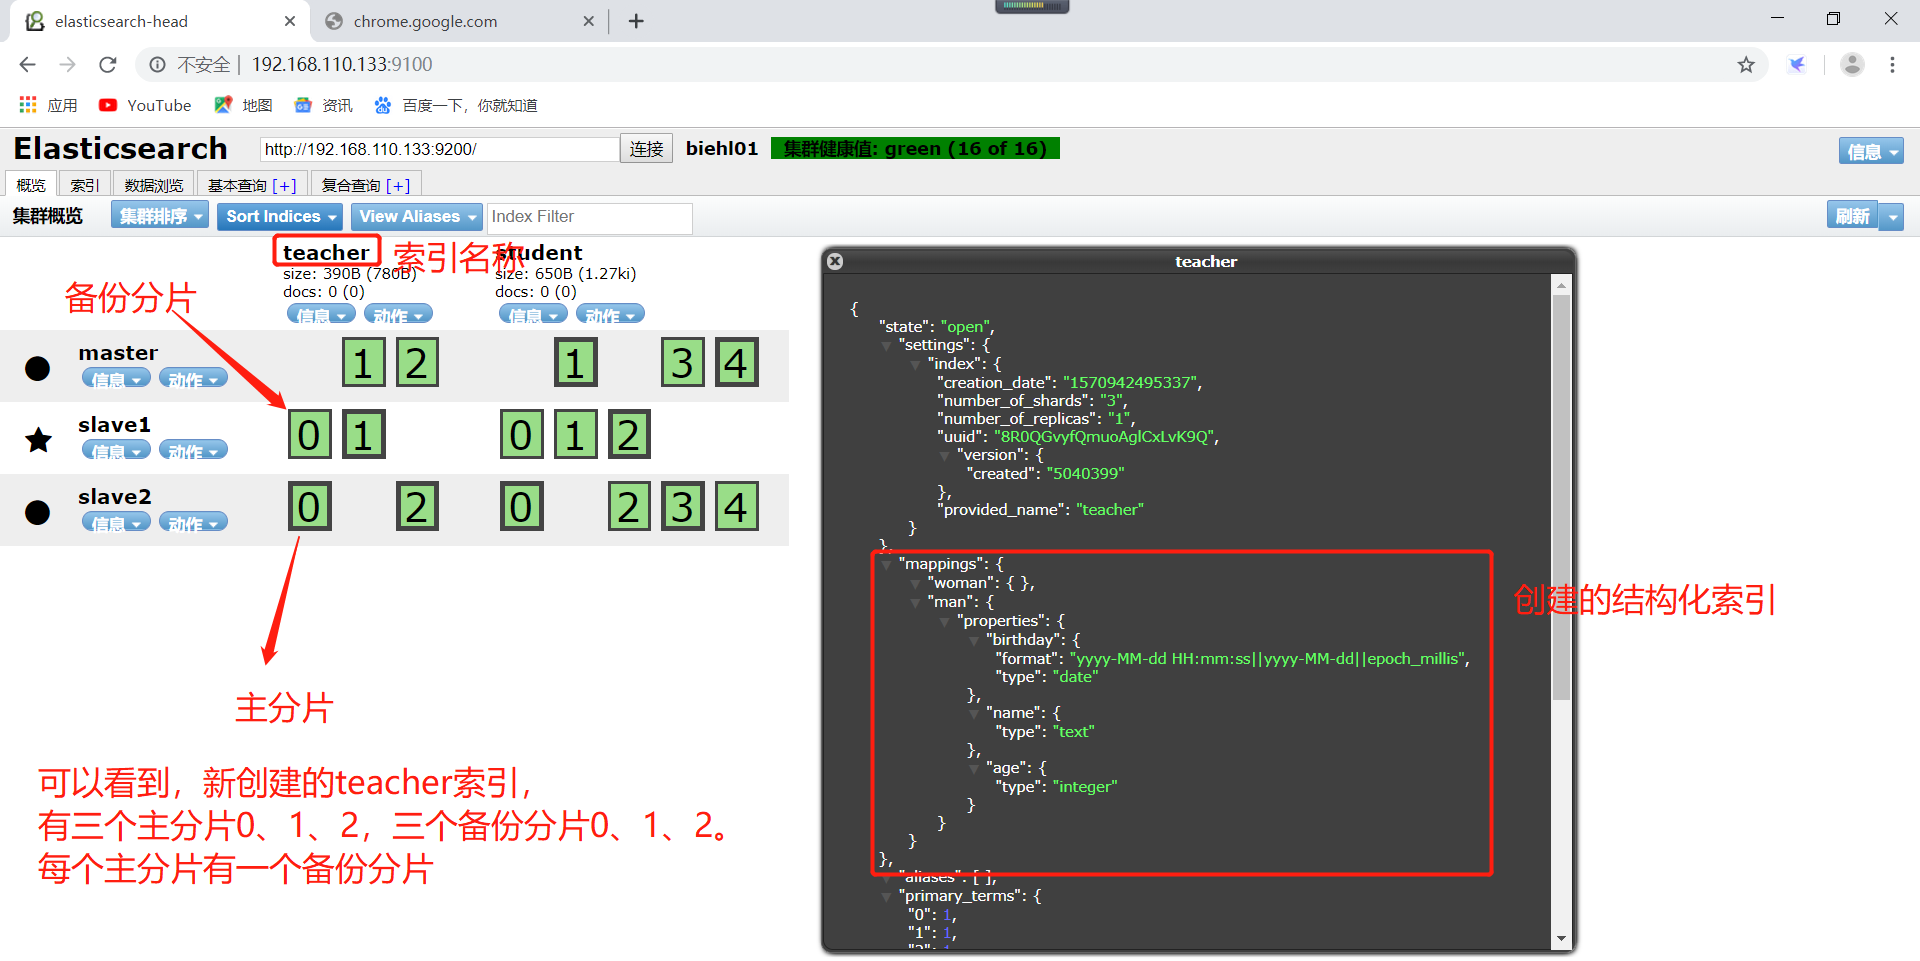
查看創建的結構化索引,如下所示(修改了記得點擊刷新哦):
postman是一個擁有可視化介面的http模擬器,可以驗證json結構。之前介紹過,這裡簡單使用一下。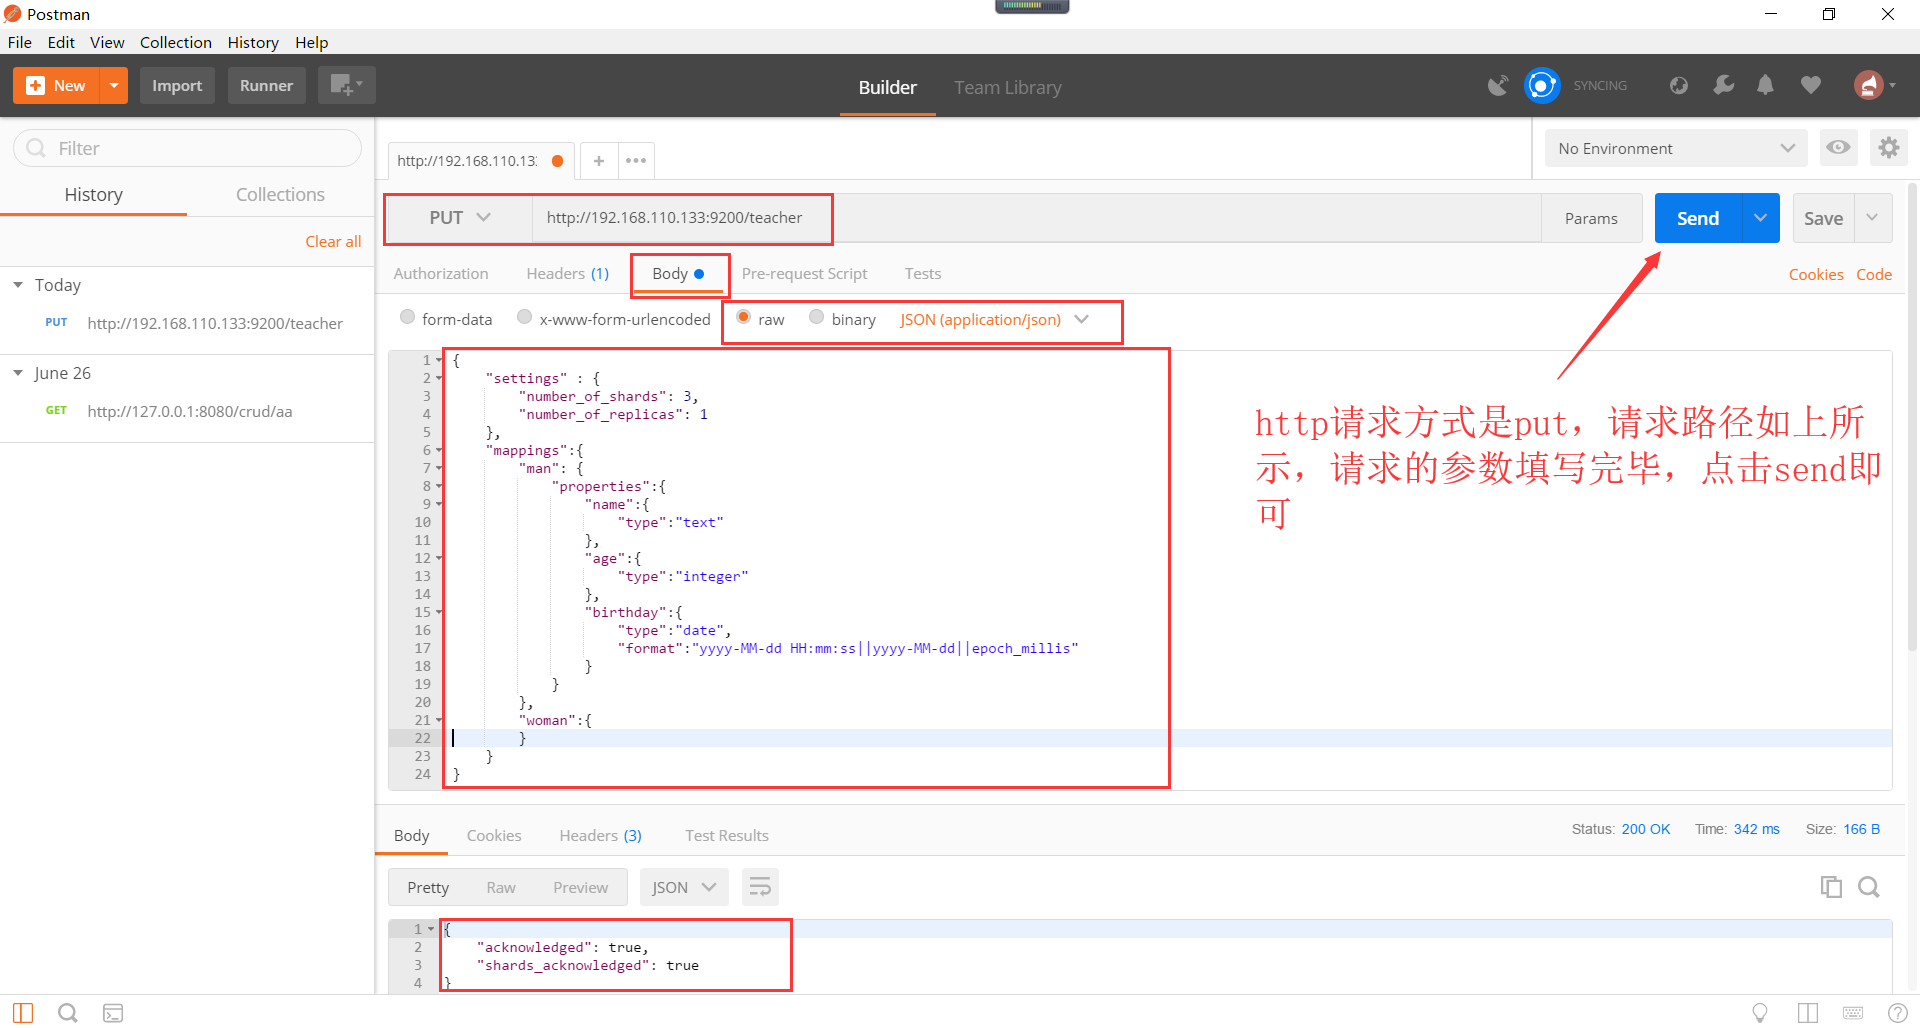
現在查看一下新創建的索引,如下所示:
7、es的索引創建完畢以後就可以進行es的數據插入。插入分為指定文檔id插入和自動產生文檔id插入。文檔id是什麼呢,文檔id是一個唯一索引值,指向我們的文檔數據。
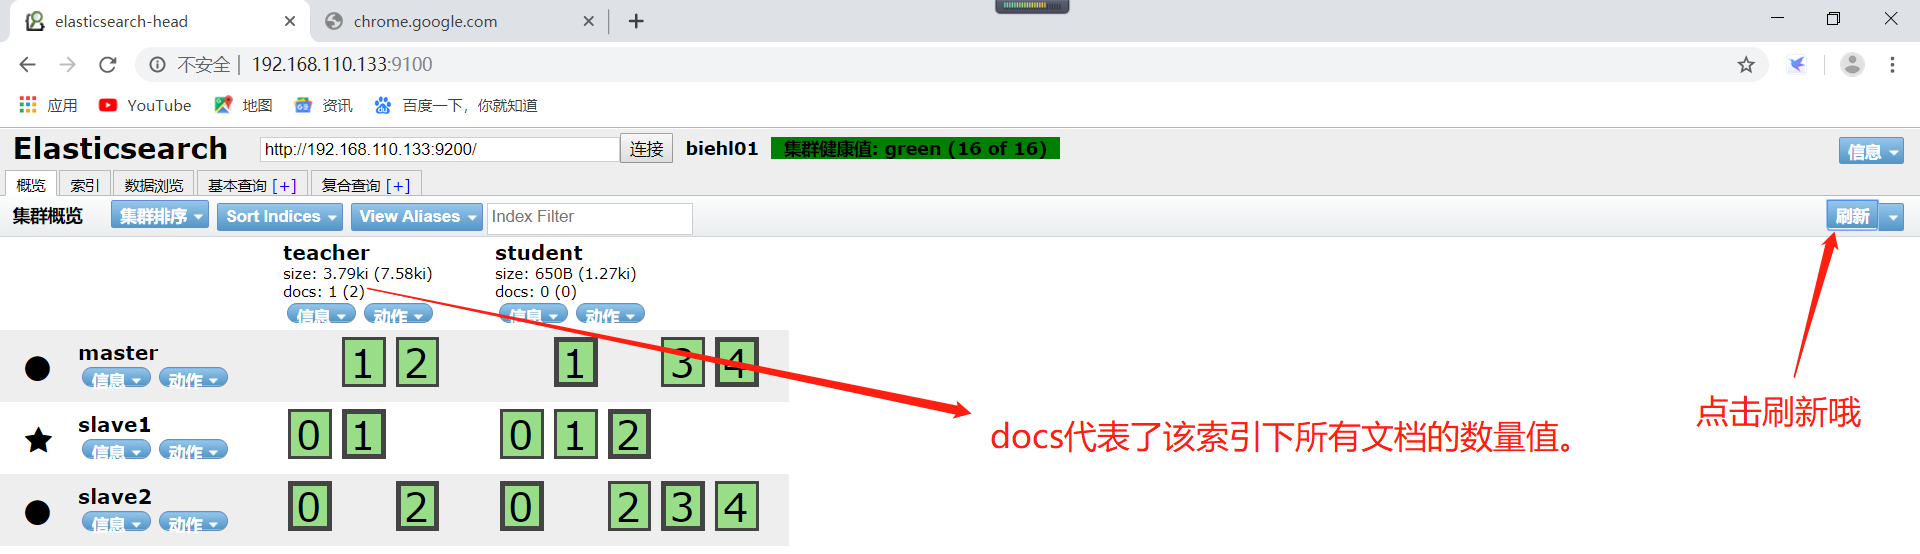
在head插件概覽裡面查看docs的變化,docs代表了該索引下所有文檔的數量值。
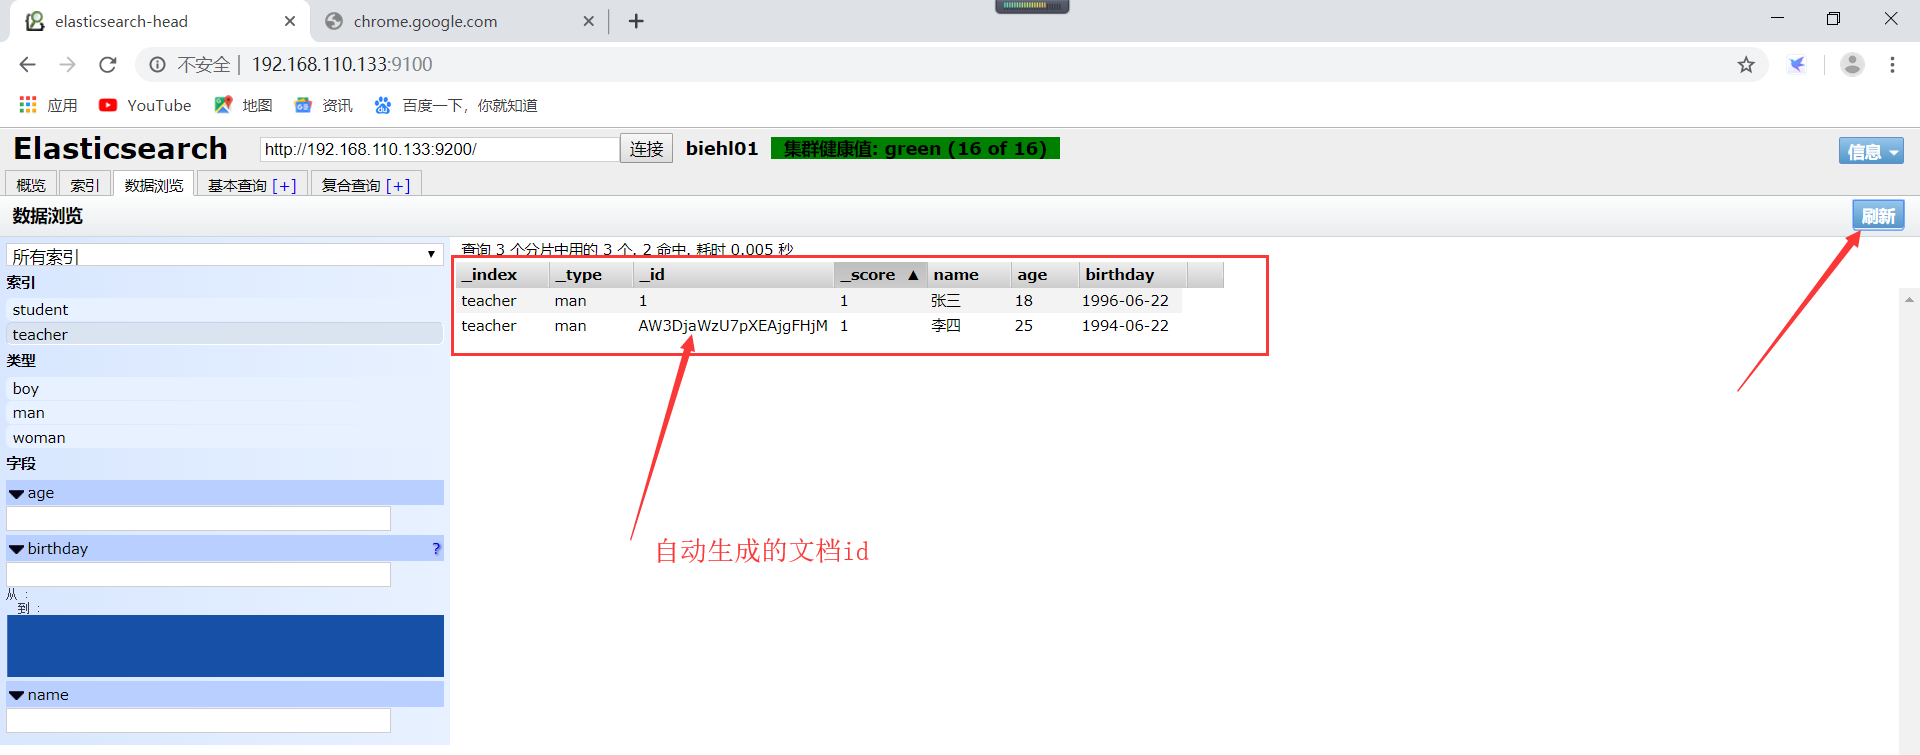
在head插件的數據瀏覽可以看到剛才插入的一條數據的。
如何讓es自動指定文檔id呢。如下所示:
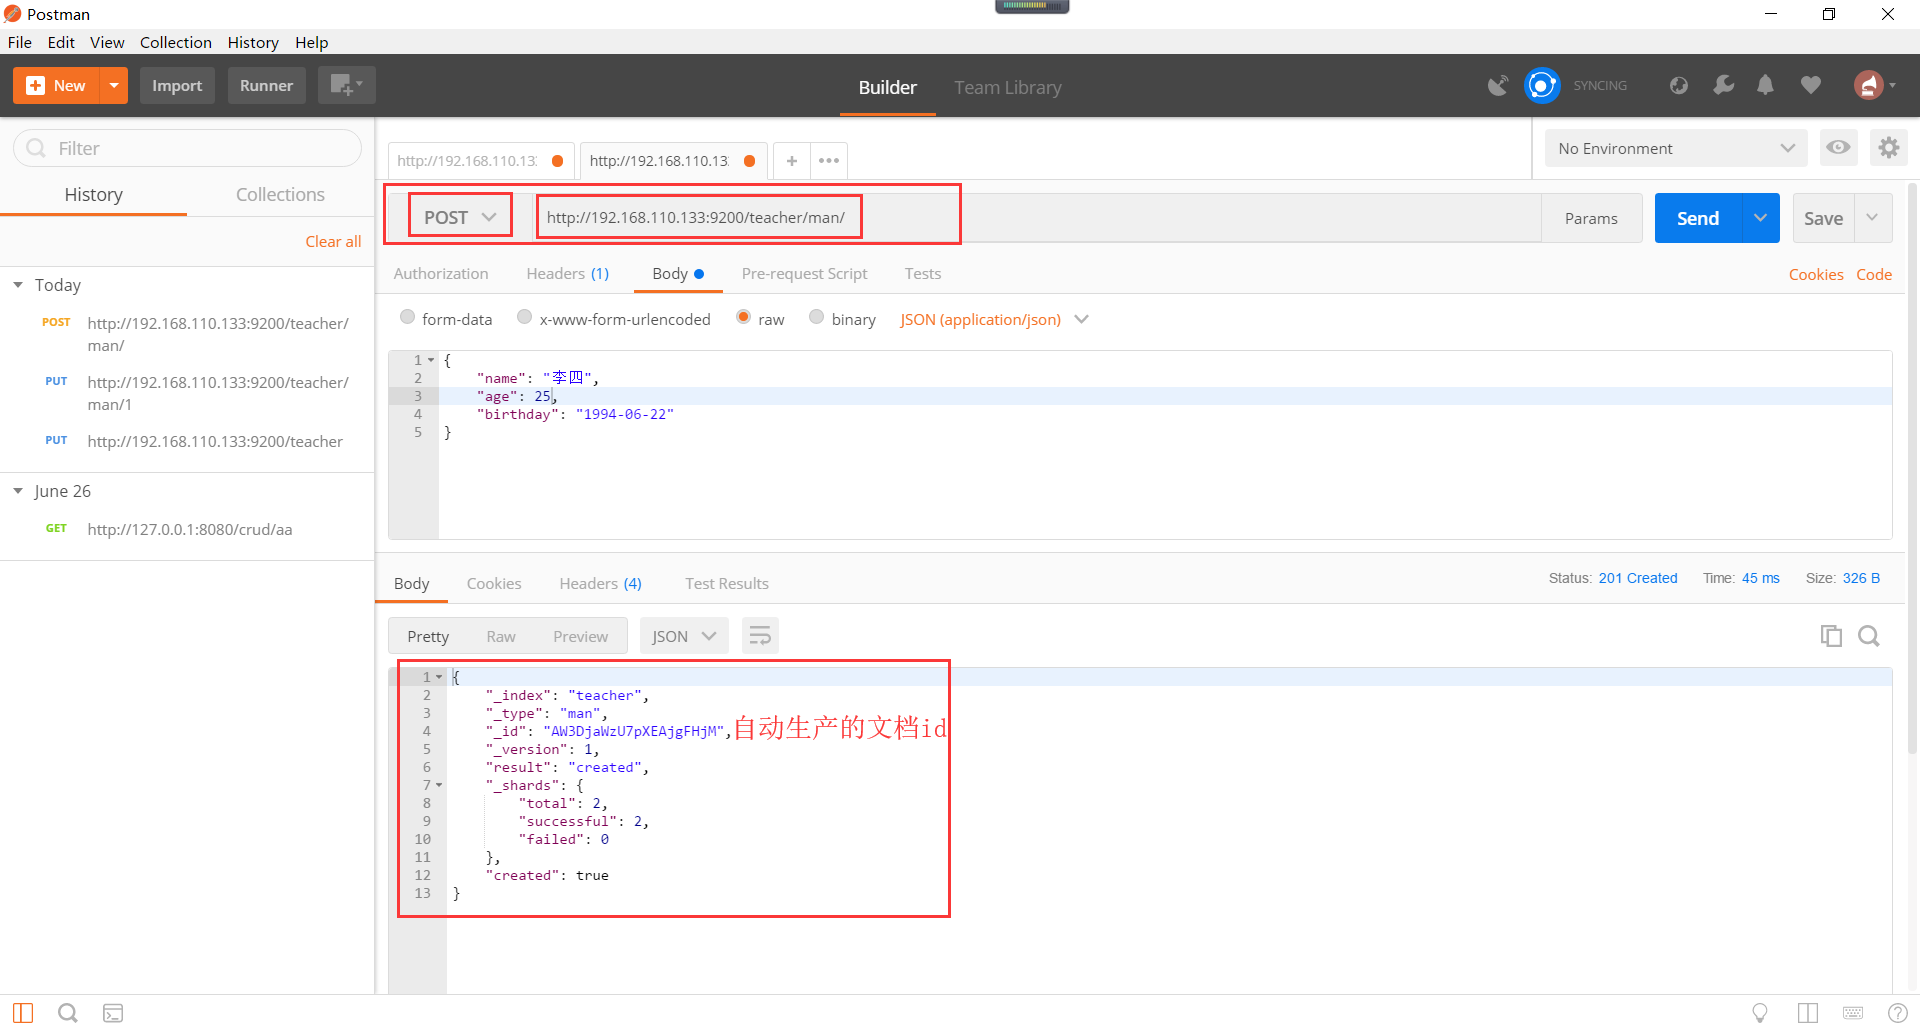
自己可以去head插件的概述和數據瀏覽進行查看,這裡僅展示了數據瀏覽的數據。如下所示:
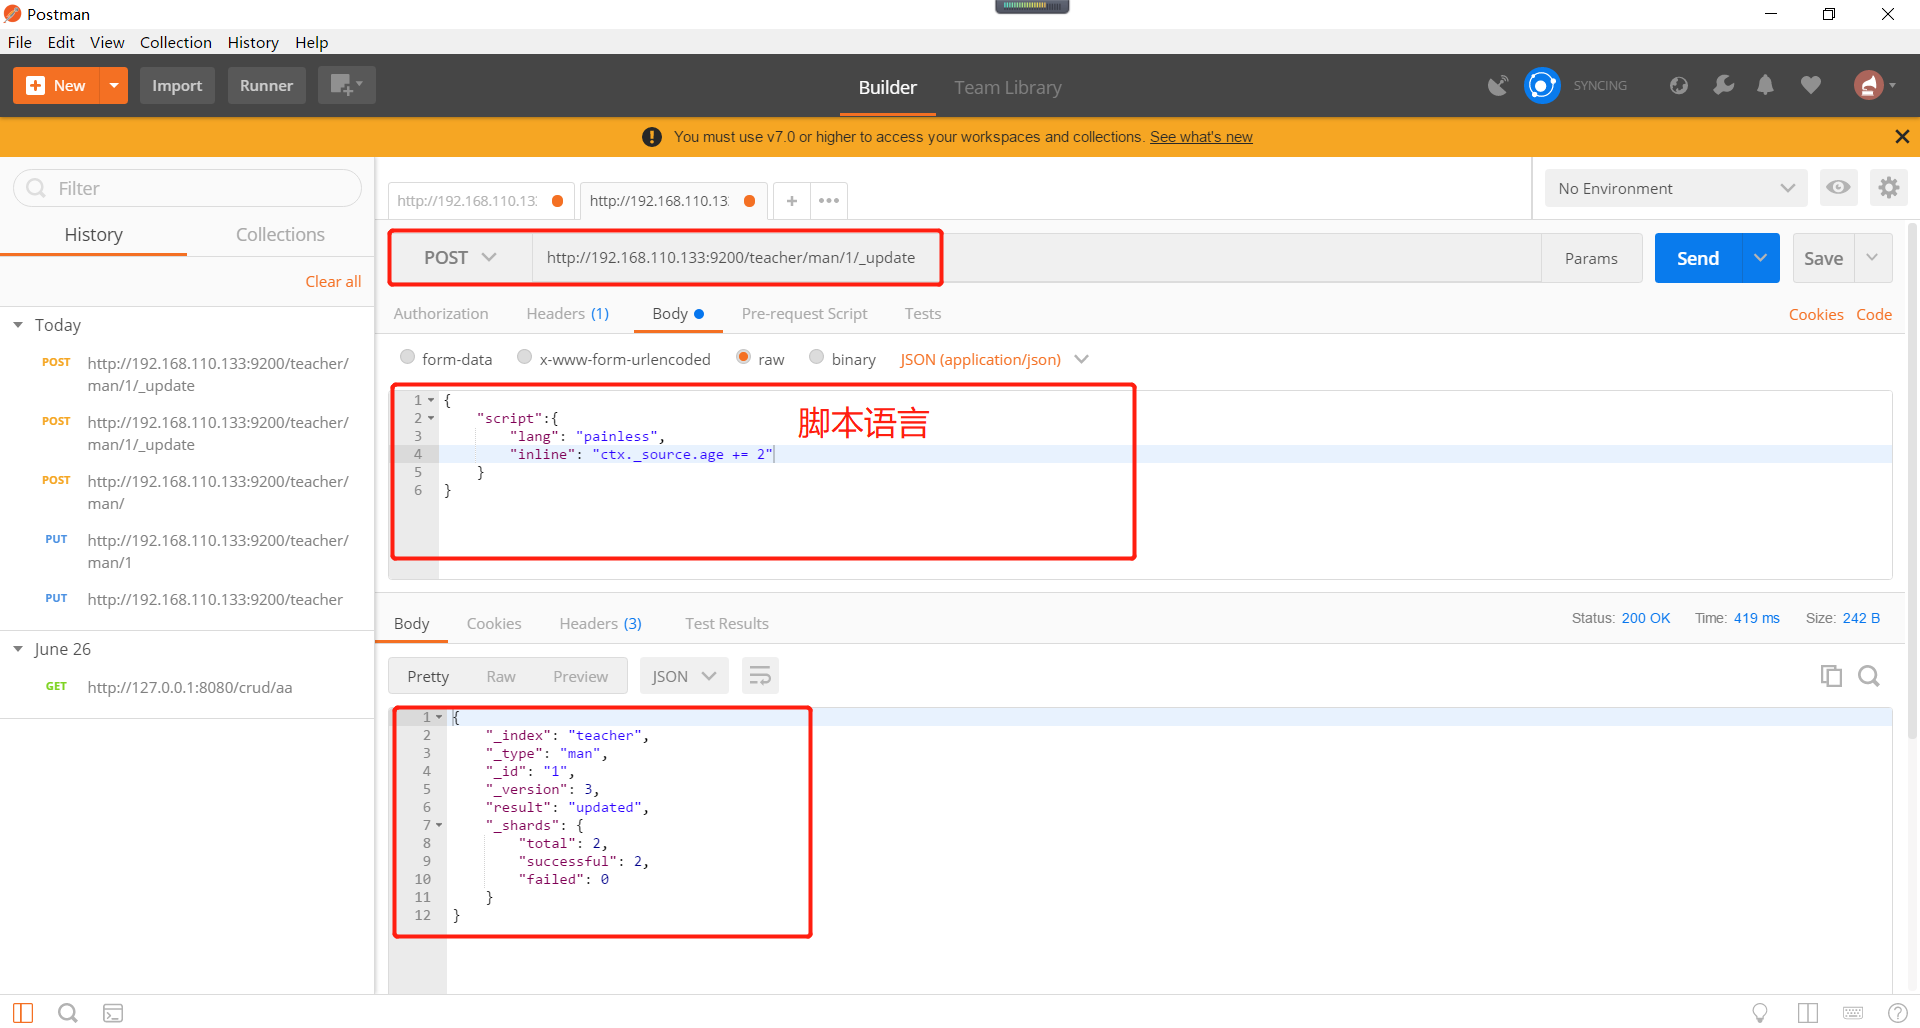
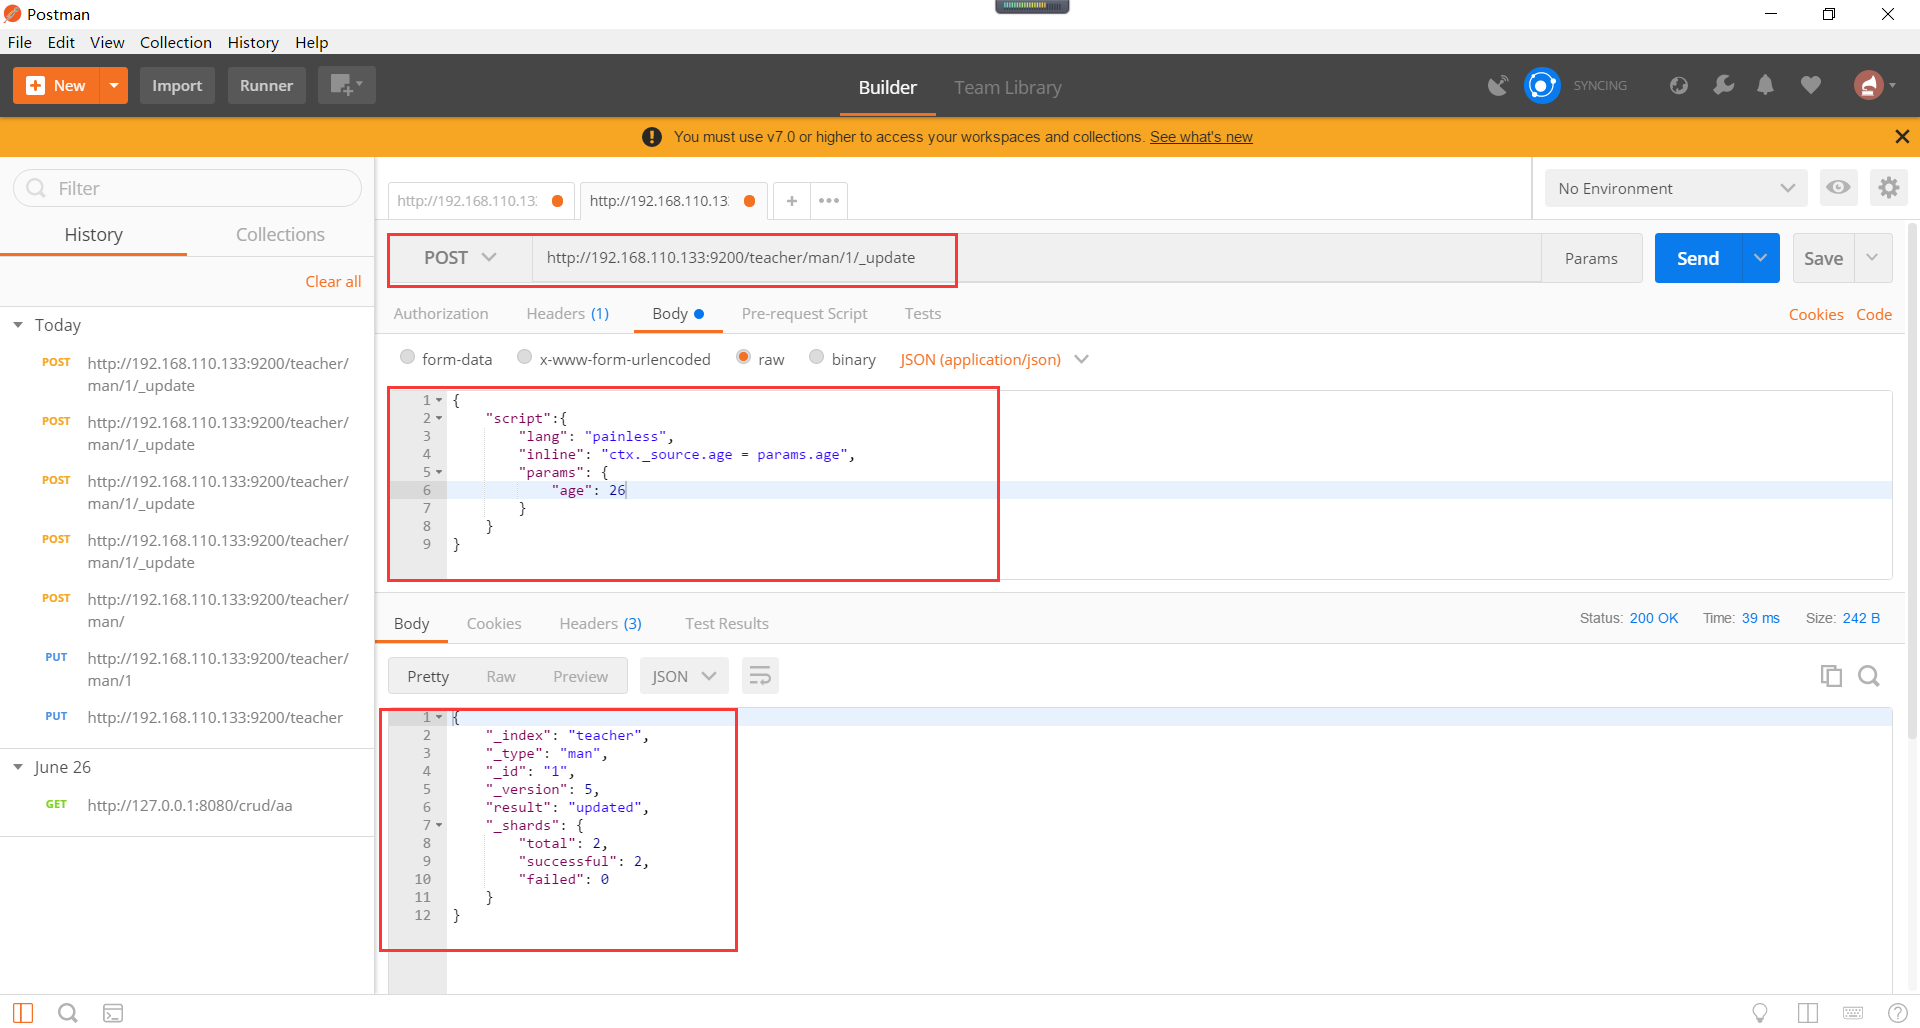
8、修改Elasticsearch的文檔數據。分為直接修改文檔、通過腳本修改文檔。
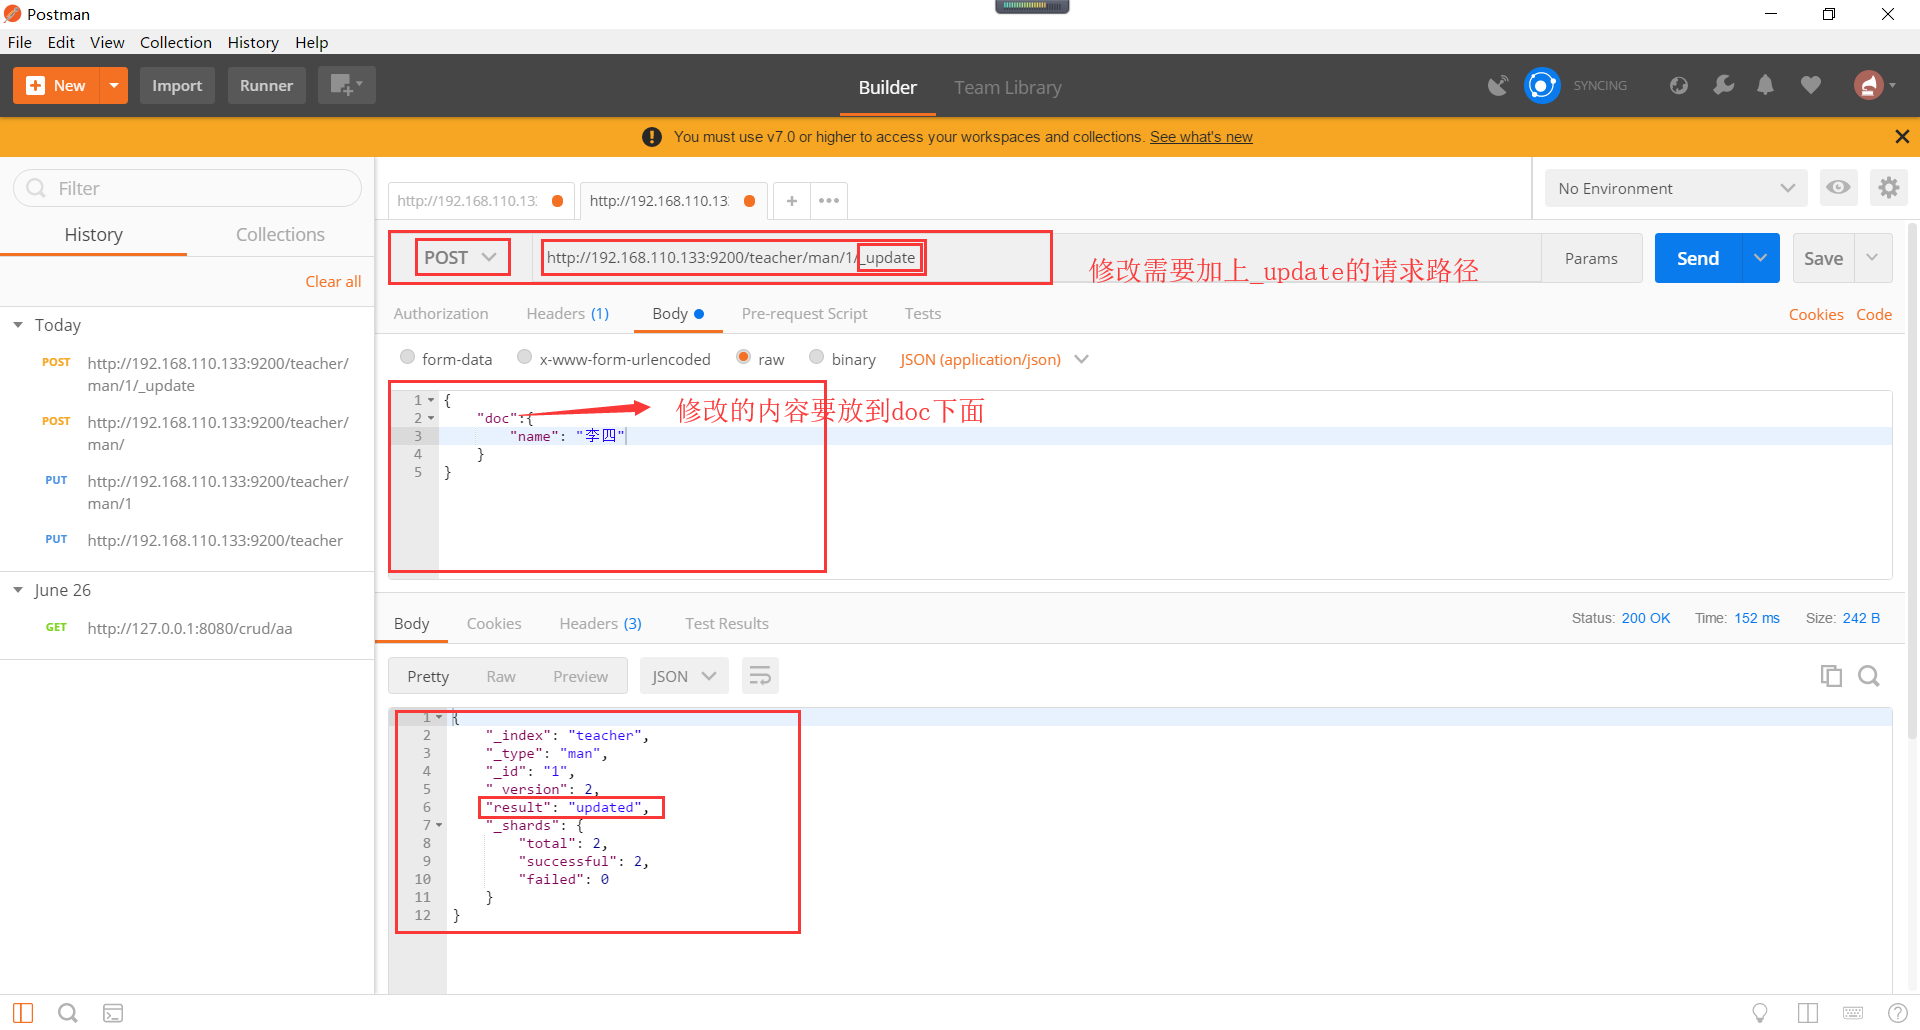
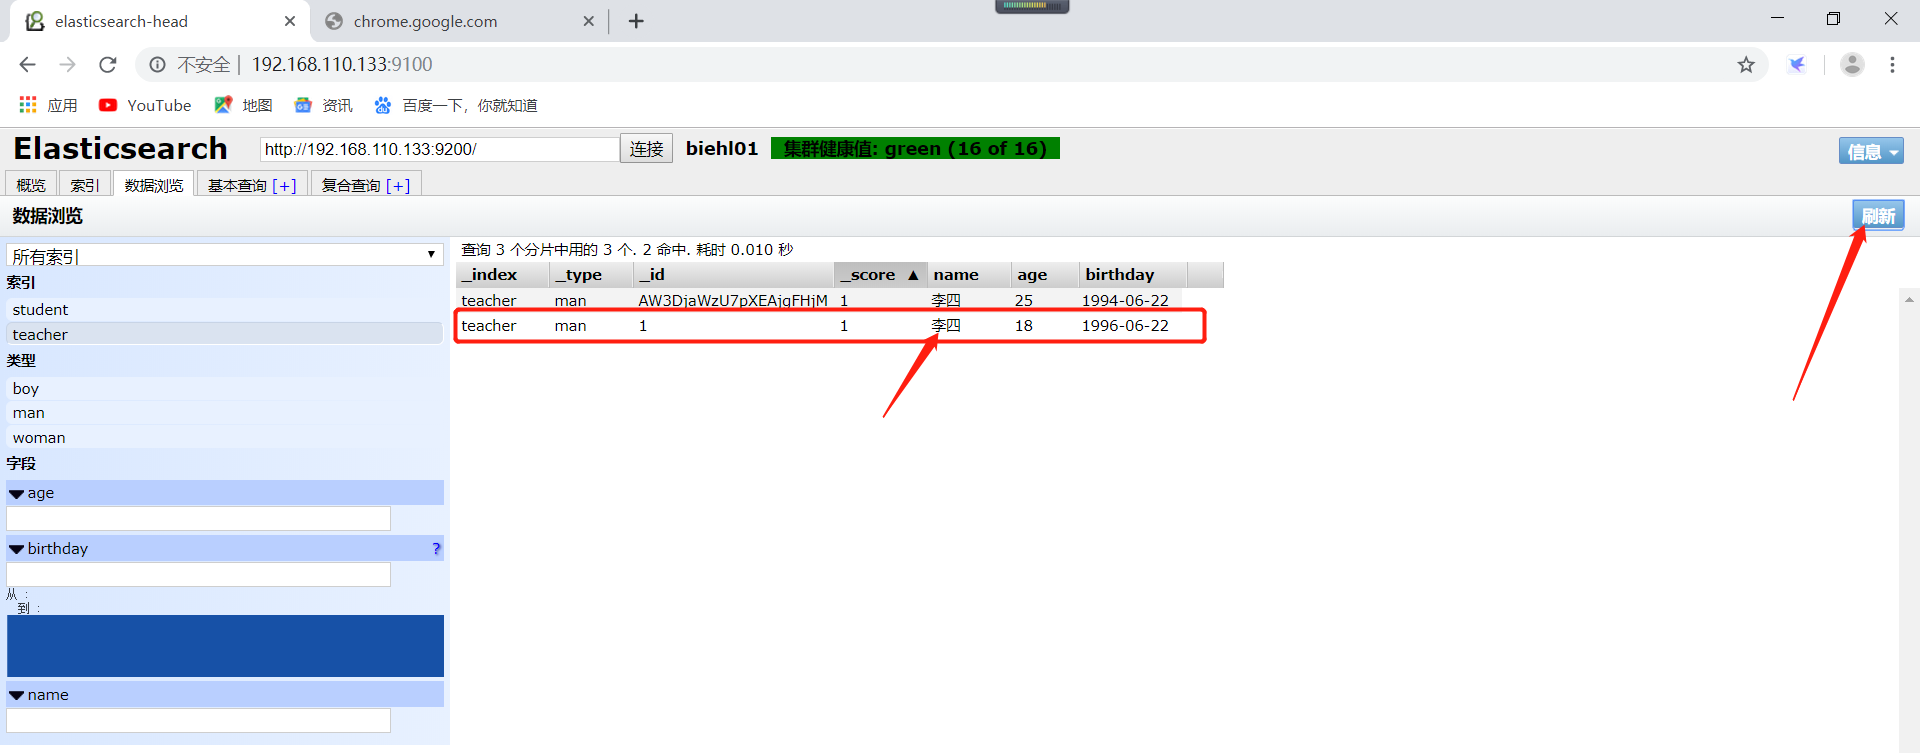
這種通過指定文檔id進行直接修改的效果如下所示:
通過腳本修改文檔。操作如下所示:
不同的方式,請求成功以後自己使用head查看效果即可。
9、刪除Elasticsearch的文檔、刪除Elasticsearch的索引。
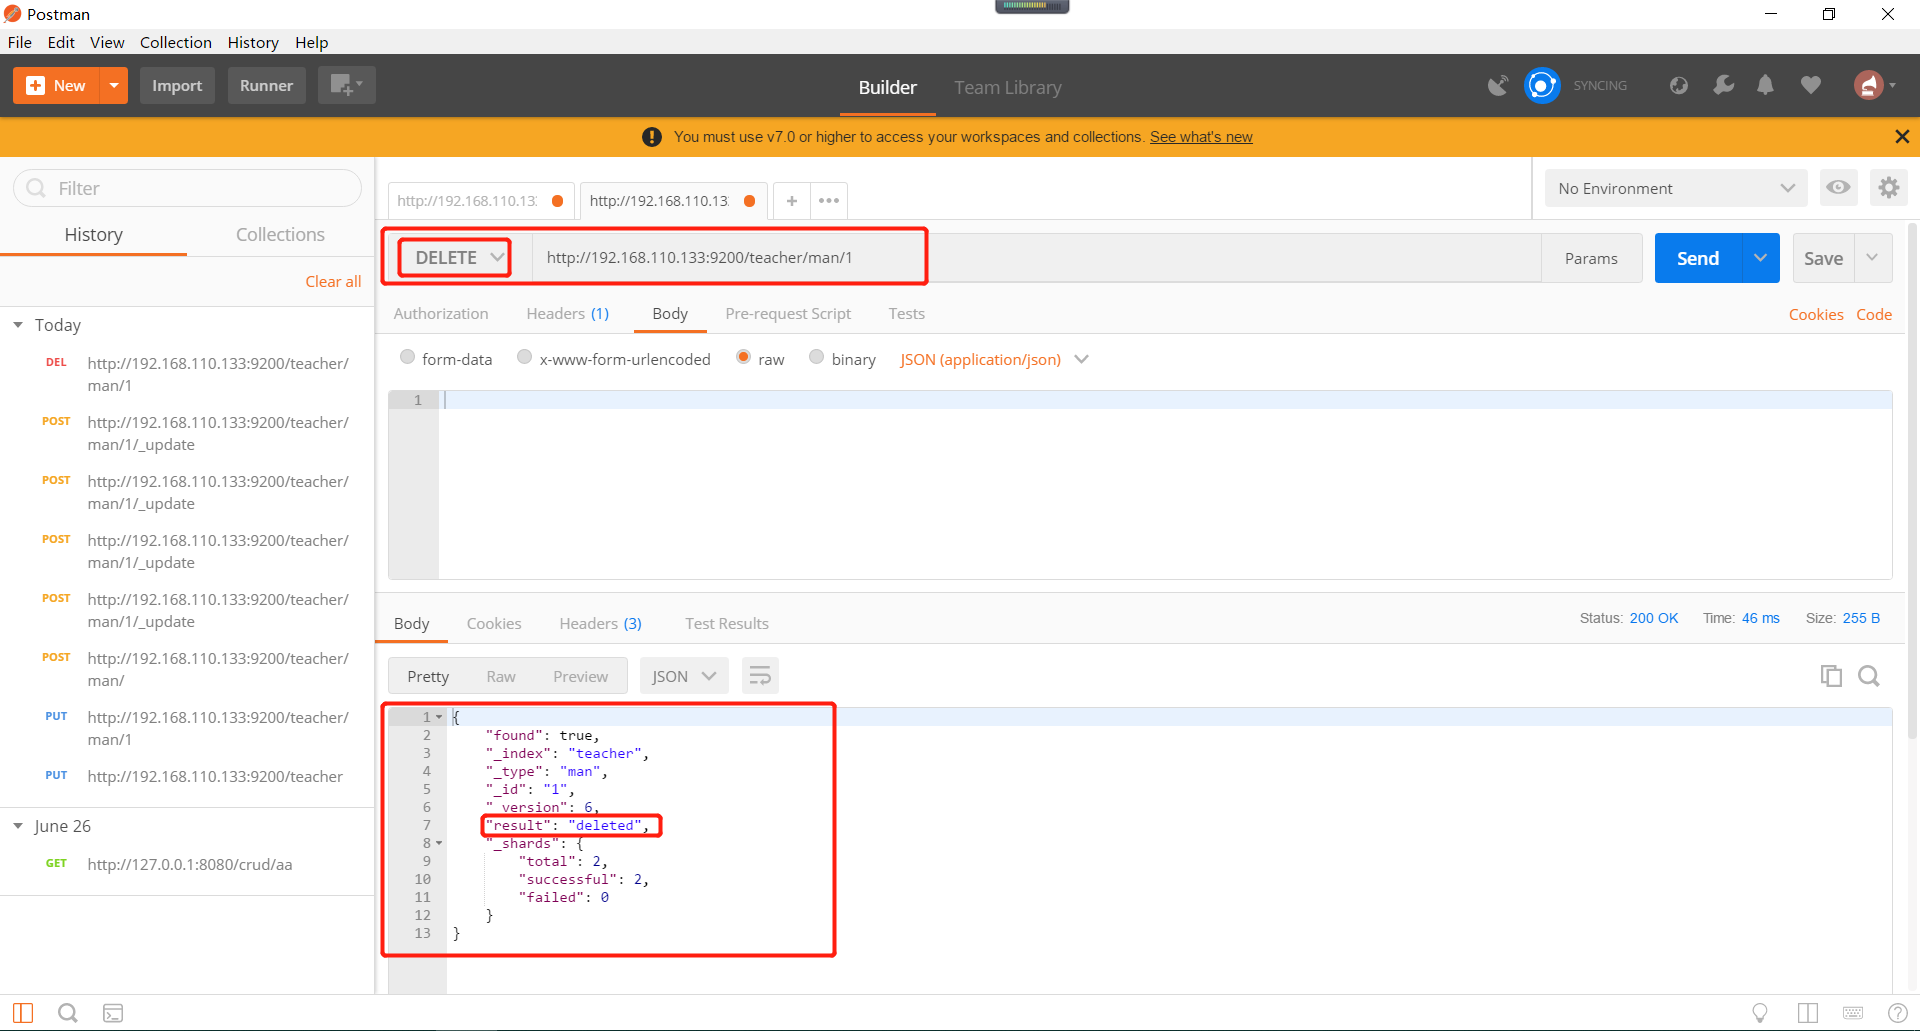
刪除以後發現數據已經被刪除了。
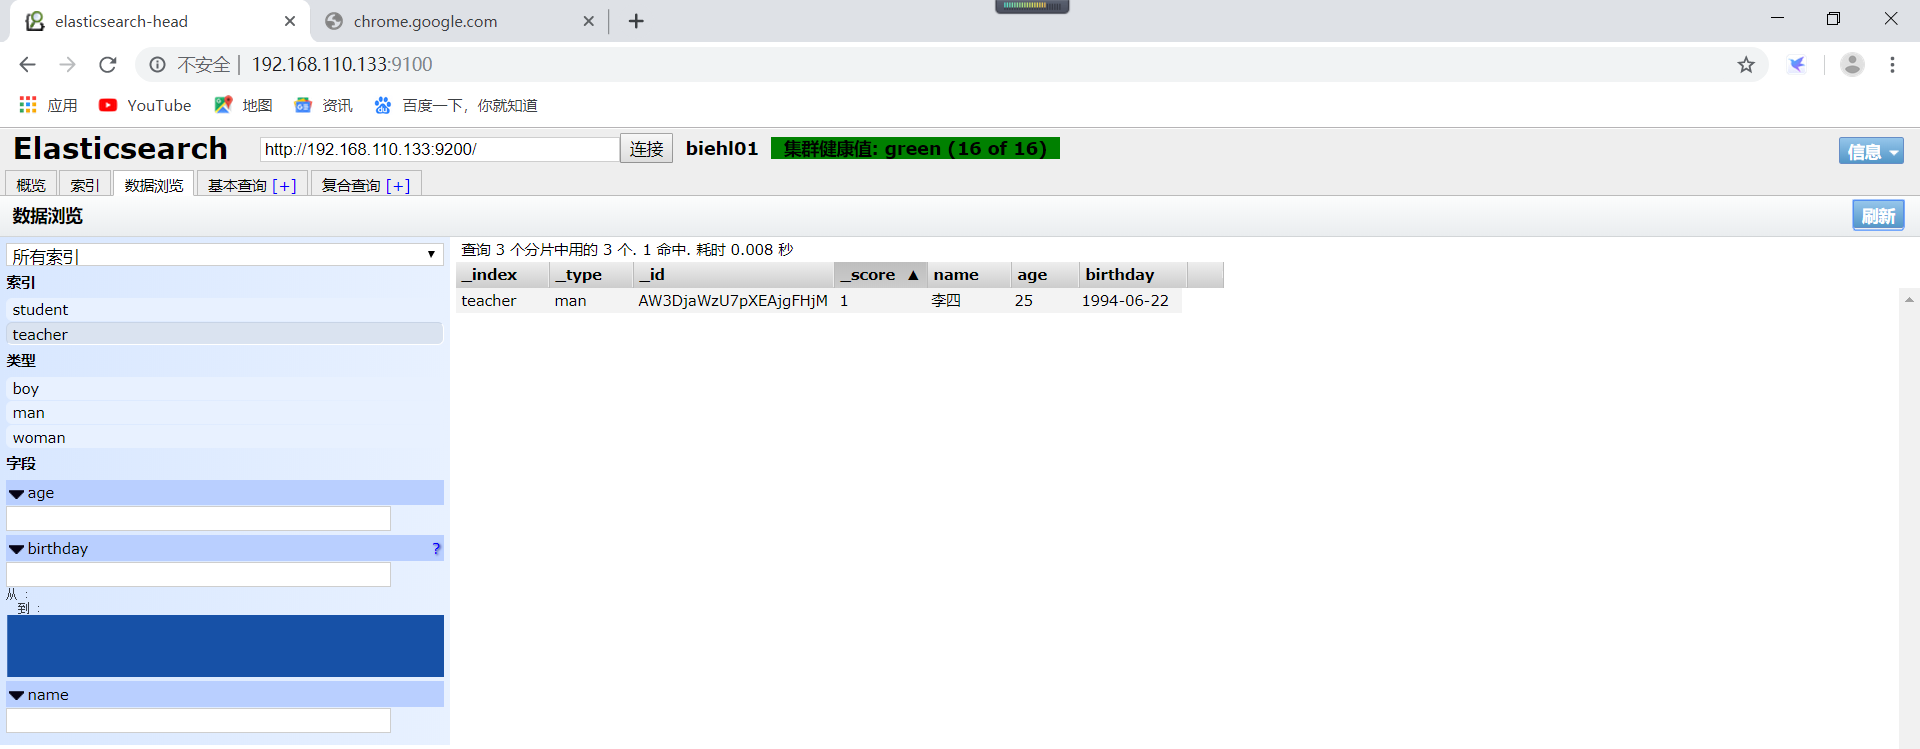
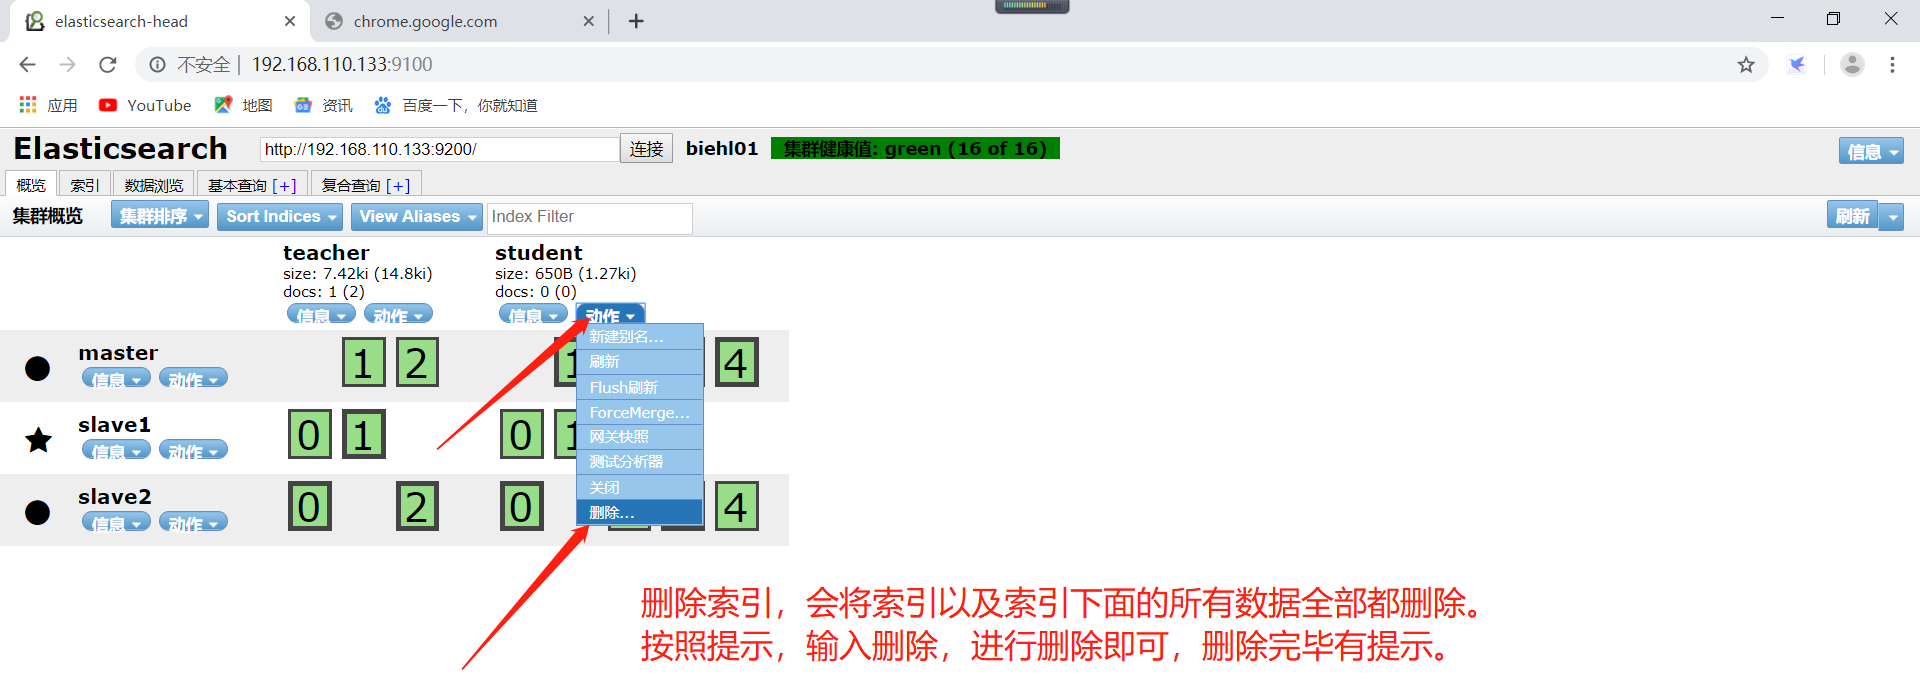
如何刪除一個索引呢,可以直接使用head插件進行刪除即可。也可以使用請求刪除索引。
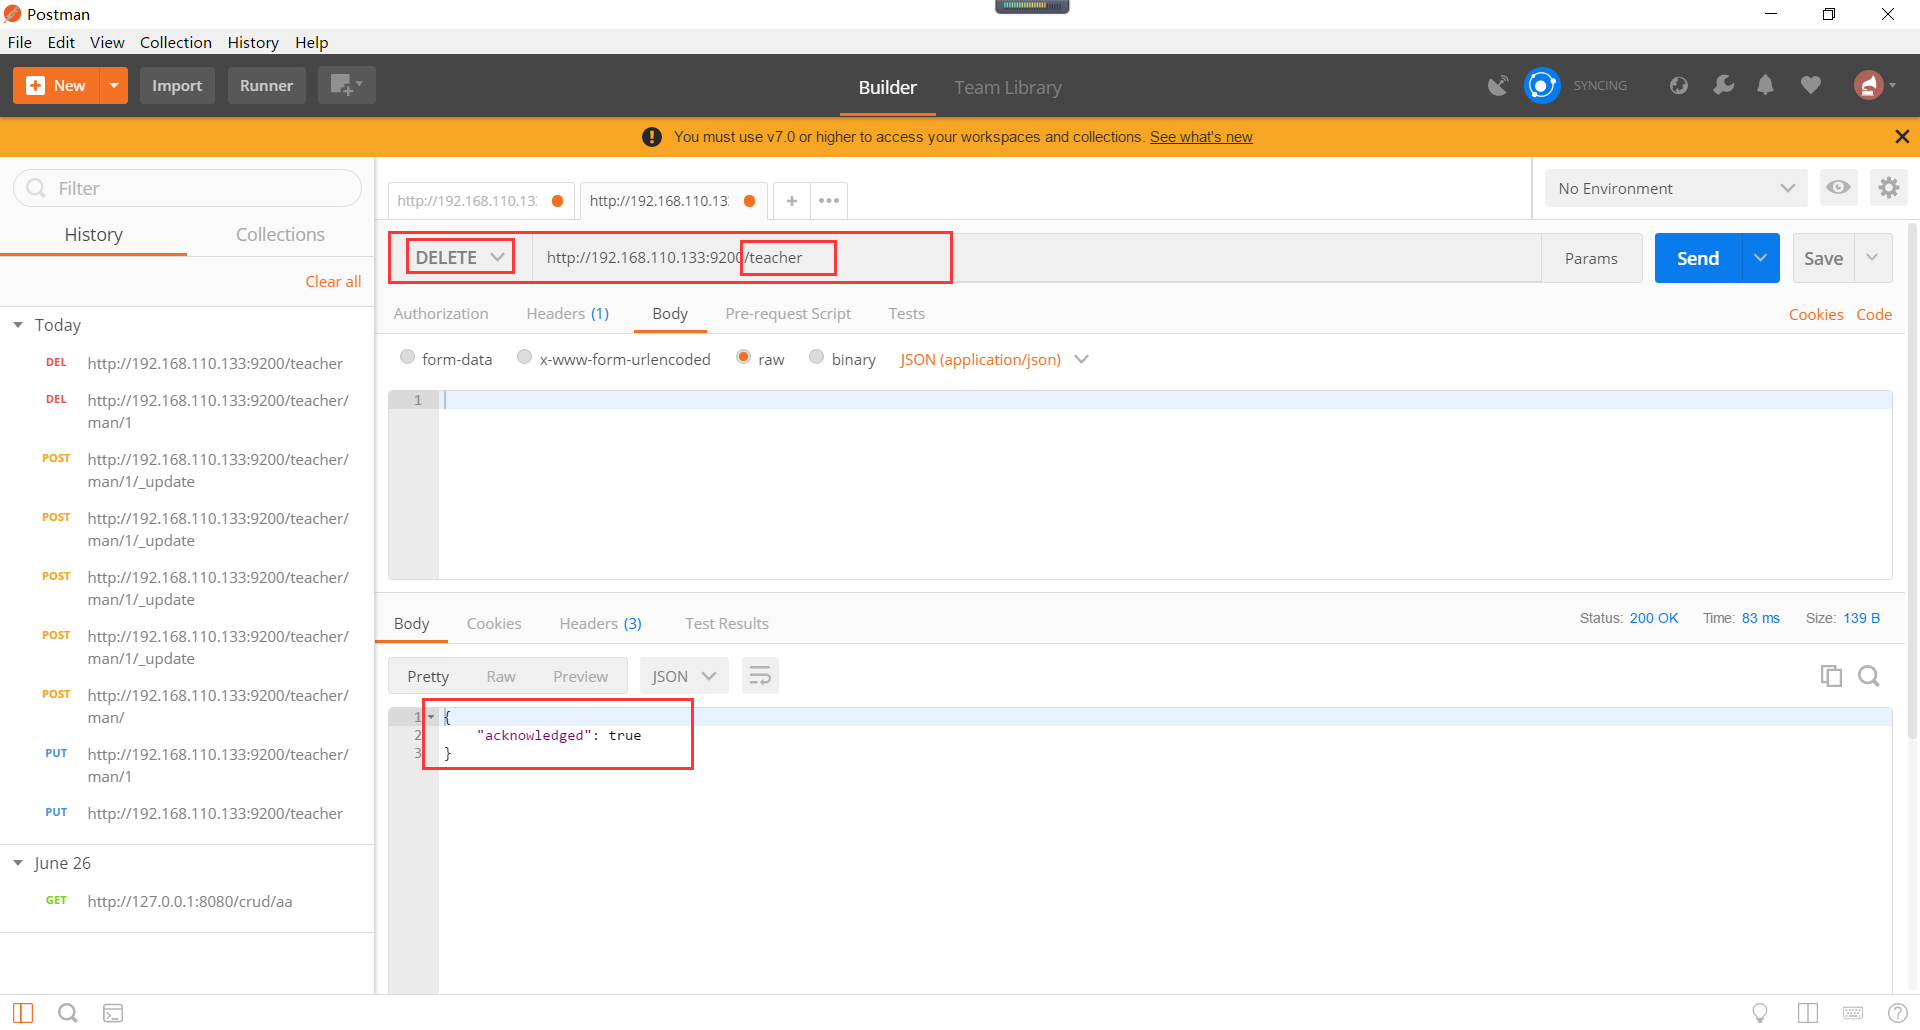
使用postman的http請求刪除索引,如下所示(注意:刪除索引,是高危操作,索引刪除,其下的數據也將全部刪除):
10、Elasticsearch的查詢,分為簡單查詢,條件查詢,聚合查詢。(注意:Elasticsearch的查詢才是重中之重哦!)。
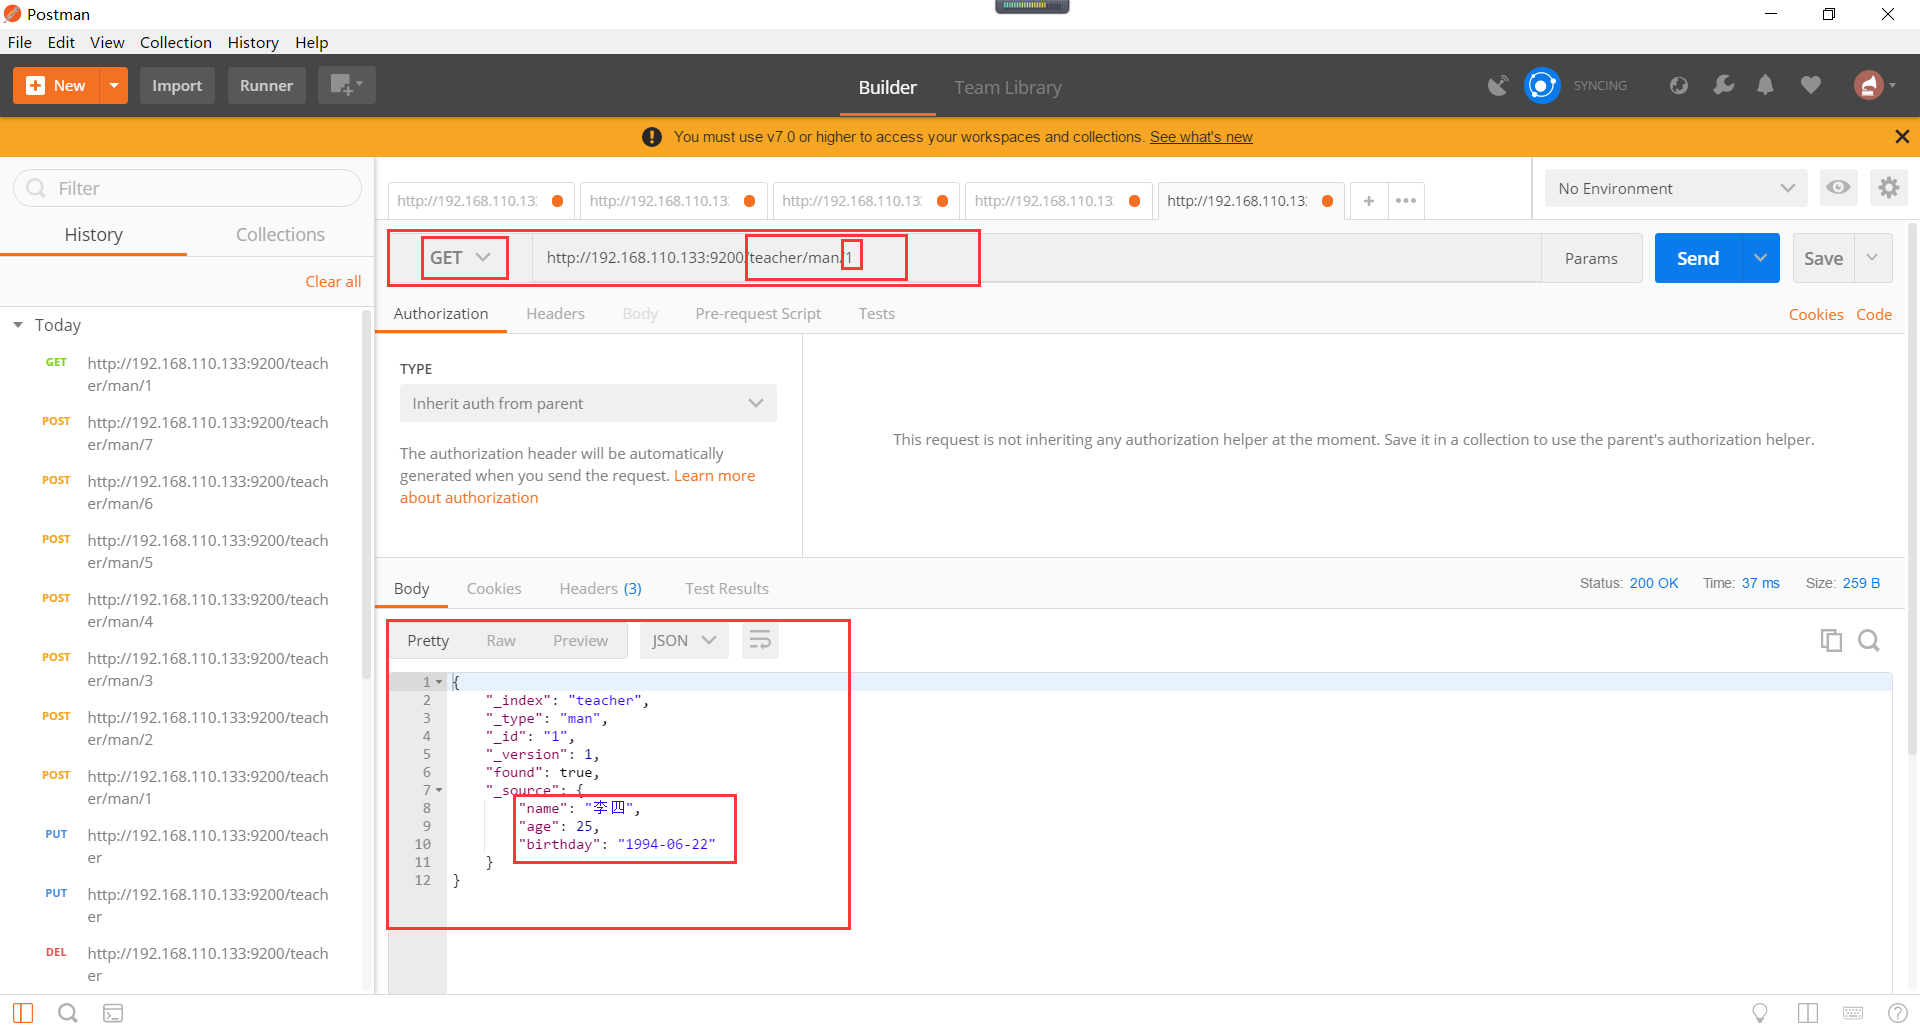
Elasticsearch的條件查詢如下所示:

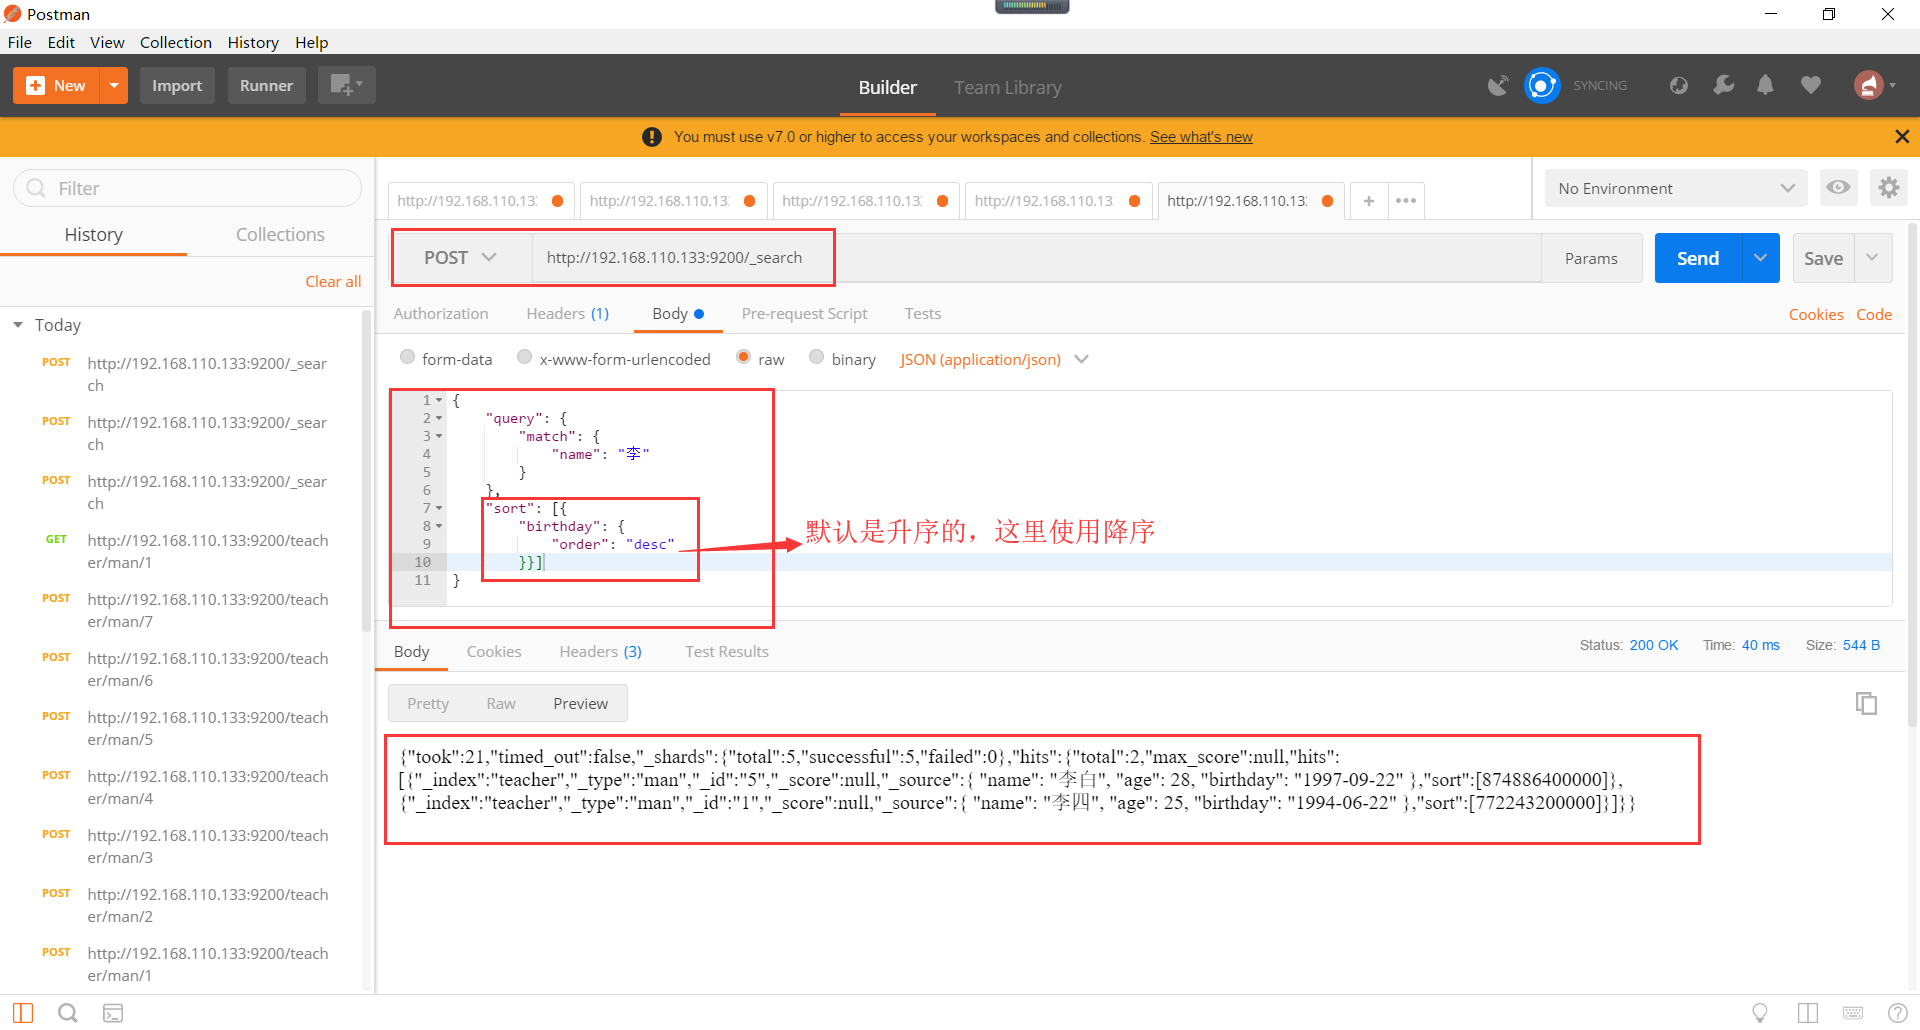
如何對Elasticsearch查詢進行關鍵詞的查詢。查詢出的數據順序,以_score欄位進行默認倒排的。

查詢出的數據順序,以_score欄位進行默認倒排的。如何指定數據顯示的順序呢,如下所示:
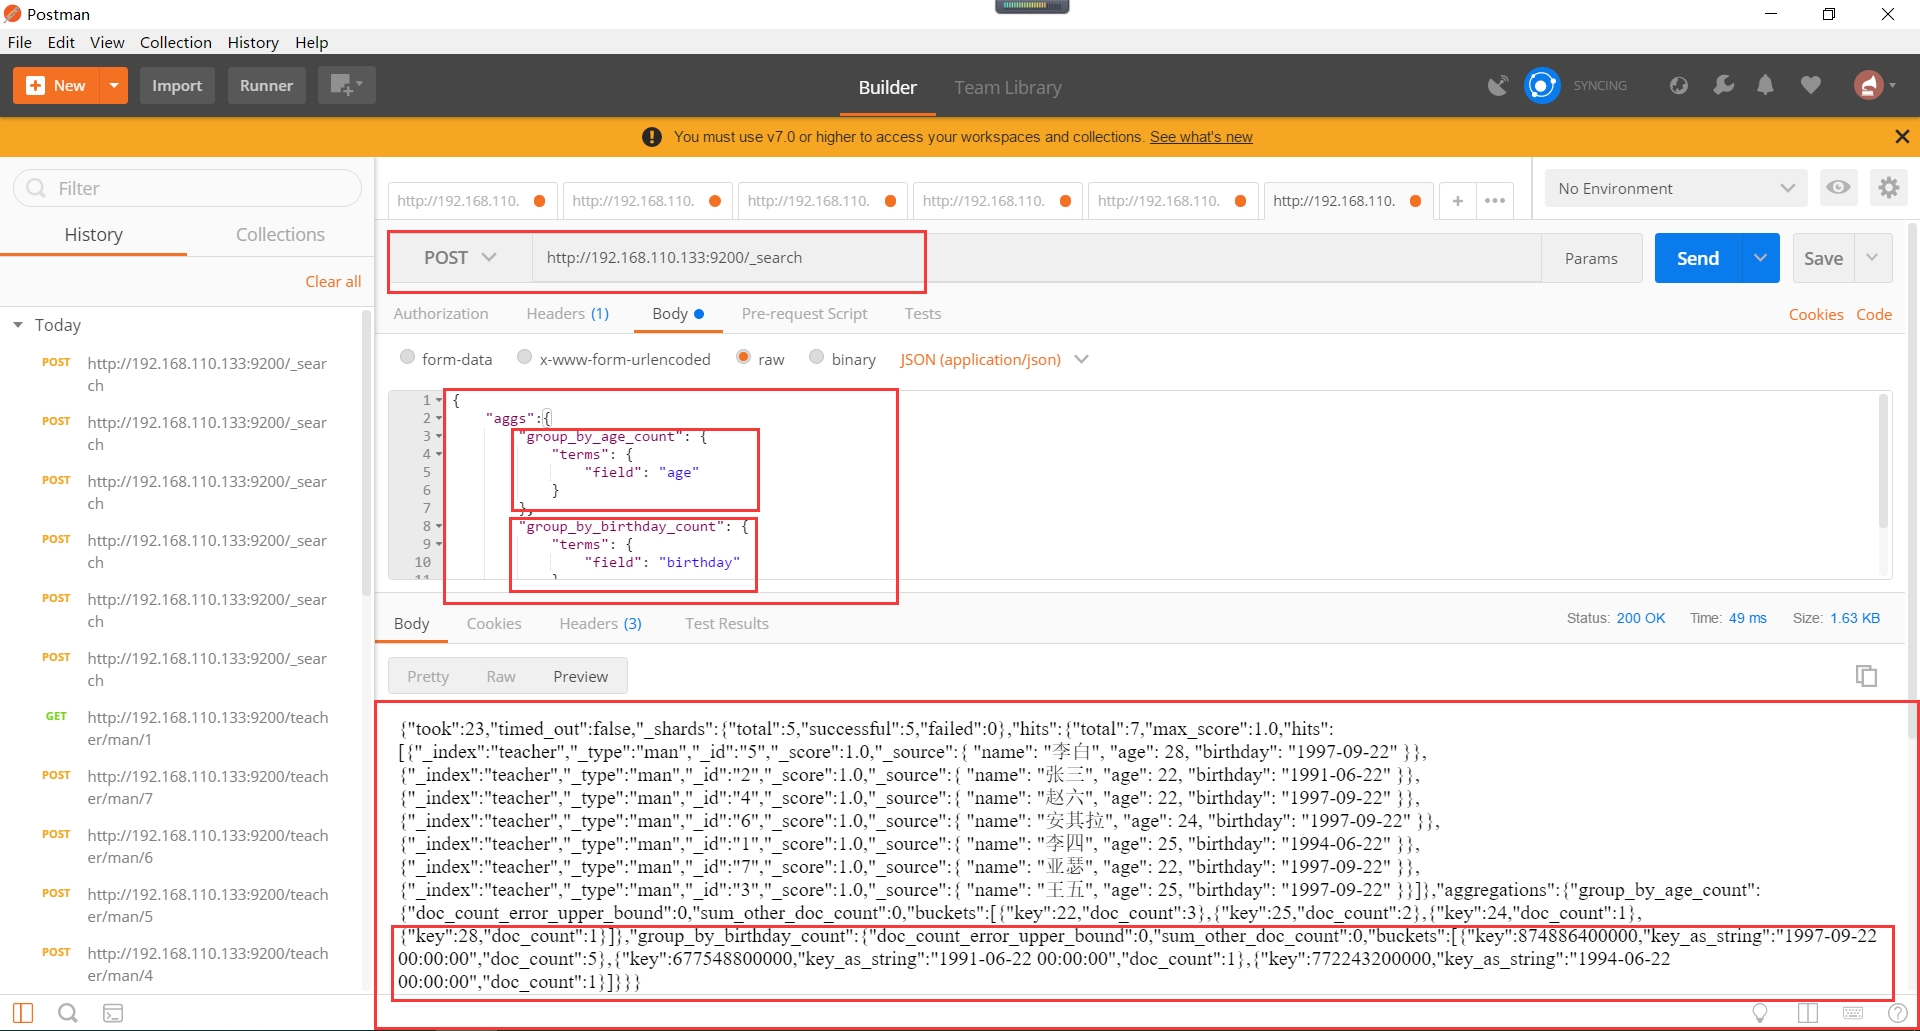
Elasticsearch聚合查詢如下所示:
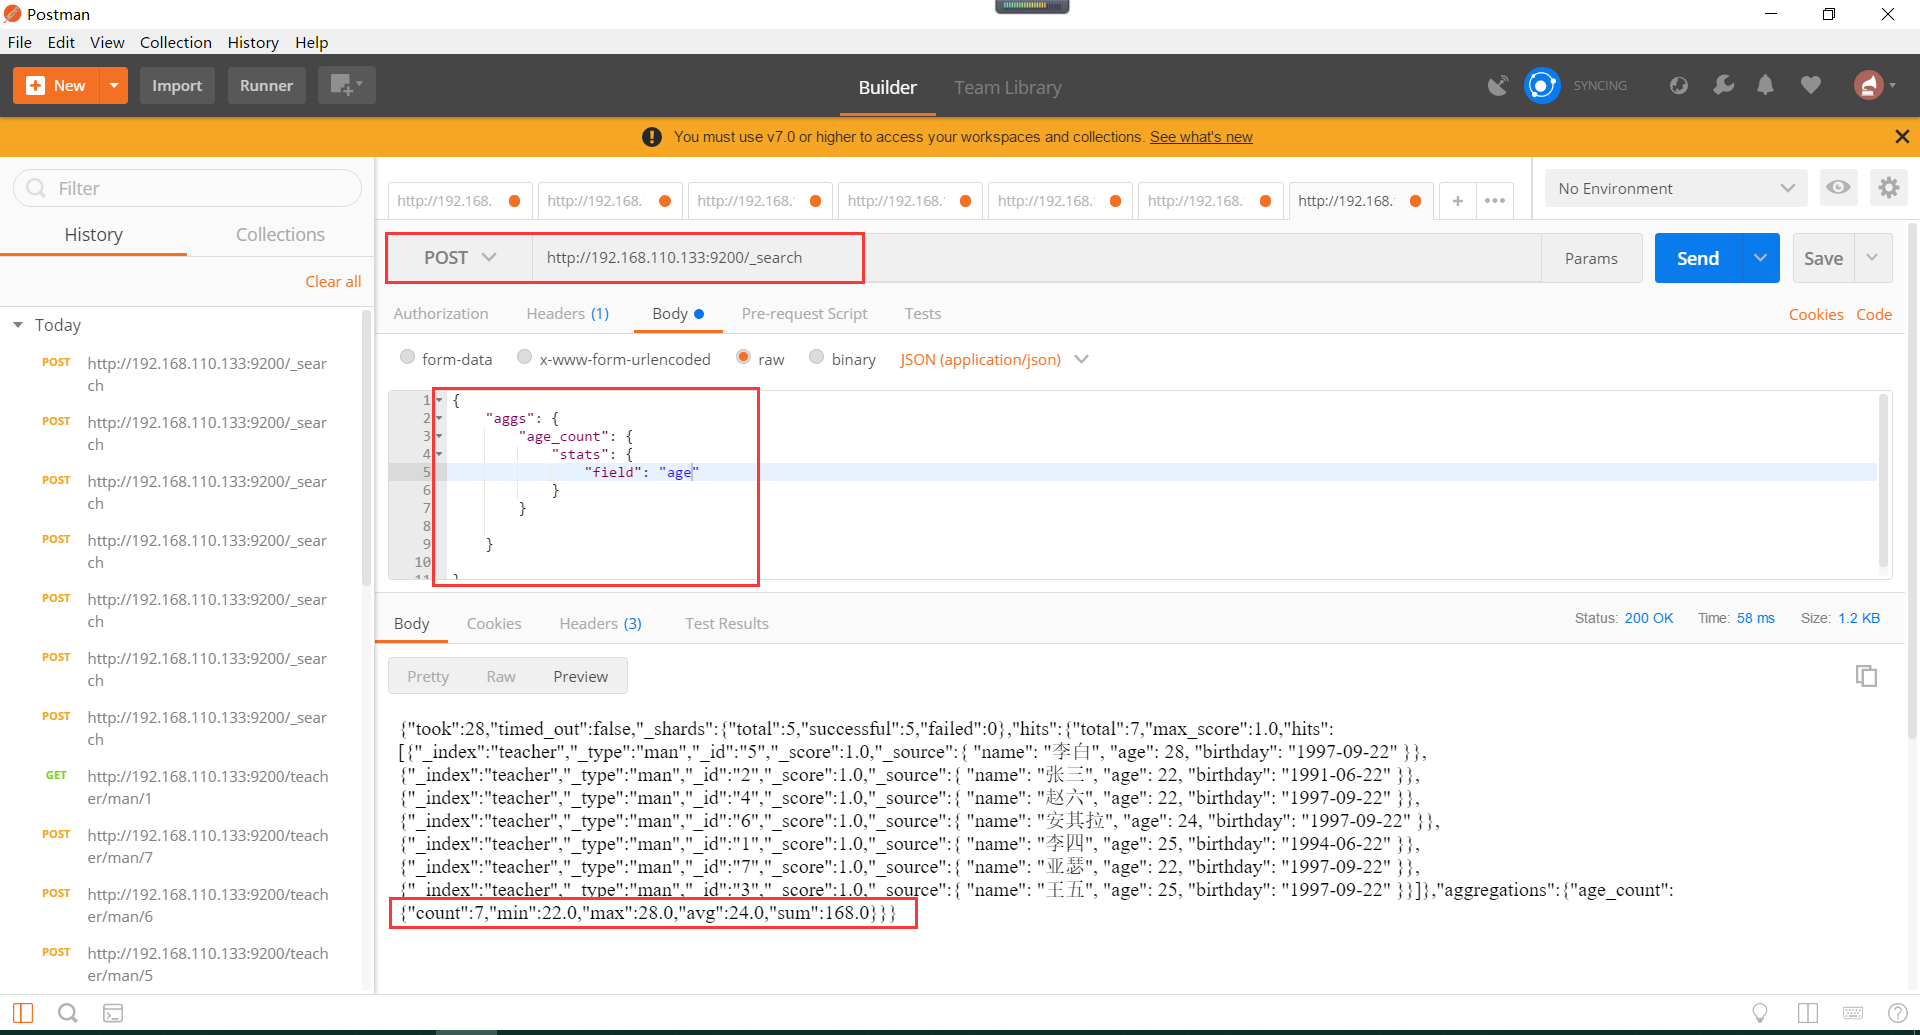
複雜的聚合函數使用如下所示,可以計算最小值,平均值,最大值等等:
11、Elasticsearch的高級查詢。高級查詢包含子條件查詢(也叫做葉子條件查詢),指特定欄位查詢所指特定值。複合條件查詢,指以一定的邏輯組合子條件查詢。子條件查詢包含Query context、Filter context。
1)、Query context是指在查詢過程中,除了判斷文檔是否滿足查詢條件外,es還會計算一個_score來標識匹配的程度,旨在判斷目標文檔和查詢條件匹配的有多好。Query context常用查詢,包含全文本查詢,即針對文本類型數據。欄位級別查詢,針對結構化數據,如數字、日期等等。全文本查詢有模糊匹配,短語匹配,多個欄位的匹配查詢,以及語法的查詢等等。
模糊匹配查詢,如下所示,但是模糊匹配有一個缺點,就是比如模糊查詢"java入門",會查詢出"java高級編程","elasticsearch入門"等等這些詞語。
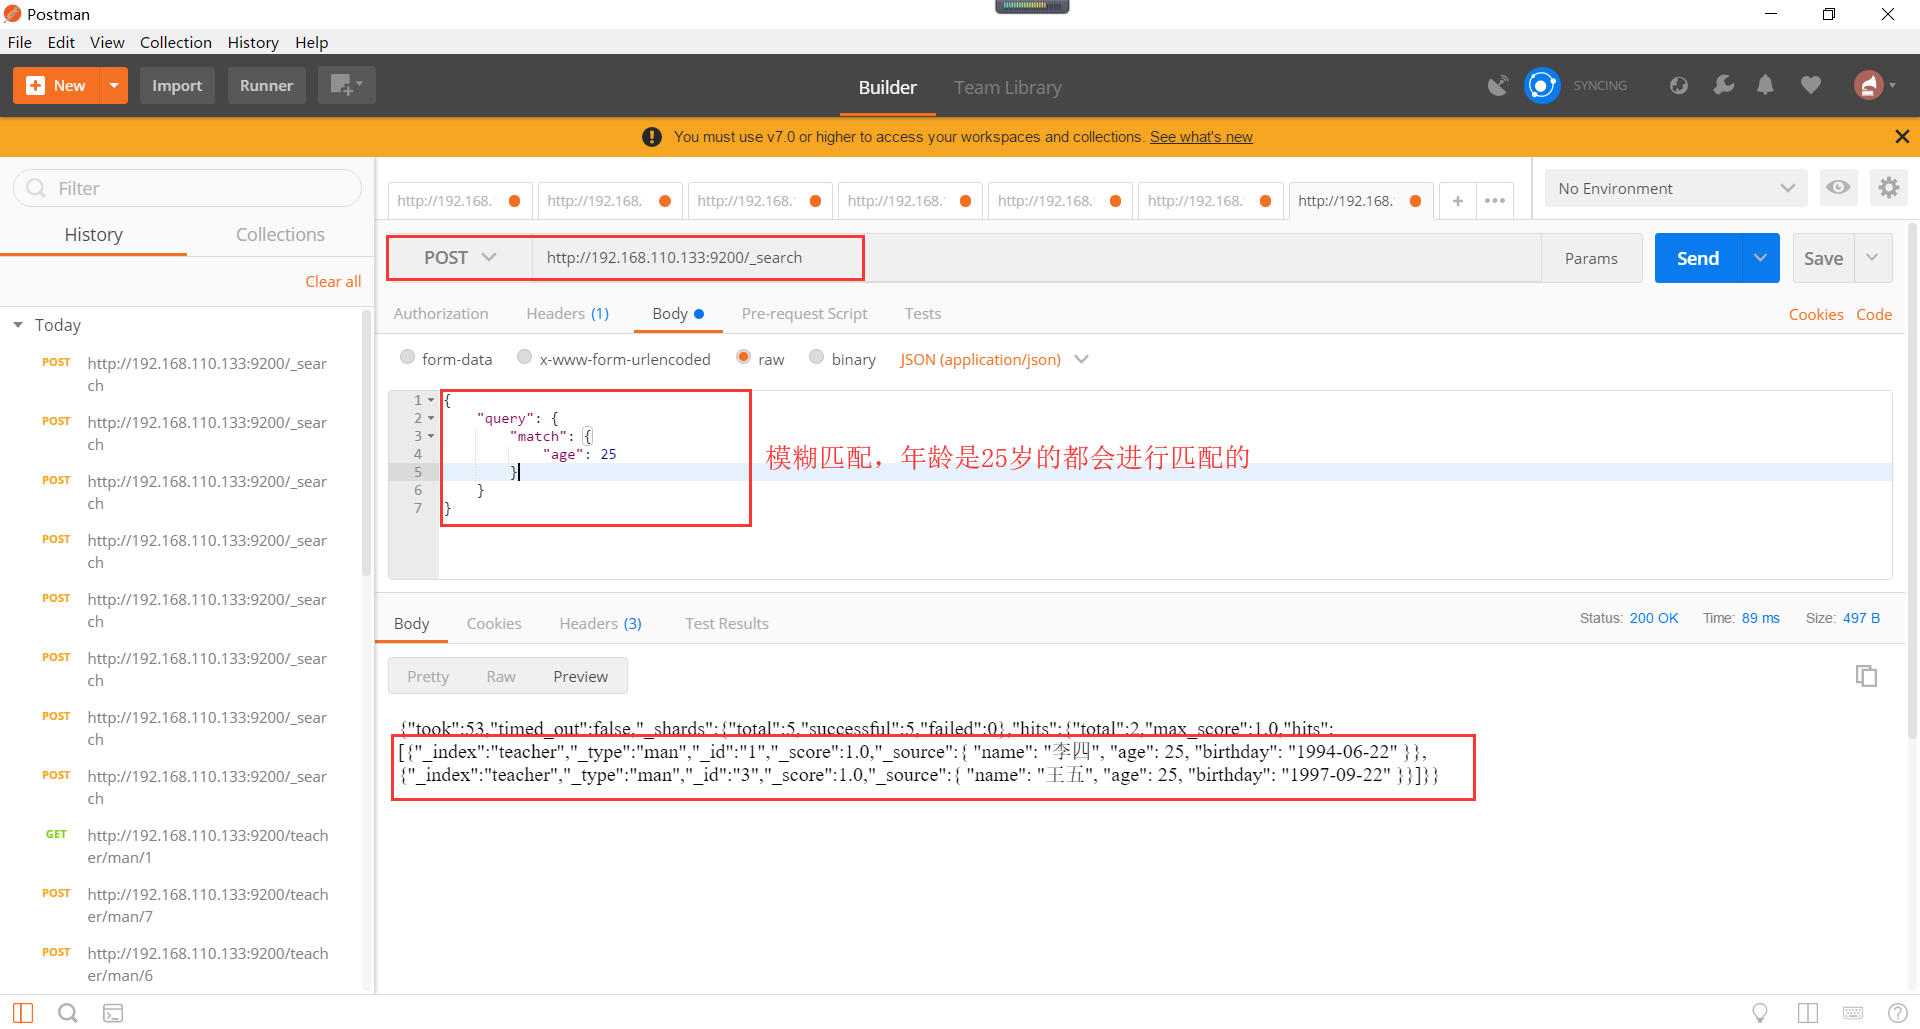
Elasticsearch短語匹配如下所示:
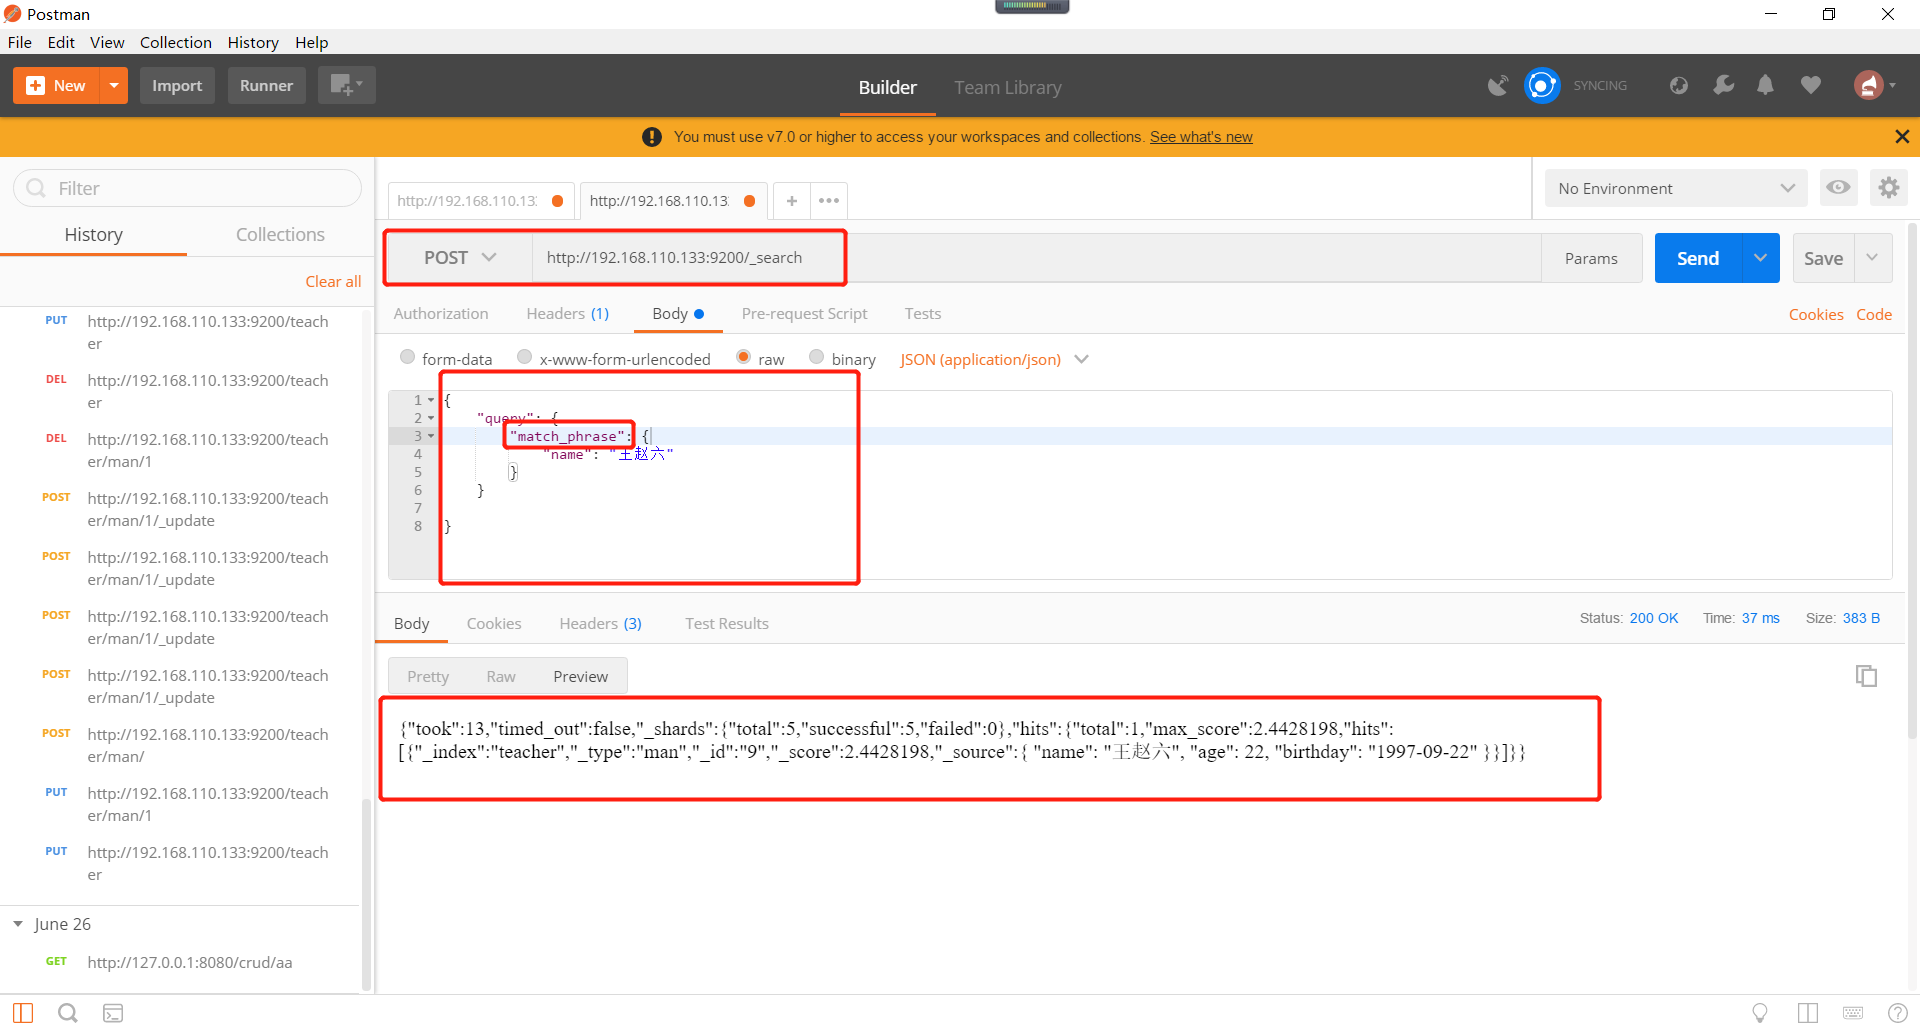
Elasticsearch多欄位模糊匹配查詢。
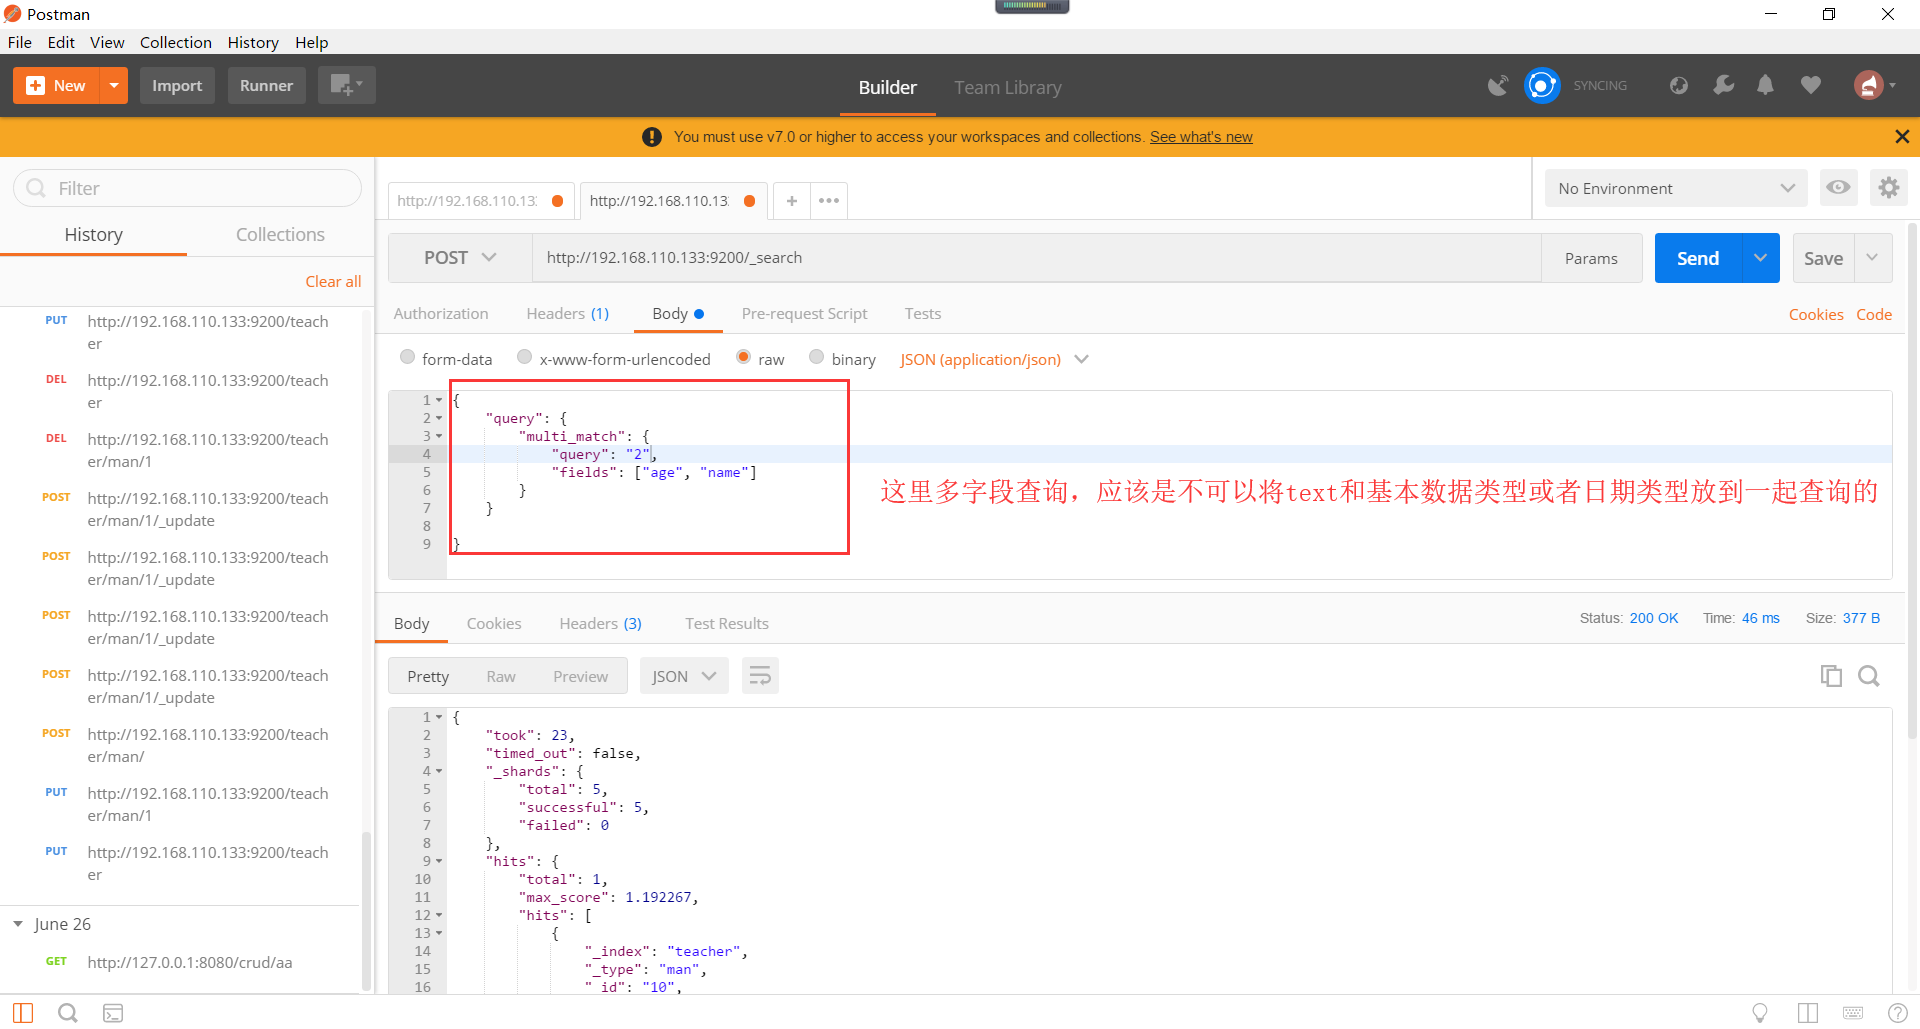
Elasticsearch語法查詢。語法查詢,是根據一定的語法規則進行的查詢,一般用作數據搜索,支援通配符,boolean查詢,範圍查詢,正則表達式查詢。
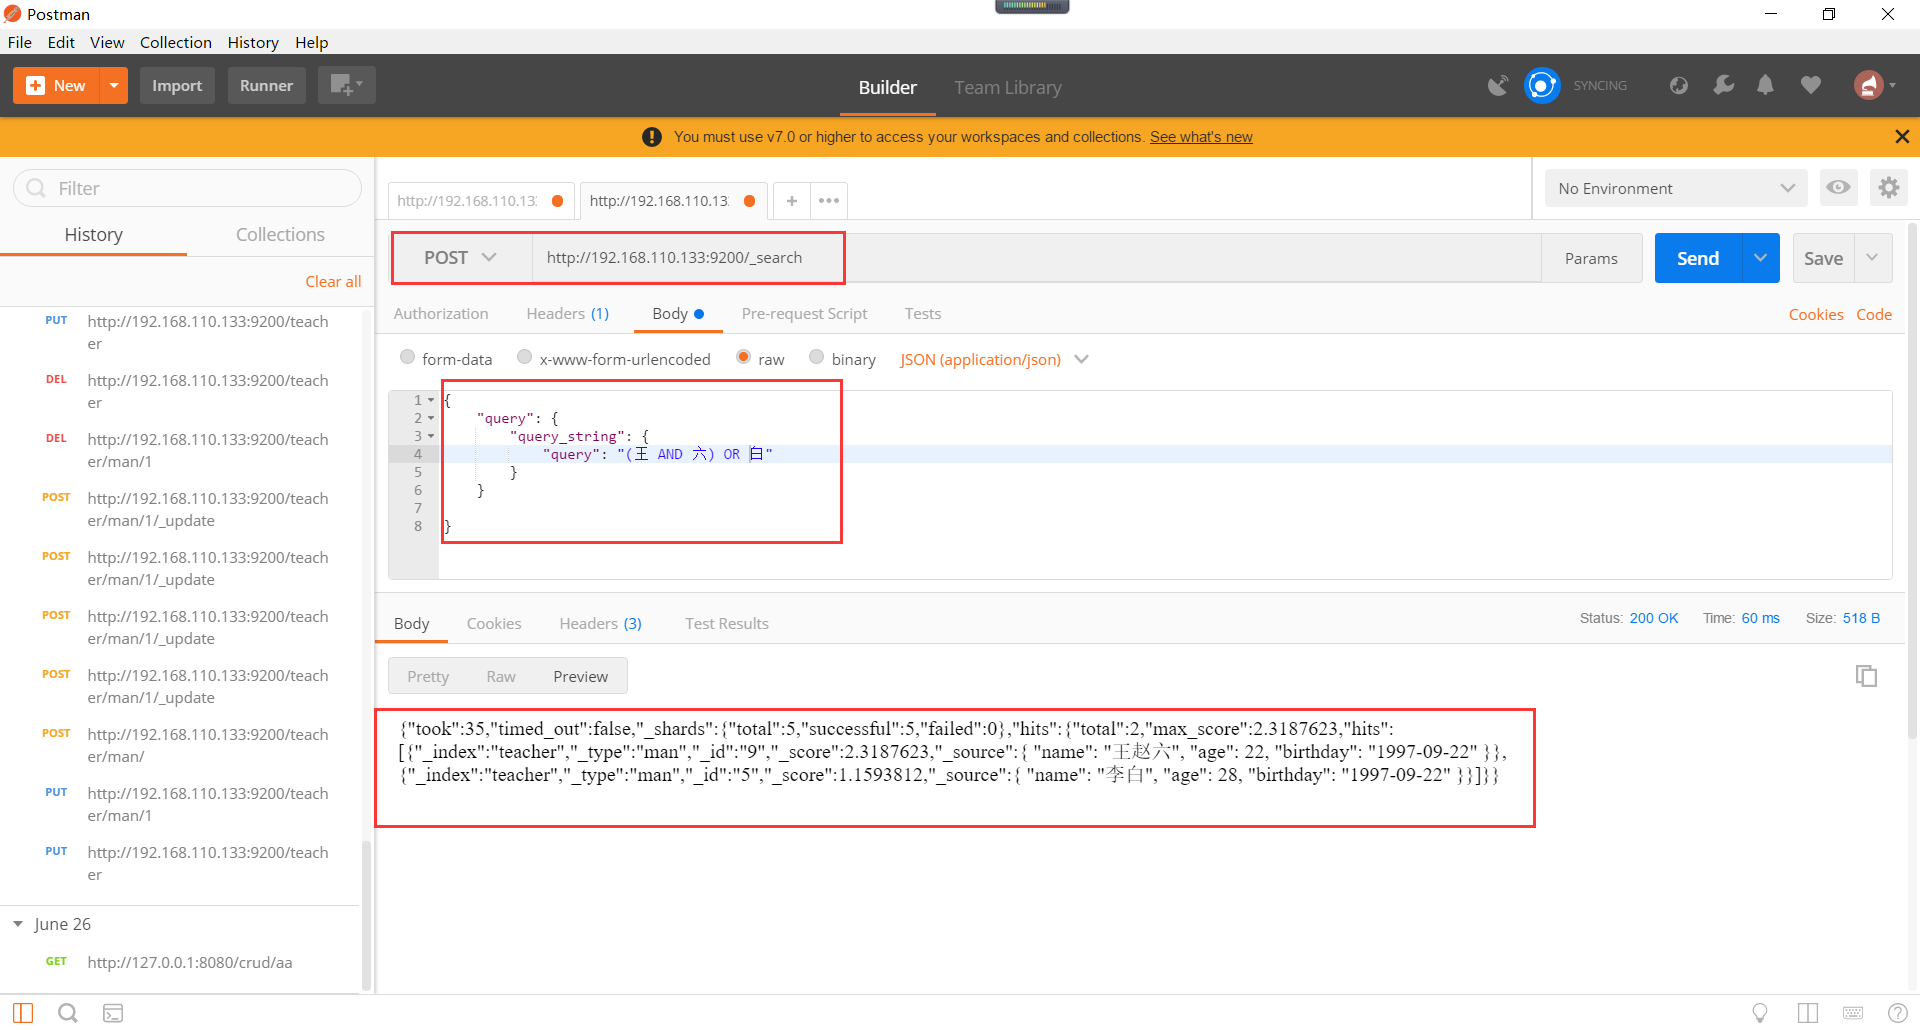
語法查詢的多欄位查詢如下所示:
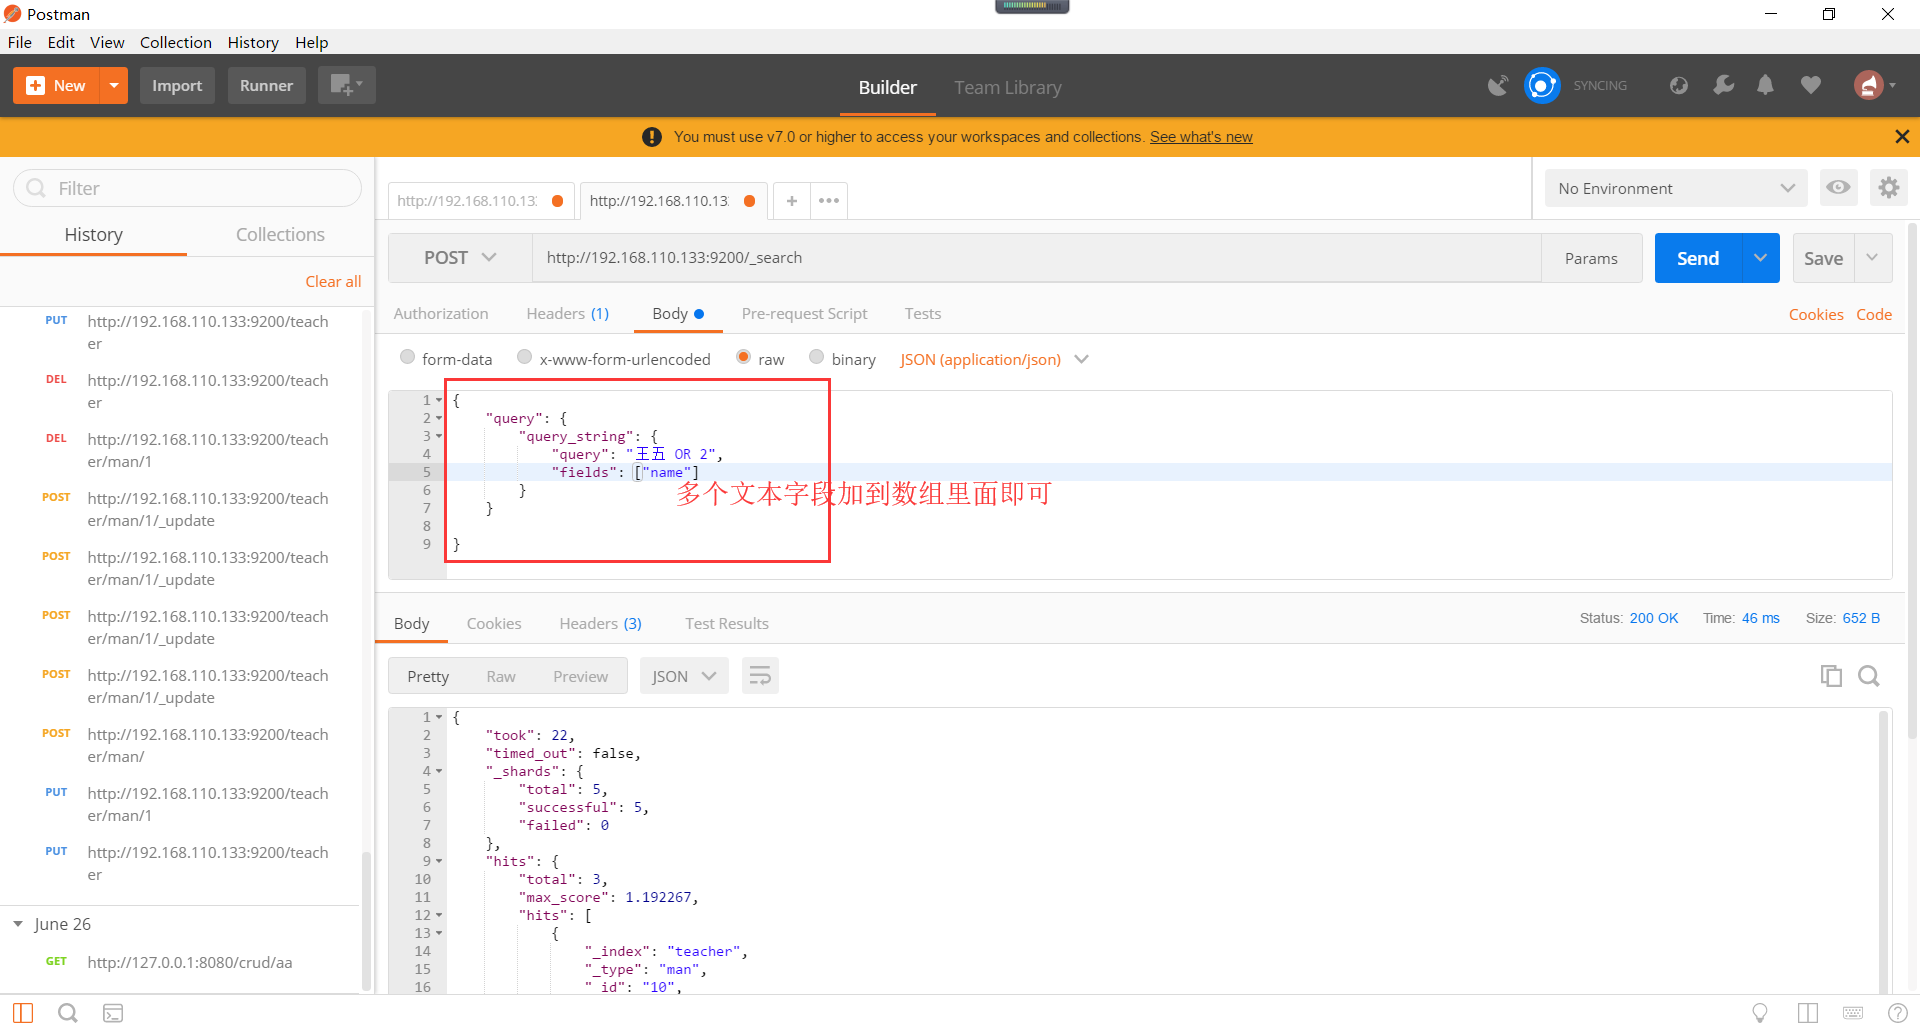
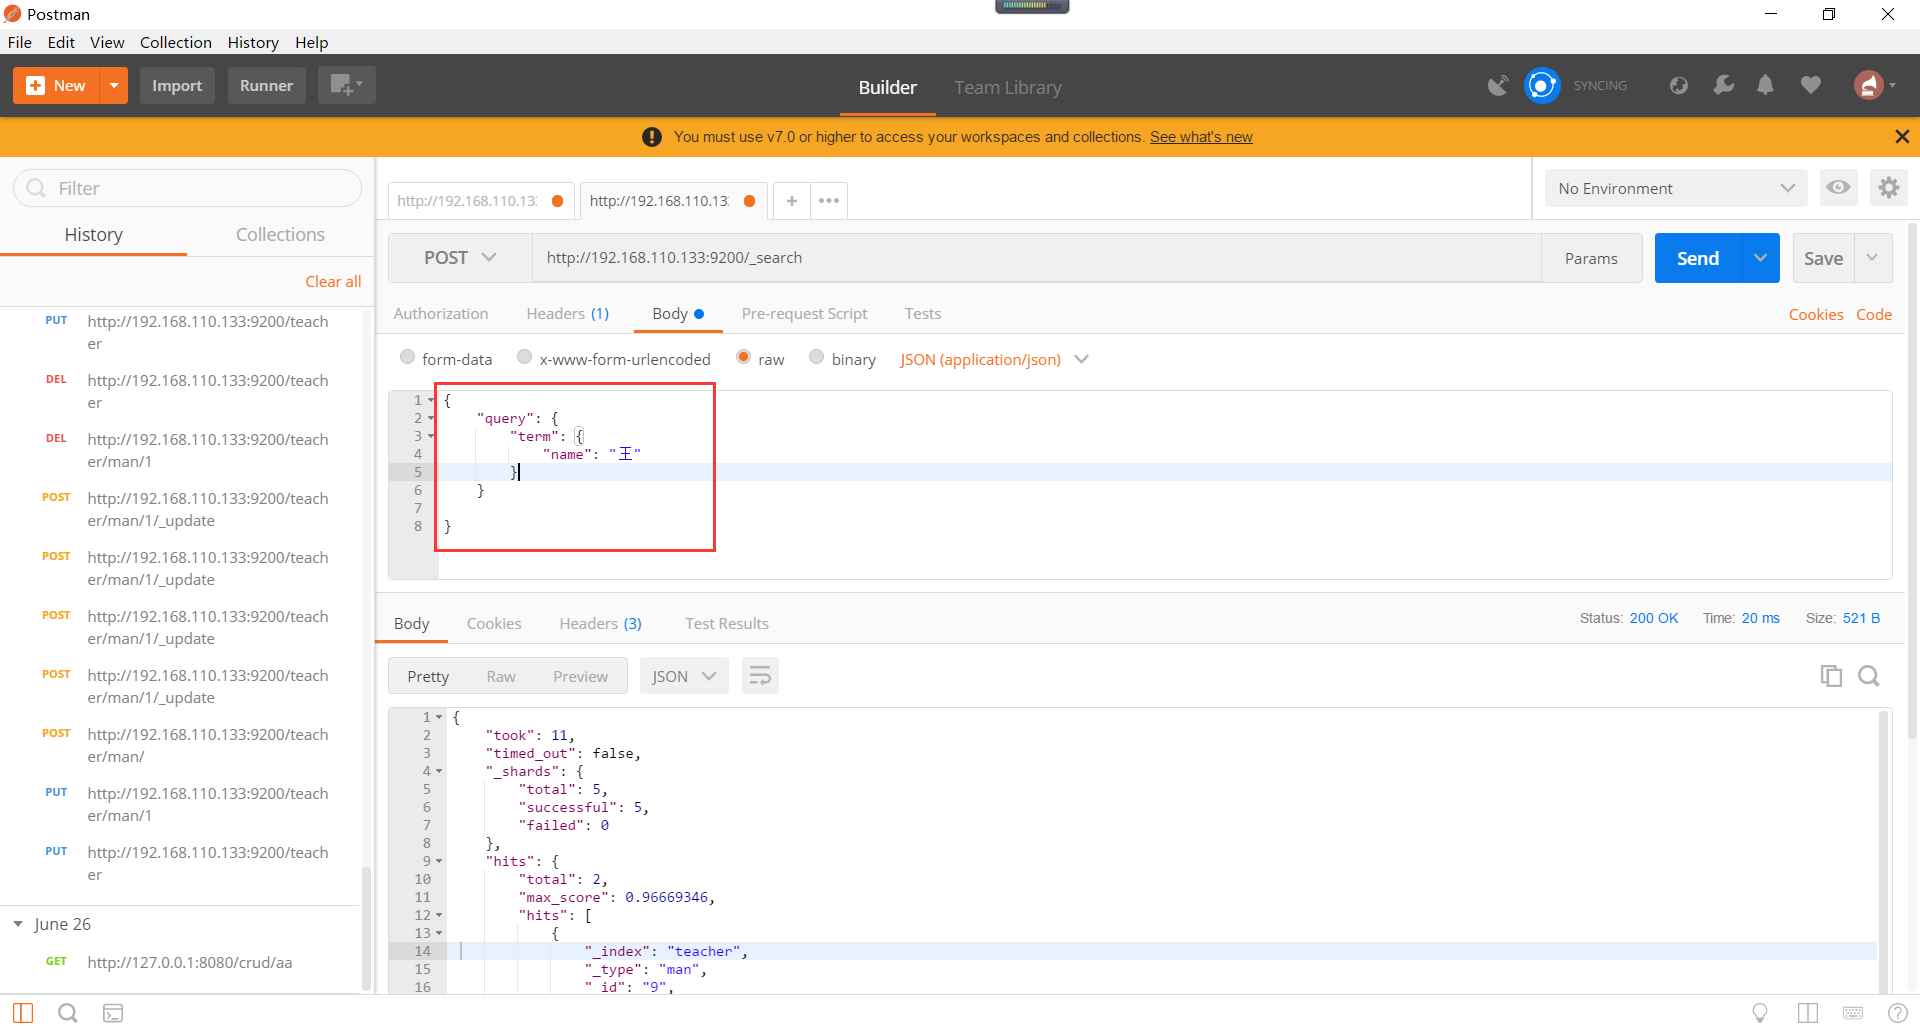
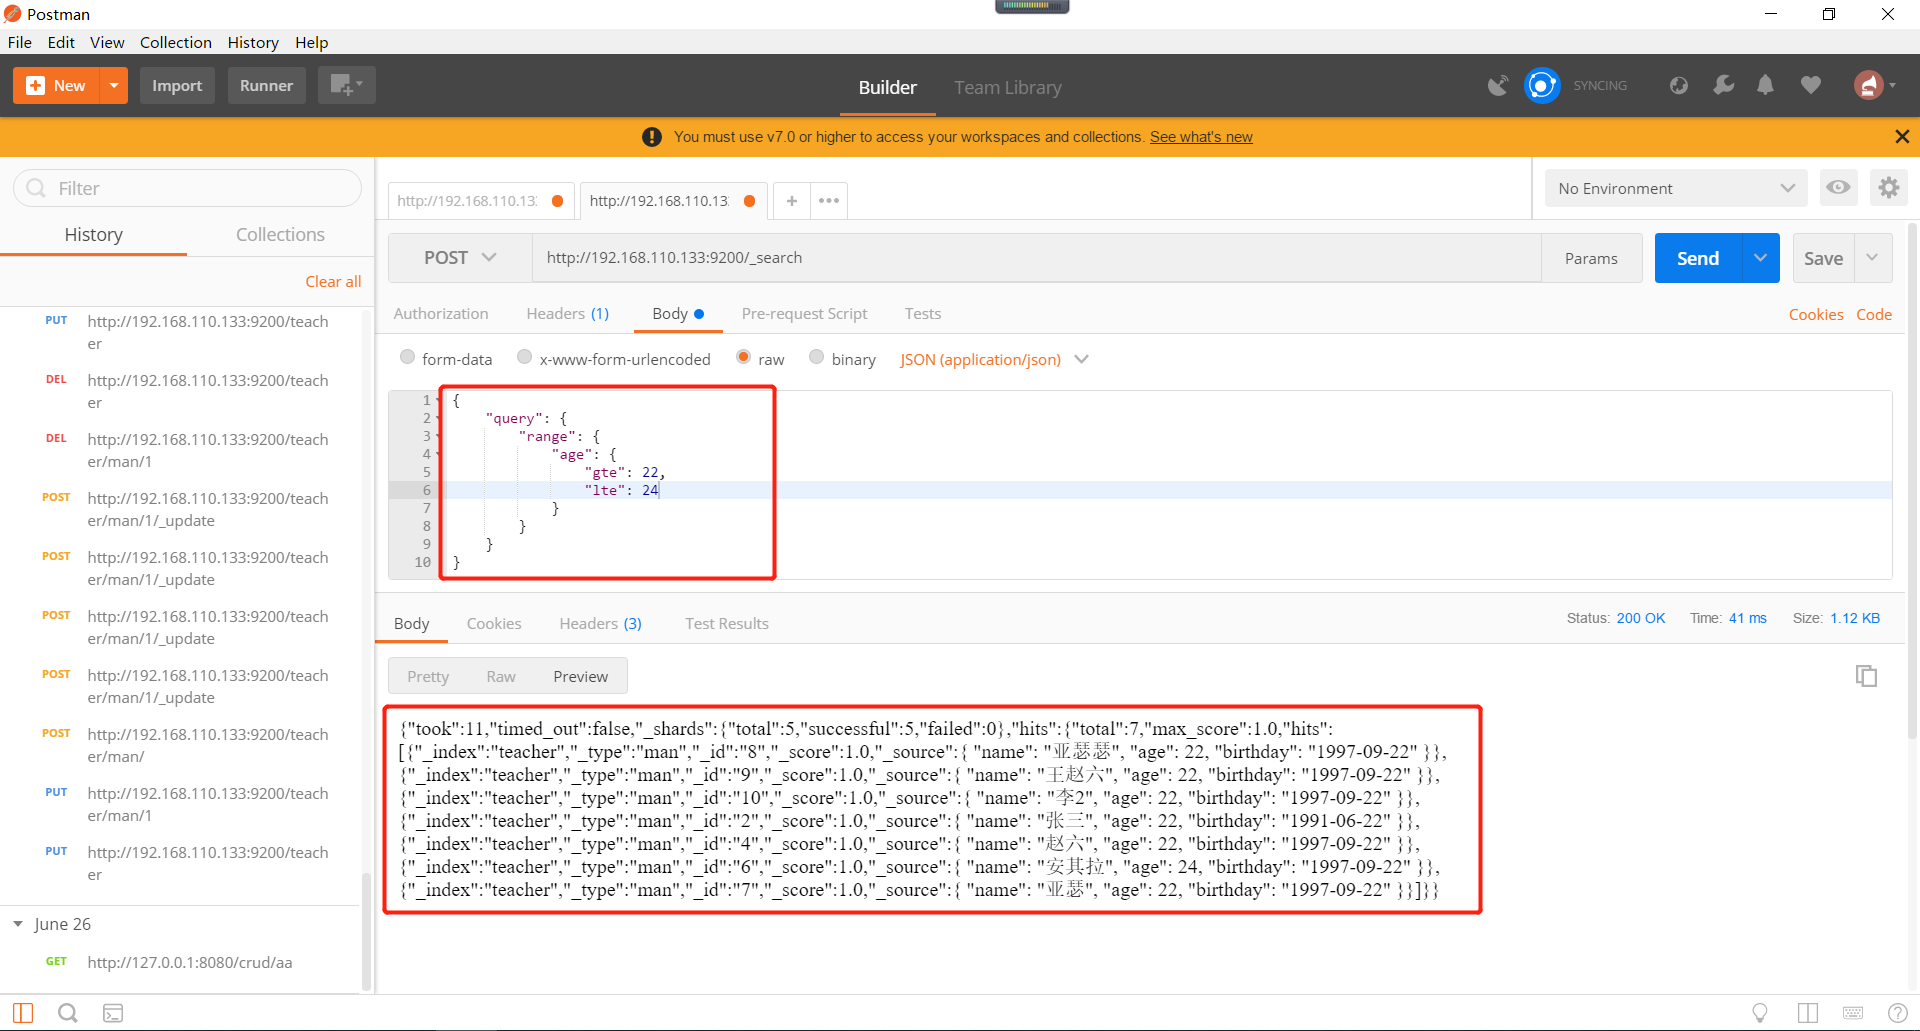
Elasticsearch欄位的查詢,即結構化數據的查詢。term是具體項的含義,range是範圍的含義。如下所示:
Elasticsearch範圍的查詢,gte是大於等於的含義,lte是小於等於的含義。gt是大於的含義,lt是小於的含義。
2)、Filter context的含義,Filter context在查詢過程中,只判斷該文檔是否滿足條件,只有yes或者no。Filter context主要用來做數據過濾的,查詢的結果會被快取起來。
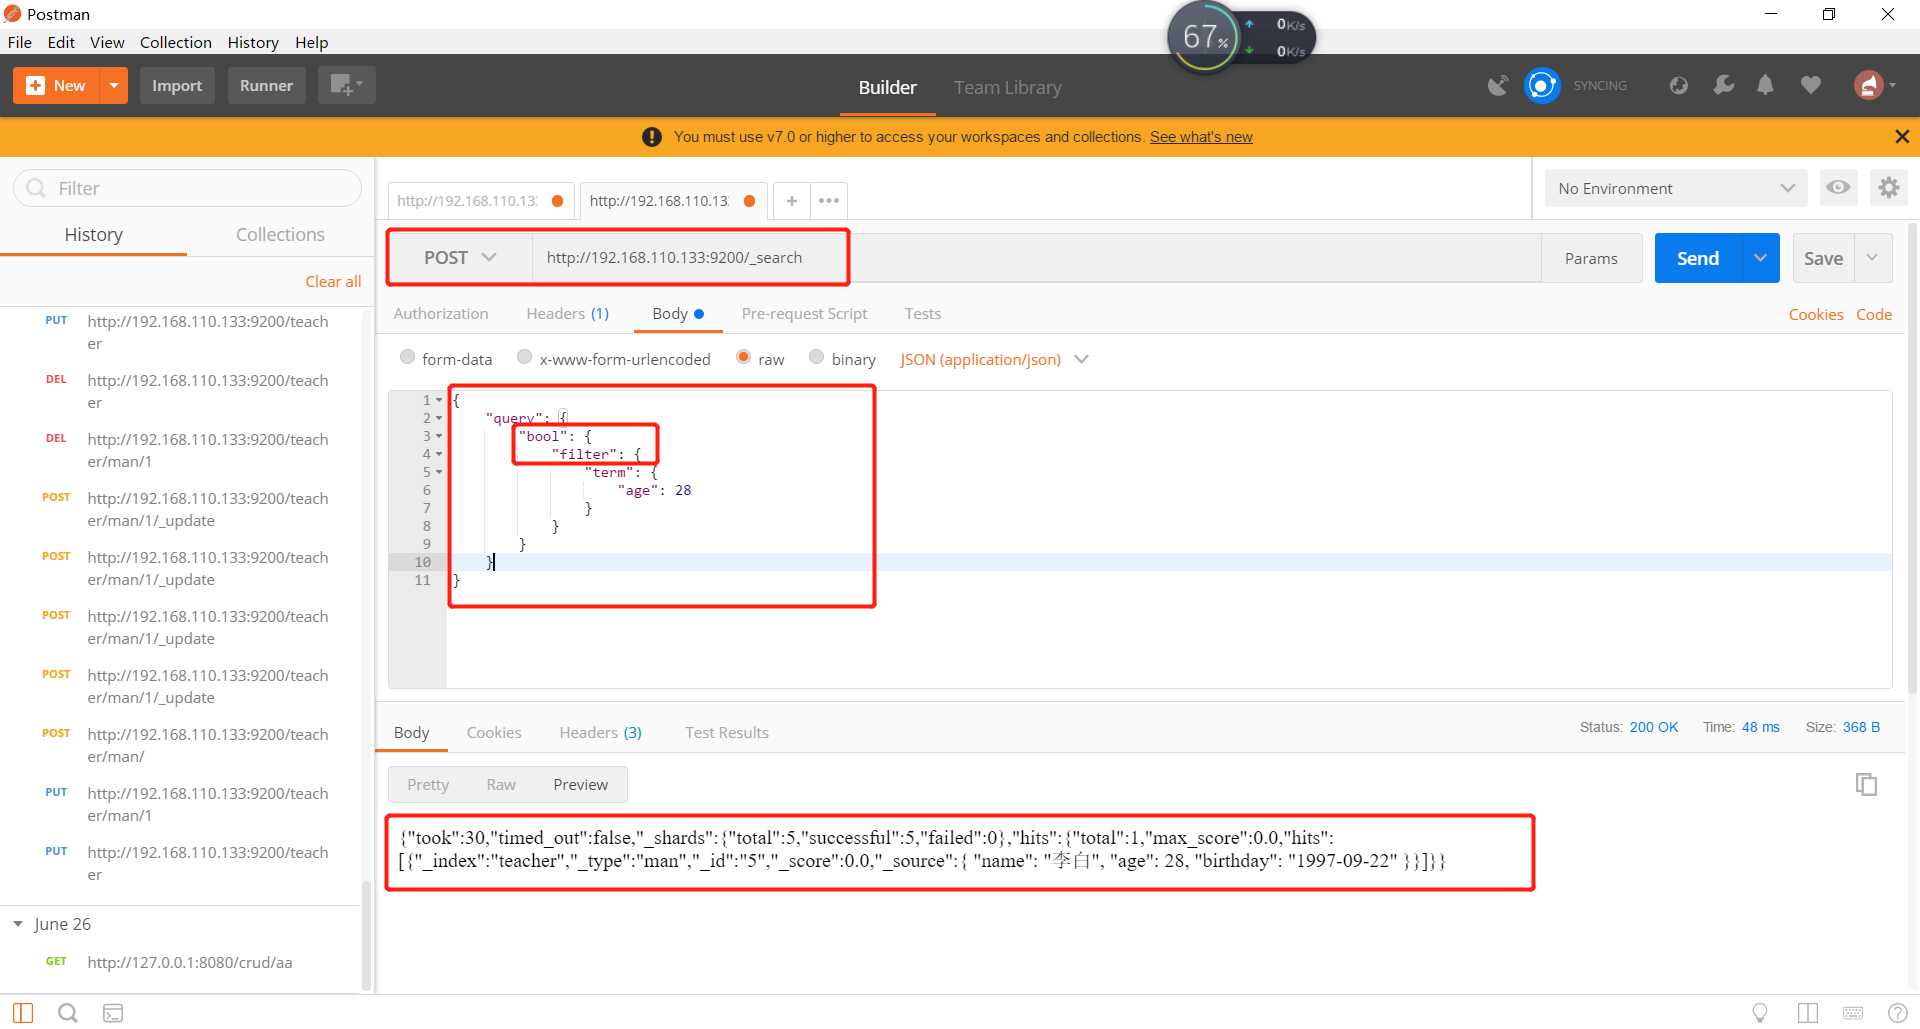
Query Context和Filter Context的複合查詢,常用查詢如固定分數查詢、布爾查詢。,如下所示:
Elasticsearch在查詢返回後會給一個評分_score這個值,固定分數查詢就是將分數固定下來,boost可以設置分數的值,如下所示:

布爾查詢如下所示,should是或者的關係,滿足條件之一即查詢出來,must是必須滿足兩者才查詢出來,must就不截圖了,替換成should即可測試:

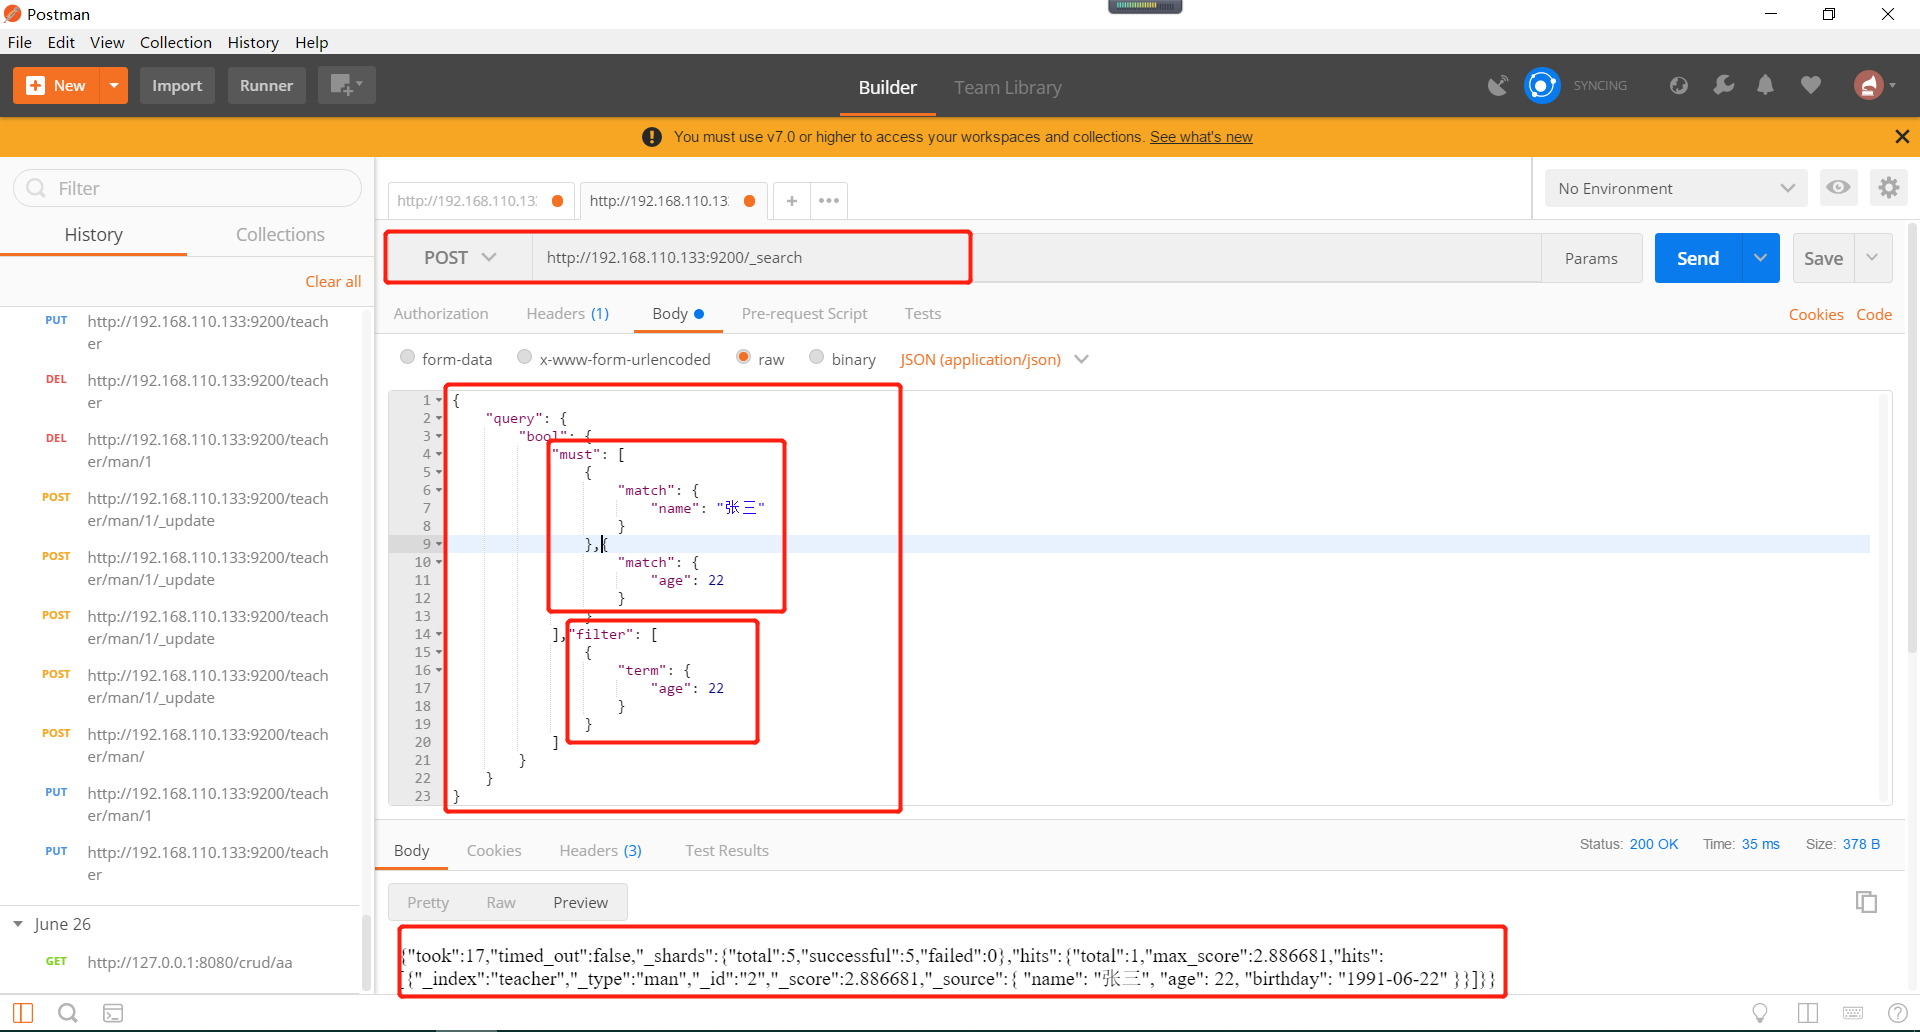
布爾查詢和過濾組成的組合查詢,must的反義是must_not,自己可以進行測試即可,must和should的替換自行測試,如下所示:
作者:別先生
部落格園:https://www.cnblogs.com/biehongli/
如果您想及時得到個人撰寫文章以及著作的消息推送,可以掃描上方二維碼,關注個人公眾號哦。