爬蟲那點事,干就玩了之seleunim
- 2019 年 10 月 12 日
- 筆記
做技術我們最重要的是【做】。但是今天我們來講片【玩】。這句話可能不太好理解。直接開門見山吧。對於外行朋友一談到IT他們對我們的定位就是黑客。其實我們和黑客一點關係都沒有。今天的技術是【爬蟲】 。 為什麼說爬蟲和黑客有點關聯呢。因為爬蟲可以將人為行為進行機器化。就是實現編寫好程式碼讓機器代替我們人類重複的操作意見事情。
對於爬蟲了我們這裡不做基礎的講解了。在平時的開發中我們偶爾會用到爬蟲。比如說我們系統需要添加天氣情況。但是我們有沒有氣象站給我提供數據。這時候我們最顯示的做法就是調用網路上免費的天氣介面API 。 這個時候我們Java就會通過爬蟲模擬除一個瀏覽器請求去訪問這個天氣介面的API。 然後在通過爬蟲獲取這個API返回的數據。從而進行解析。
對於這些免費的API我們通過爬蟲(HttpClient)就可以輕鬆的訪問了。但是想優酷、愛奇藝、掘金這些等級網站他們會有發爬蟲策略。最常見的就是利用爬蟲進行刷票的行為。他們針對這些刷票做了一些措施。具體措施就不說了(不知道)。更有甚者他們對他們的頁面進行加密。讓你無法分析他們的html.或者加大你分析的成本。以上就是之前我們用爬蟲爬取數據遇到的一些問題。下面簡單梳理下我們遇到爬蟲的問題
- 網路反爬蟲
- 網路人為審核
- 登錄驗證碼
- 需要了解網站(需要有程式碼經驗進行html分析)
selenium
今天我們帶了一個好東西。它轉變了我們傳統爬蟲的思路。傳統的爬蟲我們會去按照開發者的思路去處理邏輯。但是selenium他不需要關注開發者邏輯。只需要我們關注自己的需求。什麼意思呢?就是說selenium他就是在模擬用戶的行為,你告訴selenium我需要點擊頁面的某個按鈕了,他就去點擊了。你告訴他我需要在某個輸入框中輸入內容了。他就去給你輸入內容。有了它,你再也不用管輸入內容之後提交登錄真正請求了。這樣的好處是降低了爬蟲的學習成本。對於不懂技術的人也可以很快上手了。
環境準備
這個是幹嘛的呢?這裡先透露下selenium使用的是瀏覽器的內核操作頁面的。所以這裡需要現在內核。下載內核前提是電腦上有瀏覽器。筆者這裡電腦上瀏覽器是Google 1.73版本 。 所以下載內核就得是對應的版本,否則會報錯的。在notes.txt文件中會列出每個對應的瀏覽器的版本的。
程式碼環境
<dependency> <groupId>org.seleniumhq.selenium</groupId> <artifactId>selenium-java</artifactId> <version>3.141.59</version> </dependency> 開始爬蟲
想想我們平時瀏覽網頁的時候是需要先打開瀏覽器,這裡也是一樣。
【我們需要打開瀏覽器】(我的內核放在/root/Downloads/chromedriver)
ChromeOptions chromeOptions = new ChromeOptions(); File chromeDriverPath = new File("/root/Downloads/chromedriver"); System.setProperty("webdriver.chrome.driver", chromeDriverPath.getAbsolutePath()); chromeOptions.addArguments("--headless"); chromeOptions.addArguments("--disable-gpu"); //ubuntu瀏覽器中需要添加 chromeOptions.addArguments("--no-sandbox"); webDriver = new ChromeDriver(chromeOptions); headless : 表示隱式打開瀏覽器,因為做爬蟲就不需要顯示介面了。
no-sandbox : 這個是因為我的Ubuntu安裝的google需要這個參數,所以這裡也需要加上
disable-gpu : 同上
【輸入鏈接地址】(https://juejin.im/)
webDriver.get("https://juejin.im/");,這樣內核就獲取到了我們在瀏覽器中看到的效果。那麼我們這麼獲取我們需要的頁面數據呢。
findElement通過這個方法我們可以獲取到我們想要的任何數據。換句話說通過這個方法這個頁面在你面前一覽無餘。包括他的衍生頁面
有的讀者有疑問了。我該怎麼讓他獲取我想要的東西呢。
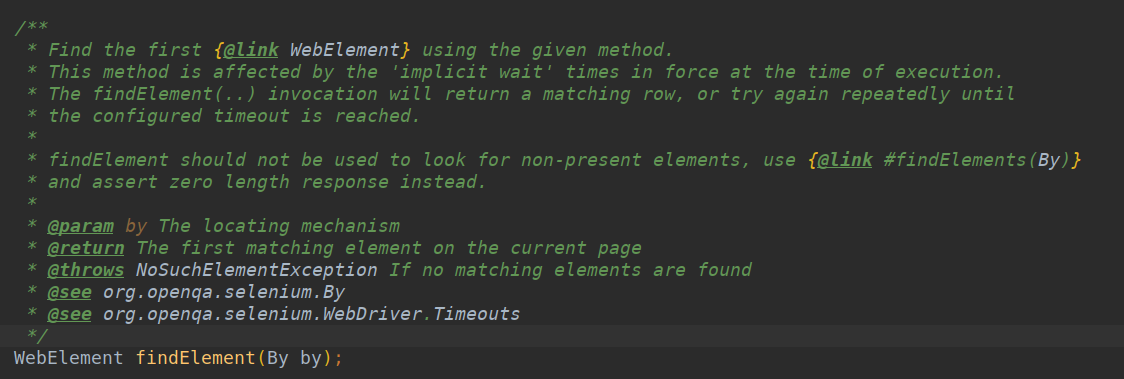
我們可以看出來這個方法里只有一個參數,By對象。這個By對象里提供了如下方法
- id
- linkText
- partialLinkText
- name
- tagName
- xpath
- className
- cssSelector
上面這些方法就是我們定位元素的方法。什麼意思呢,我們前段朋友們經常通過jquery操作html的dom對象,在By對象里cssSelector就是和jquery同樣的操作方法。好多都是和jquery類似的。這裡不懂技術的人會說這裡技術點很難。其實不難。 我們不懂程式碼的怎麼辦呢。我們在瀏覽器瀏覽頁面 。 比如下圖中我想獲取我的部落格名稱(框架原理那點事--不就反射嘛。)

我們滑鼠放在【框架原理那點事--不就反射嘛】上右鍵選擇【檢查】。會自動跳轉到對應的程式碼的
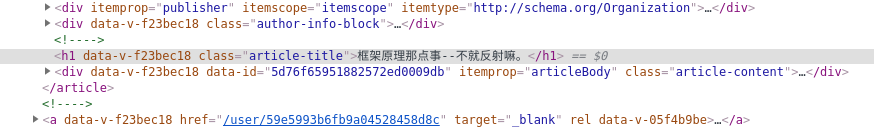

後面三種對應By裡面的制定方法。這裡就不說了。
操作js
WebElement webElement = webDriver.findElement(By.cssSelector("xxxxxx")); JavascriptExecutor js = (JavascriptExecutor) webDriver; js.executeScript("arguments[0].click();",digg);上面的webElement是頁面中一個按鈕。我們可以直接webElement.click()讓按鈕點擊或者webElement.submit()提交Form表單。但是有的時候會不起作用。這個時候用上面的程式碼可以進行點擊。
截圖
File source = ((TakesScreenshot) webDriver).getScreenshotAs(OutputType.FILE); try { Files.copy(source.toPath(), new FileOutputStream(new File("/root/Downloads/test/1.png"))); } catch (IOException e) { e.printStackTrace(); } try { TimeUnit.SECONDS.sleep(5); } catch (InterruptedException e) { e.printStackTrace(); } 我們內核操作因為正常不開瀏覽器介面,但是我們調試的時候又想知道結果,可以列印除當前窗口的圖片。就是上述的程式碼
切換窗口
Set<String> windowHandles = webDriver.getWindowHandles(); for (String windowHandle : windowHandles) { if (!windowHandle.equals(webDriver.getWindowHandle())) { //webDriver.switchTo().window(windowHandle); } } 在當前窗口切換訪問地址
webDriver.navigate().to("https://juejin.im/post/5d76f6585188254cc27b2af4"); webDriver.get("https://juejin.im/post/5d76f6585188254cc27b2af4"); 管理cookie
webDriver.get("https://juejin.im/timeline"); webDriver.manage().addCookie(cookie); webDriver.get("https://juejin.im/post/5d76f6585188254cc27b2af4");這裡值得注意的是,在添加cookie之前我們需要先訪問主頁,告訴內核我們後面添加的cookie是給那個Host下添加的。這樣我們添加的cookie才會有效。如上我們在juejin.im這個Host下都添加了Cookie。
個人網站(https://zxhtom.oschina.io)
個人微信(zxh870775401)
微信公眾號 : 新華前後端開發
# 加入戰隊
微信公眾號
# 加入戰隊
微信公眾號