一、Redis 總結
- 2020 年 6 月 1 日
- 筆記
Redis 介紹
Redis 是一個開源的、支援網路、可基於記憶體亦可持久化的日誌型、Key-Value 資料庫,並提供多種語言的 API。
Redis 是一個 key-value 存儲系統。為了保證效率,數據都是快取在記憶體中。Redis 會周期性的把更新的數據寫入磁碟或者把修改操作寫入追加的記錄文件,並且在此基礎上實現了 master-slave (主從)同步。
Redis 從第3版本開始支援主從同步和分片(以前的版本需要自己實現,也就是說不是自帶的功能)。數據可以從主伺服器向任意位置的從伺服器上同步,從伺服器可以是關聯其他從伺服器的主伺服器。分片機制使 Redis 可以增加讀寫性能。由於完全實現了發布/訂閱機制,使得從資料庫在任何地方同步,可訂閱一個頻道並接收主伺服器完整的消息發布記錄。分片機制增加了數據的可擴展性,數據的同步增加了數據冗餘和容災。
Redis 的特點:1、記憶體快取 2、數據持久化 3、操作原子性 4、分散式支援
Redis為什麼這麼快
- 完全基於記憶體,絕大部分請求是純粹的記憶體操作,非常快速;
- 數據結構簡單,對數據操作也簡單,Redis 中的數據結構是專門進行設計的;
- 採用單執行緒,避免了不必要的上下文切換和競爭條件,也不存在多進程或者多執行緒導致的切換而消耗 CPU,不用去考慮各種鎖的問題,不存在加鎖釋放鎖操作,沒有因為可能出現死鎖而導致的性能消耗;
- 使用多路I/O復用模型,非阻塞 IO。只有單個執行緒,通過跟蹤每個I/O流的狀態,來管理多個I/O流;
-
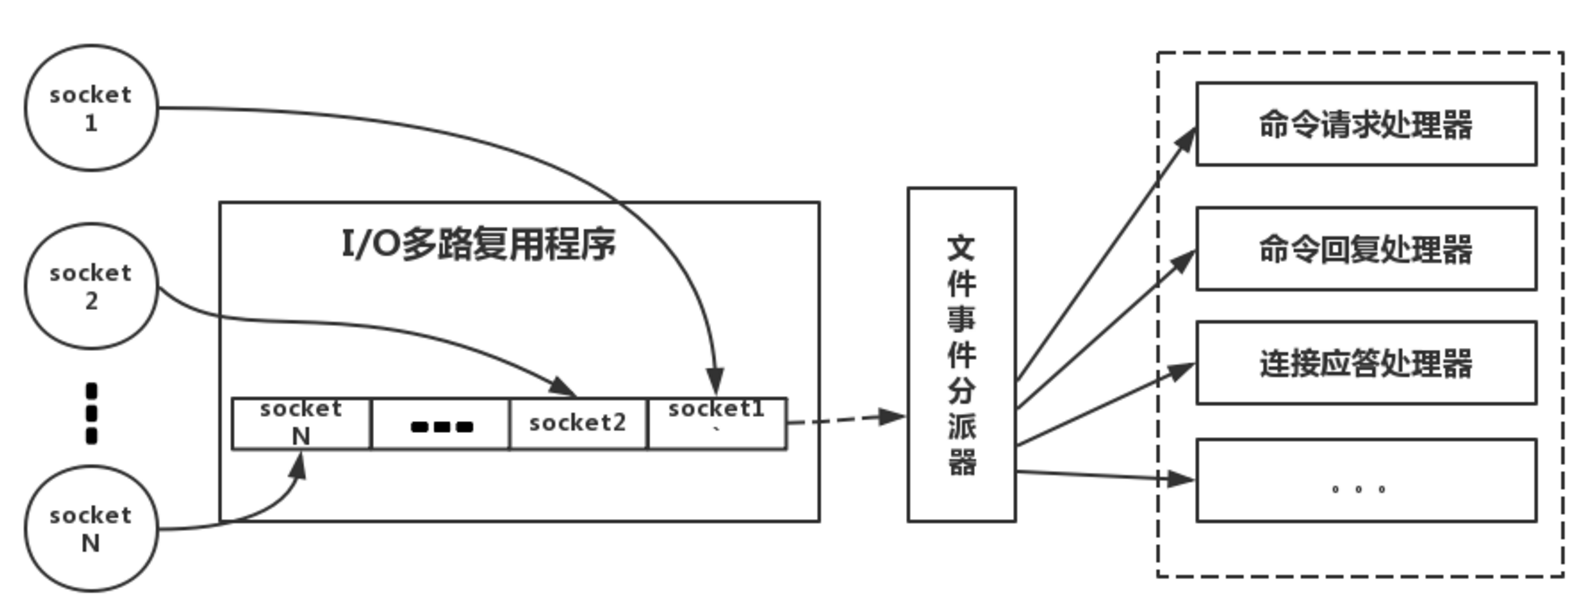
- 我們的 redis-client 在操作的時候,會產生具有不同事件類型的 socket。在服務端,有一段 I/0 多路復用程式,將其置入隊列之中。然後,文件事件分派器,依次去隊列中取,轉發到不同的事件處理器中。
-
Redis 的數據類型 & TTL
Redis 的數據類型
- String:常規的 set/get 操作。
- List:可以做簡單的消息隊列。
- set:一堆不重複值的集合,所以可以做全局去重的功能。
- zset:sorted set 多了一個權重參數 score,集合中的元素能夠按 score 進行排列。可以做排行榜應用,取 TOP N 操作。
- Hash。
Redis 設置過期時間
//把數據資訊寫入 redis
jedisClient.set("key", "value");
//設置 key 的過期時間 時間單位是秒
jedisClient.expire("key", 1800);
但這樣做可能會出現問題,比如多並發上面,設置值和過期時間用了兩步操作。可以將設置值和過期時間合併成一步操作,所以可以使用 redis 的設置值 set 的另外一個方法
// NX是不存在時才set, XX是存在時才set, EX是秒,PX是毫秒
jedisClient.set(key, value, "NX", "EX", expireSecond);
Redis 的過期策略以及記憶體淘汰機制
這個問題其實相當重要,比如 redis 只能存5G數據,可是寫了10G,那會刪5G的數據。數據已經設置了過期時間,但是時間到了,記憶體佔用率還是比較高,原因?
- Redis 採用的是定期刪除+惰性刪除策略。
- 為什麼不用定時刪除策略?
- 定時刪除,用一個定時器來負責監視 key,過期則自動刪除。雖然記憶體及時釋放,但是十分消耗 CPU 資源。在大並發請求下,CPU 要將時間應用在處理請求,而不是刪除 key,因此沒有採用這一策略.
- 定期刪除+惰性刪除是如何工作的呢?
- 定期刪除,redis 默認每個 100ms 檢查,是否有過期的 key,有過期 key 則刪除。
- 需要說明的是,redis 不是每個 100ms 將所有的 key 檢查一次,而是隨機抽取進行檢查(如果每隔 100ms,全部 key 進行檢查,redis 豈不是卡死)。
- 因此,如果只採用定期刪除策略,會導致很多key到時間沒有刪除。
- 於是,惰性刪除派上用場。也就是說在你獲取某個 key 的時候,redis 會檢查一下,這個 key 如果設置了過期時間那麼是否過期了?如果過期了此時就會刪除。
- 採用定期刪除+惰性刪除就沒其他問題了么?
- 不是的,如果定期刪除沒刪除 key。然後你也沒即時去請求 key,也就是說惰性刪除也沒生效。這樣,redis 的記憶體會越來越高。那麼就應該採用記憶體淘汰機制。
- 在 redis.conf 中有一行配置:# maxmemory-policy volatile-lru。該配置就是配記憶體淘汰策略的。
- noeviction:當記憶體不足以容納新寫入數據時,新寫入操作會報錯。
- allkeys-lru:當記憶體不足以容納新寫入數據時,在鍵空間中,移除最近最少使用的 key。推薦使用。
- allkeys-random:當記憶體不足以容納新寫入數據時,在鍵空間中,隨機移除某個 key。
- volatile-lru:當記憶體不足以容納新寫入數據時,在設置了過期時間的鍵空間中,移除最近最少使用的 key。
- volatile-random:當記憶體不足以容納新寫入數據時,在設置了過期時間的鍵空間中,隨機移除某個 key。
- volatile-ttl:當記憶體不足以容納新寫入數據時,在設置了過期時間的鍵空間中,有更早過期時間的 key 優先移除。
Redis 集群模式
-
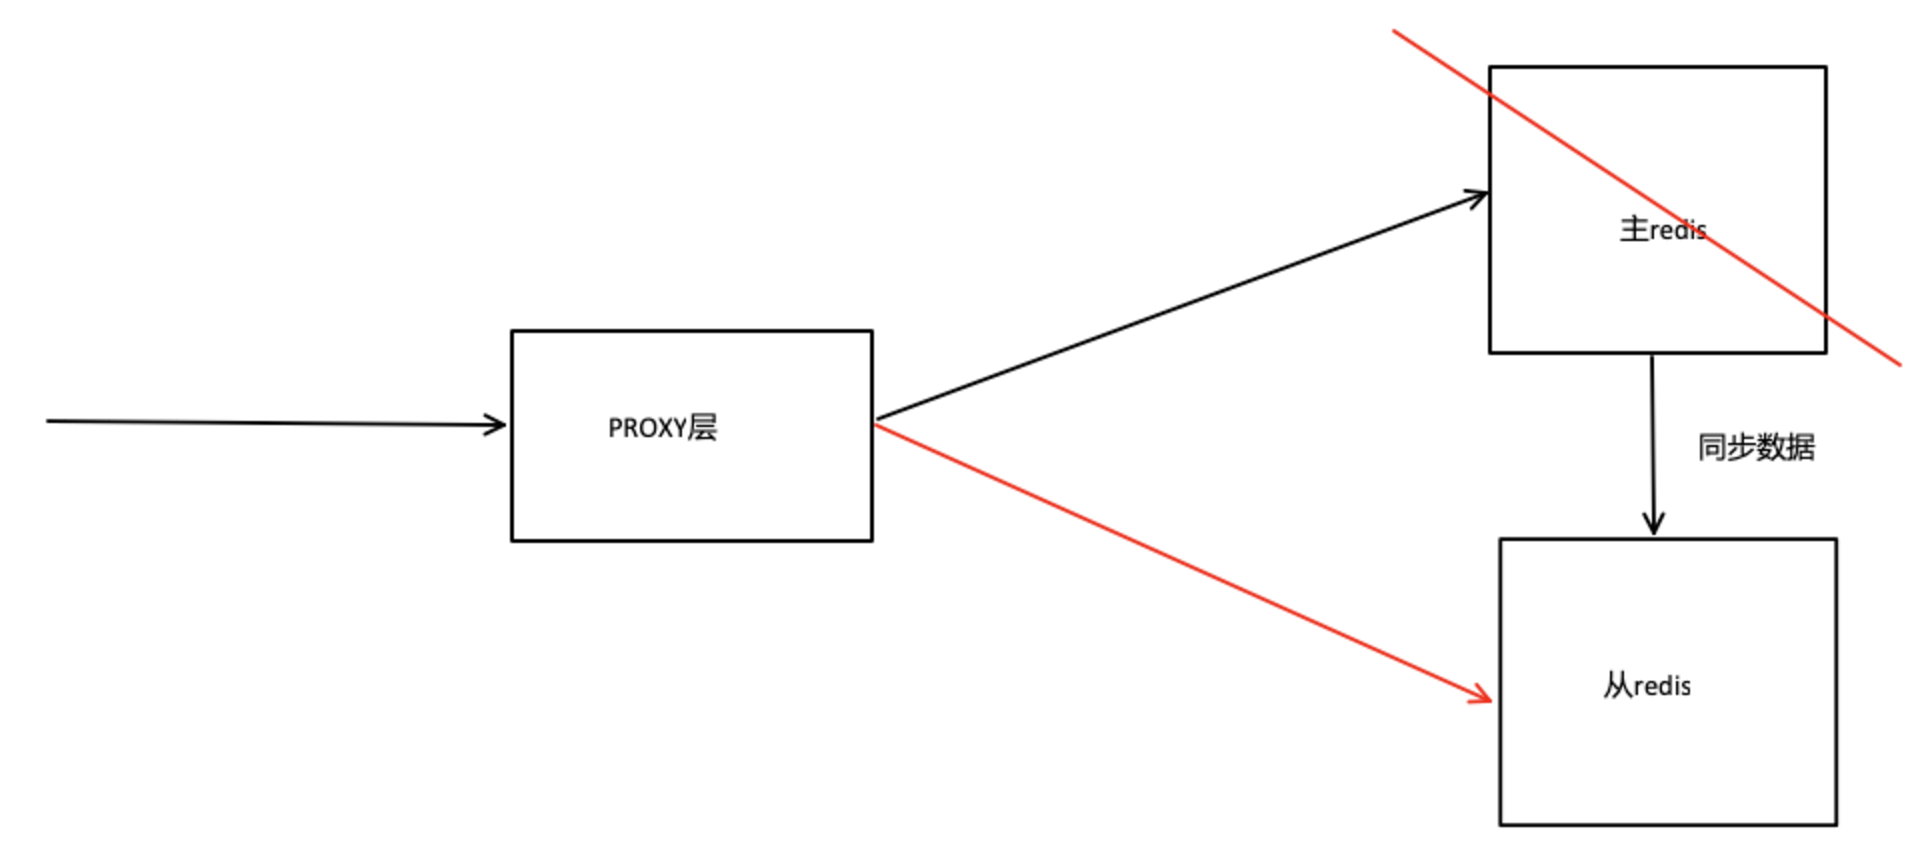
主從複製解決單點故障
-
-
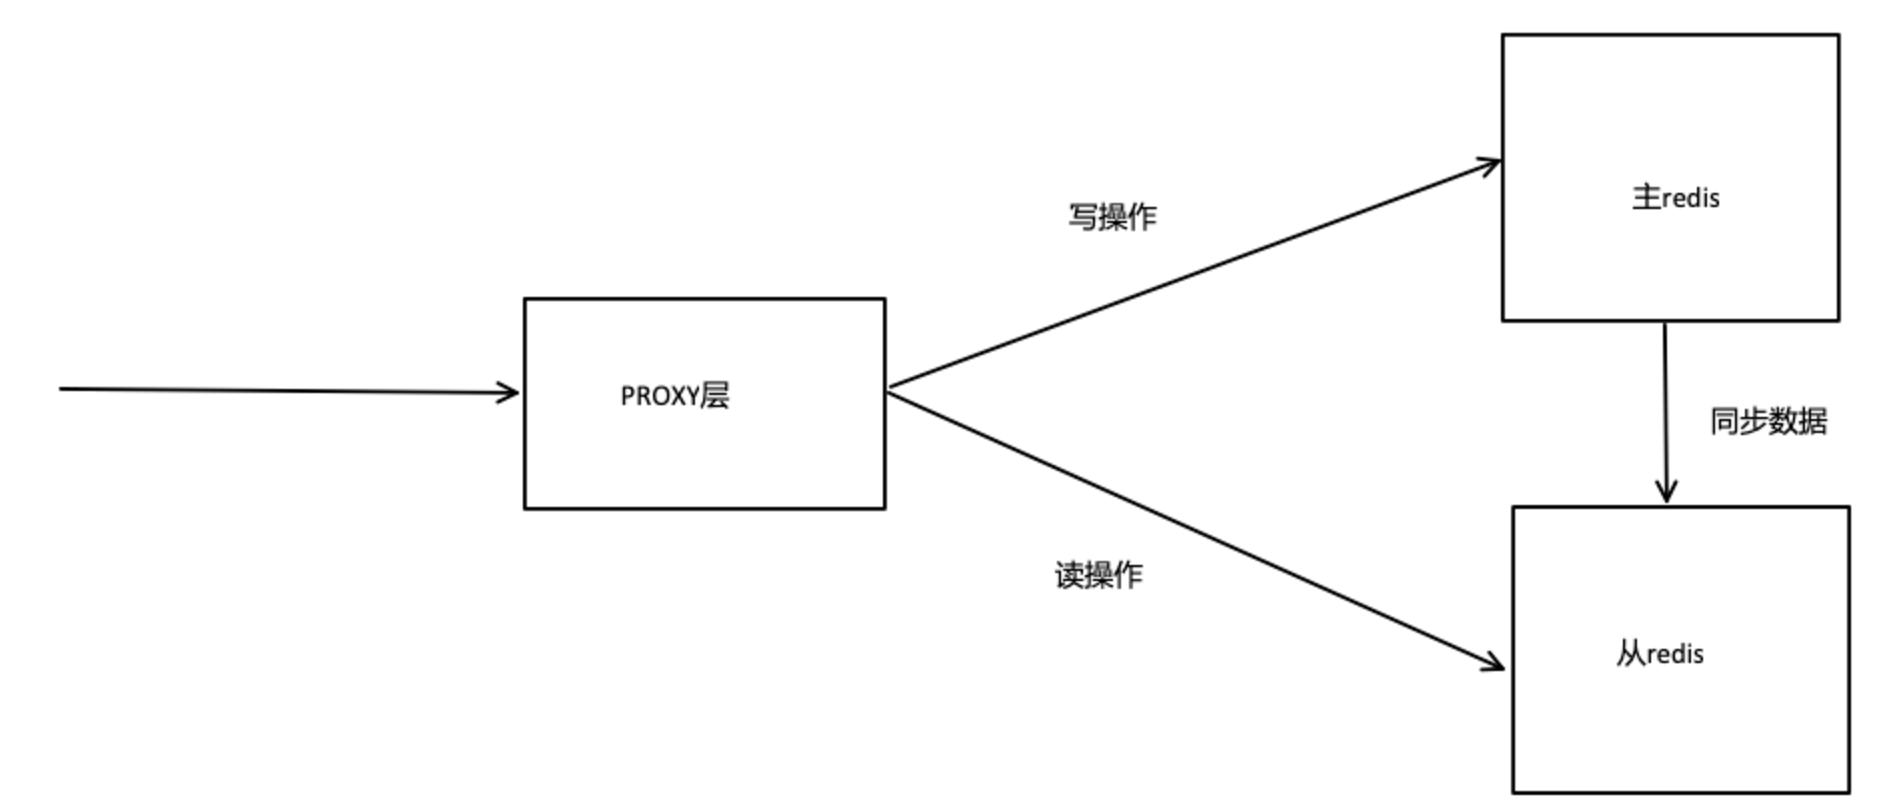
讀寫分離解決主節點壓力過大
-
-
主從複製雖然解決了性能問題,但是沒解決存儲數據量的問題,所以要使用 Redis 集群解決存儲數據量與性能問題。
-
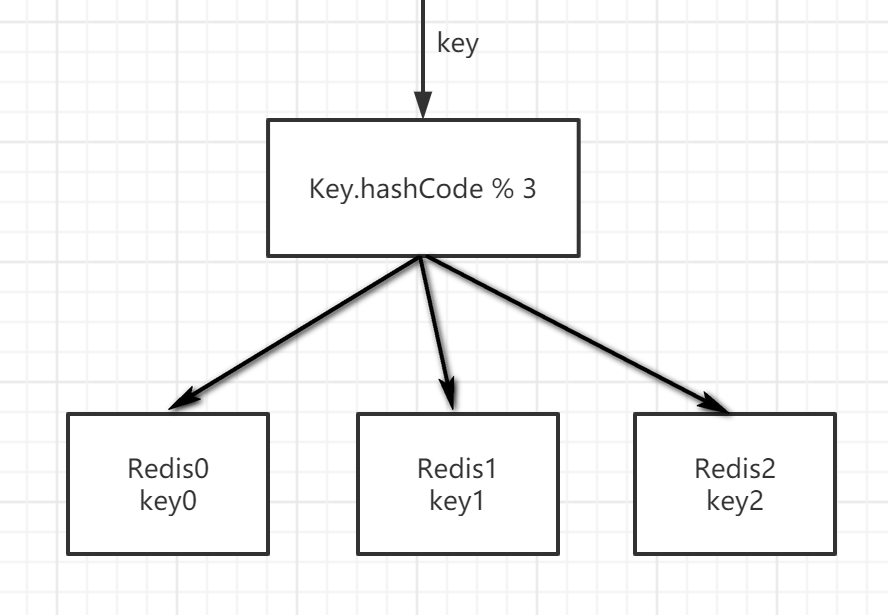
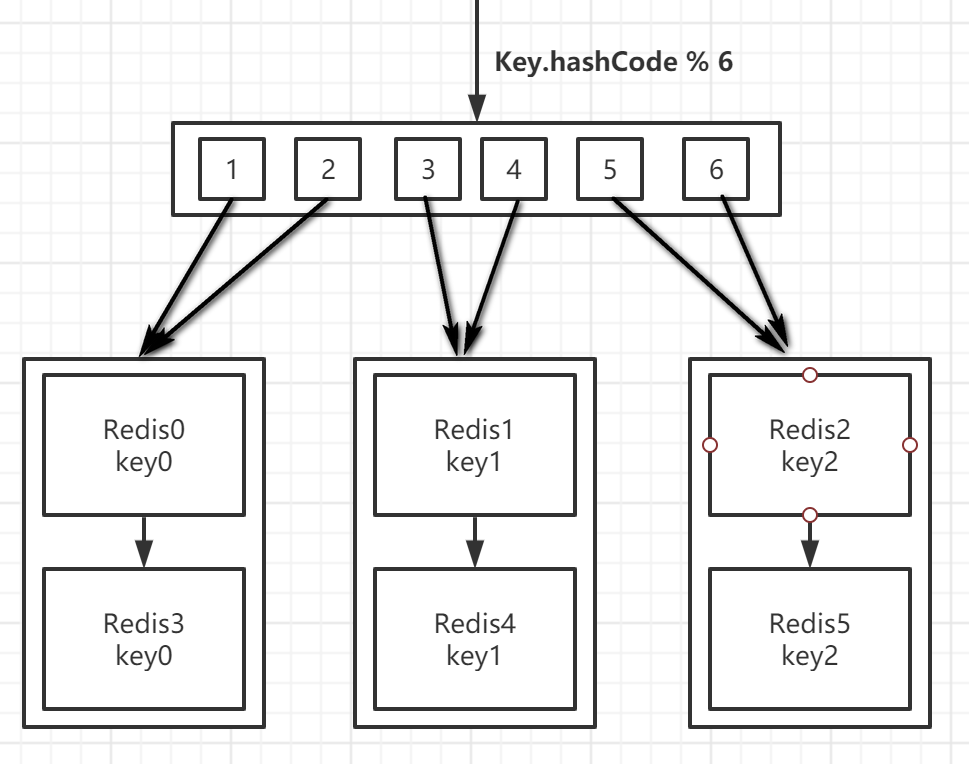
Redis 使用「一致性 hash」來解決怎麼存儲數據的問題。
-
-
這種 hash 演算法存在一定的缺陷:比如增加節點,進行擴容,那麼 key 的計算方式就是:key.hashCode % 3 => key.hashCode % 4。那麼查詢 key0 這個 key 的時候就有可能查不到。節點減少也會導致同樣的問題。
-
為了解決這個問題就引入了一致性 Hash,就是有數量不變的虛擬機,每個虛擬機都代理著集群的 1 到多個實體主機。
-
-
-
Redis 集群利用一致性hash的原理加分片機制(主從複製),解決了數據的海量存儲,單點壓力過大和數據可靠性的問題。