TensorFlow學習筆記——深層神經網路的整理
- 2019 年 10 月 3 日
- 筆記
維基百科對深度學習的精確定義為“一類通過多層非線性變換對高複雜性數據建模演算法的合集”。因為深層神經網路是實現“多層非線性變換”最常用的一種方法,所以在實際中可以認為深度學習就是深度神經網路的代名詞。從維基百科給出的定義可以看出,深度學習有兩個非常重要的特性——多層和非線性。那麼為什麼要強調這兩個性質呢?下面我們開始學習。
1,線性模型的局限性
在線性模型中,模型的輸出為輸入的加權和。假設一個模型的輸出 y 和輸入 xi 滿足以下關係,那麼這個模型就是一個線性模型:

其中,wi , b € R 為模型的參數。被稱之為線性模型是因為當模型的輸入只有一個的似乎, x 和 y 形成了二維坐標繫上的一條直線。類似的,當模型有 n 個輸入時, x 和 y 形成了 n+1 維空間中的一個平面。而當一個線性模型中通過輸入得到輸出的函數被稱之為一個線性變換。上面的公式就是一個線性變換。線性模型的最大特點就是任意線性模型的組合仍然還是線性模型。其實之前學的前向傳播演算法實現的就是一個線性模型。下面看一下前向傳播的計算公式為:
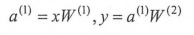
其中 x 為輸入,W為參數。整理一下上面的公式可以得到整個模型的輸出為:

根據矩陣乘法的結合律有:
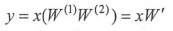
而W(1)W(2) 其實可以被表示為一個新的參數W':
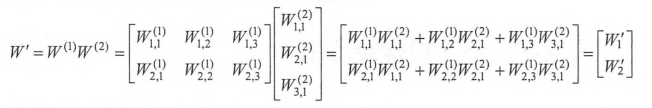
這樣輸入和輸出的關係就可以表示為:
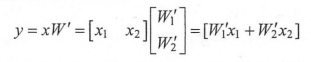
其中W' 為新的參數。這個前向傳播的演算法完全符合線性模型的定義。從這個例子可以看到,雖然這個神經網路有兩層(不算輸入層,只有隱藏層和輸出層),但是它和單層的神經網路並沒有區別。以此類推,只通過線性變換。任意層的全連接神經網路和單層神經網路模型的表達能力沒有任何區別,而且他們都是線性模型。而線性模型能夠解決的問題是有限的。這就是線性模型最大的局限性也就是為什麼深度學習要強調非線性。
下面通過TensorFlow遊樂場給出一個具體的例子來驗證線性模型的局限性。還是以判斷零件是否合格為例,輸入為 x1 和 x2 ,其中 x1 代表一個零件品質和平均品質的差, x2 代表一個零件長度和平均長度的差。假設一個零件的品質及長度離平均品質及長度越近,那麼這個零件就越有可能合格。於是訓練數據很有可能服從下圖所示的分布:
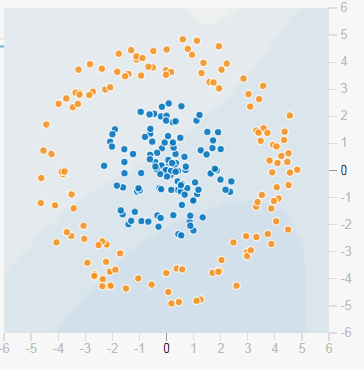
圖中藍色的點代表合格的零件,而橙色的點代表不合格的零件。可以看到雖然藍色和橙色的點有一些重合。但是大部分代表合格零件的黑色點都在原點(0, 0)的附近,而代表不合格的短都在離原點相對遠的地方。這樣的分布比較接近真實問題,因為大部分真實的問題都存在大致的趨勢,但是很難甚至無法完全正確的區分不同的類別。
下圖顯示了使用TensorFlow遊樂場訓練線性模型解決這個問題的效果:

上圖中使用的模型有一個隱藏層,並且在頂部激活函數(Activation)那一欄中選擇了線性(Linear),通過對這個模型訓練100輪之後,在最右邊那一欄可以看到整個訓練的結果。而且我們發現這個模型並不能很好的區分兩個不同的點。雖然平面的顏色比較淺,但是中間還是隱約有一條分界線,這說明這個模型只能通過直線來劃分平面。如果一個問題可以通過一條直線來劃分,那麼線性模型也是可以用來解決這個問題的。
下圖顯示了一個可以通過直線劃分的數據:
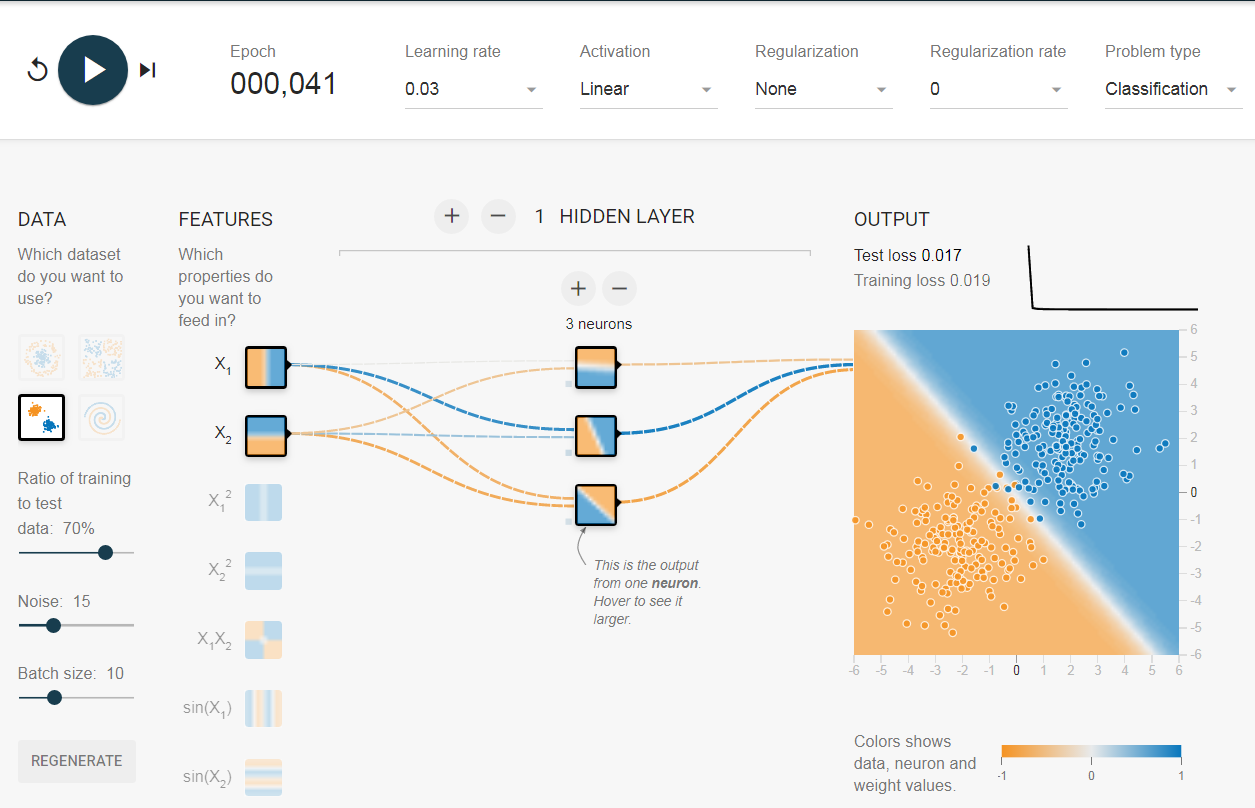
從上圖可以看出,在線性可分問題中,線性模型就能很好區分不同顏色的點。因為線性模型就能解決線性可分問題,所以在深度學習的定義中特意強調它的目的為解決更加複雜的問題。所謂複雜問題,至少是無法通過直線(或者高維空間的平面)劃分的。在線性世界中,絕大部分的問題都是無法線性劃分的。回到判斷零件是否合格的問題,如果將激活函數換成非線性的,那麼就可以得到下圖的結果(我們使用了ReLU激活函數):

我們發現,當加入非線性的元素之後,神經網路模型就可以很好地區分不同顏色的點了。
激活函數實現去線性化
如果將每一個神經元(也即是神經網路中的節點)的輸出通過一個非線性函數,那麼整個神經網路的模型也就不再是線性的了。這個非線性函數就是激活函數。下圖就是加了激活函數和偏置項之後的神經元結構:

下面給出了神經網路結構加上激活函數和偏置項之後的前向傳播演算法的數學定義:
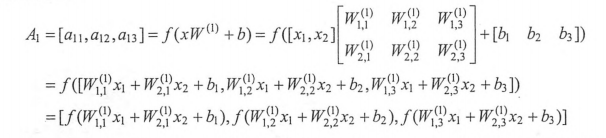
比起之前的線性模型,上面的定義主要有兩個改變。第一個改變是新的公式中增加了偏置項(bias),偏置項是神經網路中非常常用的一種結構。第二個改變就是每個節點的取值不再是單純的加權和。每個節點的輸出在加權和的基礎上還做了一個非線性變換。下圖顯示了幾種常用的非線性激活函數的函數影像:
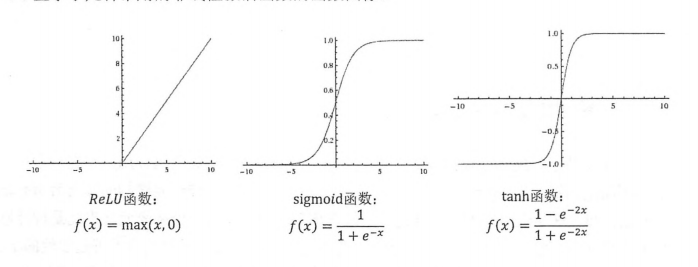
從上圖可以看出,這些激活函數的函數影像都不是一條直線。所以通過這些激活函數,每一個節點不再是線性變換,於是整個神經網路模型也就不再是線性的了。下圖給出了加入偏置項和ReLU激活函數之後,神經網路的結構:
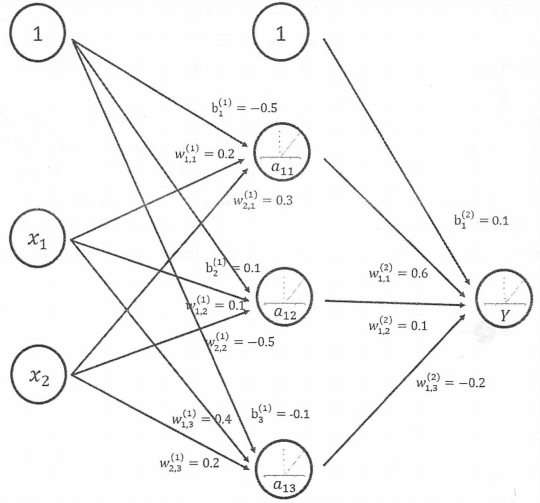
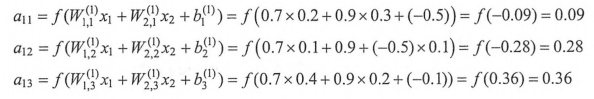
從圖中可以看出,偏置項可以被表述為一個輸出永遠為1的節點,下面的公式給出了這個新的神經網路模型前向傳播演算法的計算方式。
隱藏層推導公式:
輸出層推導公式:
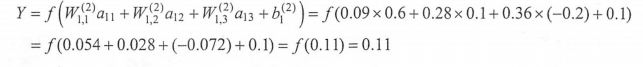
目前TensorFlow提供7種不同的非線性激活函數,tf.nn.relu,tf.simoid,tf.tanh 是其中比較常用的幾個。當然,TensorFlow也支援使用自己定義的激活函數。以下程式碼展示了如何通過TensorFlow實現上圖中神經網路的前向傳播演算法:
# 線性定義定義神經網路前向傳播的過程 a = tf.matmul(x, w1) y = tf.matmul(a, w2) # 自己定義的激活函數定義神經網路前向傳播的過程 a = tf.nn.relu(tf.matmul(x, w1) + biases1) y = tf.nn.relu(tf.matmul(a, w2) + biases2)
從上面程式碼可以看出,TensorFlow可以很好的支援使用了激活函數和偏置項的神經網路。
多層網路解決異或運算
下面我們將通過一個實際問題來學習深度學習的另外一個重要性質——多層變換。
在神經網路的發展史上,一個很重要的問題就是異或問題。神經網路的理論模型由Warren McCulloch 和 Walter Pitts 在1943年首次提出,並在1958年由Frank Rosenblatt提出了感知機(perceptron)模型,從數學上完成了對神經網路的精確建模。感知機可以理解為單層的神經網路。
感知機會先將輸入進行加權和,然後通過激活函數最後得到輸出。這個結構就是一個額每一隱藏層的神經網路。在上個世紀六十年代,神經網路作為對人類大腦的模擬演算法受到了很多關注。然而到了1969年,Marvin Minsky 和 Seymour Papert 在Perceptrons: An Introduction to Computational Geometry 一書中提出感知機是無法模擬異或運算的。這裡通過TensorFlow遊樂場來模擬一下通過感知機的網路結構來模擬異或運算。下圖為通過TensorFlow遊樂場訓練500輪之後的情況。

上圖使用了一個能夠模擬異或運算的數據集。異或運算直觀來說就是如果兩個輸入的符號相等時(同時為正或者同時為負)則輸出為0,否則(一個正一個負)輸出為1.從圖中可以看出,左下角(兩個輸入同時為負)和右上角(兩個輸入同時為正)的點為藍色。而另外兩個象限的點為灰色,這就符合異或運算的計算規則。上面將隱藏層的層數設置為0,這樣就模擬了感知機的模型。通過500輪訓練之後,可以看到這個感知機模型並不能將兩種顏色的點區分開,也就是說感知器無法模擬異或運算的功能。
當加入隱藏層之後,異或問題就可以得到很好地解決。下圖顯示了一個有四個節點的隱藏層的神經網路在訓練500輪之後的效果。在圖中我們除了可以看到最右邊的輸出節點可以很好地區分不同顏色的點外,更加有意思的是,隱藏層的四個節點中,每個節點都有一個角是黑色的。這四個隱藏點可以被認為代表了從輸入特徵中抽取的更高維的特徵。比如第一個節點可以大致代表兩個輸入的邏輯與操作的結果(當兩個輸入都為正數時該節點輸出為正數)。

經典損失函數定義
分類問題和回歸問題是監督學習的兩大種類。分類問題希望解決的是將不同的樣本分到事先定義好的類別中。比如前面說的判斷一個零件是否合格的問題就是一個二分類問題。在這個問題中,需要將樣本(也就是零件)分到合格或是不合格兩個類別中。
在解決判斷零件是否合格的二分類問題時,我們會定義過一個單個輸出節點的神經網路。當這個節點的輸出越接近0時,這個樣本越有可能是不合格的;反之如果輸出越接近1,則這個樣本越有可能是合格的。為了給出具體的分類結果,可以取0.5作為閾值。凡是輸出大於0.5的樣本都認為是合格的,小於0.5的則是不合格的。然而這樣的做法並不容易直接推廣到多分類的問題。雖然設置多個閾值在理論上是可能的,但是在解決實際問題的過程中一般不會這麼處理。
通過神經網路解決多分類問題最常用的方法是設置 n 個輸出節點,其中 n 為類別的個數。對於每一個樣例。神經網路可以得到一個 n 維數組作為輸出結果。數組中的每一個維度(也就是每一個輸出節點)對應一個類別。在理想情況下,如果一個樣本屬於類別 k ,那麼這個類別所對應的輸出節點的輸出值應該為1,而其他節點的輸出都為0,以識別數字1為例,神經網路模型的輸出結果越接近 [0, 1 , 0, 0 , 0, 0, 0, 0, 0, 0] 越好。那麼如何判斷一個輸出向量和期望的向量有多接近呢?交叉熵(cross entropy)是最常用的評判方法之一。交叉熵刻畫了兩個概率分布之間的距離,它是分類問題中使用比較廣的一種損失函數。
交叉熵是一個資訊理論中的概念,它原本是用來估算平均編碼長度的。那下面給定兩個概率分布 p 和 q ,通過 q 表示 p 的交叉熵為:

注意交叉熵刻畫的是兩個概率分布之間的距離,然而神經網路的輸出卻不一定是一個概率分布。概率分布刻畫了不同事件發生的概率。當事件總數是有限的情況下,概率分布函數 p(X=x) 滿足:

也就是說,任意事件發生的概率都在 0 和 1 之間,且總有某一個事件發生(概率的和為1)。如果將分類問題中“一個樣例屬於某一個類別” 看成一個概率事件,那麼訓練數據的正確答案就符合一個概率分布。因為事件“一個樣例屬於不正確的類別”的概率為 0 ,而“一個樣例屬於正確的類別” 的概率為 1。如何將神經網路前向傳播得到的結果也變成概率分布呢?Softmax回歸就是一個非常常用的方法。
Softmax 回歸本身可以作為一個學習演算法來優化分類結果,但是在TensorFlow中,Softmax回歸的參數被去掉了,它只是一層額外的處理層,將神經網路的輸出變成一個概率分布。下圖展示了加上softmax回歸的神經網路結構圖:

假設原始的神經網路輸出為 y1,y2,... yn,那麼經過Softmax回歸處理之後的輸出為:
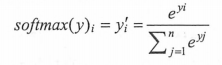
從上面的公式中可以看出,原始神經網路的輸出被用作置信度來生成新的輸出,而新的輸出滿足概率分布的所有要求。這個新的輸出可以理解為經過神經網路的推導,一個樣例為不同類別的概率分別是多大。這樣就把神經網路的輸出也變成了一個概率分布,從而可以通過交叉熵來計算預測的概率分布和真實答案的概率分布之間的距離。
從交叉熵的公式中可以看到交叉熵函數不是對稱的(H(p, q) != H(q, p)),它刻畫的是通過概率分布q 來表達概率分布 p 的困難程度。因為正確答案是希望得到的結果,所以當交叉熵作為神經網路的損失函數時,p代表的是正確答案, q 代表的是預測值。交叉熵刻畫的是兩個概率分布的距離,也就是說交叉熵值越小,兩個概率分布越接近。
下面將給出兩個具體樣例來直觀的說明通過交叉熵可以判斷預測答案和真實答案之間的距離。假設有一個三分類問題,某個樣例的正確答案是(1, 0, 0)。某模型經過Softmax回歸之後的預測答案是(0.5,0.4,0.1),那麼這個預測和正確答案之間的交叉熵為:
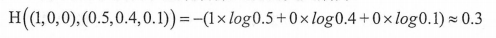
如果另外一個模型的預測時(0.8, 0.1, 0.1),那麼這個預測值和真實值之間的交叉熵是:
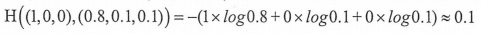
從直觀上可以很容易地知道第二個預測答案要優於第一個。通過交叉熵計算得到結果也是一致的(第二個交叉熵的值更小)。我們可以通過TensorFlow實現交叉熵程式碼:
# 定義損失函數來刻畫預測值與真實值的差距 cross_entropy = -tf.reduce_mean( y_ * tf.log(tf.clip_by_value(y, 1e-10, 1.0)) )
其中y_ 代表正確結果,y代表預測結果。
下面將具體的學習這個計算過程。這一行程式碼包含了四個不同的TensorFlow運算。通過 tf.clip_by_value 函數可以將一個張量中的數值限制在一個範圍之內,這樣就可以避免一些運算錯誤(比如 log0 是無效的)。下面給出了使用 tf.clip_by_value 的簡單樣例。
import tensorflow as tf v = tf.constant([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]]) print(v) ''' #這段程式碼之前如果沒有添加session,會報錯:Cannot evaluate tensor using `eval()`: No default session is registered print tf.clip_by_value(v, 2.5, 4.5).eval() 為避免報錯應該使用下面的方式: with tf.Session() as sess: print tf.clip_by_value(v, 2.5, 4.5).eval() ''' with tf.Session() as sess: print(tf.clip_by_value(v, 2.5, 4.5).eval()) ''' 結果: Tensor("Const:0", shape=(2, 3), dtype=float32) [[2.5 2.5 3. ] [4. 4.5 4.5]] ''' 從上面的結果可以看出,小於2.5 的數都被換成了2.5,而大於4.5的數都被換成了4.5。這樣通過 tf.clip_by_value 函數就可以保證在進行 log 運算時,不會出現 log0 這樣的錯誤或者大於1 的概率。第二個運算時 tf.log 函數,這個函數完成了對張量中所有元素依次求對數的功能。以下程式碼中給出的一個簡單的樣例。
v = tf.constant([[1.0, 2.0, 3.0]]) with tf.Session() as sess: print(tf.log(v).eval()) # 結果為: [[0. 0.6931472 1.0986123]]
第三個運算時乘法,在實現交叉熵的程式碼中直接將兩個矩陣通過“*”操作相乘。這個操作不是矩陣乘法,而是元素之間直接相乘。矩陣乘法需要使用 tf.matmul 函數來完成。下面給出了這兩個操作的區別:
v1 = tf.constant([[1.0, 2.0], [3.0, 4.0]]) v2 = tf.constant([[5.0, 6.0], [7.0, 8.0]]) with tf.Session() as sess: print((v1*v2).eval()) print(tf.matmul(v1, v2).eval()) ''' [[ 5. 12.] [21. 32.]] [[19. 22.] [43. 50.]] '''
v1 * v2 的結果是每個位置上對應元素的乘積。比如(1, 1)這個元素的值是:
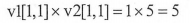
(1,2)這個元素的值是:
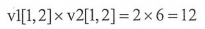
以此類推。而tf.matmul 函數完成的是矩陣乘法運算,所以(1, 1)這個元素的值是:
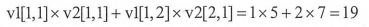
通過上面這三個運算完成了對每一個樣例中的每一個類別交叉熵 p(x)log q(x) 的計算。這三步計算得到的結果是一個 n*m 的二維矩陣,其中 n 為一個 batch 中樣例的數量,m 為分類的類別數量。根據交叉熵的公式,應該將每行中的 m 個結果相加得到所有樣例的交叉熵,然後再對這 n 行取
平均得到一個batch的平均交叉熵。但是因為分類問題的類別數量是不變的。所以可以直接對整個矩陣做平均而並不改變計算結果的意義。這樣的方式可以使整個程式更加簡潔。以下程式碼簡單展示了 tf.reduce_mean 函數的使用方法。
v = tf.constant([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]]) with tf.Session() as sess: print(tf.reduce_mean(v).eval()) # 3.5
因為交叉熵一般會與softmax回歸一起使用,所以TensorFlow對這兩個功能進行了統一封裝,並提供了 tf.nn.softmax_cross_entropy_with_logits 函數。比如可以直接通過下面的程式碼來實現使用 softmax 回歸之後的交叉熵損失函數:
cross_entropy = tf.nn.softmax_cross_entropy_with_logits(y, y_)
其中 y 代表了原始神經網路的輸出結果,而 y_ 給出了標準答案。這樣就通過一個命令就可以得到使用了Softmax回歸之後的交叉熵。在只有一個正確答案的分類問題中,TensorFlow提供了 tf.nn.sparse_softmax_cross_entropy_with_logited 函數來進一步加速計算過程。
與分類問題不同,回歸問題解決的是對具體數值的預測。比如房價預測,銷售預測等都是回歸問題。這些問題需要預測的不是一個事先定義好的類別,而是一個任意實數。解決回歸問題的神經網路一般只有一個輸出節點,這個節點的輸出值就是預測值。對於回歸問題,最常用的損失函數是均方誤差(MSE, mean squared error)。它的定義如下:
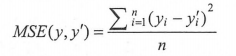
其中 yi 為一個batch的第 i 個數據的正確答案,而 y'i 為神經網路的預測值。以下程式碼展示了如何通過TensorFlow實現均方誤差損失函數:

其中 y 代表了神經網路的輸出答案,y_ 代表了標準答案。上面的減法運算 “-” 也是兩個矩陣中對應元素的減法。
自定義損失函數
Tensorflow不僅支援經典的損失函數,還可以優化任意的自定義損失函數。
下面以預測商品銷量問題為例。在預測商品銷售時,如果預測多了(預測值比真實銷量大),商家損失的是生產商品的成本;而如果預測少了(預測值比真實銷量少),損失的則是商品的利潤。因為一般商品的成本和商品的利潤不會嚴格相等,所以均方誤差損失函數就不能夠很好的最大化銷售利潤。比如一個商品的成本是1元,但是利潤是10元,那麼少預測一個就少掙10元,而多預測一個才少掙1元。如果神經網路模型最小化的是均方誤差,那麼很有可能此模型就無法最大化預測的利潤。為了最大化預測利潤,需要將損失函數和利潤直接聯繫起來。注意損失函數定義的是損失,所以要將利潤最大化,定義的損失函數應該刻畫成本或者代價。下面的公式給出了一個當預測多餘真實值和預測少於真實值時有不同損失係數的損失函數:
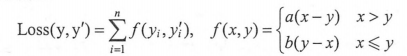
和均方誤差公式類似,yi是一個batch中第i個數據的正確答案, y'i 為神經網路得到的預測值,a 和 b 是常量。比如在上面介紹的銷售預測問題中 ,a就等於10(正確答案多於預測答案的代價),而b等於1(正確答案少於預測答案的代價)。通過對這個自定義損失函數的優化,模型提供的預測值更有可能最大化收益。在TensorFlow中,可以通過以下程式碼來實現這個損失函數:
loss = tf.reduce_sum(tf.where(tf.greater(v1, v2), ((v1 - v2) * a, (v2 - v1)* b )))
tf.greater:輸入時兩個張量,這個函數會比較兩個輸入張量中每一個元素的大小,然後返回一個bool類型的Tensor,如果兩個張量的維度不一致的話,會進行類似Numpy一樣的廣播操作。
tf.where:函數有三個參數,根據第一個條件是否成立,當為True的時候選擇第二個參數中的值,否則使用第三個參數中的值。
下面展示了兩個函數的用法:
import tensorflow as tf v1 = tf.constant([[1.0, 2.0, 3.0, 4.0]]) v2 = tf.constant([[4.0, 3.0, 2.0, 1.0]]) sess = tf.InteractiveSession() print(tf.greater(v1, v2).eval()) # [[False False True True]] print(tf.where(tf.greater(v1, v2), v1, v2).eval()) # [[4. 3. 3. 4.]] sess.close()
在定義了損失函數之後,我們可以通過一個簡單的神經網路程式來講解損失函數對模型訓練結果的影響。在下面這個程式中,實現了一個擁有兩個輸入節點,一個輸出節點,沒有隱藏層的神經網路。
# _*_coding:utf-8_*_ import tensorflow as tf from numpy.random import RandomState batch_size = 8 # 兩個輸入節點 x = tf.placeholder(tf.float32, shape=(None, 2), name='x-input') # 回歸問題一般只有一個輸出節點 y_ = tf.placeholder(tf.float32, shape=(None, 1), name='y-input') # 定義了一個單層的神經網路前向傳播的過程,這裡就是簡單加權和 w1 = tf.Variable(tf.random_normal([2, 1], stddev=1, seed=1)) y = tf.matmul(x, w1) # 定義預測多了和預測少了的成本 loss_less = 10 loss_more = 1 loss = tf.reduce_sum(tf.where(tf.greater(y, y_), (y - y_) * loss_more, (y_ - y) * loss_less)) learning_rate = 0.001 train_step = tf.train.AdamOptimizer(learning_rate).minimize(loss) # 通過隨機數生成一個模擬數據集 rdm = RandomState(1) dataset_size = 128 X = rdm.rand(dataset_size, 2) # 設置回歸的正確值為兩個輸入的和加上一個隨機量,之所有要加上一個隨機量是為了加入不可預測的噪音 # 否則不同損失函數的意義就不大了,因為不同損失函數都會在能完全預測正確的時候最低 # 一般來說噪音為一個均值為0的小量,所有這裡噪音設置為 -0.05~0.05的隨機數 Y = [[x1 + x2 + rdm.rand() / 10.0 - 0.05] for (x1, x2) in X] # 訓練神經網路 with tf.Session() as sess: init_op = tf.global_variables_initializer() sess.run(init_op) STEPS = 5000 for i in range(STEPS): start = (i * batch_size) % dataset_size end = min(start + batch_size, dataset_size) sess.run(train_step, feed_dict={x:X[start:end], y_:Y[start:end]}) print(sess.run(w1)) ''' 最後一次的結果為: [[1.019347 ] [1.0428089]] ''' 我們可以看到最後得到的w1的值。也就是得到的預測函數是 x1+x2 ,這要比 1.02x1+1.04x2 大,因為在損失函數中指定預測少了的損失更大(loss_less > loss_more)。如果 將loss_less 的值調整為1,loss_more 的值調整為10,那麼w1 的值會[[0.9552581] [0.9813394]]。也就是說,在這樣的設置下,模型會更加偏向於預測少一點。而如果使用均方誤差作為損失函數,那麼w1則會是[[0.97437561] [1.0243336]]。使用這個損失函數會盡量讓預測值離標準答案更近,通過這個樣例可以感受到,對於相同的神經網路,不同的損失函數會對訓練得到的模型產生重要的影響。
神經網路優化演算法
下面將學習如何通過反向傳播演算法(backpropagation)和梯度下降演算法(gradient decent)調整神經網路中參數的取值。梯度下降演算法主要用於優化單個參數的取值,而反向傳播演算法給出了一個高效的方式在所有參數上使用梯度下降演算法,從而使神經網路模型在訓練數據上的損失函數儘可能小。反向傳播演算法是訓練神經網路的核心演算法,它可以根據定義好的損失函數優化神經網路中參數的取值,從而使得神經網路模型在訓練數據集上的損失函數達到一個較小值。神經網路模型中參數的優化過程直接決定了模型的品質,是使用神經網路時非常重要的一步。
下面主要學習神經網路優化過程的基本概念和主要思想。我們將學習一個具體的樣例來解釋使用梯度下降演算法優化參數取值的過程。
假設用 Θ 表示神經網路中的參數,J(Θ) 表示給定的參數取值下,訓練數據集上損失函數的大小,那麼整個優化過程可以抽象為尋找一個參數Θ,使得 J(Θ) 最小,因為目前沒有一個通用的方法可以對任意損失函數直接求解最佳的參數取值,所以在實踐中,梯度下降演算法是最常用的神經網路優化方法。梯度下降演算法會迭代式更新參數 Θ,不斷沿著梯度的反方向讓參數朝著總損失更小的方向更新,下圖展示了梯度下降演算法的原理:

上圖中 x 軸表示參數Θ 的取值, y 軸表示損失函數 J(Θ ) 的值,上圖的曲線表示了在參數Θ 取不同值的時候,對應損失函數 J(Θ ) 的大小。假設當前的參數和損失值對應圖中小圓點的位置,那麼梯度下降演算法會將參數向 x 軸左側移動,從而使得小圓點朝著箭頭的方向移動。
參數的梯度可以通過求偏導的方式計算,對於參數Θ,其梯度 ,有了梯度,還需要定義一個學習率 η (learning rate)來定義每次參數更新的幅度。從直觀上理解,可以認為學習率定義的就是每次參數移動的幅度。通過參數的梯度和學習率,參數更新的公式為:

下面給出了一個具體的例子來說明梯度下降演算法是如何工作的。假設要通過梯度下降演算法來優化參數 x ,使得損失函數 的值盡量小。梯度下降演算法的第一步需要隨機產生一個參數 x 的初始值,然後通過梯度和學習率來更新參數 x 的取值。在這個樣例中,參數 x 的梯度為
 ,那麼使用梯度下降演算法每次對參數 x 的更新公式為
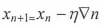 。假設參數的初始值為5,學習率為0.3,那麼這個優化過程 可以總結為下表:
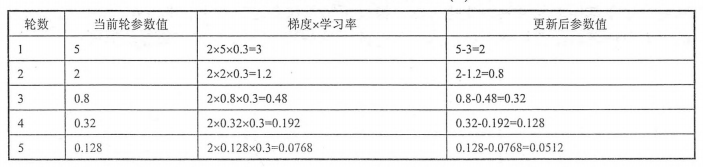
從上面可以看出,經過五次迭代之後,參數 x 的值變成0.0512,這個和參數最優值0 已經比較接近了。雖然這裡給出的是一個非常簡單的樣例,但是神經網路的優化過程也是可以類似的。神經網路的優化過程可以分為兩個階段,第一個階段先通過前向傳播演算法計算得到預測值,並將預測值和真實值做對比得出兩者之間的差距,然後在第二個階段通過反向傳播演算法計算損失函數對每一個參數的梯度,再根據梯度和學習率使用梯度下降演算法更新每一個參數。
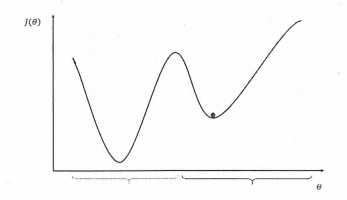
需要注意的是,梯度下降演算法並不能保證被優化的函數達到全局最優解。如下圖所示,圖中給出的函數就有可能只能得到局部最優解而不是全局最優解。在小黑點處,損失函數的偏導為0,於是參數就不會再進一步更新。在這個樣例中,如果參數 x 的初始值落在右側深色的區域中,那麼通過梯度下降得到的結果都會落在小黑點代表的局部最優解。只有當 x 的初始值落在左側淺色的區間時梯度下降才能給出全局最優答案。由此可見在訓練神經網路時,參數的初始值會很大程度影響最後得到的結果,只有當損失函數為凸函數時,梯度下降演算法才能保證達到全局最優解。
除了不一定能達到全局最優外,梯度下降演算法的另外一個問題就是計算時間太長。因為要在全部訓練數據上最小化損失,所以損失函數 J(Θ ) 是所有訓練數據上的損失和。這樣在每一輪迭代中都需要計算在全部訓練數據上的損失函數。在海量訓練數據下,要計算所有訓練數據的損失函數是非常耗時的。為了加速訓練過程,可以使用隨機梯度下降的演算法(stochastic gradient descent)。這個演算法優化的不是在全部訓練數據上的損失函數,而是在每一輪迭代中,隨機優化某一條訓練數據上的損失函數。這樣每一輪參數更新的速度就大大地加快了。因為隨機梯度下降演算法每次優化的只是某一條數據上的損失函數,所以他的問題也非常明顯:在某一條數據上損失函數更小並不代表在全部數據上損失函數更小,於是使用隨機梯度下降優化得到的神經網路甚至可能無法達到局部最優。
為了綜合梯度下降演算法和隨機梯度下降演算法的優缺點,在實際應用中一般採用這兩個演算法的折中——每次計算一小部分訓練數據的損失函數。這一小部分數據被稱之為一個batch。通過矩陣運算,每次在一個batch上優化神經網路的參數並不會比單個數據慢太多。另一方面,每次使用一個batch可以大大減少收斂所需要的迭代次數,同時可以使收斂到的結果更加接近梯度下降的效果。一下程式碼給出了在TensorFlow中如何實現神經網路的訓練過程:
import tensorflow as tf batch_size = n # 每次讀取一小部分數據作為當前的訓練數據來執行反向傳播演算法 x = tf.placeholder(tf.float32, shape=(batch_size, 2), name='x-input') y_ = tf.placeholder(tf.float32, shape=(batch_size, 1), name='y-input') # 定義神經網路結構和優化演算法 loss = ... learning_rate = 0.001 train_step = tf.train.AdamOptimizer(learning_rate).minimize(loss) # 訓練神經網路 with tf.Session() as sess: # 參數初始化 # 迭代的更新參數 for i in range(STEPS): # 準備batch_size 個訓練數據,一般講所有訓練書打亂再選取可以得到更好的優化效果 current_X, current_Y = ... sess.run(train_step, feed_dict={x:current_X, y_:current_Y})
神經網路的進一步優化
1,學習率的設置
之前學習訓練神經網路時,需要設置學習率(learning rate)控制參數更新的速度。下面將進一步學習如何設置學習率。學習率決定了參數每次更新的幅度。如果幅度過大,那麼可能導致參數在極優值的兩側來回移動。上面說的損失函數的樣例,如果在優化中使用的學習率為1,則整個優化過程將會如下(學習率過大,梯度下降演算法的運行過程):
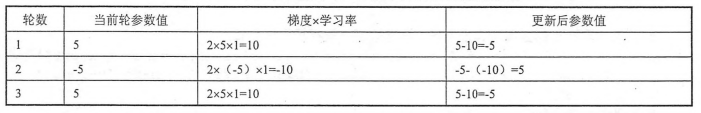
從上面的樣例來看,無論進行多少輪的迭代,參數將在5和-5之間搖擺,而不會收斂到一個極小值。相反,當學習率過小時,雖然能保證收斂性,但是這會大大降低優化速度。我們會需要更多輪的迭代才能達到一個比較理想的優化效果。比如當學習率為0.001時候,迭代5次之後,x的值將為4.95.要將 x 訓練到0.05 需要大約2300輪;而當學習率為0.3時,只需要5輪就可以達到,綜上所述,學習率既不能過大,也不能過小。
為了解決學習率的問題,TensorFlow提供了一種更加靈活地學習率設置方法——指數衰減法。tf.train.exponential_decay 函數實現了指數衰減學習率。通過這個函數,可以先使用較大的學習率來快速得到一個比較優的解,然後隨著迭代的繼續逐步減少學習率,使得模型在訓練後期更加穩定。exponential_decay 函數會指數級地減少學習率,它實現了一下程式碼的功能:
decayed_learning_rate = learning_rate * decay_rate ^(global_step / decay_steps)
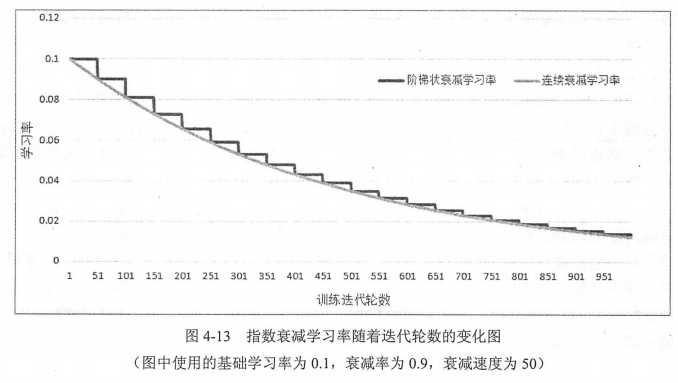
其中 decayed_learning_rate 為每一輪優化時使用的學習率,learning_rate 為事先設定的初始學習率,decay_rate 為衰減係數,decay_steps 為衰減速度。tf.train.exponential_decay 函數可以通過設置參數 staircase 選擇不同的衰減方式。staircase 的默認值為False,這是學習率隨迭代輪數變化的趨勢如下圖中灰色曲線所示。當staircase設置為True時, global_step/decay_steps 會被轉化成整數。這使得學習率稱為一個階梯函數(staircase funcation)。黑色曲線顯示了階梯狀的學習率。在這樣的設置下,decay_steps通常代表了完整的時域以便訓練數據所需要的迭代輪數。這個迭代輪數也就是總訓練樣本數除以每一個batch中訓練樣本數。這種設置的常用場景是每完整的過完一遍訓練數據,學習率就減少一次。這可以使得訓練數據集中的所有數據對模型訓練有相等的作用。當使用連續的指數衰減學習率時,不同的訓練數據有不同的學習率,而當學習率減少時,對應的訓練數據對模型訓練結果的影響也就小了。
下圖顯示了隨著迭代輪數的增加,學習率逐步降低的過程。
下面給出一段程式碼示範如何在TensorFlow中使用 tf.train.exponential_decay 函數:
global_step = tf.Variable(0) # 通過 exponential_decay 函數生成學習率 learning_rate = tf.train.exponential_decay( 0.1, global_step, 100, 0.96, staircase=True ) # 使用指數衰減的學習率,在minimize函數中傳入 global_step將自定更新global_step參數 # 從而使得學習率也得到相應更新 learning_step = tf.train.GradientDescentOptimizer(learning_rate).minimize( ...my loss..., global_step=global_step )
2,過擬合問題
上面學習了如何在訓練數據上優化一個給定的損失函數。然而在真實地應用中想要的並不是讓模型盡量模擬訓練數據的行為,而是希望通過訓練出來的模型對未知的數據給出判斷。模型在訓練數據上的表現並不一定代表了它在未知數據上的表現。而過擬合問題就是可以導致這個差距的一個很重要的因素。所謂過擬合,指的是當一個模型過為複雜之後,它可以很好的“記憶”每一個訓練數據中隨機噪音的部分而忘記了要去“學習”訓練數據中通用的趨勢。舉一個極端的例子,如果一個模型中的參數比訓練數據的總數還多,那麼只要訓練數據不衝突,這個模型完全可以記住所有訓練數據的結果從而使得損失函數為0,可以直觀的想像一個包含 n 個變數和 n 個等式的方程組,當方程不衝突時,這個方程組是可以通過數學的方式來求解的。然而,過度擬合訓練數據中的隨機噪音雖然可以得到非常小的損失函數,但是對於未知的數據可能無法做出可靠的判斷。
下圖顯示了模型訓練的三種不同情況。在第一種情況下,由於模型過於簡單,無法刻畫問題的趨勢。第二個模型比價合理,它既不會過於關注訓練數據中的噪音,又能夠比較好地刻畫問題的整體趨勢。第三個模型就是過擬合了,雖然第三個模型完美的劃分了不同形狀的點,但是這樣的劃分不能很好地對未知數據做出判斷,因為它過度擬合了訓練數據中的噪音而忽視了問題的整體規律。比如圖中淺色方塊更有可能和X數據同一類,而不是根據圖上的劃分和“ O ” 屬於同一類。

為了避免過擬合問題,一個非常常用的方法是正則化(regularization)。正則化的思想就是在損失函數中加入刻畫模型複雜程度的指標。假設用於刻畫模型在訓練數據上表現的損失函數為 J(Θ),那麼在優化時不是直接優化J(Θ),而是優化 J(Θ) +λR(w) 。其中R(w) 是刻畫模型的複雜程度,而 λ 表示模型複雜損失在總損失中的比例。注意 Θ 表示的是一個神經網路中所有的參數,它包含邊上的權重 w 和偏置項 b 。一般來說模型複雜度只由權重 w 決定。常用的刻畫模型複雜度的函數 R(w) 有兩種,
一種是L1正則化,指權值向量中各個元素的絕對值之和,計算公式是:
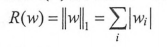
另一種是L2正則化,指權值向量中各個元素的平方和然後再求平方根,計算公式是:

無論是哪一種正則化方式,基本的思想都是希望通過限制權重的大小,使得模型不能任意擬合訓練數據中的隨機噪音。但是這兩種正則化的方法也有很大的區別。首先,L1正則化會讓參數變得更稀疏,而L2正則化不會。所謂參數變得更稀疏是指會有更多的參數變為0,這樣可以達到類似特徵選取的功能。之所以L2正則化不會讓參數變得更稀疏的原因是當參數很小時,比如0.001,這個參數的平方基本上就可以忽略了。於是模型不會進一步將這個參數調整為0。其次,L1正則化的計算公式不可導,而L2 正則化公式可導。因為在優化時需要計算損失函數的偏導數,所以對含有L2正則化損失函數的優化要更加簡潔。優化帶L1正則化的損失函數要更加複雜,而且優化方法也有很多種。在實踐中,也可以將L1正則化和L2正則化同時使用:
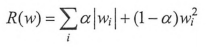
我們知道,TensorFlow可以優化任意形式的損失函數,所以TensorFlow自然也可以優化帶正則化的損失函數,一下程式碼給出了一個簡單的帶L2正則化的損失函數定義:
w = tf.Variable(tf.random_normal([2, 1], stddev=1, seed=1)) y = tf.matmul(x, w) loss = tf.reduce_mean(tf.square(y_-y)) + tf.contrib.layers.l2_regualarizer(lambda )(w)
在上面的程式中,loss為定義的損失函數,它是由兩個部分組成。第一個部分為均方誤差損失函數,它刻畫了模型在訓練數據上的表現。第二個部分就是正則化,它防止模型過度擬合訓練數據中的隨機噪音。lambda參數表示了正則化項的權重,也就是公式 J(Θ) +λR(w) 中的 λ 。w為需要計算正則化損失的參數。TensorFlow提供了 tf.contrib.layers.l2_regularizer 函數,它可以返回一個函數,這個函數可以計算一個給定參數的L2正則化項的值。類似的,tf.contrib.layers.l1_regularizer 可以計算L1正則化項的值,以下程式碼給出了使用這兩個函數的樣例:
weights =tf.constant([[1.0, -2.0], [-3.0, 4.0]]) with tf.Session() as sess: # 輸出為(|1| + |-2| + |-3| + |4|)*0.5 = 5 其中0.5為正則化項的權重 print(sess.run(tf.contrib.layers.l1_regularizer(0.5)(weights))) #5 # 輸出為(|1|**2 + |-2|**2 + |-3|**2 + |4|**2)/2*0.5 = 7.5 其中0.5為正則化項的權重 print(sess.run(tf.contrib.layers.l2_regularizer(0.5)(weights))) #7.5
在簡單的神經網路中,這樣的方式就可以很好地計算帶正則化的損失函數了。但是當神經網路的參數增多之後,這樣的方式首先可能導致損失函數loss的定義很長,可讀性差且容易出錯。但更主要的是,當網路結構複雜之後定義網路結構的部分和計算損失函數的部分可能不在同一個函數中,這樣通過變數這種方式計算損失函數就不方便了。為了解決這個問題,可以使用TensorFlow中提供的集合(collection)。集合可以在一個計算圖(tf.Graph)中保存一組實體(比如張量)。以下程式碼給出了通過集合計算一個5層神經網路帶L2正則化的損失函數的計算方法:
#_*_coding:utf-8_*_ import tensorflow as tf def get_weight(shape, weights): ''' 獲取一層神經網路邊上的權重,並將這個權重的L2正則化損失加入名稱為“losses”的集合中 :param shape: :return: ''' # 生成一個變數 var = tf.Variable(tf.random_normal(shape), dtype=tf.float32) # add_to_collection 函數將這個新生成變數的L2正則化損失項加入集合 # 這個函數的第一個參數:losses 是集合的名稱,第二個參數是要加入這個集合的內容 tf.add_to_collection( 'losses', tf.contrib.layers.l2_regularizer(weights)(var) ) # 返回生成的變數 return var x = tf.placeholder(tf.float32, shape=(None, 2)) y_ = tf.placeholder(tf.float32, shape=(None, 1)) batch_size = 8 # 定義了每一層網路中節點的個數 layer_dimension = [2, 10, 10, 10, 1] # 神經網路的層數 n_layers = len(layer_dimension) # 這個變數維護前向傳播時最深層的節點,開始的時候就是輸入層 cur_layer = x # 當前層的節點個數 in_dimension = layer_dimension[0] # 通過一個循環來生成5層全連接的神經網路結構 for i in range(1, n_layers): # layer_dimension[i] 為下一層的節點個數 out_dimension = layer_dimension[i] # 生成當前層中權重的變數,並將這個變數的L2正則化損失加入計算圖上的集合 weight = get_weight([in_dimension, out_dimension], 0.001) bias = tf.Variable(tf.constant(0.1, shape=[out_dimension])) # 使用ReLU 激活函數 cur_layer = tf.nn.relu(tf.matmul(cur_layer, weight) + bias) # 進入下一層之前將下一層的節點個數更新為當前層節點個數 in_dimension = layer_dimension[i] # 在定義神經網路前向傳播的同時已經將所有的L2正則化損失加入了圖上的集合 # 這裡只需要計算刻畫模型在訓練數據上的表現的損失函數 mse_loss = tf.reduce_mean(tf.square(y_ - cur_layer)) # 將均方誤差損失函數加入損失集合 tf.add_to_collection('losses', mse_loss) # get_collection 返回一個列表,這個列表是所有這個集合中的元素 # 在這個樣例中,這些元素就是損失函數的不同部分,將他們加起來就可以得到最終的損失函數 loss = tf.add_n(tf.get_collection('losses')) TensorFlow會將L2的正則化損失值除以2使得求導得到的結果更加簡潔。
從上面的程式碼可以看出通過使用集合的方法在網路結構比較複雜的情況下可以使用程式碼的可讀性更高。上面的程式碼給出的是一個只有5層的全連接層,在更加複雜的網路結構中,使用這樣的方法來計算損失函數將大大增強程式碼的可讀性。
3,滑動平均模型
這裡學習另外一個可以使模型在測試數據上更加健壯(robust)的方法——滑動平均模型。在採用隨機梯度下降演算法訓練神經網路時,使用滑動平均模型在很多應用中都可以在一定程度提高最終再測試數據上的表現。
在TensorFlow中提供了 tf.train.ExponentialMovingAverage 來實現滑動平均模型。在初始化ExponentialMovingAverage 時,需要提供一個衰減率(decay)。這個衰減率將用於控制模型更新的速度。ExponentialMovingAverage 對每一個變數會維度一個影子變數(shadow variable)。這個影子變數的初始值就是相應的初始值,而每次運行變數更新時,影子變數會更新為:

其中 shadow_variable 為影子變數。variable為待更新的變數,decay為衰減率。從公式中可以看到。decay決定了模型更新的速度,decay越大模型越趨於穩定。在實際應用中,decay一般會設成非常接近1的數(比如0.999或者0.9999)。為了使得模型在訓練前期可以更新的更快。ExponentialMovingAverage 還提供了 num_updates 參數來動態設置 decay的大小。如果在ExponentialMovingAverage 初始化時提供了 num_updates 參數,那麼每次使用的衰減率將是:
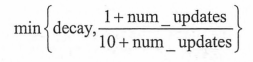
下面通過一段程式碼來解釋ExponentialMovingAverage 是如何被使用的:
#_*_coding:utf-8_*_ import tensorflow as tf # 定義一個變數用於計算滑動平均,這個變數的初始值為0 # 注意這裡手動指定了變數的類型為tf.float32 # 因為所有需要計算滑動平均的變數必須為實數型 v1 = tf.Variable(0, dtype=tf.float32) # 這裡step變數模擬神經網路中迭代的輪數,可以用於動態控制衰減率 step = tf.Variable(0, trainable=False) # 定義一個滑動平均的類(class)初始時給定了衰減率(0.99)和控制衰減率的變數step ema = tf.train.ExponentialMovingAverage(0.99, step) # 定義一個更新變數滑動平均的操作。這裡需要給定一個列表, # 每次執行的時候這個列表中的變數都會被更新 maintain_averages_op = ema.apply([v1]) with tf.Session() as sess: # 初始化所有變數 init_op = tf.global_variables_initializer() sess.run(init_op) # 通過ema.average(v1) 獲取滑動平均之後變數的取值 # 在初始化之後變數 v1 的值和 v1 的滑動平均都為0 print(sess.run([v1, ema.average(v1)])) # 輸出結果為 [0.0, 0.0] # 更新變數 v1 的值到5 sess.run(tf.assign(v1, 5)) # 更新 v1 的滑動平均值衰減率為 min{0.99, (1+step)/(10+step)=0.1}=0.1 # 所以 v1 的滑動平均會被更新為0.1*0 + 0.9*5 = 4.5 sess.run(maintain_averages_op) print(sess.run([v1, ema.average(v1)])) # 輸出結果為 [5.0, 4.5] # 更新step的值為10000 sess.run(tf.assign(v1, 10)) # 更新v1的平均滑動值,衰減率為 min{0.99, (1+step)/(10+step)=0.999}=0.99 # 所以 v1 的滑動平均會被更新為0.99*4.5 + 0.01*10= 4.555 sess.run(maintain_averages_op) print(sess.run([v1, ema.average(v1)])) # 輸出結果為 [10.0, 4.5554998] # 再次更新滑動平均值,得到的新滑動平均值為0.99*4.555+0.01*10=4.60945 sess.run(maintain_averages_op) print(sess.run([v1, ema.average(v1)])) # 輸出結果為 [10.0, 4.6094499] 這一篇文章主要學習了使用神經網路模型時需要考慮的主要問題。從神經網路模型結構的設計,損失函數的設計,神經網路的優化和神經網路進一步調優四個方面覆蓋了設計和優化神經網路過程中可能遇到的主要問題。
此文是自己的學習筆記總結,學習於《TensorFlow深度學習框架》,俗話說,好記性不如爛筆頭,寫寫總是好的,所以若侵權,請聯繫我,謝謝。