容器生態圈之旅--第二章《容器》
- 2019 年 10 月 3 日
- 筆記
第二章 容器
重點先知:
1. 容器技術基礎原理
2. docker的基本用法
3. docker鏡像管理基礎
4. 容器網路
5. docker存儲卷
6. dockerfile詳解
7. docker倉庫
8. docker的系統資源限制及驗證
原文分享:http://note.youdao.com/noteshare?id=cfaaab1ea5ecc8472e31313ee2bf3d9f&sub=7395451B766449B180466AECA5834D8E
2.1 前言
依舊記得初次聽到容器這個詞是在2018年的8月份。
依舊記得那月發生了兩件改變我IT軌跡的事:1. 加入小馬哥的運維群(駿馬金龍:www.junmajinlong.com) 2. 買了馬哥的docker和kubernetes影片。
依舊記得那時候的自己完成了某孩的期末架構就自認為自己已經足夠強了。
那時候我大二剛結束。
白駒過隙,又是一年,2019年的8月份到了,我大三剛結束。
2019年的7月29號,我開始動筆寫下我對於容器這塊的總結性筆記。
我有寫過docker的系統性博文的:https://blog.csdn.net/zisefeizhu/article/category/7960629 自認為寫的蠻好的。
我對容器總結性的一句話概括:容器等於鏡像加進程,鏡像是應用程式及其依賴環境的封裝。
2.3 容器技術基礎
統稱來說,容器是一種工具,指的是可以裝下其它物品的工具,以方便人類歸納放置物品、存儲和異地運輸,具體來說比如人類使用的衣櫃、行李箱、背包等可以成為容器,但今天我們所說的容器是一種IT技術。
容器技術是虛擬化、雲計算、大數據之後的一門新興的並且是炙手可熱的新技術,容器技術提高了硬體資源利用率、方便了企業的業務快速橫向擴容、實現了業務宕機自愈功能,因此未來數年會是一個容器愈發流行的時代,這是一個對於IT行業來說非常有影響和價值的技術,而對於IT行業的從業者來說,熟練掌握容器技術無疑是一個很有前景的的行業工作機會。
知名的容器技術有:Docker(Docker的同名開源容器化引擎適用於大多數後續產品以及許多開源工具),CSDE(Docker公司擁有擴展Docker的所有權。CSDE支援在Windows伺服器上運行docker實例),Rkt(rkt的發音為“rocket”,它是由CoreOS開發的。rkt是Docker容器的主要競爭對手),Solaris Containers(Solaris容器架構比Docker更早出現。想必那些已經在Solaris上標準化的IT企業會繼續研究它),Microsoft容器(作為Linux的競爭對手,Microsoft Containers可以在非常特定的情況下支援Windows容器)。
這裡我將講的容器技術是docker,畢竟別的容器技術我都沒接觸過,招聘簡歷上也沒見過。
Docker是一個在2013年開源的應用程式並且是一個基於go語言編寫是一個開源的pass服務(Platform as a Service,平台即服務的縮寫),go語言是由google開發,docker公司最早叫dotCloud,後由於Docker開源後大受歡迎就將公司改名為 Docker Inc,總部位於美國加州的舊金山,Docker是基於linux 內核實現,Docker最早採用LXC技術(LinuX Container的簡寫,LXC是Linux 原生支援的容器技術,可以提供輕量級的虛擬化,可以說 docker 就是基於 LXC 發展起來的,提供 LXC 的高級封裝,發展標準的配置方法),源程式碼託管在 Github 上,而虛擬化技術KVM(Kernel-based Virtual Machine) 基於模組實現,Docker後改為自己研發並開源的runc技術運行容器。
Docker利用現有的Linux容器技術,以不用方式將其封裝及擴展(通過提供可移植的鏡像及友好的介面),來創建(負責創建與運行容器的docker引擎)及發布方案(用來發布容器的雲服務docker hub)。
Docker的基本組成:docker client 客戶端、docker daemon 守護進程、docker image 鏡像、docker container 容器、docker registry 倉庫、docker 主機。
Docker 相比虛擬機的交付速度更快,資源消耗更低,Docker 採用客戶端/服務端架構,使用遠程API來管理和創建Docker容器,其可以輕鬆的創建一個輕量級的、可移植的、自給自足的容器,docker 的三大理念是build(構建)、ship(運輸)、run(運行),Docker遵從aoache 2.0協議,並通過(namespace及cgroup等)來提供容器的資源隔離與安全保障等(安全和隔離可以使你可以同時在機器上運行多個容器),所以Docke容器在運行時不需要類似虛擬機(空運行的虛擬機佔用物理機6-8%性能)的額外資源開銷,因此可以大幅提高資源利用率,總而言之Docker是一種用了新穎方式實現的輕量級虛擬機.類似於VM但是在原理和應用上和VM的差別還是很大的,並且docker的專業叫法是應用容器(Application Container)。
IDC/IAAS/PAAS/SAAS 對比

2.3.1docker運行原理
構建 -- > 運輸 --> 運行
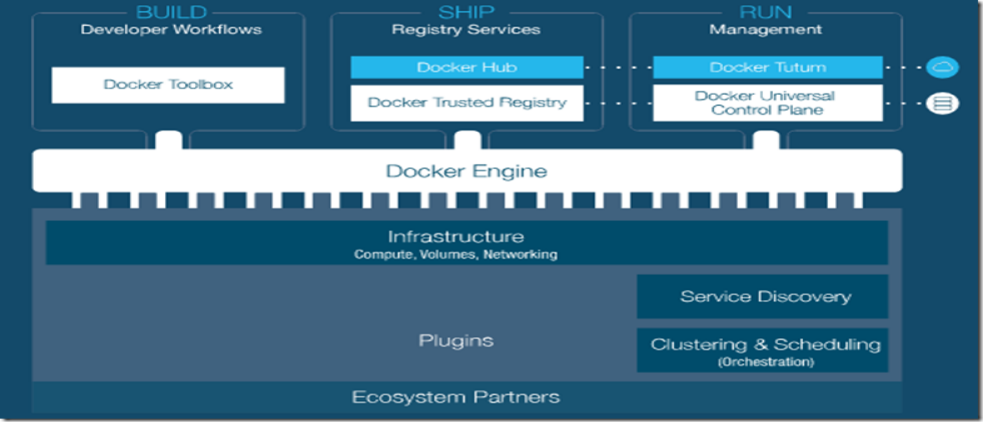
2.3.2 docker架構圖
總架構圖

主要模組:
DockerClient(與Daemon建立通訊,發起容器的管理請求)
DockerDaemon(接收Client請求,處理請求)
Docker Regisrty(鏡像管理)
Graph(存儲鏡像)
Drvier(鏡像管理驅動)
libcontainer(系統內核特性,提供完整、明確的介面給Daemon)
Docker Container
各模組功能及實現
Docker Client
Docker架構中用戶與Docker Daemon建立通訊的客戶端。
用戶可以使用可執行文件docker作為Docker Client,發起Docker容器的管理請求。
三種方式建立通訊:
tcp://host:port
unix://path_to_socket
fd://socketfd
Docker Client發送容器管理請求後,請求由Docker Daemon接收並處理,當Docker Client接收到返回的請求響應並做簡單處理後,Docker Client一次完整的生命周期就結束了。
Docker Daemon
常駐在後台的系統進程。
主要作用:
接收並處理Docker Client發送的請求
管理所有的Docker容器
Docker Daemon運行時,會在後台啟動一個Server,Server負責接收Docker Client發送的請求;接收請求後,Server通過路由與分發調度,找到相應的Handler來處理請求。
三部分組成:
A.Docker Server
專門服務於Docker Client,接收並調度分發Client請求。
Server通過包gorilla/mux創建mux。Router路由器,提供請求的路由功能,每一個路由項由HTTP請求方法(PUT、POST、GET、DELETE)、URL和Handler組成。
每一個Client請求,Server均會創建一個全新的goroutine來服務,在goroutine中,Server首先讀取請求內容,然後做請求解析工作,接著匹配相應的路由項,隨後調用相應的Handler來處理,最後Handler處理完請求後給Client回復響應。
B.Engine
核心模組,運行引擎。
存儲著大量容器資訊,管理著Docker大部分Job的執行。
handlers對象:
存儲眾多特定Job各自的處理方法handler。
例如:
{"create":daemon.ContainerCreate,}
當執行名為"create"的Job時,執行的是daemon.ContainerCreate這個handler。
C.Job
Engine內部最基本的執行單元,Daemon完成的每一項工作都體現為一個Job。
Docker Registry
存儲容器鏡像(Docker Image)的倉庫。
Docker Image是容器創建時用來初始化容器rootfs的文件系統內容。
主要作用:
搜索鏡像
下載鏡像
上傳鏡像
方式:
公有Registry
私有Registry
Graph
容器鏡像的保管者。
Driver
驅動模組,通過Driver驅動,Docker實現對Docker容器運行環境的訂製,訂製的維度包括網路、存儲、執行方式。
作用:
將與Docker容器有關的管理從Daemon的所有邏輯中區分開。
實現:
A.graphdriver
用於完成容器鏡像管理。
初始化前的四種文件系統或類文件系統的驅動在Daemon中註冊:
aufs、btrfs、devmapper用於容器鏡像的管理
vfs用於容器volume的管理
B.networkdriver
完成Docker容器網路環境的配置。
C.execdriver
執行驅動,負責創建容器運行時的命名空間,負責容器資源使用的統計與限制,負責容器內部進程的真正運行等。
Daemon啟動過程中載入ExecDriverflag參數在配置文件中默認設為native。
libcontainer
使用Go語言設計的庫,不依靠任何依賴,直接訪問內核中與容器相關的系統調用。
Docker Container
服務交付的最終體現。
用戶對Docker容器的配置:
通過指定容器鏡像,使得Docker容器可以自定義rootfs等文件系統;
通過指定物理資源的配額,使得Docker容器使用受限的資源;
通過配置容器網路及其安全策略,使得Docker容器擁有獨立且安全的網路環境;
通過指定容器的運行命令,使得Docker容器執行指定的任務;
2.3.3 docker架構
Docker使用C/S架構,Client 通過介面與Server進程通訊實現容器的構建,運行和發布。client和server可以運行在同一台集群,也可以通過跨主機實現遠程通訊。
Docker 客戶端會與Docker守護進程進行通訊。Docker 守護進程會處理複雜繁重的任務,例如建立、運行、發布你的 Docker 容器。
Docker 客戶端和守護進程可以運行在同一個系統上,當然也可以使用Docker客戶端去連接一個遠程的 Docker 守護進程。
Docker 客戶端和守護進程之間通過socket或者RESTful API進行通訊。

2.3.4 docker的組成
Docker 客戶端(Client):Docker 客戶端,實際上是 docker 的二進位程式,是主要的用戶與 Docker 交互方式。它接收用戶指令並且與背後的 Docker 守護進程通訊,如此來回往複。
Docker 服務端(Server):Docker守護進程,運行docker容器。Docker守護進程運行在一台主機上。用戶並不直接和守護進程進行交互,而是通過 Docker 客戶端間接和其通訊。
Docker 鏡像(Images):Docker 鏡像是Docker容器運行時的只讀模板,每一個鏡像由一系列的層 (layers) 組成。Docker 使用 UnionFS 來將這些層聯合到單獨的鏡像中。UnionFS 允許獨立文件系統中的文件和文件夾(稱之為分支)被透明覆蓋,形成一個單獨連貫的文件系統。正因為有了這些層的存在,Docker 是如此的輕量。當你改變了一個 Docker 鏡像,比如升級到某個程式到新的版本,一個新的層會被創建。因此,不用替換整個原先的鏡像或者重新建立(在使用虛擬機的時候你可能會這麼做),只是一個新 的層被添加或升級了。現在你不用重新發布整個鏡像,只需要升級,層使得分發 Docker 鏡像變得簡單和快速。
Docker 容器(Container): 容器是從鏡像生成對外提供服務的一個或一組服務。Docker 容器和文件夾很類似,一個Docker容器包含了所有的某個應用運行所需要的環境。每一個 Docker 容器都是從 Docker 鏡像創建的。Docker 容器可以運行、開始、停止、移動和刪除。每一個 Docker 容器都是獨立和安全的應用平台,Docker 容器是 Docker 的運行部分。
Docker 倉庫(Registry): 保存鏡像的倉庫,類似於git或svn這樣的版本控制系統,官方倉庫: https://hub.docker.com/ 。同樣的,Docker 倉庫也有公有和私有的概念。公有的 Docker 倉庫名字是 Docker Hub。Docker Hub 提供了龐大的鏡像集合供使用。這些鏡像可以是自己創建,或者在別人的鏡像基礎上創建。Docker 倉庫是 Docker 的分發部分。
Docker 主機(Host):一個物理機或虛擬機,用於運行Docker服務進程和容器。

2.3.5 docker對比虛擬機
資源利用率更高:一台物理機可以運行數百個容器,但是一般只能運行數十個虛擬機。
開銷更小:容器與主機的作業系統共享資源,提高了效率,性能損耗低
啟動速度更快:可以在做到秒級完成啟動。
容器具有可移植性
容器是輕量的,可同時運行數十個容器,模擬分散式系統
不必花時間在配置和安裝上,無需擔心系統的改動,以及依賴關係是否滿足
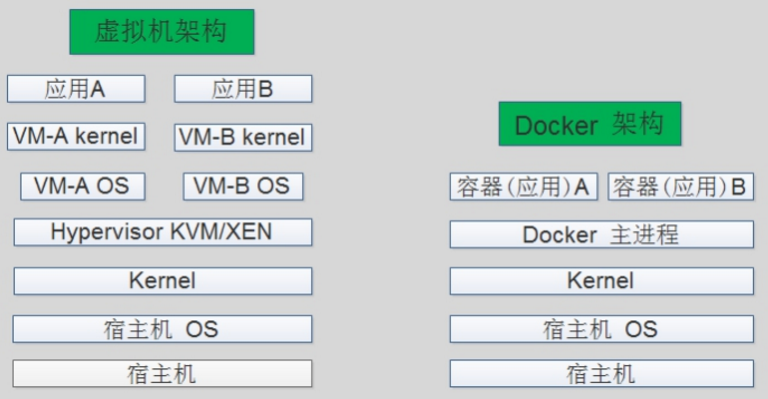
區別:
A.容器只能運行與主機一樣的內核
B.容器程式庫可以共用
C.容器中執行的進程與主機的進程等價(沒有虛擬機管理程式的損耗)
D.隔離能力,虛擬機更高(將容器運行在虛擬機中)
E.使用虛擬機是為了更好的實現服務運行環境隔離,但是一個虛擬機只運行一個服務,很明顯資源利用率比較低
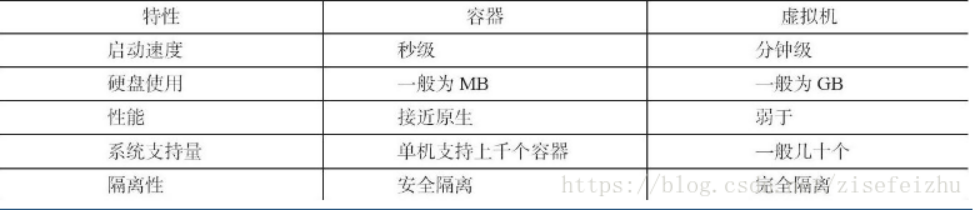
2.3.6 docker的優勢與缺點
優勢
快速部署:短時間內可以部署成百上千個應用,更快速交付到線上。
高效虛擬化:不需要額外的hypervisor支援,直接基於linux 實現應用虛擬化,相比虛擬機大幅提高性能和效率。
節省開支:提高伺服器利用率,降低IT 支出。
簡化配置:將運行環境打包保存至容器,使用時直接啟動即可。
快速遷移和擴展:可誇平台運行在物理機、虛擬機、公有雲等環境,良好的兼容性可以方便將應用從A宿主機遷移到B宿主機,甚至是A平台遷移到B平台。
缺點:
隔離性:各應用之間的隔離不如虛擬機。
2.3.7 docker容器的核心技術
容器規範:
除了docker之外的docker技術,還有coreOS的rkt,還有阿里的Pouch,為了保證容器生態的標誌性和健康可持續發展,包括Google、Docker等公司共同成立了一個叫open container(OCI)的組織,其目的就是制定開放的標準的容器規範,目前OCI一共發布了兩個規範,分別是runtime spec和image format spec,有了這兩個規範,不同的容器公司開發的容器只要兼容這兩個規範,就可以保證容器的可移植性和相互可操作性。
容器runtime:
runtime是真正運行容器的地方,因此為了運行不同的容器runtime需要和作業系統內核緊密合作相互在支援,以便為容器提供相應的運行環境。
目前主流的三種runtime:
Lxc:linux上早期的runtime,Docker早期就是採用lxc作為runtime。
runc:目前Docker默認的runtime,runc遵守OCI規範,因此可以兼容lxc。
rkt:是CoreOS開發的容器runtime,也符合OCI規範,所以使用rktruntime也可以運行Docker容器。
容器管理工具:
管理工具連接runtime與用戶,對用戶提供圖形或命令方式操作,然後管理工具將用戶操作傳遞給runtime執行。
Lxd是lxc的管理工具。
Runc的管理工具是docker engine,docker engine包含後台deamon和cli兩部分,大家經常提到的Docker就是指的docker engine。
Rkt的管理工具是rkt cli。
容器定義工具:
容器定義工具允許用戶定義容器的屬性和內容,以方便容器能夠被保存、共享和重建。
Docker image:是docker 容器的模板,runtime依據docker image創建容器。
Dockerfile:包含N個命令的文本文件,通過dockerfile創建出docker image。
ACI(App container image):與docker image類似,是CoreOS開發的rkt容器的鏡像格式。
Registry:
統一保存共享鏡像的地方,叫做鏡像倉庫。
Image registry:docker 官方提供的私有倉庫部署工具。
Docker hub:docker官方的公共倉庫,已經保存了大量的常用鏡像,可以方便大家直接使用。
Harbor:vmware 提供的自帶web的鏡像倉庫,目前有很多公司使用。
編排工具:
當多個容器在多個主機運行的時候,單獨管理每個容器是相當負載而且很容易出錯,而且也無法實現某一台主機宕機後容器自動遷移到其他主機從而實現高可用的目的,也無法實現動態伸縮的功能,因此需要有一種工具可以實現統一管理、動態伸縮、故障自愈、批量執行等功能,這就是容器編排引擎。
容器編排通常包括容器管理、調度、集群定義和服務發現等功能。
Docker swarm:docker 開發的容器編排引擎。
Kubernetes:google領導開發的容器編排引擎,內部項目為Borg,且其同時支援docker和CoreOS。
Mesos+Marathon:通用的集群組員調度平台,mesos與marathon一起提供容器編排引擎功能。
2.3.8 docker容器的依賴技術
容器網路:
docker自帶的網路docker network僅支援管理單機上的容器網路,當多主機運行的時候需要使用第三方開源網路,例如calico、flannel等。
服務發現:
容器的動態擴容特性決定了容器IP也會隨之變化,因此需要有一種機制開源自動識別並將用戶請求動態轉發到新創建的容器上,kubernetes自帶服務發現功能,需要結合kube-dns服務解析內部域名。 【現在是Core-dns】
容器監控:
可以通過原生命令docker ps/top/stats 查看容器運行狀態,另外也可以使heapster/ Prometheus等第三方監控工具監控容器的運行狀態。
數據管理:
容器的動態遷移會導致其在不同的Host之間遷移,因此如何保證與容器相關的數據也能隨之遷移或隨時訪問,可以使用邏輯卷/存儲掛載等方式解決。
日誌收集:
docker 原生的日誌查看工具docker logs,但是容器內部的日誌需要通過ELK等專門的日誌收集分析和展示工具進行處理。
2.3.9 docker命名空間【namespaces】
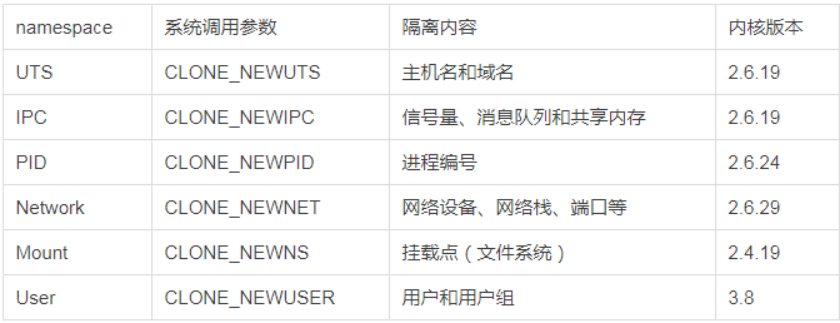
實現內核級虛擬化(容器)服務,讓同一個Namespace下的進程可以感知彼此的變化,同時又能確保對外界的進程一無所知,以達到獨立和隔離的目的。
通過查看 /proc 目錄下以進程ID作為名稱的子目錄中的資訊,能了解該進程的一組Namespace ID
pid namespace
不同用戶的進程就是通過pid namespace隔離開的,且不同 namespace 中可以有相同 PID。
具有以下特徵:
每個namespace中的pid是有自己的pid=1的進程(類似 /sbin/init 進程)
每個 namespace 中的進程只能影響自己的同一個 namespace 或子 namespace 中的進程
因為 /proc 包含正在運行的進程,因此在 container 中的 pseudo-filesystem 的 /proc 目錄只能看到自己namespace 中的進程
因為 namespace 允許嵌套,父 namespace 可以影響子 namespace 的進程,所以子 namespace 的進程可以在父namespace中看到,但是具有不同的 pid
mnt namespace
類似 chroot,將一個進程放到一個特定的目錄執行。mnt namespace 允許不同namespace的進程看到的文件結構不同,這樣每個namespace 中的進程所看到的文件目錄就被隔離開了。同 chroot 不同,每個 namespace 中的 container 在 /proc/mounts 的資訊只包含所在namespace的mount point。
net namespace
網路隔離是通過 net namespace 實現的, 每個 net namespace 有獨立的 network devices, IP addresses, IP routing tables, /proc/net 目錄。這樣每個 container 的網路就能隔離開來。 docker 默認採用 veth 的方式將 container 中的虛擬網卡同 host 上的一個 docker bridge 連接在一起。
uts namespace
UTS ("UNIX Time-sharing System") namespace 允許每個 container 擁有獨立的 hostname 和 domain name, 使其在網路上可以被視作一個獨立的節點而非 Host 上的一個進程。
ipc namespace
container 中進程交互還是採用 Linux 常見的進程間交互方法 (interprocess communication - IPC), 包括常見的訊號量、消息隊列和共享記憶體。然而同 VM 不同,container 的進程間交互實際上還是 host 上具有相同 pid namespace 中的進程間交互,因此需要在IPC資源申請時加入 namespace 資訊 - 每個 IPC 資源有一個唯一的 32bit ID。
user namespace
每個 container 可以有不同的 user 和 group id, 也就是說可以以 container 內部的用戶在 container 內部執行程式而非 Host 上的用戶。
有了以上6種namespace從進程、網路、IPC、文件系統、UTS 和用戶角度的隔離,一個 container 就可以對外展現出一個獨立電腦的能力,並且不同container從OS層面實現了隔離。然而不同 namespace 之間資源還是相互競爭的,仍然需要類似ulimit 來管理每個container所能使用的資源。
2.3.10 docker資源配額【cgroups】
cgroups是Linux內核提供的一種可以限制、記錄、隔離進程組所使用的物理資源(包括CPU、記憶體、磁碟I/O速度等)的機制,也是容器管理虛擬化系統資源的手段。
查看任意進程在/proc目錄下的內容,可以看到一個名為cgroup的文件,每個掛載點都是一個CGroup子系統的根目錄
實現了對資源的配額和度量。cgroups的使用非常簡單,提供類似文件的介面,在/cgroup目錄下新建一個文件夾即可新建一個group,在此文件夾中新建 task 文件,並將 pid 寫入該文件,即可實現對該進程的資源控制。具體的資源配置選項可以在該文件夾中新建子 subsystem ,{子系統前綴}.{資源項} 是典型的配置方法, 如 memory.usageinbytes 就定義了該 group 在 subsystem memory 中的一個記憶體限制選項。
另外,cgroups 中的 subsystem 可以隨意組合,一個 subsystem 可以在不同的 group 中,也可以一個 group 包含多個 subsystem - 也就是說一個 subsystem。
在Linux 4.7.1內核中,已經支援了10類不同的子系統,分別如下所示:
hugetlb:
限制進程對大頁記憶體(Hugepage)的使用
memory:
限制進程對記憶體和Swap的使用,並生成每個進程使用的記憶體資源報告
pids:
限制每個CGroup中能夠創建的進程總數
cpuset:
在多核系統中為進程分配獨立CPU和記憶體
devices:
允許或拒絕進程訪問特定設備
net_cls 和 net_prio:
標記每個網路包,並控制網卡優先順序
cpu 和 cpuacct:
限制進程對CPU的用量,並生成每個進程所使用的CPU報告
freezer:
掛起或恢復特定的進程
blkio:
為進程對塊設備(如磁碟、USB等)限制輸入/輸出
perf_event:
監測屬於特定的CGroup的所有執行緒以及運行在特定CPU上的執行緒
2.3.11 docker的工作原理
1)可以建立一個容納應用程式的容器。
2)可以從Docker鏡像創建Docker容器來運行應用程式。
3)可以通過Docker Hub或者自己的Docker倉庫分享Docker鏡像。
docker鏡像是如何工作的
Docker鏡像是Docker容器運行時的只讀模板,每一個鏡像由一系列的層(layers)組成;
Docker使用UnionFS(聯合文件系統)來將這些層聯合到一二鏡像中,UnionFS文件系統允許獨立文件系統中的文件和文件夾(稱之為分支)被透明覆蓋,形成一個單獨連貫的文件系統。
正因為有了這些層(layers)的存在,Docker才會如此的輕量。當你改變了一個Docker鏡像,比如升級到某個程式到新的版本,一個新的層會被創建。因此,不用替換整個原先的鏡像或者重新建立(在使用虛擬機的時候你可能會這麼做),只是一個新的層被添加或升級了。所以你不用重新發布整個鏡像,只需要升級。層使得分發Docker鏡像變得簡單和快速。
每個鏡像都是從一個基礎的鏡像開始的,比如ubuntu,一個基礎的Ubuntu鏡像,或者是Centos,一個基礎的Centos鏡像。你可以使用你自己的鏡像作為新鏡像的基礎,例如你有一個基礎的安裝了Nginx的鏡像,你可以使用該鏡像來建立你的Web應用程式鏡像。(Docker通常從Docker Hub獲取基礎鏡像)
Docker鏡像從這些基礎的鏡像創建,通過一種簡單、具有描述性的步驟,我們稱之為 指令(instructions)。
每一個指令會在鏡像中創建一個新的層,指令可以包含這些動作:
1)運行一個命令。
2)增加文件或者文件夾。
3)創建一個環境變數。
4)當運行容器的時候哪些程式會運行。
這些指令存儲在Dockerfile文件中。當你需要建立鏡像的時候,Docker可以從Dockerfile中讀取這些指令並且運行,然後返回一個最終的鏡像。
docker倉庫是如何工作的
Docker倉庫是Docker鏡像的存儲倉庫。可以推送鏡像到Docker倉庫中,然後在Docker客戶端,可以從Docker倉庫中搜索鏡像。
Docker容器是如何工作的
一個Docker容器包含了一個作業系統、用戶添加的文件和元數據(meta-data)。每個容器都是從鏡像建立的,鏡像告訴Docker容器內包含了什麼,當容器啟動時運行什麼程式,還有許多配置數據。
Docker鏡像是只讀的,當Docker運行一個從鏡像建立的容器,它會在鏡像頂部添加一個可讀寫的層,應用程式可以在這裡運行。
當運行docker容器時發生了什麼
使用docker命令時,Docker客戶端都告訴Docker守護進程運行一個容器。
docker run -i -t ubuntu /bin/bash
可以來分析這個命令,Docker客戶端使用docker命令來運行,run參數表明客戶端要運行一個新的容器。
Docker客戶端要運行一個容器需要告訴Docker守護進程的最小參數資訊是:
1)這個容器從哪個鏡像創建,這裡是ubuntu,基礎的Ubuntu鏡像。
2)在容器中要運行的命令,這裡是/bin/bash,在容器中運行Bash shell。
那麼運行這個命令之後在底層發生了什麼呢?
按照順序,Docker做了這些事情:
1)拉取ubuntu鏡像: Docker檢查ubuntu鏡像是否存在,如果在本地沒有該鏡像,Docker會從Docker Hub下載。如果鏡像已經存在,Docker會使用它來創建新的容器。
2)創建新的容器: 當Docker有了這個鏡像之後,Docker會用它來創建一個新的容器。
3)分配文件系統並且掛載一個可讀寫的層: 容器會在這個文件系統中創建,並且一個可讀寫的層被添加到鏡像中。
4)分配網路/橋接介面: 創建一個允許容器與本地主機通訊的網路介面。
5)設置一個IP地址: 從池中尋找一個可用的IP地址並且服加到容器上。
6)運行你指定的程式: 運行指定的程式。
7)捕獲並且提供應用輸出: 連接並且記錄標準輸出、輸入和錯誤讓你可以看到你的程式是如何運行的。
由此你就可以擁有一個運行著的Docker容器了!從這裡開始你可以管理你的容器,與應用交互,應用完成之後,可以停止或者刪除你的容器。
2.3.12 docker與openstack的對比
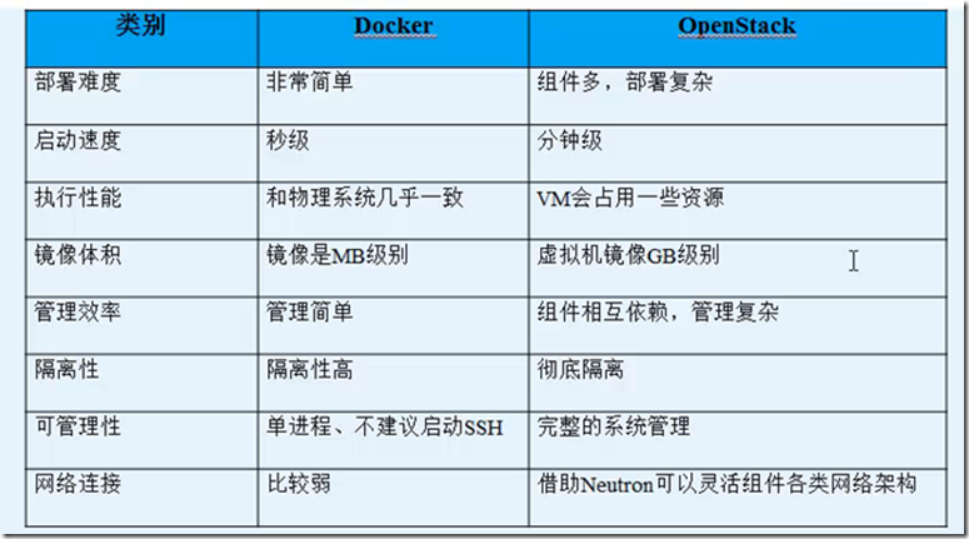
2.3.13 docker用途
簡單配置、程式碼流水線管理、開發效率、應用隔離、伺服器整合、調試能力、多租戶、快速部署
2.4 dcker的基本用法
2.4.1 docker安裝及驗證
官方網址:
系統版本選擇:
Docker 目前已經支援多種作業系統的安裝運行,比如Ubuntu、CentOS、Redhat、Debian、Fedora,甚至是還支援了Mac和Windows,在linux系統上需要內核版本在3.10或以上,docker版本號之前一直是0.X版本或1.X版本,但是從2017年3月1號開始改為每個季度發布一次穩版,其版本號規則也統一變更為YY.MM,例如18.09表示是2018年9月份發布的,本次演示的作業系統使用Centos 7.6為例,內核4.4。
[root@docker ~]# cat /etc/redhat-release CentOS Linux release 7.6.1810 (Core) [root@docker ~]# uname -r 4.4.186-1.el7.elrepo.x86_64 Docker版本選擇:
Docker之前沒有區分版本,但是2017年推出(將docker更名為)新的項目Moby,github地址:https://github.com/moby/moby,Moby項目屬於Docker項目的全新上游,Docker將是一個隸屬於的Moby的子產品,而且之後的版本之後開始區分為CE版本(社區版本)和EE(企業收費版),CE社區版本和EE企業版本都是每個季度發布一個新版本,但是EE版本提供後期安全維護1年,而CE版本是4個月,本次演示的Docker版本為19.03。
下載rpm包安裝:
官方rpm包下載地址: https://download.docker.com/linux/centos/7/x86_64/stable/Packages/
阿里鏡像下載地址:https://mirrors.aliyun.com/docker-ce/linux/centos/7/x86_64/stable/Packages/
通過yum源安裝:【常用】
[root@docker ~]# wget -O /etc/yum.repos.d/docker-ce.repo https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo [root@docker ~]# yum repolist ...... * extras: mirrors.aliyun.com --- > extras倉庫里有docker安裝包,版本可以通過Centos鏡像直接查看 ...... docker-ce-stable/x86_64 Docker CE Stable - x86_64 #安裝 [root@docker ~]# yum install docker-ce ...... 正在安裝: docker-ce x86_64 3:19.03.1-3.el7 docker-ce-stable 24 M 52 啟動並驗證docker服務:
#啟動docker服務 [root@docker ~]# systemctl enable docker ; systemctl start docker;systemctl status docker|grep Active Active: active (running) since 一 2019-07-29 16:37:37 CST; 23s ago #驗證docker資訊 [root@docker ~]# docker info Server Version: 19.03.1 Storage Driver: overlay2 Backing Filesystem: xfs Supports d_type: true Native Overlay Diff: true Logging Driver: json-file Cgroup Driver: cgroupfs Plugins: Volume: local Network: bridge host ipvlan macvlan null overlay Log: awslogs fluentd gcplogs gelf journald json-file local logentries splunk syslog Swarm: inactive Runtimes: runc Default Runtime: runc Init Binary: docker-init containerd version: 894b81a4b802e4eb2a91d1ce216b8817763c29fb runc version: 425e105d5a03fabd737a126ad93d62a9eeede87f init version: fec3683 Security Options: seccomp Profile: default Kernel Version: 4.4.186-1.el7.elrepo.x86_64 Operating System: CentOS Linux 7 (Core) OSType: linux Architecture: x86_64 CPUs: 4 Total Memory: 1.936GiB Name: docker ID: 6EXA:7EIF:JC2F:W5SG:RG2U:7FDZ:TSI7:TTUF:2OMS:BDX2:TMDF:CFN7 Docker Root Dir: /var/lib/docker Debug Mode: false Registry: https://index.docker.io/v1/ Labels: Experimental: false Insecure Registries: 127.0.0.0/8 Live Restore Enabled: false #驗證docker0網卡 在docker安裝啟動之後,默認會生成一個名稱為docker0的網卡並且默認IP地址為172.17.0.1的網卡。
[root@docker ~]# ifconfig docker0: flags=4099<UP,BROADCAST,MULTICAST> mtu 1500 inet 172.17.0.1 netmask 255.255.0.0 broadcast 172.17.255.255 ether 02:42:22:7f:4a:b1 txqueuelen 0 (Ethernet) RX packets 0 bytes 0 (0.0 B) RX errors 0 dropped 0 overruns 0 frame 0 TX packets 0 bytes 0 (0.0 B) TX errors 0 dropped 0 overruns 0 carrier 0 collisions 0 eth0: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 inet 20.0.0.209 netmask 255.255.255.0 broadcast 20.0.0.255 ether 00:0c:29:da:d7:53 txqueuelen 1000 (Ethernet) RX packets 79925 bytes 109388735 (104.3 MiB) RX errors 0 dropped 0 overruns 0 frame 0 TX packets 14335 bytes 1002691 (979.1 KiB) TX errors 0 dropped 0 overruns 0 carrier 0 collisions 0 #查看docker網路 [root@docker ~]# docker network list NETWORK ID NAME DRIVER SCOPE 064e0098dd15 bridge bridge local 48cf42c3b371 host host local 4c1006be1ea1 none null local docker存儲引擎
目前docker的默認存儲引擎為overlay2,需要磁碟分區支援d-type文件分層功能,因此需要系統磁碟的額外支援。
官方文檔關於存儲引擎的選擇文檔:https://docs.docker.com/storage/storagedriver/select-storage-driver/
Docker官方推薦首選存儲引擎為overlay2其次為devicemapper,但是devicemapper存在使用空間方面的一些限制,雖然可以通過後期配置解決,但是官方依然推薦使用overlay2,以下是網上查到的部分資料:https://www.cnblogs.com/youruncloud/p/5736718.html
[root@docker ~]# xfs_info / meta-data=/dev/sda3 isize=512 agcount=4, agsize=1179584 blks = sectsz=512 attr=2, projid32bit=1 = crc=1 finobt=0 spinodes=0 data = bsize=4096 blocks=4718336, imaxpct=25 = sunit=0 swidth=0 blks naming =version 2 bsize=4096 ascii-ci=0 ftype=1 log =internal bsize=4096 blocks=2560, version=2 = sectsz=512 sunit=0 blks, lazy-count=1 realtime =none extsz=4096 blocks=0, rtextents=0 如果docker數據目錄是一塊單獨的磁碟分區而且是xfs格式的,那麼需要在格式化的時候加上參數-n ftype=1,否則後期在啟動容器的時候會報錯不支援d-type。
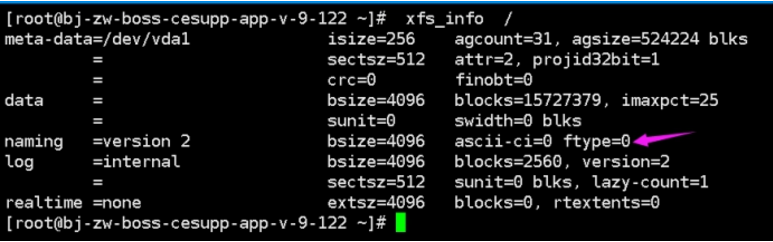
報錯介面:

2.4.2 鏡像加速
因為國情的原因,中國下載 Docker HUB 官方的相關鏡像比較慢,可以使用中國(docker.io)的一些鏡像加速器,鏡像保持和官方一致,關鍵是速度塊,推薦使用。
這裡需要明確一個問題,就是Mirror與Private Registry的區別。二者有著本質的差別:
1)Private Registry(私有倉庫)是開發者或者企業自建的鏡像存儲庫,通常用來保存企業內部的 Docker 鏡像,用於內部開發流程和產品的發布、版本控制。
2)Mirror是一種代理中轉服務,我們(比如daocloud)提供的Mirror服務,直接對接Docker Hub的官方Registry。Docker Hub 上有數以十萬計的各類 Docker 鏡像。
3)在使用Private Registry時,需要在Docker Pull 或Dockerfile中直接鍵入Private Registry 的地址,通常這樣會導致與 Private Registry 的綁定,缺乏靈活性。
4)使用 Mirror 服務,只需要在 Docker 守護進程(Daemon)的配置文件中加入 Mirror 參數,即可在全局範圍內透明的訪問官方的 Docker Hub,避免了對 Dockerfile 鏡像引用來源的修改。
5)簡單來說,Mirror類似CDN,本質是官方的cache;Private Registry類似私服,跟官方沒什麼關係。對用戶來說,由於用戶是要拖docker hub上的image,對應的是Mirror。 yum/apt-get的Mirror又有點不一樣,它其實是把官方的庫文件整個拖到自己的伺服器上做鏡像(不管有沒有用),並定時與官方做同步;而Docker Mirror只會快取曾經使用過的image。
目前中國訪問docker hub速度上有點尷尬,使用docker Mirror勢在必行。
現有中國提供docker鏡像加速服務的商家有不少,下面重點介紹幾家:
(1). ustc的鏡像
ustc是老牌的linux鏡像服務提供者了,還在遙遠的ubuntu 5.04版本的時候就在用。之前在blog里有提到可以用ustc的docker倉庫鏡像.
使用方法參考ustc docker鏡像使用幫助
ustc的docker鏡像加速器速度很不錯,一直用的挺happy。ustc docker mirror的優勢之一就是不需要註冊,真正是公共服務啊。
----------------------------------這裡順便說下在新版Docker里使用ustc的做法------------------------------------- 新版的Docker配置方法: [root@localhost ~]# vim /etc/docker/daemon.json //如果沒有該文件的話,就手動創建。在該文件里添加下面內容 { "registry-mirrors": ["https://docker.mirrors.ustc.edu.cn"] } 然後就可以直接docker pull下載鏡像了,速度杠杠滴!!! [root@localhost docker]# docker pull ubuntu Using default tag: latest Trying to pull repository docker.io/library/ubuntu ... latest: Pulling from docker.io/library/ubuntu d54efb8db41d: Pull complete f8b845f45a87: Pull complete e8db7bf7c39f: Pull complete 9654c40e9079: Pull complete 6d9ef359eaaa: Pull complete Digest: sha256:dd7808d8792c9841d0b460122f1acf0a2dd1f56404f8d1e56298048885e45535 Status: Downloaded newer image for docker.io/ubuntu:latest [root@localhost ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/ubuntu latest 0ef2e08ed3fa 2 weeks ago 130 MB ----------------------------------------------------------------------------------------------------------------------
(2). daocloud鏡像
DaoCloud也提供了docker加速器,但是跟ustc不同,需要用戶註冊後才能使用,並且每月限制流量10GB。linux上使用比較簡單,一條腳本命令搞定:
curl -sSL https://get.daocloud.io/daotools/set_mirror.sh | sh -s http://{your_id}.m.daocloud.io 實際上面的腳本執行後,改的是/usr/lib/systemd/system/docker.service文件,加了個–registry-mirror參數。如果不執行上面的腳本命令,可以如下直接修改這個文件也可: ExecStart=/usr/bin/docker-current daemon --registry-mirror=http://{your_id}.m.daocloud.io 設置後,需要重新載入配置&重啟: # systemctl enable docker # systemctl daemon-reload # systemctl restart docker 但是最近使用DaoCloud的docker加速器體驗非常差,加速效果不是很明顯。
(3). alicloud
阿里雲也提供了docker加速器,不過比daocloud更麻煩:不光要註冊為阿里雲的用戶,還得加入開發者平台。
不過雖然麻煩,但是它的服務還真是不錯,pull速度很溜!配置方法跟daocloud類似,也是開通加速器以後給一個url。
可以直接去改/usr/lib/systemd/system/docker.service: ExecStart=/usr/bin/docker-current daemon --registry-mirror=https://{your_id}.mirror.aliyuncs.com 重新載入配置&重啟: # systemctl enable docker # systemctl daemon-reload # systemctl restart docker pull的時候還是顯示docker.io,但速度一點都不docker.io。 # docker pull ubuntu Using default tag: latest Trying to pull repository docker.io/library/ubuntu ... latest: Pulling from docker.io/library/ubuntu cad964aed91d: Pull complete 3a80a22fea63: Pull complete 50de990d7957: Pull complete 61e032b8f2cb: Pull complete 9f03ce1741bf: Pull complete Digest: sha256:28d4c5234db8d5a634d5e621c363d900f8f241240ee0a6a978784c978fe9c737 Status: Downloaded newer image for docker.io/ubuntu:latest
(4). 網易鏡像
網易也提供了Docker鏡像服務:網易蜂巢
echo "DOCKER_OPTS="$DOCKER_OPTS --registry-mirror=http://hub-mirror.c.163.com"" >> /etc/default/docker service docker restart 綜上,雖然aliyun docker mirror用之前的流程有點繁瑣,但服務講真是很不錯的。
我在本次學習中使用的是如下:

[root@docker ~]# sudo mkdir -p /etc/docker [root@docker ~]# sudo tee /etc/docker/daemon.json <<-'EOF' > { > "registry-mirrors": ["https://llpuz83z.mirror.aliyuncs.com"] > } > EOF { "registry-mirrors": ["https://llpuz83z.mirror.aliyuncs.com"] } [root@docker ~]# sudo systemctl daemon-reload [root@docker ~]# sudo systemctl restart docker [root@docker ~]# docker info Registry Mirrors: https://llpuz83z.mirror.aliyuncs.com/ 2.4.3 docker鏡像基礎命令
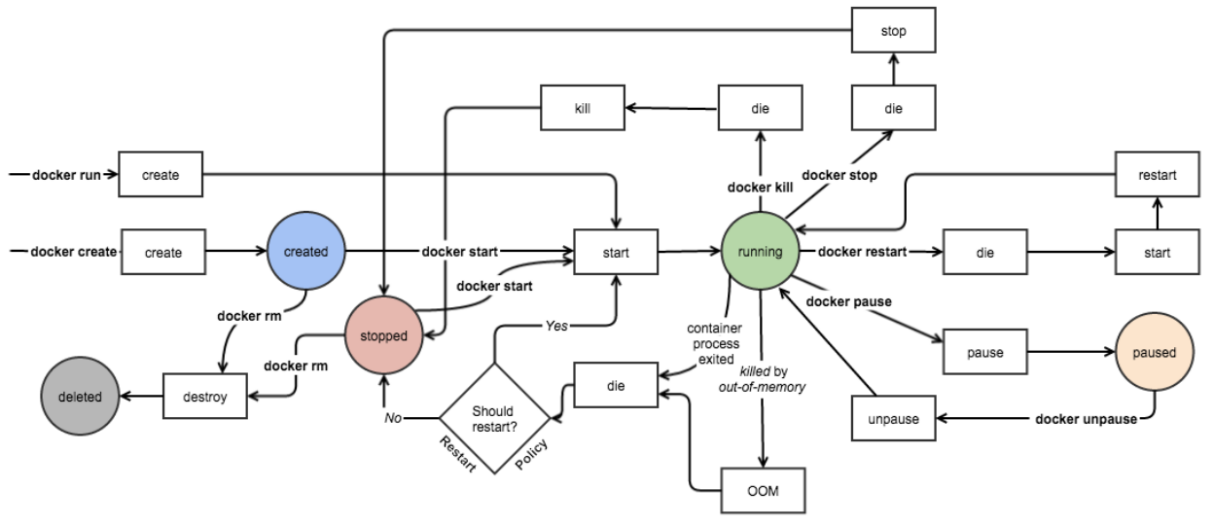
[root@docker ~]# docker --help Usage: docker [OPTIONS] COMMAND Commands: attach Attach to a running container # 當前 shell 下 attach 連接指定運行鏡像 build Build an image from a Dockerfile # 通過 Dockerfile 訂製鏡像 commit Create a new image from a container's changes # 提交當前容器為新的鏡像 cp Copy files/folders from the containers filesystem to the host path # 從容器中拷貝指定文件或者目錄到宿主機中 create Create a new container # 創建一個新的容器,同 run,但不啟動容器 diff Inspect changes on a container's filesystem # 查看 docker 容器變化 events Get real time events from the server # 從 docker 服務獲取容器實時事件 exec Run a command in an existing container # 在已存在的容器上運行命令 export Stream the contents of a container as a tar archive # 導出容器的內容流作為一個 tar 歸檔文件[對應 import ] history Show the history of an image # 展示一個鏡像形成歷史 images List images # 列出系統當前鏡像 import Create a new filesystem image from the contents of a tarball # 從tar包中的內容創建一個新的文件系統映像[對應 export] info Display system-wide information # 顯示系統相關資訊 inspect Return low-level information on a container # 查看容器詳細資訊 kill Kill a running container # kill 指定 docker 容器 load Load an image from a tar archive # 從一個 tar 包中載入一個鏡像[對應 save] login Register or Login to the docker registry server # 註冊或者登陸一個 docker 源伺服器 logout Log out from a Docker registry server # 從當前 Docker registry 退出 logs Fetch the logs of a container # 輸出當前容器日誌資訊 port Lookup the public-facing port which is NAT-ed to PRIVATE_PORT # 查看映射埠對應的容器內部源埠 pause Pause all processes within a container # 暫停容器 ps List containers # 列出容器列表 pull Pull an image or a repository from the docker registry server # 從docker鏡像源伺服器拉取指定鏡像或者庫鏡像 push Push an image or a repository to the docker registry server # 推送指定鏡像或者庫鏡像至docker源伺服器 restart Restart a running container # 重啟運行的容器 rm Remove one or more containers # 移除一個或者多個容器 rmi Remove one or more images # 移除一個或多個鏡像[無容器使用該鏡像才可刪除,否則需刪除相關容器才可繼續或 -f 強制刪除] run Run a command in a new container # 創建一個新的容器並運行一個命令 save Save an image to a tar archive # 保存一個鏡像為一個 tar 包[對應 load] search Search for an image on the Docker Hub # 在 docker hub 中搜索鏡像 start Start a stopped containers # 啟動容器 stop Stop a running containers # 停止容器 tag Tag an image into a repository # 給源中鏡像打標籤 top Lookup the running processes of a container # 查看容器中運行的進程資訊 unpause Unpause a paused container # 取消暫停容器 version Show the docker version information # 查看 docker 版本號 wait Block until a container stops, then print its exit code # 截取容器停止時的退出狀態值 大多數子命令下都用選項,需要用到時--help下。
docker 命令是最常使用的命令,其後面可以加不同的參數以實現響應的功能,常用的命令如下:
#查看docker版本資訊 [root@docker ~]# docker --version Docker version 19.03.1, build 74b1e89 [root@docker ~]# docker info #搜索鏡像 在官方的docker 倉庫中搜索指定名稱的docker鏡像,也會有很多三方鏡像。 [root@docker ~]# docker search nginx #不帶版本號默認latest [root@docker ~]# docker search nginx:1.17 #帶指定版本號 從站點查看搜索鏡像 https://hub.docker.com/ -->nginx -->nginx -->Tags 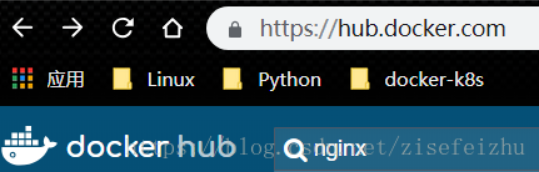
#下載鏡像 [root@docker ~]# docker pull busybox Using default tag: latest latest: Pulling from library/busybox ee153a04d683: Pull complete Digest: sha256:9f1003c480699be56815db0f8146ad2e22efea85129b5b5983d0e0fb52d9ab70 Status: Downloaded newer image for busybox:latest docker.io/library/busybox:latest BusyBox是一種特殊類型的程式,它將許多重要程式與標準UNIX命令(如Coreutils) “打包”到一個可執行文件中(有時稱為其打包方法)。BusyBox 可執行文件被設計為Linux上最小的可執行文件,與安裝每個命令的可執行文件相比,可以大大減少磁碟使用量。因此,應用程式特定的Linux發行版和嵌入式系統都適合,“ 嵌入式Linux的Jittoku刀也稱為”。它是GPLv2中發布的免費軟體。 從功能上講,它類似於crunchgen命令,它是1994年由馬里蘭大學帕克分校的James da Silva開發的FreeBSD程式。 #查看本地鏡像 下載完成的鏡像比下載的大,因為下載完成後會解壓 [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE busybox latest db8ee88ad75f 10 days ago 1.22MB REPOSITORY #鏡像所屬的倉庫名稱 TAG #鏡像版本號(標識符),默認為latest IMAGE ID #鏡像唯一ID標示 CREATED #鏡像創建時間 VIRTUAL SIZE #鏡像的大小 #刪除鏡像 [root@docker ~]# docker image rm busybox:latest Untagged: busybox:latest Untagged: busybox@sha256:9f1003c480699be56815db0f8146ad2e22efea85129b5b5983d0e0fb52d9ab70 Deleted: sha256:db8ee88ad75f6bdc74663f4992a185e2722fa29573abcc1a19186cc5ec09dceb Deleted: sha256:0d315111b4847e8cd50514ca19657d1e8d827f4e128d172ce8b2f76a04f3faea #docker 鏡像導入導出(import export)和載入保存(load,save) save和load是一對,export和import是一對 export和import是對容器來講的,export時會對容器做快照保存下來,import時可以重新命名鏡像,也可以根據文件或url或目錄來創建鏡像(import命令比較複雜,推薦看文檔來嘗試) docker export container_id/container_name > latest.tar docker import latest.tar image:tag save和load對鏡像來講的,save時可能會保存所有層,之後可以層回滾(我還沒試) docker save > latest.tar image[:tag] #將image(可指定tag,不指定默認所有)打包 docker load < latest.tar 區別 docker import可以重新指定鏡像的名字,docker load不可以 export導出的鏡像文件大小 小於 save保存的鏡像 我們發現導出後的版本會比原來的版本稍微小一些。那是因為導出後,會丟失歷史和元數據。執行下面的命令就知道了: 顯示鏡像的所有層(layer) docker images --tree 執行命令,顯示下面的內容。正如看到的,導出後再導入(exported-imported)的鏡像會丟失所有的歷史,而保存後再載入(saveed-loaded)的鏡像沒有丟失歷史和層(layer)。這意味著使用導出後再導入的方式,你將無法回滾到之前的層(layer),同時,使用保存後再載入的方式持久化整個鏡像,就可以做到層回滾(可以執行docker tag 來回滾之前的層)。 2.4.4 docker容器操作基礎命令
docker最核心的命令:docker run
docker run [選項] [鏡像名] [shell命令] [參數]
[root@docker ~]# docker run --help -d, --detach=false 指定容器運行於前台還是後台,默認為false -i, --interactive=false 打開STDIN,用於控制台交互 -t, --tty=false 分配tty設備,該可以支援終端登錄,默認為false -u, --user="" 指定容器的用戶 -a, --attach=[] 登錄容器(必須是以docker run -d啟動的容器) -w, --workdir="" 指定容器的工作目錄 -c, --cpu-shares=0 設置容器CPU權重,在CPU共享場景使用 -e, --env=[] 指定環境變數,容器中可以使用該環境變數 -m, --memory="" 指定容器的記憶體上限 -P, --publish-all=false 指定容器暴露的埠 -p, --publish=[] 指定容器暴露的埠 -h, --hostname="" 指定容器的主機名 -v, --volume=[] 給容器掛載存儲卷,掛載到容器的某個目錄 --volumes-from=[] 給容器掛載其他容器上的卷,掛載到容器的某個目錄 --cap-add=[] 添加許可權,許可權清單詳見:http://linux.die.net/man/7/capabilities --cap-drop=[] 刪除許可權,許可權清單詳見:http://linux.die.net/man/7/capabilities --cidfile="" 運行容器後,在指定文件中寫入容器PID值,一種典型的監控系統用法 --cpuset="" 設置容器可以使用哪些CPU,此參數可以用來容器獨佔CPU --device=[] 添加主機設備給容器,相當於設備直通 --dns=[] 指定容器的dns伺服器 --dns-search=[] 指定容器的dns搜索域名,寫入到容器的/etc/resolv.conf文件 --entrypoint="" 覆蓋image的入口點 --env-file=[] 指定環境變數文件,文件格式為每行一個環境變數 --expose=[] 指定容器暴露的埠,即修改鏡像的暴露埠 --link=[] 指定容器間的關聯,使用其他容器的IP、env等資訊 --lxc-conf=[] 指定容器的配置文件,只有在指定--exec-driver=lxc時使用 --name="" 指定容器名字,後續可以通過名字進行容器管理,links特性需要使用名字 --net="bridge" 容器網路設置: bridge 使用docker daemon指定的網橋 host //容器使用主機的網路 container:NAME_or_ID >//使用其他容器的網路,共享IP和PORT等網路資源 none 容器使用自己的網路(類似--net=bridge),但是不進行配置 --privileged=false 指定容器是否為特權容器,特權容器擁有所有的capabilities --restart="no" 指定容器停止後的重啟策略: no:容器退出時不重啟 on-failure:容器故障退出(返回值非零)時重啟 always:容器退出時總是重啟 --rm=false 指定容器停止後自動刪除容器(不支援以docker run -d啟動的容器) --sig-proxy=true 設置由代理接受並處理訊號,但是SIGCHLD、SIGSTOP和SIGKILL不能被代理 #從鏡像啟動一個容器 會直接進入到容器,並隨機生成容器ID和名稱 [root@docker ~]# docker run --name b1 -it busybox:latest ---> --name 自定義容器名稱 Unable to find image 'busybox:latest' locally ---> 本地沒有 就從默認的公有倉庫中拉取 latest: Pulling from library/busybox ee153a04d683: Pull complete Digest: sha256:9f1003c480699be56815db0f8146ad2e22efea85129b5b5983d0e0fb52d9ab70 Status: Downloaded newer image for busybox:latest / # ---> 直接進入到容器 / # ps ---> 默認情況下進入的是sh PID USER TIME COMMAND 1 root 0:00 sh 8 root 0:00 ps / # ls / bin dev etc home proc root sys tmp usr var ---> 都是busybox的別名 / # hostname ---> 隨機生成的容器ID 02379c036216 #退出容器不註銷 / # exit ---> exit或者ctrl + d 退出容器 容器是退出的 [root@docker ~]# docker ps ---> 顯示正在運行的容器 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES [root@docker ~]# docker container ls --->列出正在運行的容器 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES [root@docker ~]# docker ps -a ---> 顯示所有容器,包括當前正在運行以及已經關閉的所有容器 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 02379c036216 busybox:latest "sh" 4 minutes ago Exited (0) 14 seconds ago b1 [root@docker ~]# docker container ls -a ---> 顯示所有容器,包括當前正在運行以及已經關閉的所有容器 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 02379c036216 busybox:latest "sh" 38 minutes ago Exited (1) About a minute ago b1 [root@docker ~]# docker exec -it b1 sh ---> 進入容器 Error response from daemon: Container 02379c036216092f07c46c58361c2da6b5df7d15a733b3c39cfc984cd2dcf314 is not running [root@docker ~]# docker start b1 ---> 啟動暫定的容器 b1 [root@docker ~]# docker exec -it b1 sh / # hostname 02379c036216 #容器暫停不刪除是對容器原有資源資訊無影響的 ctrl +p +q 操作,退出容器,容器依然運行 [root@docker ~]# docker exec -it b1 sh / # read escape sequence [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 02379c036216 busybox:latest "sh" 17 minutes ago Up 4 minutes b1 停止容器的另一種方法:
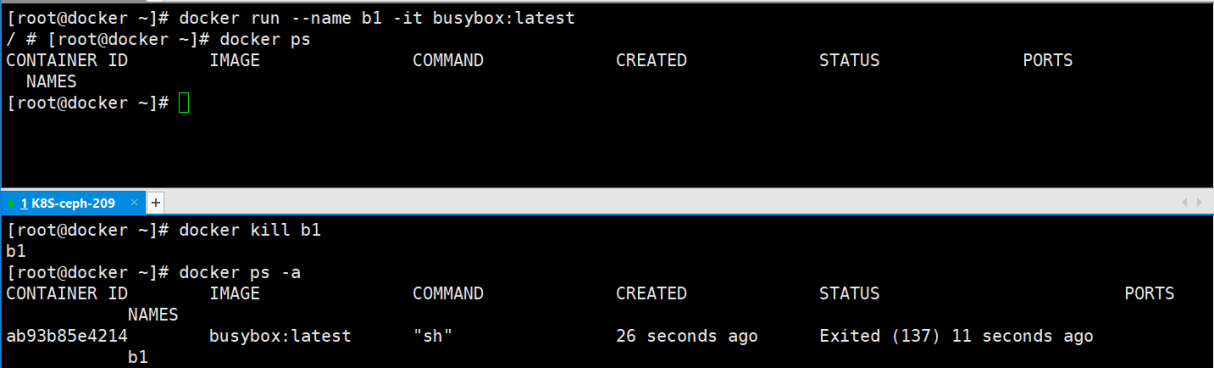
進入容器的方法對比
方法一: docker attach container_NAME/container_ID

註:當多個窗口使用該命令進入該容器時,所有窗口都會顯示同步。如果一個窗口阻塞了,其他窗口無法再進行操作;。因此docker attach命令不太適合於生產環境。且該命令有點古老,不太建議使用
方法二:使用ssh 進入docker容器
docker應用容器是一個Linux虛擬主機,那麼就可以在該主機上面安裝一個ssh server 就可以通過ssh協議來鏈接該容器
註:這種出力不討好的方法,了解一下就可以了。
方法三:使用nsenter進入docker容器
對於nsenter網上有比較多且詳細的介紹,這裡我大致寫一下操作過程
nsenter命令需要通過PID進入到容器內部,不過可以使用docker inspect獲取到容器的PID
# 安裝nsenter wget https://www.kernel.org/pub/linux/utils/util-linux/v2.24/util-linux-2.24.tar.gz tar -xzvf util-linux-2.24.tar.gz cd util-linux-2.24/ ./configure --without-ncurses make nsenter cp nsenter /usr/local/bin nsenter --help # nsenter可以訪問另一個進程名稱空間。因此我們需要獲取容器的PID docker inspect -f {{.State.Pid}} container_NAME/container_ID // 假設進程號為 4426 nsenter --target 目標PID --mount --uts --ipc --net --pid 簡寫: nsenter -t 目標PID -m -u -i -n -p #--target 4426 目標pid 腳本方式: 將nsenter命令寫入到腳本進行調用 vim /service/scripts/docker-in.sh #!/bin/bash docker_in(){ NAME_ID=$1 PID=$(docker inspect -f "{{.State.Pid}}" ${NAME_ID}) nsenter -t ${PID} -m -u -i -n -p } docker_in $1 chmod a+x /service/scripts/docker-in.sh #測試腳本是否可以正常進入到容器且退出後仍正常運行 /service/scripts/docker-in.sh container_NAME/container_ID exit /service/scripts/docker-in.sh container_NAME/container_ID exit 註:個人理解nsenter:通過容器在宿主機中的pid進行通訊
因此:nsenter需要在宿主機安裝而非容器或者鏡像
方法四:docker exec 命令
[root@docker ~]# docker exec --help Usage: docker exec [OPTIONS] CONTAINER COMMAND [ARG...] Run a command in a running container Options: -d, --detach Detached mode: run command in the background --detach-keys string Override the key sequence for detaching a container -e, --env list Set environment variables -i, --interactive Keep STDIN open even if not attached --privileged Give extended privileges to the command -t, --tty Allocate a pseudo-TTY -u, --user string Username or UID (format: <name|uid>[:<group|gid>]) -w, --workdir string Working directory inside the container [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 02379c036216 busybox:latest "sh" 33 minutes ago Up 12 minutes b1 [root@docker ~]# docker exec -it b1 sh 註:最常用的方法!!!
#刪除運行中的容器 即使容器正在運行中,也會被強制刪除 [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 02379c036216 busybox:latest "sh" 39 minutes ago Up 2 seconds b1 [root@docker ~]# docker container rm -f b1 b1 [root@docker ~]# docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 埠映射
#隨機映射埠
[root@docker ~]# docker image ls
REPOSITORY TAG IMAGE ID CREATED SIZE
busybox latest db8ee88ad75f 11 days ago 1.22MB
[root@docker ~]# docker ps -a
CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES
[root@docker ~]# docker pull nginx
docker.io/library/nginx:latest

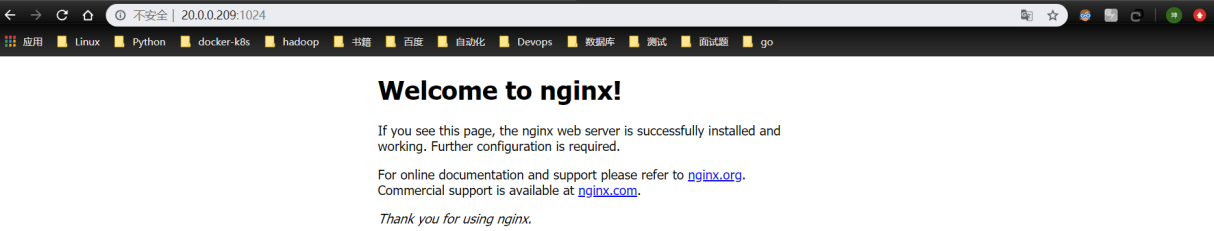
註:隨機埠映射,其實默認是從1024開始
瀏覽器訪問
#指定埠映射 方式1:本地埠81映射到容器80埠: # docker run -d -p 81:80 --name nginx-test-port1 nginx --> -d 後台啟動容器 方式2:本地IP:本地埠:容器埠 # docker run -d -p 20.0.0.209:82:80 --name nginx-test-port2 docker.io/nginx 方式3:本地IP:本地隨機埠:容器埠 # docker run -d -p 20.0.0.209::80 --name nginx-test-port3 docker.io/nginx 方式4:本機ip:本地埠:容器埠/協議,默認為tcp協議 # docker run -d -p 20.0.0.209:83:80/udp --name nginx-test-port4 docker.io/nginx 方式5:一次性映射多個埠+協議: # docker run -d -p 86:80/tcp -p 443:443/tcp -p 53:53/udp --name nginx-test-port5 docker.io/nginx 查看容器的日誌
#一次查看 [root@docker ~]# docker logs nginx-test-port2 20.0.0.1 - - [30/Jul/2019:03:42:17 +0000] "GET / HTTP/1.1" 200 612 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:42:17 +0000] "GET /favicon.ico HTTP/1.1" 404 555 "http://20.0.0.209:82/" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 2019/07/30 03:42:17 [error] 6#6: *2 open() "/usr/share/nginx/html/favicon.ico" failed (2: No such file or directory), client: 20.0.0.1, server: localhost, request: "GET /favicon.ico HTTP/1.1", host: "20.0.0.209:82", referrer: "http://20.0.0.209:82/" #持續查看 [root@docker ~]# docker logs -f nginx-test-port2 20.0.0.1 - - [30/Jul/2019:03:42:17 +0000] "GET / HTTP/1.1" 200 612 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:42:17 +0000] "GET /favicon.ico HTTP/1.1" 404 555 "http://20.0.0.209:82/" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 2019/07/30 03:42:17 [error] 6#6: *2 open() "/usr/share/nginx/html/favicon.ico" failed (2: No such file or directory), client: 20.0.0.1, server: localhost, request: "GET /favicon.ico HTTP/1.1", host: "20.0.0.209:82", referrer: "http://20.0.0.209:82/" 20.0.0.1 - - [30/Jul/2019:03:43:07 +0000] "GET / HTTP/1.1" 304 0 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:43:08 +0000] "GET / HTTP/1.1" 304 0 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:43:08 +0000] "GET / HTTP/1.1" 304 0 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:43:08 +0000] "GET / HTTP/1.1" 304 0 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 20.0.0.1 - - [30/Jul/2019:03:43:08 +0000] "GET / HTTP/1.1" 304 0 "-" "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-" 查看容器已經映射的埠
[root@docker ~]# docker port nginx-test-port3 80/tcp -> 20.0.0.209:1024 容器退出後自動刪除
[root@docker ~]# docker run -it --rm --name nginx nginx bash 傳遞運行命令
容器需要有一個前台運行的進程才能保持容器的運行,通過傳遞運行參數是一種方式,另外也可以在構建鏡像的時候指定容器啟動時運行的前台命令。 [root@docker ~]# docker run -d centos /usr/bin/tail -f '/etc/hosts' [root@docker ~]# docker ps -l CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES c8a7605ede61 centos "/usr/bin/tail -f /e…" 32 seconds ago Up 31 seconds strange_curie 容器的啟動和關閉
docker stop/start container_NAME/container_ID 批量操作
#批量關閉正在運行的容器 [root@docker ~]# docker stop $(docker ps -a -q) --->正常關閉所有運行中的容器 #批量強制關閉正在運行的容器 [root@docker ~]# docker kill $(docker ps -a -q) --->強制關閉所有運行中的容器 #批量刪除已退出的容器 [root@docker ~]# docker rm -f `docker ps -aq -f status=exited` #批量刪除所有容器 [root@docker ~]# docker rm -f `docker ps -a -q` 一個例子
[root@docker ~]# docker run --name text -it --network bridge -h zisefeizhu.com --dns 223.6.6.6 --rm busybox:latest / # hostname zisefeizhu.com / # cat /etc/resolv.conf nameserver 223.6.6.6 / # exit [root@docker ~]# docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 2.5 docker鏡像技術
一個鏡像是一個惰性的,不可變的文件,它本質上是一個容器的快照。它只是一個模板,其中包含有關創建Docker容器的說明。
鏡像存儲在Docker倉庫中,例如registry.hub.docker.com。因為它們可能變得非常大,所以鏡像被設計為由其他鏡像的層組成,允許在通過網路傳輸影像時發送最少量的數據。
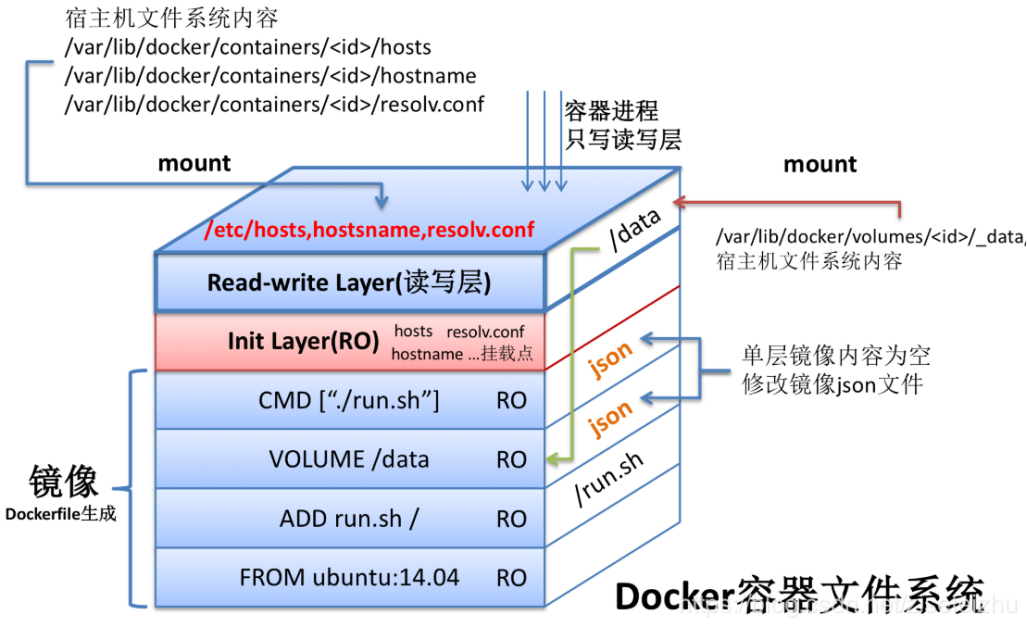
docker 鏡像是一個只讀的 docker 容器模板,含有啟動 docker 容器所需的文件系統結構及其內容,因此是啟動一個 docker 容器的基礎。docker 鏡像的文件內容以及一些運行 docker 容器的配置文件組成了 docker 容器的靜態文件系統運行環境:rootfs。可以這麼理解,docker 鏡像是 docker 容器的靜態視角,docker 容器是 docker 鏡像的運行狀態。我們可以通過下圖來理解 docker daemon、docker 鏡像以及 docker 容器三者的關係(此圖來自互聯網):
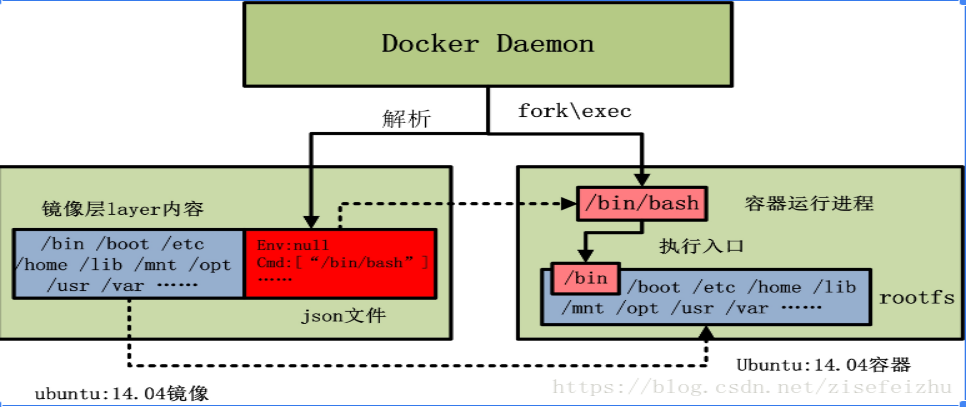
從上圖中我們可以看到,當由 ubuntu:14.04 鏡像啟動容器時,ubuntu:14.04 鏡像的鏡像層內容將作為容器的 rootfs;而 ubuntu:14.04 鏡像的 json 文件,會由 docker daemon 解析,並提取出其中的容器執行入口 CMD 資訊,以及容器進程的環境變數 ENV 資訊,最終初始化容器進程。當然,容器進程的執行入口來源於鏡像提供的 rootfs。
rootfs
rootfs 是 docker 容器在啟動時內部進程可見的文件系統,即 docker 容器的根目錄。rootfs 通常包含一個作業系統運行所需的文件系統,例如可能包含典型的類 Unix 作業系統中的目錄系統,如 /dev、/proc、/bin、/etc、/lib、/usr、/tmp 及運行 docker 容器所需的配置文件、工具等。
在傳統的 Linux 作業系統內核啟動時,首先掛載一個只讀的 rootfs,當系統檢測其完整性之後,再將其切換為讀寫模式。而在 docker 架構中,當 docker daemon 為 docker 容器掛載 rootfs 時,沿用了 Linux 內核啟動時的做法,即將 rootfs 設為只讀模式。在掛載完畢之後,利用聯合掛載(union mount)技術在已有的只讀 rootfs 上再掛載一個讀寫層。這樣,可讀寫的層處於 docker 容器文件系統的最頂層,其下可能聯合掛載了多個只讀的層,只有在 docker 容器運行過程中文件系統發生變化時,才會把變化的文件內容寫到可讀寫層,並隱藏只讀層中的舊版本文件。
2.5.1 Docker 鏡像的主要特點
為了更好的理解 docker 鏡像的結構,下面介紹一下 docker 鏡像設計上的關鍵技術。
分層
docker 鏡像是採用分層的方式構建的,每個鏡像都由一系列的 "鏡像層" 組成。分層結構是 docker 鏡像如此輕量的重要原因。當需要修改容器鏡像內的某個文件時,只對處於最上方的讀寫層進行變動,不覆寫下層已有文件系統的內容,已有文件在只讀層中的原始版本仍然存在,但會被讀寫層中的新版本所隱藏。當使用 docker commit 提交這個修改過的容器文件系統為一個新的鏡像時,保存的內容僅為最上層讀寫文件系統中被更新過的文件。分層達到了在不的容器同鏡像之間共享鏡像層的效果。
分層技術——aufs

Aufs是Another Union File System的縮寫,支援將多個目錄掛載到同一個虛擬目錄下。
已構建的鏡像會設置成只讀模式,read-write寫操作是在read-only上的一種增量操作,固不影響read-only層。
這個研究有一個好處,比如我們現在可以看到手機裡面的APP,在命令裡面都會用APP欄位下回來,在下回來之前它就是一個靜態的,我們沒有往裡面寫東西,但是我們啟動起來以後,我們就可以往裡面寫東西,進行各種各樣的操作。但是如果我們把它關掉了以後,或者刪除了以後,它的這個鏡像是存在遠端的,所以在這個鏡像裡面是不會去修改的。並且這樣也會有一個非常好的地方,這個場景非常適合我們去實現測試環境,因為我們的測試環境經常會有一個操作就是灌數據,我們可以提前把這個鏡像數據打包到測試裡面,那麼這個鏡像軟體裡面包含了,最上面是nginx,比如它裡面會有一些數據,我們可以在往上面打一層數據,打完之後把它起成一個容器就可以去測試,測試完之後這個容器裡面會生成各種各樣的數據,也就是臟數據,這樣的話,我們就可以把這個容器刪掉,刪掉以後我們鏡像裡面的容器是不會受影響的。如果說它想再創建一套,我們可以把這個鏡像再啟一個容器,就可以是一個一模一樣的,並且是一個乾淨的環境。
我們先來看一個Ubuntu系統的鏡像
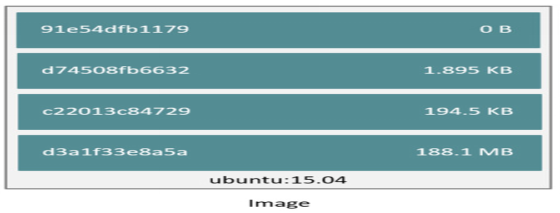
我們看見鏡像可以分層很多個layer,並且他們都有大小和ID,我們可以看到這裡有4個layer ID號,最終這個鏡像是由他們layer組合而成,並且這個鏡像它是只讀的,它不能往裡面寫數據,如果想寫數據怎麼辦呢?我們會在鏡像上啟一層contain layer,其實就是相當於把鏡像啟動成一個容器,那麼在容器這一層,我們是可寫的。
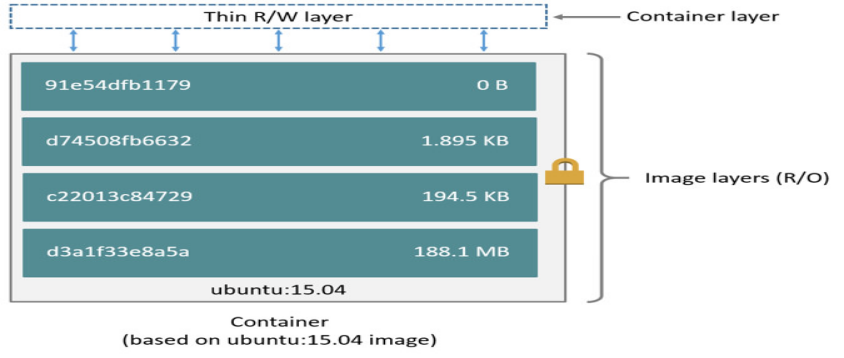
比如我們想在Ubuntu這個系統上加一層,只能在上面繼續疊加,這些工作其實都是由cow,寫字型檔下的機制來實現的。
寫時複製
docker 鏡像使用了寫時複製(copy-on-write)的策略,在多個容器之間共享鏡像,每個容器在啟動的時候並不需要單獨複製一份鏡像文件,而是將所有鏡像層以只讀的方式掛載到一個掛載點,再在上面覆蓋一個可讀寫的容器層。在未更改文件內容時,所有容器共享同一份數據,只有在 docker 容器運行過程中文件系統發生變化時,才會把變化的文件內容寫到可讀寫層,並隱藏只讀層中的老版本文件。寫時複製配合分層機制減少了鏡像對磁碟空間的佔用和容器啟動時間。
內容定址
在 docker 1.10 版本後,docker 鏡像改動較大,其中最重要的特性便是引入了內容定址存儲(content-addressable storage) 的機制,根據文件的內容來索引鏡像和鏡像層。與之前版本對每個鏡像層隨機生成一個 UUID 不同,新模型對鏡像層的內容計算校驗和,生成一個內容哈希值,並以此哈希值代替之前的 UUID 作為鏡像層的唯一標識。該機制主要提高了鏡像的安全性,並在 pull、push、load 和 save 操作後檢測數據的完整性。另外,基於內容哈希來索引鏡像層,在一定程度上減少了 ID 的衝突並且增強了鏡像層的共享。對於來自不同構建的鏡像層,主要擁有相同的內容哈希,也能被不同的鏡像共享。
聯合掛載
通俗地講,聯合掛載技術可以在一個掛載點同時掛載多個文件系統,將掛載點的原目錄與被掛載內容進行整合,使得最終可見的文件系統將會包含整合之後的各層的文件和目錄。實現這種聯合掛載技術的文件系統通常被稱為聯合文件系統(union filesystem)。以下圖所示的運行 Ubuntu:14.04 鏡像後的容器中的 aufs 文件系統為例:
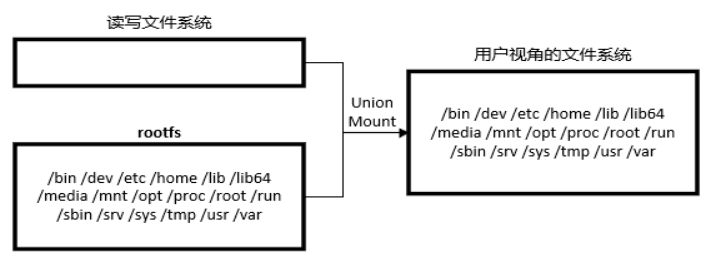
由於初始掛載時讀寫層為空,所以從用戶的角度看,該容器的文件系統與底層的 rootfs 沒有差別;然而從內核的角度看,則是顯式區分開來的兩個層次。當需要修改鏡像內的某個文件時,只對處於最上方的讀寫層進行了變動,不複寫下層已有文件系統的內容,已有文件在只讀層中的原始版本仍然存在,但會被讀寫層中的新版本文件所隱藏,當 docker commit 這個修改過的容器文件系統為一個新的鏡像時,保存的內容僅為最上層讀寫文件系統中被更新過的文件。
聯合掛載是用於將多個鏡像層的文件系統掛載到一個掛載點來實現一個統一文件系統視圖的途徑,是下層存儲驅動(aufs、overlay等) 實現分層合併的方式。所以嚴格來說,聯合掛載並不是 docker 鏡像的必需技術,比如在使用 device mapper 存儲驅動時,其實是使用了快照技術來達到分層的效果。
2.5.2 docker鏡像的存儲組織方式
綜合考慮鏡像的層級結構,以及 volume、init-layer、可讀寫層這些概念,一個完整的、在運行的容器的所有文件系統結構可以用下圖來描述:
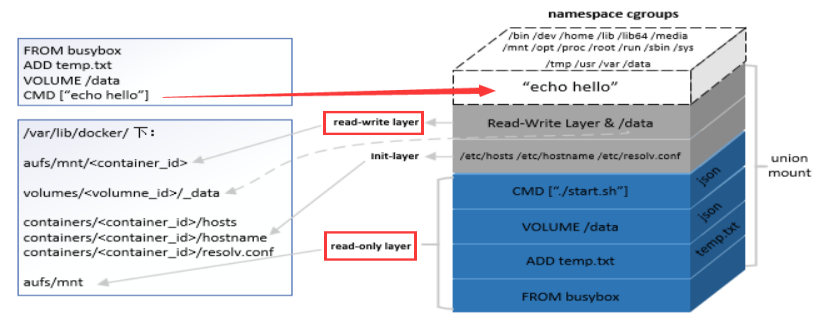
從圖中我們不難看到,除了 echo hello 進程所在的 cgroups 和 namespace 環境之外,容器文件系統其實是一個相對獨立的組織。可讀寫部分(read-write layer 以及 volumes)、init-layer、只讀層(read-only layer) 這 3 部分結構共同組成了一個容器所需的下層文件系統,它們通過聯合掛載的方式巧妙地表現為一層,使得容器進程對這些層的存在一無所知。
2.5.3 docker鏡像中的關鍵概念
registry
我們知道,每個 docker 容器都要依賴 docker 鏡像。那麼當我們第一次使用 docker run 命令啟動一個容器時,是從哪裡獲取所需的鏡像呢?
答案是,如果是第一次基於某個鏡像啟動容器,且宿主機上並不存在所需的鏡像,那麼 docker 將從 registry 中下載該鏡像並保存到宿主機。如果宿主機上存在該鏡像,則直接使用宿主機上的鏡像完成容器的啟動。
那麼 registry 是什麼呢?
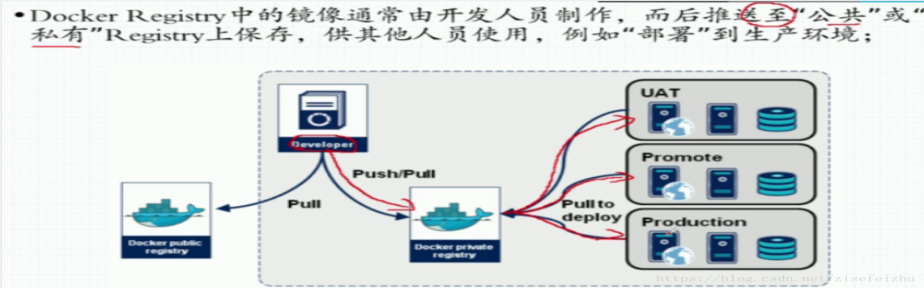
registry 用以保存 docker 鏡像,其中還包括鏡像層次結構和關於鏡像的元數據。可以將 registry 簡單的想像成類似於 Git 倉庫之類的實體。
用戶可以在自己的數據中心搭建私有的 registry,也可以使用 docker 官方的公用 registry 服務,即 Docker Hub。它是由 Docker 公司維護的一個公共鏡像庫。Docker Hub 中有兩種類型的倉庫,即用戶倉庫(user repository) 與頂層倉庫(top-level repository)。用戶倉庫由普通的 Docker Hub 用戶創建,頂層倉庫則由 Docker 公司負責維護,提供官方版本鏡像。理論上,頂層倉庫中的鏡像經過 Docker 公司驗證,被認為是架構良好且安全的。
分類:
Sponsor Registry: 第三方的registry,供客戶和Docker社區使用
Mirror Registry: 第三方的registry,只讓客戶使用
Vendor Registry: 由發布Docker鏡像的供應商提供的registry
Private Registry: 通過設有防火牆和額外的安全層的私有實體提供的registry
repository
repository 由具有某個功能的 docker 鏡像的所有迭代版本構成的鏡像組。Registry 由一系列經過命名的 repository 組成,repository 通過命名規範對用戶倉庫和頂層倉庫進行組織。所謂的頂層倉庫,其其名稱只包含倉庫名,如:
而用戶倉庫的表示類似下面:

可以看出,用戶倉庫的名稱多了 "用戶名/" 部分。
比較容易讓人困惑的地方在於,我們經常把 mysql 視為鏡像的名稱,其實 mysql 是 repository 的名稱。repository 是一個鏡像的集合,其中包含了多個不同版本的鏡像,這些鏡像之間使用標籤進行版本區分,如 mysql:5.6、mysql:5.7 等,它們均屬於 mysql 這個 repository。
簡單來說,registry 是 repository 的集合,repository 是鏡像的集合。
manifest
manifest(描述文件)主要存在於 registry 中作為 docker 鏡像的元數據文件,在 pull、push、save 和 load 過程中作為鏡像結構和基礎資訊的描述文件。在鏡像被 pull 或者 load 到 docker 宿主機時,manifest 被轉化為本地的鏡像配置文件 config。在我們拉取鏡像時顯示的摘要(Digest):就是對鏡像的 manifest 內容計算 sha256sum 得到的。
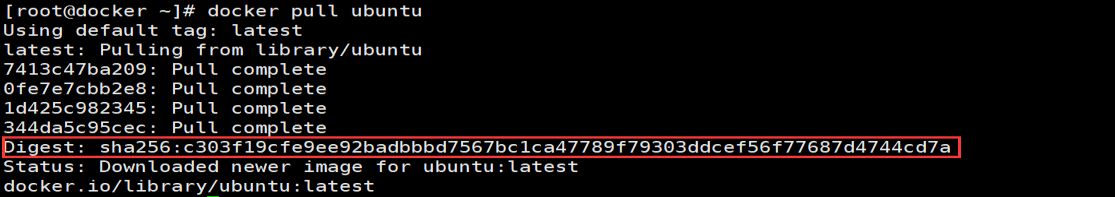
image 和 layer
docker 內部的 image 概念是用來存儲一組鏡像相關的元數據資訊,主要包括鏡像的架構(如 amd64)、鏡像默認配置資訊、構建鏡像的容器配置資訊、包含所有鏡像層資訊的 rootfs。docker 利用 rootfs 中的 diff_id 計算出內容定址的索引(chainID) 來獲取 layer 相關資訊,進而獲取每一個鏡像層的文件內容。
layer(鏡像層) 是 docker 用來管理鏡像層的一個中間概念。我們前面提到,鏡像是由鏡像層組成的,而單個鏡像層可能被多個鏡像共享,所以 docker 將 layer 與 image 的概念分離。docker 鏡像管理中的 layer 主要存放了鏡像層的 diff_id、size、cache-id 和 parent 等內容,實際的文件內容則是由存儲驅動來管理,並可以通過 cache-id 在本地索引到。
2.5.4 獲取docker鏡像的方法
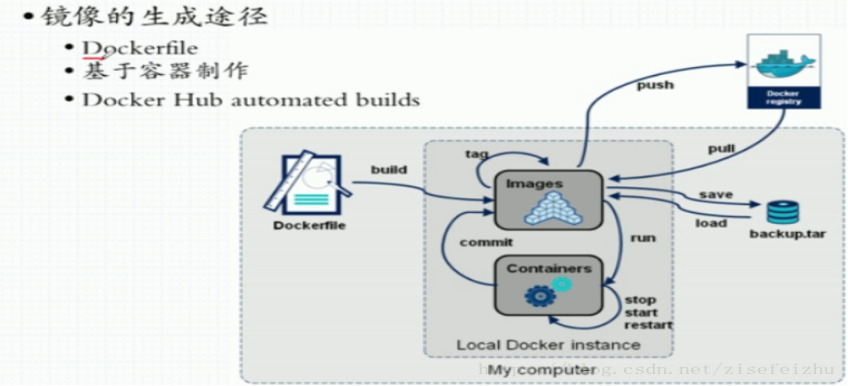
docker.hub
現在docker官方公有倉庫裡面有大量的鏡像,所以最基礎的鏡像,我們可以在公有倉庫直接拉取,因為這些鏡像都是原廠維護,可以得到及時的更新和修護。
Dockerfile:
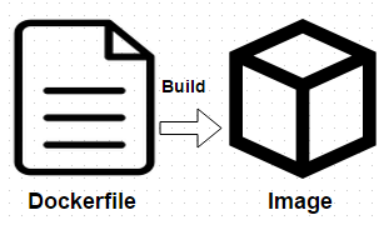
我們如果想去訂製這些鏡像,我們可以去編寫Dockerfile,然後重新bulid,最後把它打包成一個鏡像,這種方式是最為推薦的方式包括我們以後去企業當中去實踐應用的時候也是推薦這種方式。
Commit :
當然還有另外一種方式,就是通過鏡像啟動一個容器,然後進行操作,最終通過commit這個命令commit一個鏡像,但是不推薦這種方式,雖然說通過commit這個命令像是操作虛擬機的模式,但是容器畢竟是容器,它不是虛擬機,所以大家還是要去適應用Dockerfile去訂製這些鏡像這種習慣。
[root@docker ~]# docker commit --help Usage: docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] Create a new image from a container's changes Options: -a, --author string Author (e.g., "John Hannibal Smith <[email protected]>") -c, --change list Apply Dockerfile instruction to the created image -m, --message string Commit message -p, --pause Pause container during commit (default true)
2.5.5 鏡像的一個例子詳解
#從默認倉庫拉取buxybox鏡像,默認為docker.hub [root@docker ~]# docker pull buxybox #查看主機現有鏡像 [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE busybox latest db8ee88ad75f 13 days ago 1.22MB #用buxybox鏡像啟動一個名稱為b1的容器 [root@docker ~]# docker run --name b1 -it busybox / # ls / bin dev etc home proc root sys tmp usr var #在b1容器中創先一個index.html / # mkdir -p /data/html / # vi /data/html/index.html / # cat /data/html/index.html #ctrl+p+q退出容器不關閉 <h1> Busybox httpd server. </h1> / # [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 7b030688d7c6 busybox "sh" About a minute ago Up About a minute b1 #利用b1容器創建新鏡像 [root@docker ~]# docker commit -p b1 sha256:470b5b0a5f15cf5270634f4ae53c227592114e45eeba925468f662f710b26a12 #因為在用commit創建鏡像時未指明鏡像名稱,所以為none [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE <none> <none> 470b5b0a5f15 14 seconds ago 1.22MB busybox latest db8ee88ad75f 13 days ago 1.22MB #給鏡像打標籤,類似與硬連接。 [root@docker ~]# docker tag 470b5b0a5f15 zisefeizhu/httpd:v0.1-1 [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE zisefeizhu/httpd v0.1-1 470b5b0a5f15 About a minute ago 1.22MB busybox latest db8ee88ad75f 13 days ago 1.22MB [root@docker ~]# docker tag zisefeizhu/httpd:v0.1-1 zhujingxing/httpd:latest [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE zhujingxing/httpd latest 470b5b0a5f15 2 minutes ago 1.22MB zisefeizhu/httpd v0.1-1 470b5b0a5f15 2 minutes ago 1.22MB busybox latest db8ee88ad75f 13 days ago 1.22MB #刪除鏡像類似於刪除硬鏈接。關於文件的刪除原理在此不聲明,必須要懂! [root@docker ~]# docker image rm zisefeizhu/httpd:v0.1-1 Untagged: zisefeizhu/httpd:v0.1-1 #獲取鏡像源/容器數據,json 格式 [root@docker ~]# docker inspect -f '{{.ContainerConfig.Cmd}}' busybox [/bin/sh -c #(nop) CMD ["sh"]] [root@docker ~]# docker inspect -f '{{.ContainerConfig.Cmd}}' zhujingxing/httpd:latest [sh] [root@docker ~]# docker run -it --name t1 zhujingxing/httpd:latest / # ls / bin data dev etc home proc root sys tmp usr var / # cat /data/html/index.html <h1> Busybox httpd server. </h1> / # [root@docker ~]# [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 7cf93b2d56be zhujingxing/httpd:latest "sh" 6 minutes ago Up 6 minutes t1 7b030688d7c6 busybox "sh" 22 minutes ago Up 22 minutes b1 [root@docker ~]# docker commit -a "zisefeizhu <[email protected]>" -c 'CMD ["/bin/httpd","-f","-h","/data/html"]' -p b1 zisefeizhu/httpd:v0.2 sha256:9f0e2f6192bf72cb2230e9654d92985bbbd77a800f749a58fa72e496dd28f452 [root@docker ~]# docker run --name t2 zisefeizhu/httpd:v0.2 前台運行 卡住 另開一個窗口 [root@docker ~]# docker container ls CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES a39c73488430 zisefeizhu/httpd:v0.2 "/bin/httpd -f -h /d…" 12 seconds ago Up 11 seconds t2 7cf93b2d56be zhujingxing/httpd:latest "sh" 9 minutes ago Up 9 minutes t1 7b030688d7c6 busybox "sh" 25 minutes ago Up 25 minutes b1 [root@docker ~]# docker inspect -f '{{.Config.Cmd}}' t2 [/bin/httpd -f -h /data/html] [root@docker ~]# docker inspect -f '{{.NetworkSettings.IPAddress}}' t2 172.17.0.4 [root@docker ~]# curl 172.17.0.4 <h1> Busybox httpd server. </h1>
2.5.6 共享存儲
註:我建議還是自建倉庫harbor,所以這部分,在此不提,後面講“docker 倉庫”會重點介紹harbor。有興趣的同道可以看此篇博文:https://blog.csdn.net/zisefeizhu/article/details/83378322
2.6 docker容器網路
在開始的時候就有提過,現在的linux內核已經支援六種名稱空間:
UTS:主機名和域名
USER:用戶
Mount:掛載文件系統
IPC:進程間通訊
Pid:進程id
Net:網路
網路作為docker容器化實現的6個名稱空間的其中之一,是必不可少的。其在Linux內核2.6時已經被載入進內核支援了。
網路名稱空間主要用於實現網路設備和協議棧的隔離。
2.6.1 理解網路虛擬化
網路虛擬化相對計算、存儲虛擬化來說是比較抽象的,以我們在學校書本上學的那點網路知識來理解網路虛擬化可能是不夠的。
在我們的印象中,網路就是由各種網路設備(如交換機、路由器)相連組成的一個網狀結構,世界上的任何兩個人都可以通過網路建立起連接。
帶著這樣一種思路去理解網路虛擬化可能會感覺雲里霧裡——這樣一個龐大的網路如何實現虛擬化?
其實,網路虛擬化更多關注的是數據中心網路、主機網路這樣比較「細粒度」的網路,所謂細粒度,是相對來說的,是深入到某一台物理主機之上的網路結構來談的。
如果把傳統的網路看作「宏觀網路」的話,那網路虛擬化關注的就是「微觀網路」。網路虛擬化的目的,是要節省物理主機的網卡設備資源。從資源這個角度去理解,可能會比較好理解一點。
2.6.2 傳統網路架構
在傳統網路環境中,一台物理主機包含一個或多個網卡(NIC),要實現與其他物理主機之間的通訊,需要通過自身的 NIC 連接到外部的網路設施,如交換機上,如下圖所示。

這種架構下,為了對應用進行隔離,往往是將一個應用部署在一台物理設備上,這樣會存在兩個問題
1)是某些應用大部分情況可能處於空閑狀態
2)是當應用增多的時候,只能通過增加物理設備來解決擴展性問題。不管怎麼樣,這種架構都會對物理資源造成極大的浪費。
2.6.3 虛擬化網路架構
為了解決這個問題,可以藉助虛擬化技術對一台物理資源進行抽象,將一張物理網卡虛擬成多張虛擬網卡(vNIC),通過虛擬機來隔離不同的應用。
這樣對於上面的問題
針對問題 1),可以利用虛擬化層 Hypervisor (系統管理程式)的調度技術,將資源從空閑的應用上調度到繁忙的應用上,達到資源的合理利用;
針對問題 2),可以根據物理設備的資源使用情況進行橫向擴容,除非設備資源已經用盡,否則沒有必要新增設備。
這種架構如下所示:
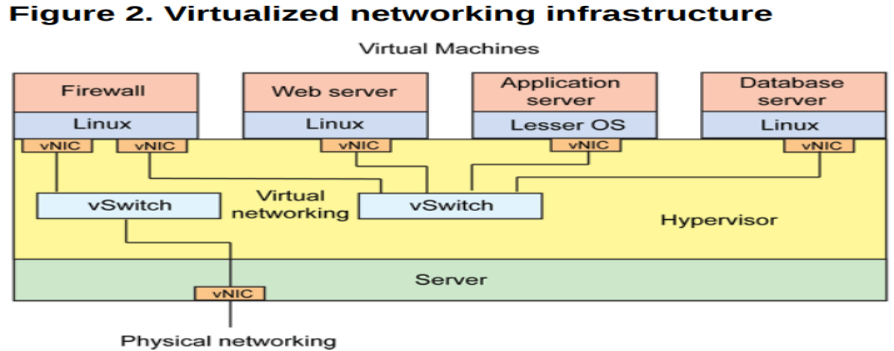
其中虛擬機與虛擬機之間的通訊,由虛擬交換機完成,虛擬網卡和虛擬交換機之間的鏈路也是虛擬的鏈路,整個主機內部構成了一個虛擬的網路,如果虛擬機之間涉及到三層的網路包轉發,則又由另外一個角色——虛擬路由器來完成。
一般,這一整套虛擬網路的模組都可以獨立出去,由第三方來完成,如其中比較出名的一個解決方案就是 Open vSwitch(OVS)。
OVS 的優勢在於它基於 SDN 的設計原則,方便虛擬機集群的控制與管理,另外就是它分散式的特性,可以「透明」地實現跨主機之間的虛擬機通訊。
如下是跨主機啟用 OVS 通訊的:
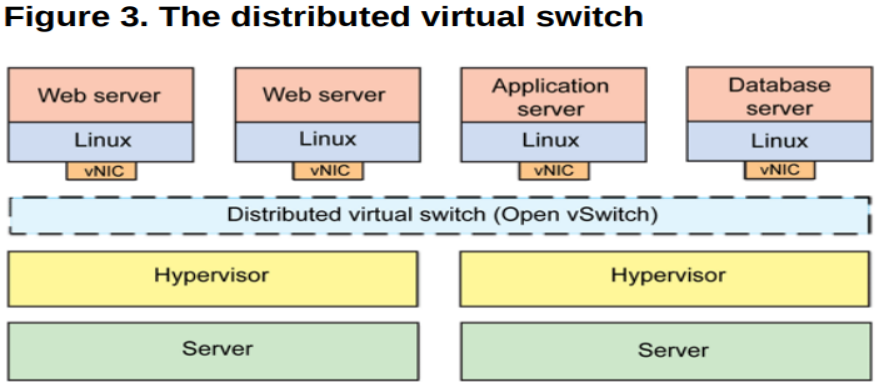
總結下來,網路虛擬化主要解決的是虛擬機構成的網路通訊問題,完成的是各種網路設備的虛擬化,如網卡、交換設備、路由設備等。
2.6.4 linux下網路設備虛擬化的幾種形式
為了完成虛擬機在同主機和跨主機之間的通訊,需要藉助某種“橋樑”來完成用戶態到內核態(Guest 到 Host)的數據傳輸,這種橋樑的角色就是由虛擬的網路設備來完成,上面介紹了一個第三方的開源方案——OVS,它其實是一個融合了各種虛擬網路設備的集大成者,是一個產品級的解決方案。
但 Linux 本身由於虛擬化技術的演進,也集成了一些虛擬網路設備的解決方案,主要有以下幾種:
TAP/TUN/VETH
TAP/TUN 是 Linux 內核實現的一對虛擬網路設備,TAP 工作在二層,TUN 工作在三層。Linux 內核通過 TAP/TUN 設備向綁定該設備的用戶空間程式發送數據,反之,用戶空間程式也可以像操作物理網路設備那樣,向 TAP/TUN 設備發送數據。
基於 TAP 驅動,即可實現虛擬機 vNIC 的功能,虛擬機的每個 vNIC 都與一個 TAP 設備相連,vNIC 之於 TAP 就如同 NIC 之於 eth。
當一個 TAP 設備被創建時,在 Linux 設備文件目錄下會生成一個對應的字元設備文件,用戶程式可以像打開一個普通文件一樣對這個文件進行讀寫。
比如,當對這個 TAP 文件執行 write 操作時,相當於 TAP 設備收到了數據,並請求內核接受它,內核收到數據後將根據網路配置進行後續處理,處理過程類似於普通物理網卡從外界收到數據。當用戶程式執行 read 請求時,相當於向內核查詢 TAP 設備是否有數據要發送,有的話則發送,從而完成 TAP 設備的數據發送。
TUN 則屬於網路中三層的概念,數據收發過程和 TAP 是類似的,只不過它要指定一段 IPv4 地址或 IPv6 地址,並描述其相關的配置資訊,其數據處理過程也是類似於普通物理網卡收到三層 IP 報文數據。
VETH 設備總是成對出現,一端連著內核協議棧,另一端連著另一個設備,一個設備收到內核發送的數據後,會發送到另一個設備上去,這種設備通常用於容器中兩個 namespace 之間的通訊。
Bridge
Bridge 也是 Linux 內核實現的一個工作在二層的虛擬網路設備,但不同於 TAP/TUN 這種單埠的設備,Bridge 實現為多埠,本質上是一個虛擬交換機,具備和物理交換機類似的功能。
Bridge 可以綁定其他 Linux 網路設備作為從設備,並將這些從設備虛擬化為埠,當一個從設備被綁定到 Bridge 上時,就相當於真實網路中的交換機埠上插入了一根連有終端的網線。
如下圖所示,Bridge 設備 br0 綁定了實際設備 eth0 和 虛擬設備 tap0/tap1,當這些從設備接收到數據時,會發送給 br0 ,br0 會根據 MAC 地址與埠的映射關係進行轉發。
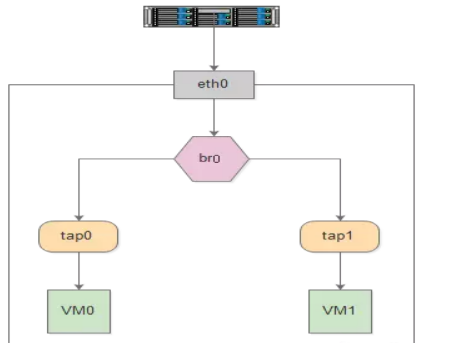
因為 Bridge 工作在二層,所以綁定到它上面的從設備 eth0、tap0、tap1 均不需要設 IP,但是需要為 br0 設置 IP,因為對於上層路由器來說,這些設備位於同一個子網,需要一個統一的 IP 將其加入路由表中。
這裡有人可能會有疑問,Bridge 不是工作在二層嗎,為什麼會有 IP 的說法?其實 Bridge 雖然工作在二層,但它只是 Linux 網路設備抽象的一種,能設 IP 也不足為奇。
對於實際設備 eth0 來說,本來它是有自己的 IP 的,但是綁定到 br0 之後,其 IP 就生效了,就和 br0 共享一個 IP 網段了,在設路由表的時候,就需要將 br0 設為目標網段的地址。
2.6.5 跨主機docker容器通訊方案介紹
NET:網路名稱空間
描述:主要是網路設備、協議棧等實現,假設物理機上有四塊網卡,需要創建兩個名稱空間,這些設備可以單獨關聯給某個空間所使用的,如第一個網卡分配給第一個名稱空間使用,其他就看不見這個設備了,一個設備一般只能授予一個空間,同樣有四個網卡就可以使用四個名稱空間,使得每個名稱空間都可以配置IP地址與外界進行通訊。
如果名稱空間的數量超過物理網卡數量,每個名稱空間內部的進程也是需要通過網路進行通訊,應該如何上報,可以使用模擬技術,linux設備支援兩種內核級的模擬,是二層設備和三層設備,網卡就是一個二層設備,工作在鏈路層,能夠封裝報文實現各設備之間報文轉發的實現,這功能是完全可以在Linux之上利用內核中對二層虛擬設備的支援,創建虛擬網卡介面,而且這種虛擬網卡介面很獨特,每個網路介面設備是成對出現的,可以模擬為一根網線的兩頭,其中一頭可以插在主機之上,另一頭插在交換機之上進行模擬,相當於一個主機連接到交換機上去了,而linux內核源生就支援模擬二層網路設備,使用軟體來構建一個交換機。
如果有兩個名稱空間,那麼兩台主機就像連接到同一個交換機上進行通訊,如果配置的網路地址在同一個網段就可以直接進行通訊了。這就是虛擬化的網路。
OVS: OpenVSwitch 可以模擬高級的網路技術,二層交換,甚至三層網路設備,vlan,,不屬於Linux內核組件,要額外安裝,由cisco眾多公司所構建的,有雲計算的浪潮下,構建網路是比較複雜的,然後才是網路之上所承載的主機,才能通訊,這個網路虛擬化所實現的功能,需要軟體硬體結合起來實現,而且把傳統意義上的網路平面,控制平面,傳輸平面等,隔離開來,集中到一個設備之上實現全局的調度,實現SDN,軟體定義網路。
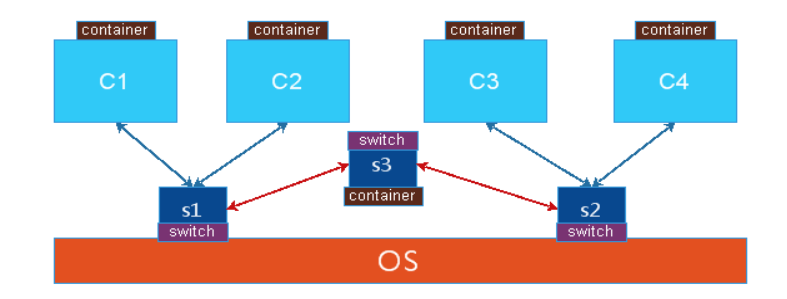
單節點上容器通訊:同一個物理機上的兩個容器,或者兩個名稱空間要通訊,就是在主機上建立一個虛擬的交換機,讓兩個容器各自使用純軟體的方式,建一對虛擬網卡,一半在交換機上,一半在容器上,從而實現單節點上容器進行通訊,但是也有比較複雜的情況,有可能會出現有兩個軟交換機的情況,連接不同的容器,這時兩個軟交換機要連接,需要再做一塊網卡,一頭在交換機1上,另一頭在交換機2之上,如果不同交換機之間要實現路由轉發,就需要在兩能交換機上加一台路由器,linux內核自身可以當作路由器來使用,打開轉發或者使用iptables規則,但是路由器是一個三層的設備,在linux內核直接使用一個單獨的名稱空間就可以實現,就是再做一個容器當作路由器來使用,但是要模擬出網卡來讓它們建立關聯關係。
多節點:另一台主機上的一個容器,與1號主機上的容器進行通訊,vmware實現不同主機上的虛擬機之間的通訊可以使用橋接的方式,就是把物理網卡當作交換機來使用,所有一台主機上的容器都到一個物理網卡來,通過MAC地址來確定交給那個容器,如果是到物理機的,就給物理機,也就是虛擬機里也有自身的獨特的MAC地址,所以數據包來時可以區別各個設備,把物理網卡當作交換機來使用,把報文轉發給各容器,如果報文目標是物理網卡時,需要虛擬出一個軟網卡作為物理網卡的使用,這樣就沒有虛擬交換機概念,所以兩台主機上的虛擬機要使用橋接通訊時,都是連接到各自主機上的物理網卡的的。但是這種通訊方式要實現有很大的代價,因為所有容器的橋接都在同一個平面中,很容易產生風暴,所以在大規模的虛擬機或容器的使用場景中使用橋接不太好,除非能隔離得很好(橋接)。
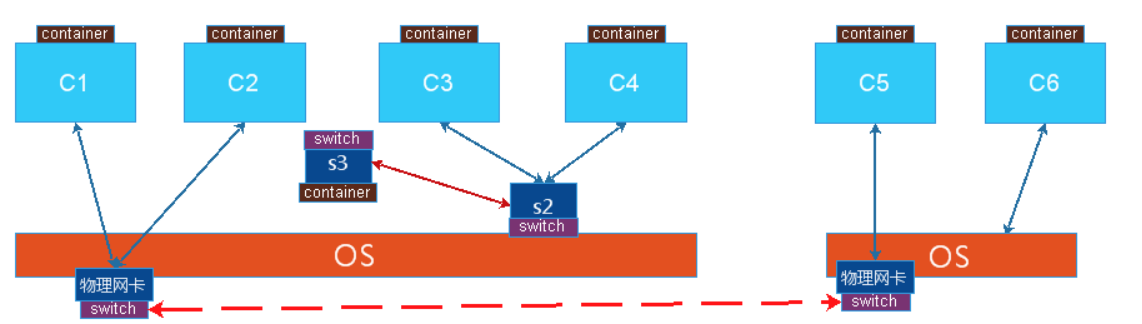
Nat技術:如圖中C3與C6通訊,C3是虛擬網卡,C3網卡與物理網卡物理地址不在同一個網段中,C3把網關指向S2,把S3當作宿主機的一個網卡來使用,IP地址與C3在同一個網段,把C3的網關指向S2,然後在物理機上打開核心轉發功能,所以當C3與C6通訊時,先轉給s2,再到達內核,內核判定查路由列不是自己要到另一個主機上的C6,這時報文回不來,因為C3和C4是一個私有地址,如果要報文能夠回來,最後到報文送走物理機之前,要把源IP地址修改成物理網卡的IP地址,這樣C5或者C6回復物理主機的IP就可以了,通過NAT表的查詢是C3的訪問,就把報文送給C3,這就使用NAT實現跨主機之間的通訊,但是這裡有一個很大的問題,C6也可能是NAT的模式下工作,也就是說它也是使用私有地址的,如果C6要被訪問只能把它暴露出去,在物理機的能外網卡上明確說明某個埠是提供服務的,如果要C4能夠訪問C6,就要先訪問C6所在的宿主機的物理地址,再使用H2做dnat發給C6,但是C4發送報文時是通過SNAT出來的,C4也是隱藏在NAT背後的,發出去的報文要其他的主機可以響應就應該改寫源地址。所以在跨服務主機實現兩個虛擬機之間的通訊要實現兩級的NAT操作,從C4到C6,首先C4出去就SNAT,到到C6要使用到DNAT,這樣的效率不會高,但是網路比較容易管理。
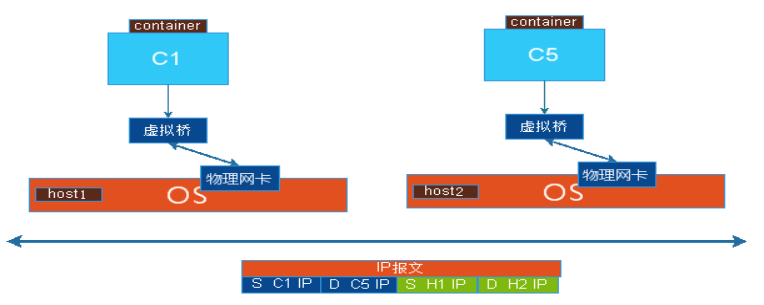
Overlay Network: 疊加網路,是NAT和橋接的一個解決方案,有多個物理主機,在虛擬機上做一個虛擬的橋,讓各虛擬機連接到虛擬橋上,通訊時借用物理網路來完成報文的隧道轉發,從而實現C1可以直接看見C5或C6,物理主機本來就是使用物理網路連接在一起的,C1與物理網路不在同一個地址段內,但是C1與C5是在同一地址段內的,C1發送報文時,先發送給虛擬機,假設它是知道C5是不要本地的物理主機上的,以是報文要從物理網卡發送出去,但是要做隧道轉發,也就是C1的報文源IP地址是C1,目標地址是C5,然後再封裝一個IP包頭的首部源地址是C1所在物理主機的IP地址,目標地址是C5所在物理主機的IP地址,當報文送到C5所在的物理機,把報文拆完第一層後,第二層的目標地址就是C5的,就直接交給本地的軟交換機,再交給C5,C1與C5之間的通訊直接源地址和目標地址就是各自雙方,但是它寄於別的網路,本地自身就是一個三層的網路,應該封裝二層,但是沒有封裝,又封裝三層四層報文,就是一個TCP或者UDP的首部,再封裝一個首部實現一個兩級的三層封裝,從而完成報文的轉發
2.6.5.1 其他方案
基於實現方式的分類
隧道方案(Overlay Networking):
Weave:UDP廣播,本機建立新的BR,通過PCAP互通。
Open vSwitch(OVS):基於VxLAN和GRE協議,但是性能方面損失比較嚴重。
Flannel:UDP廣播,VxLan。
路由方案:
Calico:基於BGP協議的路由方案,支援很細緻的ACL控制,對混合雲親和度比較高。
Macvlan:從邏輯和Kernel層來看隔離性和性能最優的方案,基於二層隔離,所以需要二層路由器支援,大多數雲服務商不支援,所以混合雲上比較難以實現。
基於網路模型分類
Docker Libnetwork Container Network Model(CNM):
Docker Swarm overlay
Macvlan & IP network drivers
Calico
Contiv(from Cisco)
#Docker Libnetwork的優勢就是原生,而且和Docker容器生命周期結合緊密;缺點也可以理解為是原生,被Docker“綁架”。
Container Network Interface(CNI):
Kubernetes
Weave
Macvlan
Flannel
Calico
Contiv
Mesos CNI
#CNI的優勢是兼容其他容器技術(e.g. rkt)及上層編排系統(Kuberneres & Mesos),而且社區活躍勢頭迅猛,Kubernetes加上CoreOS主推;缺點是非Docker原生。
詳解:
以Flannel方案為例
Flannel之前的名字是Rudder,它是由CoreOS團隊針對Kubernetes設計的一個重載網路工具,它的主要思路是:預先留出一個網段,每個主機使用其中一部分,然後每個容器被分配不同的ip;讓所有的容器認為大家在同一個直連的網路,底層通過UDP/VxLAN等進行報文的封裝和轉發
下面這張是Flannel網路的經典架構圖:

- 容器直接使用目標容器的ip訪問,默認通過容器內部的eth0發送出去。
- 報文通過veth pair被發送到vethXXX。
- vethXXX是直接連接到虛擬交換機docker0的,報文通過虛擬bridge docker0發送出去。
- 查找路由表,外部容器ip的報文都會轉發到flannel0虛擬網卡,這是一個P2P的虛擬網卡,然後報文就被轉發到監聽在另一端的flanneld。
- flanneld通過etcd維護了各個節點之間的路由表,把原來的報文UDP封裝一層,通過配置的iface發送出去。
- 報文通過主機之間的網路找到目標主機。
- 報文繼續往上,到傳輸層,交給監聽在8285埠的flanneld程式處理。
- 數據被解包,然後發送給flannel0虛擬網卡。
- 查找路由表,發現對應容器的報文要交給docker0。
- docker0找到連到自己的容器,把報文發送過去
關於docker網路解決方案,強烈建議參考“散盡浮華”前輩的博文:https://www.cnblogs.com/kevingrace/category/839227.html
註:關於“散盡浮華”前輩,我有必要說一下:此乃我IT路上的良師和精神支柱!
關於docker網路解決方案,我本人更推薦使用calico方案。關於calico 網路插件會在kubernetes章節重點闡述
docker 網路是深入學習docker的重點、難點,強烈建議:一定要耐著性子深入學習這部分。
2.6.6 單機網路
[root@docker ~]# docker network ls  NETWORK ID          NAME                DRIVER              SCOPE  1fbc952b8c69        bridge              bridge              local  48cf42c3b371        host                host                local  4c1006be1ea1        none                null                local
  bridge:默認網路驅動程式。當你的應用程式在需要通訊的獨立容器中運行時,通常會使用橋接網路。  host:對於獨立容器,刪除容器和Docker主機之間的網路隔離,並直接使用主機的網路。  none:對於此容器,禁用所有網路。  container: Container 網路模式是 Docker 中一種較為特別的網路的模式。處於這個模式下的 Docker 容器會共享其他容器的網路環境,因此,至少這兩個容器之間不存在網路隔離,而這兩個容器又與宿主機以及除此之外其他的容器存在網路隔離。
bridge 模式【默認網路模式】
橋接時網路,並不是物理橋,在本機上創建一個純粹的軟交換機docker0,也可以當作網卡來使用,每啟動一個容器就可以給容器分配一段網卡的地址,一半在容器上,一半在docker0橋上,veth176661b這種在機器可以看到的無論容器還是KVM時,每次創建網卡時,都是創建一對的,一半放在虛擬機上,一半放在軟交換機上,相當於一根網線連接著兩個設備一樣。
bridge網路的特點
使用一個 linux bridge,默認為 docker0
使用veth 對,一頭在容器的網路 namespace中,一頭在docker0上
該模式下Docker Container不具有一個公有IP,因為宿主機的IP地址與veth pair的IP地址不在同一個網段內
Docker採用NAT方式,將容器內部的服務監聽的埠與宿主機的某一個埠進行“綁定”,使得宿主機以外的世界可以主動將網路報文發送至容器內部
外界訪問容器內的服務時,需要訪問宿主機的 IP 以及宿主機的埠 port
NAT 模式由於是在三層網路上的實現手段,故肯定會影響網路的傳輸效率。
容器擁有獨立、隔離的網路棧;讓容器和宿主機以外的世界通過NAT建立通訊
#當前運行有三個容器 [root@docker ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES a39c73488430 zisefeizhu/httpd:v0.2 "/bin/httpd -f -h /d…" 27 hours ago Up 27 hours t2 7cf93b2d56be zhujingxing/httpd:latest "sh" 27 hours ago Up 27 hours t1 7b030688d7c6 busybox "sh" 27 hours ago Up 27 hours b1 #因為啟動了三個容器,所以生成了三個虛擬IP,同時這三個虛擬IP都是插在docker0橋上的 [root@docker ~]# ifconfig docker0: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 inet 172.17.0.1 netmask 255.255.0.0 broadcast 172.17.255.255 ...... veth0a020f8: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 ...... veth74be495: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 ...... veth99cb539: flags=4163<UP,BROADCAST,RUNNING,MULTICAST> mtu 1500 [root@docker ~]# brctl show bridge name bridge id STP enabled interfaces docker0 8000.0242dcbf397a no veth0a020f8 veth74be495 veth99cb539 #查看網卡之間的連接關係、紅色為容器內部網卡 [root@docker ~]# ip link show 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP mode DEFAULT group default qlen 1000 link/ether 00:0c:29:da:d7:53 brd ff:ff:ff:ff:ff:ff 3: docker0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP mode DEFAULT group default link/ether 02:42:dc:bf:39:7a brd ff:ff:ff:ff:ff:ff 5: veth99cb539@if4: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue master docker0 state UP mode DEFAULT group default link/ether 42:07:17:86:75:3b brd ff:ff:ff:ff:ff:ff link-netnsid 0 7: veth0a020f8@if6: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue master docker0 state UP mode DEFAULT group default link/ether 3a:de:33:6e:cc:ff brd ff:ff:ff:ff:ff:ff link-netnsid 1 9: veth74be495@if8: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue master docker0 state UP mode DEFAULT group default link/ether 3e:02:4d:e7:34:e5 brd ff:ff:ff:ff:ff:ff link-netnsid 2 #進入容器t2 [root@docker ~]# docker exec -it t2 sh / # ifconfig eth0 Link encap:Ethernet HWaddr 02:42:AC:11:00:04 inet addr:172.17.0.4 Bcast:172.17.255.255 Mask:255.255.0.0 #Nat橋:docker創建時默認就是nat橋,是使用Iptables來實現的 [root@docker ~]# iptables -t nat -vnL Chain PREROUTING (policy ACCEPT 231 packets, 28675 bytes) pkts bytes target prot opt in out source destination 5 260 DOCKER all -- * * 0.0.0.0/0 0.0.0.0/0 ADDRTYPE match dst-type LOCAL Chain INPUT (policy ACCEPT 231 packets, 28675 bytes) pkts bytes target prot opt in out source destination Chain OUTPUT (policy ACCEPT 611 packets, 45623 bytes) pkts bytes target prot opt in out source destination 0 0 DOCKER all -- * * 0.0.0.0/0 !127.0.0.0/8 ADDRTYPE match dst-type LOCAL Chain POSTROUTING (policy ACCEPT 611 packets, 45623 bytes) pkts bytes target prot opt in out source destination 0 0 MASQUERADE all -- * !docker0 172.17.0.0/16 0.0.0.0/0 in: 從使用介面進來,只要不出docker0出去,源地址來自於172.17.0.0/16的,無論到達任何主機0.0.0.0/0,都要做地址偽裝MASQUERADE,相當於SNAT,而且是自動實現SNAT,也就是自動選擇一個最合適物理地址當作源地址,所以docker0橋默認就是nat橋 Chain DOCKER (2 references) pkts bytes target prot opt in out source destination 0 0 RETURN all -- docker0 * 0.0.0.0/0 0.0.0.0/0 #創建bridge容器 [root@docker ~]# docker run --name t3 -it --rm busybox:latest / # ifconfig eth0 Link encap:Ethernet HWaddr 02:42:AC:11:00:05 inet addr:172.17.0.5 Bcast:172.17.255.255 Mask:255.255.0.0 ...... / # exit [root@docker ~]# docker run --name t3 -it --network bridge --rm busybox:latest / # ifconfig eth0 Link encap:Ethernet HWaddr 02:42:AC:11:00:05 inet addr:172.17.0.5 Bcast:172.17.255.255 Mask:255.255.0.0 ...... 容器中網路通訊情況
同一個宿主機中,使用同一個docker0中的軟交換機進行通訊。
/ # netstat -lnt Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State tcp 0 0 :::80 :::* LISTEN #容器內訪問 / # wget -O - -q http://172.17.0.4 <h1> Busybox httpd server. </h1> #宿主機訪問 [root@docker ~]# curl http://172.17.0.4 <h1> Busybox httpd server. </h1> 跨主機通訊
在同一個宿方機之間的容器通訊可以實現,但是跨主機就會產生問題,因為docker本身就是一個nat bridge,對外來說是不可見的,要實現不同主機之間的容器的實現通訊,就要做dnat,把介面中發布出來的,假設物理主機上有一個物理網卡,開通一個埠然後提供對外服務,外部主機訪問容器中的服務時,使用dnat的方式轉到容器中的虛擬網卡中,提供服務。
但是存在一個問,如果在同一台宿主機上,起了兩個容器分別是兩個nginx的web服務,但是對外的IP只有一個,只能使用埠來區分,假設nginx1使用80,另一個nginx2就只能使用非80的埠,這時client訪問的出現問題,因為默認訪問就要給80,如果是非80埠就請求不到。
如查使用ovetlay network疊加網路方式就可以直接使用隧道來承載,直接訪問就可以了,可以不用對地址進行映射。一般的跨主機之間的虛擬機訪問方式橋接、nat的。
容器特殊功能,在容器內部有6個隔離的名稱空間,user,mount,pid,uts,net,ipc,每個容器都有自身獨立的資源,假設讓每個容器都有隔離而獨立的user,mount,pid,而uts,net,ipc這三個資源是共享使用的,擁有同一個網卡,同一組網路協議棧,有同一個主機名和域名,對外使用同一個IP地址,優點是如第一個容器使用的tomcat服務,第二個容器的是redis服務時,如果tomcat要訪問redis中的數據時,是同一個協議棧,之前如果是隔離的,通過127來訪問是不可以的,實現有自己獨立隔離的名稱空間,卻又共享一部分名稱空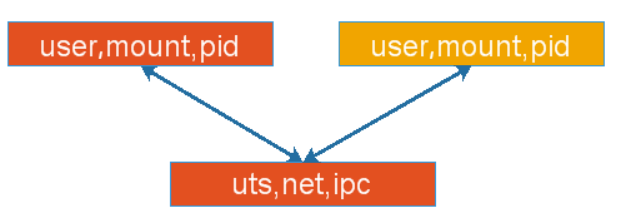
host 模式
Host模式並沒有為容器創建一個隔離的網路環境。該模式下的Docker容器會和host宿主機共享同一個網路namespace,所以容器可以和宿 主機一樣,使用宿主機的eth0,實現和外界的通訊。
host 網路特點
這種模式下的容器沒有隔離的network namespace
容器的IP地址同 Docker主機的IP地址
需要注意容器中服務的埠號不能與Docker主機上已經使用的埠號相衝突
host模式能夠和其它模式共存
[root@docker ~]# docker run --name b2 --network host -it --rm busybox / # ifconfig docker0 Link encap:Ethernet HWaddr 02:42:DC:BF:39:7A inet addr:172.17.0.1 Bcast:172.17.255.255 Mask:255.255.0.0 ...... / # echo "live zhujingxing" > /tmp/index.html / # httpd -h /tmp/ / # netstat -nat | grep 80 tcp 0 0 :::80 :::* LISTEN [root@docker ~]# netstat -ant | grep 80 tcp6 0 0 :::80 :::* LISTEN 
none 模式
網路模式為 none,即不為Docker容器構造任何網路環境,不會為容器創建網路介面,一旦Docker容器採用了none網路模式,那麼容器內部就只能使用loop back網路設備,不會再有其他的網路資源。
[root@docker ~]# docker run -it --name host --network none --rm busybox / # ifconfig lo Link encap:Local Loopback inet addr:127.0.0.1 Mask:255.0.0.0 ...... 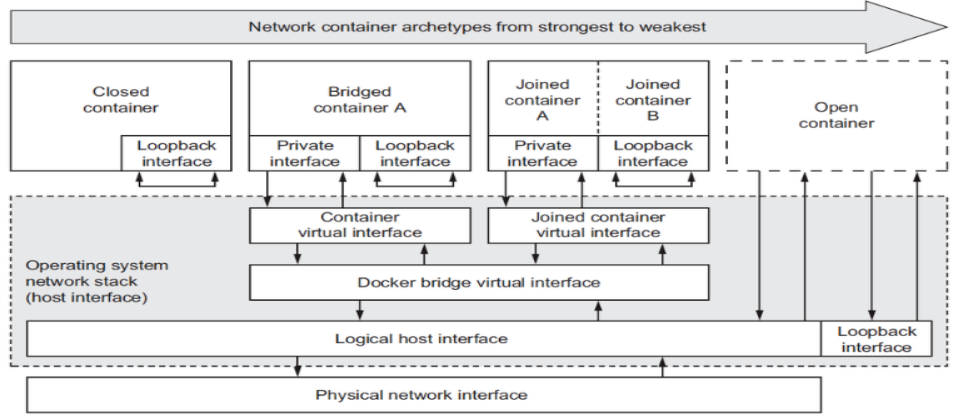
container模式
joined 容器是另一種實現容器間通訊的方式。它可以使兩個或多個容器共享一個網路棧,共享網卡和配置資訊,joined 容器之間可以通過 127.0.0.1 直接通訊。
[root@docker ~]# docker run --name busy01 -it --rm busybox / # ip a 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever 8: eth0@if9: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue link/ether 02:42:0a:00:00:03 brd ff:ff:ff:ff:ff:ff inet 172.17.0.3/16 brd 10.0.255.255 scope global eth0 valid_lft forever preferred_lft forever / # hostname 4a5449c67f3a # 此時另開一窗口,在啟動另外一個容器,可以看到ip和主機名啥的都是一樣的 [root@docker ~]# docker run --name busy02 -it --network container:busy01 --rm busybox / # ip a 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever 8: eth0@if9: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue link/ether 02:42:0a:00:00:03 brd ff:ff:ff:ff:ff:ff inet 172.17.0.3/16 brd 10.0.255.255 scope global eth0 valid_lft forever preferred_lft forever / # hostname 4a5449c67f3a # 做個測試,證明兩個容器時共用lo介面的,在busy01上面啟動一個httpd / # echo 'I live zhujingxing' >/tmp/index.html / # httpd -f -h /tmp/ # 在busy02上訪問本地介面lo,可以看到是成功的 / # wget -O - -q 127.0.0.1 I live zhujingxing # 但是文件系統還是隔離的,在busy01容器中創建一個目錄 / # mkdir /tmp/test # 在busy02中查看,是沒有的 / # ls /tmp/ 2.6.7 自定義docker的網路屬性
#修改docker0橋的地址,添加bip設置 [root@docker ~]# docker ps [root@docker ~]# ip a | grep docker0 3: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default inet 172.17.0.1/16 brd 172.17.255.255 scope global docker0 [root@docker ~]# systemctl stop docker [root@docker ~]# cp /etc/docker/daemon.json{,.bak} [root@docker ~]# vim /etc/docker/daemon.json [root@docker ~]# systemctl start docker [root@docker ~]# diff /etc/docker/daemon.json{,.bak} 2,3c2 < "registry-mirrors": ["https://llpuz83z.mirror.aliyuncs.com"], < "bip": "10.0.0.1/16" --- > "registry-mirrors": ["https://llpuz83z.mirror.aliyuncs.com"] [root@docker ~]# ip a | grep docker0 3: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default inet 10.0.0.1/16 brd 10.0.255.255 scope global docker0 #還可以修改其他選項 [root@node2 ~]# cat /etc/docker/daemon.json { "registry-mirrors": ["https://registry.docker-cn.com"], "bip": "10.0.0.1/16", #核心選項為big,即bridge ip,用於指定docker0橋自身的IP地址,其他選項可以通過此計算出來,除了DNS "fixed-cidr": "10.20.0.0/16", "fixed-cidr-v6": "2001:db8::/64", "default-gateway": "10.20.1.1", "default-gateway-v6": "2001:db8:abcd::89", "dns": ["10.20.1.2","10.20.1.3"] } #關於daemon.json 請看1.5.2.2章節 #設定外部主機連接docker dockerd守護進程的C/S,其默認僅監聽unix socket格式地址,/var/run/docker.sock;如果使用tcp套接字 # 現在我的docker01和docker02主機都是有安裝docker的,我現在修改配置,使docker01能夠控制docker02的容器 [root@docker2 ~]# docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 2157df82161b hamerle/httpd:v1 "/bin/httpd -f -h /d…" 2 days ago Exited (135) 1 hours ago web01 [root@docker02 ~]# systemctl edit docker.service [Service] ExecStart= ExecStart=/usr/bin/dockerd -H fd:// -H tcp://0.0.0.0:2375 [root@docker02 ~]# systemctl daemon-reload [root@docker02 ~]# systemctl restart docker.service [root@docker02 ~]# netstat -lntp Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name tcp 0 0 0.0.0.0:22 0.0.0.0:* LISTEN 765/sshd tcp 0 0 127.0.0.1:2375 0.0.0.0:* LISTEN 5180/dockerd tcp6 0 0 :::22 :::* LISTEN 765/sshd # docke daemon已經監聽到2375的埠,我們現在可以通過docker01遠程啟動docker02上的web007容器 [root@docker01 ~]# docker -H 20.0.0.210:2375 ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 2157df82161b hamerle/httpd:v1 "/bin/httpd -f -h /d…" 2 days ago Exited (135) 1 hours ago web01 [root@docker01 ~]# docker -H 20.0.0.210:2375 start web01 web01 [root@docker2 ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 2157df82161b hamerle/httpd:v1 "/bin/httpd -f -h /d…" 2 days ago Exited (135) 1 hours ago web01 #手動創建一個網路類型,並指定對應網橋設備的名稱為docker,最終實現基於兩個不同網路啟動的容器間互相通訊。 [root@docker ~]# docker network ls NETWORK ID NAME DRIVER SCOPE bddc0093fe11 bridge bridge local 48cf42c3b371 host host local 4c1006be1ea1 none null local [root@docker ~]# docker network create --help [root@docker ~]# docker network create -o com.docker.network.bridge.name=docker -d bridge --subnet '172.18.0.0/16' bridge-test 38ce06f558bab2dd57959448953dc214411c3d6147185c2d78fd90b37ae34c62 # -o:在使用bridge的driver類型時,可以使用-o的附加參數。上面實例中的參數意思是指定創建bridge類型網路時對應虛擬網橋設備的名字。(就是ip a命令看到的名字) # -d:指定driver,默認類型就是bridge。 # --subnet:指定新建的docker網路的網段 # 最後的bridg-test是即將要將創建出的網路的名字. [root@docker ~]# docker network ls NETWORK ID NAME DRIVER SCOPE bddc0093fe11 bridge bridge local 38ce06f558ba bridge-test bridge local 48cf42c3b371 host host local 4c1006be1ea1 none null local [root@docker ~]# ip a | grep docker 3: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default inet 10.0.0.1/16 brd 10.0.255.255 scope global docker0 19: docker: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN group default inet 172.18.0.1/16 brd 172.18.255.255 scope global docker # 我們以bridge-test網路啟動一個容器 [root@docker ~]# docker run --name busy01 -it --network bridge-test --rm busybox:latest / # ip a 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever 20: eth0@if21: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue link/ether 02:42:ac:12:00:02 brd ff:ff:ff:ff:ff:ff inet 172.18.0.2/16 brd 172.18.255.255 scope global eth0 valid_lft forever preferred_lft forever / # # 另開一個窗口,使用bridge網路再起一個容器 [root@docker ~]# docker run --name busy02 -it --network bridge --rm busybox:latest / # ip a 1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue qlen 1 link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00 inet 127.0.0.1/8 scope host lo valid_lft forever preferred_lft forever 22: eth0@if23: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1500 qdisc noqueue link/ether 02:42:0a:00:00:02 brd ff:ff:ff:ff:ff:ff inet 10.0.0.2/16 brd 10.0.255.255 scope global eth0 valid_lft forever preferred_lft forever # 可以看到兩個容器,一個是172.18網段,一個是10.0網段,此時做連通性測試。 / # ping 172.18.0.2 # 不通,此時確定宿主機的ip_forward是否開啟,如果開啟還不通,則需要另開一個窗口排查防火牆規則。 [root@docker ~]# cat /proc/sys/net/ipv4/ip_forward 1 [root@docker ~]# iptables -nvL # 排查防火牆規則,其實很簡單,把target類型為DROP的刪掉就好了。我這裡只列出有DROP的鏈,並刪除 [root@docker ~]# iptables -nvL DOCKER-ISOLATION-STAGE-2 --line-number Chain DOCKER-ISOLATION-STAGE-2 (2 references) num pkts bytes target prot opt in out source destination 1 0 0 DROP all -- * docker 0.0.0.0/0 0.0.0.0/0 2 0 0 DROP all -- * docker0 0.0.0.0/0 0.0.0.0/0 3 7 588 RETURN all -- * * 0.0.0.0/0 0.0.0.0/0 [root@docker ~]# iptables -D DOCKER-ISOLATION-STAGE-2 2 [root@docker ~]# iptables -D DOCKER-ISOLATION-STAGE-2 1 # 刪除完後再ping / # ping 172.18.0.2 PING 172.18.0.2 (172.18.0.2): 56 data bytes 64 bytes from 172.18.0.2: seq=0 ttl=63 time=0.115 ms 64 bytes from 172.18.0.2: seq=1 ttl=63 time=0.081 ms 64 bytes from 172.18.0.2: seq=2 ttl=63 time=0.169 ms 2.7 docker存儲卷
2.7.1 為什麼需要數據卷
這得從 docker 容器的文件系統說起。出於效率等一系列原因,docker 容器的文件系統在宿主機上存在的方式很複雜,這會帶來下面幾個問題:
不能在宿主機上很方便地訪問容器中的文件。
無法在多個容器之間共享數據。
當容器刪除時,容器中產生的數據將丟失。
為了解決這些問題,docker 引入了數據卷(volume) 機制。數據卷是存在於一個或多個容器中的特定文件或文件夾,這個文件或文件夾以獨立於 docker 文件系統的形式存在於宿主機中。數據卷的最大特定是:其生存周期獨立於容器的生存周期。
2.7.2 使用數據卷的最佳場景
在多個容器之間共享數據,多個容器可以同時以只讀或者讀寫的方式掛載同一個數據卷,從而共享數據卷中的數據。
當宿主機不能保證一定存在某個目錄或一些固定路徑的文件時,使用數據卷可以規避這種限制帶來的問題。
當你想把容器中的數據存儲在宿主機之外的地方時,比如遠程主機上或雲存儲上。
當你需要把容器數據在不同的宿主機之間備份、恢復或遷移時,數據卷是很好的選擇。
2.7.3 細述存儲卷
背景:一個程式,對於容器來說,啟動時依賴於可能不止一層的鏡像,聯合掛載啟動而成,使用overlay2文件系統,引導最上層的可寫層,對於讀寫層來說,所有在容器中可執行的操作,包括對數據和內容的修改,都是保存在最上層之上的,對於下層內容的操作,假設要刪除一個文件,需要使用寫時複製。
docker鏡像由多個只讀層疊加面成,啟動容器時,docker會載入只讀鏡像層並在鏡像棧頂部加一個讀寫層
如果運行中的容器修改了現有的一個已經存在的文件,那該文件將會從讀寫層下面的只讀層複製到讀寫層,該文件版本仍然存在,只是已經被讀寫層中該文件的副本所隱藏,此即“寫時複製(COW)”機制
描述:如果一個文件在最底層是可見的,如果在layer1上標記為刪除,最高的層是用戶看到的Layer2的層,在layer0上的文件,在layer2上可以刪除,但是只是標記刪除,用戶是不可見的,總之在到達最頂層之前,把它標記來刪除,對於最上層的用戶是不可見的,當標記一刪除,只有用戶在最上層建一個同名一樣的文件,才是可見的。
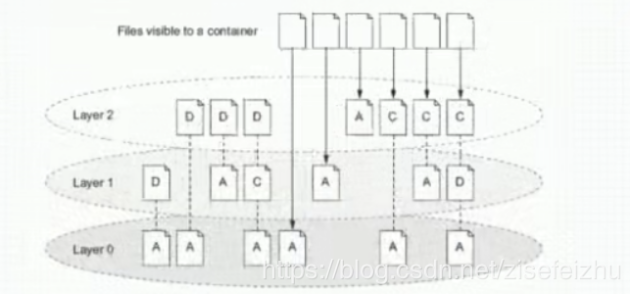
對於這類的操作,修改刪除等,一般效率非常低,如果對一於I/O要求比較高的應用,如redis在實現持久化存儲時,是在底層存儲時的性能要求比較高。
假設底層運行一個存儲庫mysql,mysql本來對於I/O的要求就比較高,如果mysql又是運行在容器中自己的文件系統之上時,也就是容器在停止時,就意味著刪除,其實現數據存取時效率比較低,要避免這個限制要使用存儲捲來實現。
存儲卷:可以想像來在各全局的名稱空間中,也就是理解為在宿主機中找一個本地的文件系統,可能存在某一個目錄中,直接與容器上的文件系統中的某一目錄建立綁定關係。
類似於掛載一樣,宿主機的/data/web目錄與容器中的/container/data/web目錄綁定關係,然後容器中的進程向這個目錄中寫數據時,是直接寫在宿主機的目錄上的,繞過容器文件系統與宿主機的文件系統建立關聯關係,使得可以在宿主機和容器內共享資料庫內容,讓容器直接訪問宿主機中的內容,也可以宿主機向容器供集內容,兩者是同步的。
mount名稱空間本來是隔離的,可以讓兩個本來是隔離的文件系統,在某個子路徑上建立一定程度的綁定關係,從而使得在兩個容器之間的文件系統的某個子路徑上不再是隔離的,實現一定程度上共享的效果。
在宿主機上能夠被共享的目錄(可以是文件)就被稱為volume。
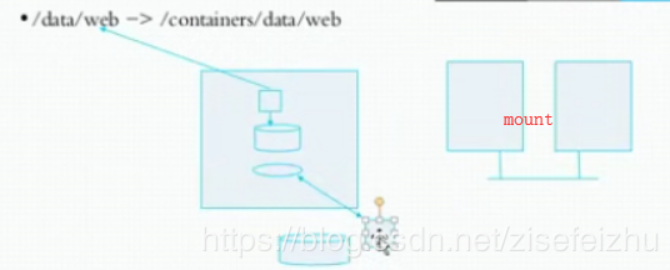
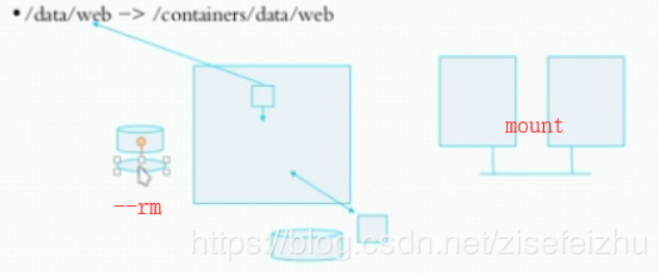
優點:容器中進程所生成的數據,都保存在存儲卷上,從而脫離容器文件系統自身後,當容器被關閉甚至被刪除時,都不用擔心數據被丟失,實現數據可以脫離容器生命周期而持久,當再次重建容器時,如果可以讓它使用到或者關聯到同一個存儲卷上時,再創建容器,雖然不是之前的容器,但是數據還是那個數據,特別類似於進程的運行邏輯,進程本身不保存任何的數據,數據都在進程之外的文件系統上,或者是專業的存儲服務之上,所以進程每次停止,只是保存程式文件,對於容器也是一樣,
容器就是一個有生命周期的動態對象來使用,容器關閉就是容器刪除的時候,但是它底層的鏡像文件還是存在的,可以基於鏡像再重新啟動容器。
但是容器有一個問題,一般與進程的啟動不太一樣,就是容器啟動時選項比較多,如果下次再啟動時,很多時候會忘記它啟動時的選項,所以最好有一個文件來保存容器的啟動,這就是容器編排工具的作用。一般情況下,是使用命令來啟動操作docker,但是可以通過文件來讀,也就讀文件來啟動,讀所需要的存儲卷等,但是它也只是操作一個容器,這也是需要專業的容器編排工具的原因。
另一個優勢就是容器就可以不置於啟動在那台主機之上了,如幾台主機後面掛載一個NFS,在各自主機上創建容器,而容器上通過關聯到宿主機的某個目錄上,而這個目錄也是NFS所掛載的目錄中,這樣容器如果停止或者是刪除都可以不限制於只能在原先的宿主機上啟動才可以,可以實現全集群範圍內調試容器的使用,當再分配存儲、計算資源時,就不會再局限於單機之上,可以在集群範圍內建立起來,基本各種docker的編排工具都能實現此功能,但是後面嚴重依賴於共享存儲的使用。
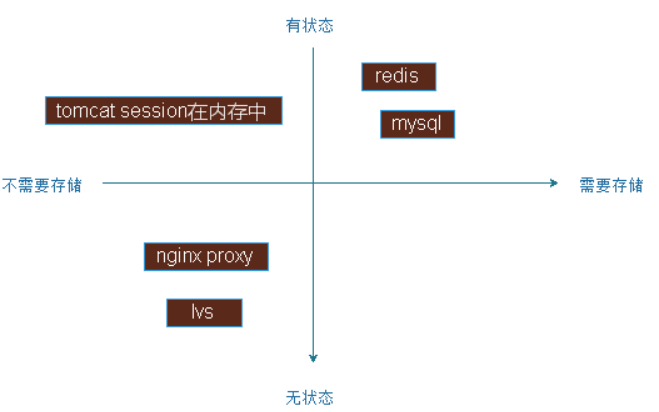
考慮到容器應用是需要持久存儲數據的,可能是有狀態的,如果考慮使用NFS做反向代理是沒必要存儲數據的,應用可以分為有狀態和無狀態,有狀態是當前這次連接請求處理一定此前的處理是有關聯的,無狀態是前後處理是沒有關聯關係的,大多數有狀態應用都是數據持久存儲的,如mysql,redis有狀態應用,在持久存儲,如nginx作為反向代理是無狀態應用,tomcat可以是有狀態的,但是它有可能不需要持久存儲數據,因為它的session都是保存在記憶體中就可以的,會導致節點宕機而丟失session,如果有必要應該讓它持久,這也算是有狀態的。

應用狀態:是否有狀態或無狀態,是否需要持久存儲,可以定立一個正軸坐標系,第一象限中是那些有狀態需要存儲的,像mysql,redis等服務,有些有有狀態但是無需進行存儲的,像tomcat把會話保存在記憶體中時,無狀態也無需要存儲的數據,如各種反向代理伺服器nginx,lvs請求連接都是當作一個獨立的連接來調度,本地也不需要保存數據,第四象限是無狀態,但是需要存儲數據是比較少見。
運維起來比較難的是有狀態且需要持久的,需要大量的運維經驗和大量的操作步驟才能操作起來的,如做一個Mysql主從需要運維知識、經驗整合進去才能實現所謂的部署,擴展或縮容,出現問題後修復,必須要了解集群的規模有多大,有多少個主節點,有多少個從節點,主節點上有多少個庫,這些都要一清二楚,才能修復故障,這些就強依賴於運維經驗,無狀態的如nginx一安裝就可以了,並不複雜,對於無狀態的應用可以迅速的實現複製,在運維上實現自動化是很容易的,對於有狀態的現狀比較難脫離運維人員來管理,即使是k8s在使用上也暫時沒有成熟的工具來實現。
總之:對於有狀態的應用的數據,不使用存儲卷,只能放在容器本地,效率比較低,而導致一個很嚴重問題就是無法遷移使用,而且隨著容器生命周期的停止,還不能把它刪除,只能等待下次再啟動狀態才可以,如果刪除了數據就可能沒了,因為它的可寫層是隨著容器的生命周期而存在的,所以只要持久存儲數據,存儲卷就是必需的。
docker存儲卷難度:對於docker存儲卷運行起來並不太麻煩,如果不自己藉助額外的體系來維護,它本身並沒有這麼強大,因為docker存儲卷是使用其所在的宿主機上的本地文件系統目錄,也就是宿主機有一塊磁碟,這塊磁碟並沒有共享給其他的docker主要,然後容器所使用的目錄,只是關聯到宿主機磁碟上的某個目錄而已,也就是容器在這宿主機上停止或刪除,是可以重新再創建的,但是不能調度到其他的主機上,這也是docker本身沒有解決的問題,所以docker存儲卷默認就是docker所在主機的本地,但是自己搭建一個共享的NFS來存儲docker存儲的數據,也可以實現,但是這個過程強依賴於運維人員的能力。
2.7.3.1 使用存儲卷的原因
關閉並重啟容器,其數據不受影響,但是刪除docker容器,則其更改將會全部丟失
存在的問題
存儲於聯合文件系統中,不易於宿主機訪問
容器間數據共享不便
刪除容器其數據會丟失
解決方案:卷
卷是容器上一個或多個"目錄“,此類目錄可繞過聯合文件系統,與宿主機上的某目錄綁定(關聯)

2.7.3.2 存儲卷原理
volume於容器初始化之時會創建,由base image提供的卷中的數據會於此期間完成複製
volume的初意是獨立於容器的生命周期實現數據持久化,因此刪除容器之時既不會刪除卷,也不會對哪怕未被引用的卷做垃圾回收操作
卷為docker提供了獨立於容器的數據管理機制
可以把“鏡像”想像成靜態文件,例如“程式”,把卷類比為動態內容,例如“數據”,於是,鏡像可以重用,而卷可以共享
卷實現了“程式(鏡像)"和”數據(卷)“分離,以及”程式(鏡像)“和"製作鏡像的主機”分離,用記製作鏡像時無須考慮鏡像運行在容器所在的主機的環境
描述:有了存儲卷,如果寫在/上,還是存在聯合掛載文件系統中,如果要寫到卷上,就會寫到宿主機關聯的目錄上,程式運行過程生成的臨時數據會寫到tmp目錄中,也就會在容器的可寫層中存儲,隨著容器被刪除而刪除,並沒太大的影響,只有關鍵型的數據才會保存在存儲卷上。

Volume types

Docker有兩種類型的卷,每種類型都在容器中存在一個掛載點,但其在宿主機上位置有所不同:
綁定掛載卷:在宿主機上的路徑要人工的指定一個特定的路徑,在容器中也需要指定一個特定的路徑,兩個已知的路徑建立關聯關係
docker管理卷: 只需要在容器內指定容器的掛載點是什麼,而被綁定宿主機下的那個目錄,是由容器引擎daemon自行創建一個空的目錄,或者使用一個已經存在的目錄,與存儲卷建立存儲關係,這種方式極大解脫用戶在使用卷時的耦合關係,缺陷是用戶無法指定那些使用目錄,臨時存儲比較適合
2.7.3.3 docker volume 子命令
docker 專門提供了 volume 子命令來操作數據卷:
create 創建數據卷 inspect 顯示數據卷的詳細資訊 ls 列出所有的數據卷 prune 刪除所有未使用的 volumes,並且有 -f 選項 rm 刪除一個或多個未使用的 volumes,並且有 -f 選項 2.7.3.4 使用mount 語法掛載數據卷
使用 --volume(-v) 選項來掛載數據卷,現在 docker 提供了更強大的 --mount 選項來管理數據卷。mount 選項可以通過逗號分隔的多個鍵值對一次提供多個配置項,因此 mount 選項可以提供比 volume 選項更詳細的配置。使用 mount 選項的常用配置如下:
type 指定掛載方式,我們這裡用到的是 volume,其實還可以有 bind 和 tmpfs。 volume-driver 指定掛載數據卷的驅動程式,默認值是 local。 source 指定掛載的源,對於一個命名的數據卷,這裡應該指定這個數據卷的名稱。在使用時可以寫 source,也可以簡寫為 src。 destination 指定掛載的數據在容器中的路徑。在使用時可以寫 destination,也可以簡寫為 dst 或 target。 readonly 指定掛載的數據為只讀。 volume-opt 可以指定多次,用來提高更多的 mount 相關的配置。 2.7.3.5 數據的覆蓋問題
如果掛載一個空的數據卷到容器中的一個非空目錄中,那麼這個目錄下的文件會被複制到數據卷中。
如果掛載一個非空的數據卷到容器中的一個目錄中,那麼容器中的目錄中會顯示數據卷中的數據。如果原來容器中的目錄中有數據,那麼這些原始數據會被隱藏掉。
這兩個規則都非常重要:
靈活利用第一個規則可以幫助我們初始化數據卷中的內容。
掌握第二個規則可以保證掛載數據卷後的數據總是你期望的結果
2.7.3.5 在容器中使用volumes
為docker run 命令使用-v 選項可使用volume
docker-managed volume docker run -it -name bbox1 -v /data busybox #/data指定docker的目錄 docker inspect -f {{.Mounts}} bbox1 #查看rbox1容器的卷,卷標識符及掛載的主機目錄 Bind-mount volume docker run -it -v HOSTDIR:VOLUMEDIR --name bbox2 busybox #宿主機目錄:容器目錄 docker inspect -f {{.Mounts}} bbox2 2.7.4 實操:docker管理卷
[root@docker ~]# docker run --help -v, --volume list Bind mount a volume --volume-driver string Optional volume driver for the container --volumes-from list Mount volumes from the specified container(s) [root@docker ~]# docker run --name volume01 -it -v /data busybox / # ls / bin data dev etc home proc root sys tmp usr var ---> data目錄默認是不存在的 [root@docker ~]# docker inspect volume01 "Mounts": [ { "Type": "volume", "Name": "632514d35d152b677553d166601fe44091720ac9788dc30e2912cb7c63ba76b4", "Source": "/var/lib/docker/volumes/632514d35d152b677553d166601fe44091720ac9788dc30e2912cb7c63ba76b4/_data", "Destination": "/data", ---> 容器中的data目錄掛載在宿主機上的Source所指目錄 "Driver": "local", "Mode": "", "RW": true, "Propagation": "" } ], #宿主機: 可以很方便實現在宿主機和容器之間共享目錄 [root@docker ~]# cd /var/lib/docker/volumes/632514d35d152b677553d166601fe44091720ac9788dc30e2912cb7c63ba76b4/_data [root@docker _data]# ls [root@docker _data]# echo "hello zhujingxing" > test.html #在容器中查看 / # ls /data/ test.html / # cat /data/test.html hello zhujingxing / # echo "hello zisefeizhu" >> /data/test.html [root@docker _data]# cat test.html hello zhujingxing hello zisefeizhu #docker綁定卷 [root@docker ~]# docker run --name volume02 -it --rm -v /data/volumes/volume02:/data busybox / # [root@docker _data]# docker inspect volume02 "Mounts": [ { "Type": "bind", "Source": "/data/volumes/volume02", "Destination": "/data", "Mode": "", "RW": true, "Propagation": "rprivate" } ], [root@docker _data]# cd /data/volumes/volume02/ ---> 目錄會自動創建 [root@docker volume02]# echo "<h1> hello zhujingxing </h1>" > index.html / # cat /data/index.html <h1> hello zhujingxing </h1> #持久化的實現 / # exit [root@docker ~]# docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES [root@docker ~]# docker run --name volume02 -it --rm -v /data/volumes/volume02:/data/web/htm busybox / # cat /data/web/htm/index.html <h1> hello zhujingxing </h1> #使用golong模板查看 [root@docker volume02]# docker inspect -f {{.Mounts}} volume02 [{bind /data/volumes/volume02 /data/web/htm true rprivate}] [root@docker volume02]# docker inspect -f {{.NetworkSettings}} volume02 {{ 03562d1741cd19808e9a904d991a6c0f1db1ba9d5098e20779edbd4529798d0d false 0 map[] /var/run/docker/netns/03562d1741cd [] []} {fd45e4499b9bbebbfe6d383593a20ccaadbcac2d130bb097037ed19444abb009 10.0.0.1 0 10.0.0.3 16 02:42:0a:00:00:03} map[bridge:0xc0005a8000]} ##引入某個鍵(鍵中鍵) [root@docker volume02]# docker inspect -f {{.NetworkSettings.IPAddress}} volume02 10.0.0.3 場景:一個docker容器可以關聯到宿主機的目錄中,也可以讓兩個docker容器同時關聯到同一個宿主機的目錄中,實現共享使用同一個存儲卷,容器之間的數據共享
[root@docker ~]# docker run --name volume02 -it --rm -v /data/volumes/volume02:/data/web/htm busybox / # cat /data/web/htm/index.html <h1> hello zhujingxing </h1> [root@docker volume02]# docker run --name volume03 -it --rm -v /data/volumes/volume02:/data busybox / # cat /data/index.html <h1> hello zhujingxing </h1> [root@docker ~]# cat /data/volumes/volume02/index.html <h1> hello zhujingxing </h1> 場景:需要多個容器同進使用多個卷,卷在那裡寫每次初始化時都要使用-v來指定,如果不想記錄這個路徑,docker還支援複製其他的存儲卷路徑
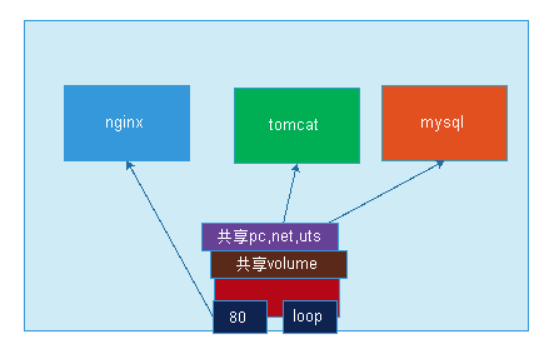
實現:制定一個容器,不執行任何任務,創建時,只要指定它的存儲路徑,作為其他相關聯容器的基礎架構容器,其他的容器啟動時去複製它的存儲卷設置,但是這樣的點浪費,不過使用joined container的基礎的話,幾個容器本來就有密切的關係,如nginx+tomcat,nginx的容器和tomcat容器共享一個底層的網路,有一個對外的介面,有一個loop介面,這樣80給nginx,在內loop給tomcat,請求進來,nginx作為反射代理轉給tomcat就可以了,再加一個mysql,也是使用loop介面來通訊。
讓它們共享網路名稱空間中的uts,net,ipc,還可以共享存儲卷,ngInx處理靜態,tomcat處理動態的,在同一個目錄下,使用存儲捲來解決這個問題,這種組織方式使用構建應用。
#多個容器的卷使用同一個主機目錄,如 docker run -it --name c1 -v /docker/volumes/v1:/data/ busybox #複製使用其他容器的卷,為docker run 命令使用--volumes-from選項 docker run -it --name bbox1 -v /docker/volumes/v1:/data busybox docker run -it --name bbox2 --volumes-from bbox1 busybox #制定基礎鏡像(網上有專門製作基礎架構容器的,不用啟動,只要創建就可以了) [root@docker ~]# docker run --name basiccon -it -v /data/basic/volume/:/data/web/html busybox / # ls /data/ web [root@docker ~]# docker run --name nginx --network container:basiccon --volumes-from basiccon -it busybox #加入網路,同時複製卷 / # ls /data/ web 2.8 dockerfile詳解
各位想必應該記得,此前如果安裝一個nginx的話,安裝完以後,通常不會運行在默認配置下,那因此,我們通常需要去改一改它的配置文件或者定義模組化配置文件,然後啟動服務。那為什麼,nginx的默認配置不符合我們的需要呢?很顯然,不同的生產場景所需要用到的配置參數各不相同,因此,對方只能用一個默認的,認為適用於大多數普遍場景情形的或者適用於較小主機資源情況下的那麼一個設定來啟動服務,同樣的邏輯,各位試想一下,如果我們從docker hub下拖下來一個nginx的鏡像,去啟動nginx容器的時候,請問這個鏡像內的nginx容器內的配置文件一定就會符合我們的需要嗎?應該說叫一定不會,基本上幾乎不能完全適合我們的需要,此時我們就必須去要修改配置,那怎麼改呢?
之前做法:啟動容器docker exec連進容器,在內部執行vi,再reload重啟
另外一種方式:假設我們把它對應的那個配置文件的路徑做存儲卷,從我們宿主機上載入文件,在宿主機上進行編輯,也能讓它立即生效,啟動容器之前先把它編輯好(容器啟動之前,我們事先找一目錄把配置文件準備好,然後啟動容器時,把容器內的應用程式默認載入配置文件的路徑與宿主機上的目錄進行建立關聯關係,然後去啟動容器,也能載入到在宿主機上訂製的配置文件)
缺點:我們在宿主上做的編輯,能不能讓它立即生效呢?比如我們啟動以後發現,有些參數還是需要改,改完以後依然需要重載才能生效。
還有一種方式:自製鏡像
基於容器:先啟動起來,互動式連入進來,做修改,改完以後,改的結果一定時保存在最上層的可寫層的。這個時候我們把可寫層保存在一個新鏡像中,而後,我們再去創建容器時,根據我們自己所創建的鏡像來使用。
缺點:做的鏡像也是直接把文件直接備進鏡像中的,直接寫死在鏡像中的就是,如果我們想在改,還是改不了,運行過程當中去修改配置的需求可能對於做運維來講,變更不就是日常操作嗎?很多時候,也有可能需要隨時進行修改。那依然解決不了問題。而且這種備進鏡像的設計方式,最悲慘的地方在於:一次更新,維護複雜 。環境簡單可以使用。
基於dockerfile:dockerfile,相當於是一個文檔,客戶可以基於dockerfile生成新的容器。dockerfile僅僅是用來製作鏡像的源碼文件,是構建容器過程中的指令,docker能夠讀取dockerfile的指定進行自動構建容器,基於dockerfile製作鏡像,每一個指令都會創建一個鏡像層,即鏡像都是多層疊加而成,因此,層越多,效率越低,創建鏡像,層越少越好。因此能在一個指令完成的動作盡量通過一個指令定義。
2.8.1 docker鏡像製作的工作邏輯
首先需要有一個製作鏡像的目錄,該目錄下有個文件,名稱必須為Dockerfile,Dockerfile有指定的格式,#號開頭為注釋,,指定默認用大寫字母來表示,以區分指令和參數,docker build讀取Dockerfile是按順序依次Dockerfile里的配置,且第一條非注釋指令必須是FROM 開頭,表示基於哪個基礎鏡像來構建新鏡像。可以根據已存在的任意鏡像來製作新鏡像。
Dockerfile可以使用環境變數,用ENV來定義環境變數,變數名支援bash的變數替換,如${variable:-word},表示如果變數值存在,就使用原來的變數,變數為空時,就使用word的值作為變數的值,一般使用這個表示法。${variable:+word},表示如果變數存在了,不是空值,那麼變數將會被賦予為word對應的值,如果變數為空,那麼依舊是空值。
[root@docker ~]# echo ${NAME:-zhujingxing} zhujingxing [root@docker ~]# NAME=zisefeizhu [root@docker ~]# echo ${NAME:-zhujingxing} zisefeizhu [root@docker ~]# echo ${NAME:+zhujingxing} zhujingxing [root@docker ~]# unset NAME [root@docker ~]# echo ${NAME:+zhujingxing} [root@docker ~]#
dockerignore file:在docker發送上下文給 docker daemon 之前,會尋找.dockerignore file文件,去排除一些不需要的文件,或者很大的文件,不把這些文件發送給docker daemon,提升效率。而如果之後需要用到,則可以使用 ADD 或者 COPY 把他們放進image中。
2.8.2 dockerfile 格式
Dockerfile整體就兩類語句組成:
# Comment 注釋資訊
Instruction arguments 指令 參數,一行一個指令。
Dockerfile文件名首字母必須大寫。
Dockerfile指令不區分大小寫,但是為方便和參數做區分,通常指令使用大寫字母。
Dockerfile中指令按順序從上至下依次執行。
Dockerfile中第一個非注釋行必須是FROM指令,用來指訂製作當前鏡像依據的是哪個基礎鏡像。
Dockerfile中需要調用的文件必須跟Dockerfile文件在同一目錄下,或者在其子目錄下,父目錄或者其它路徑無效
2.8.3 dockerfile --> image --> registry
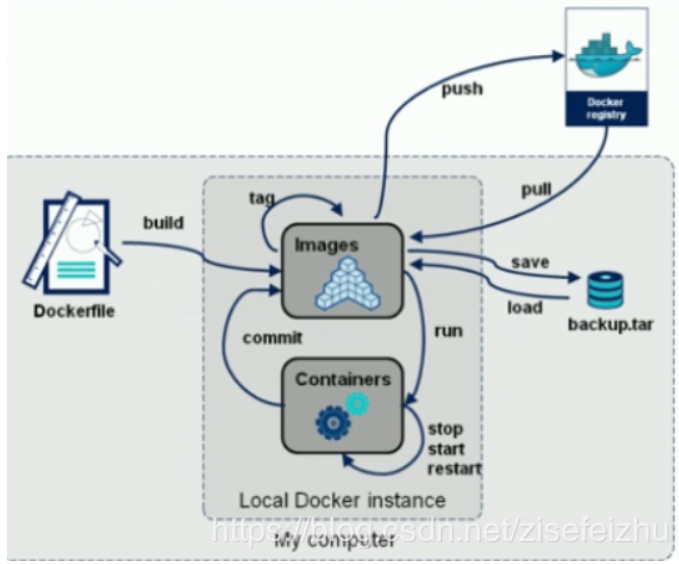
2.8.4 dockerfile 指令語法
1.FROM  介紹  FROM指令是最重要的一個且必須為 Dockerfile文件開篇的第一個非注釋行,用於為映像文件構建過程指定基準鏡像,後續的指令運行於此基準鏡像所提供的運行環境 .  實踐中,基準鏡像可以是任何可用鏡像文件,默認情況下, docker build會在 docker主機上查找指定的鏡像文件,在其不存在時,則會從 Docker Hub Registry上拉取所需的鏡像文件 .如果找不到指定的鏡像文件, docker build會返回一個錯誤資訊  語法  FROM <repository>[:<tag>]  或者  FROM <repository>@<digest>    <repository>:指定作為base image的名稱  <tag>:base image的標籤,為可選項,省略時默認為 latest;  <digest>為校驗碼  例子  FROM busybox:latest
  2.LABEL  介紹  LABEL用於為鏡像添加元數據,元數以鍵值對的形式指定,使用LABEL指定元數據時,一條LABEL指定可以指定一條或多條元數據,指定多條元數據時不同元數據之間通過空格分隔。推薦將所有的元數據通過一條LABEL指令指定,以免生成過多的中間鏡像。  語法  LABEL <key>=<value> <key>=<value> <key>=<value> ...  例子  LABEL version="1.0" description="這是一個Web伺服器" by="IT筆錄"  指定後可以通過docker inspect查看:  docker inspect itbilu/test  "Labels": {    "version": "1.0",  "description": "這是一個Web伺服器",      "by": "IT筆錄"  },
  3.COPY  介紹  用於從 Docker宿主機複製文件至創建的鏡像文件。  語法  COPY <src>... <dest>  或者  COPY ["<src>",... "<dest>"]    <src>:要複製的源文件或者目錄,支援通配符  <dest>:目標路徑,即正創建的鏡像的文件系統路徑,建議使用絕對路徑,絕對路徑為鏡像中的路徑,而不是宿主機的路徑。否則,COPY指令會以WORKDIR為其起始路徑。  如果路徑中如果包含空白字元,建議使用第二種格式用引號引起來,否則會被當成兩個文件。  規則  <src>必須是build上下文中的目錄,即只能放在workshop這個工作目錄下,不能是其父目錄中的文件。  如果<src>是目錄,則其內部的文件或則子目錄會被遞歸複製,但<src>目錄本身不會被複制。  如果指定了多個<src>,或者<src>中使用通配符,則<dest>必須是一個目錄,且必須以 / 結尾。  如果<dest>事先不存在,它將會被自動創建,包括其父目錄路徑。  例子  copy文件  COPY index.html /data/web/html/  copy目錄  COPY yum.repos.d /etc/yum.repos.d/
  4.ADD  介紹  ADD指令跟COPY類似,不過它還支援使用tar文件和URL路徑。主機可以聯網的情況下,docker build可以將網路上的某文件引用下載並打包到新的鏡像中。  語法  ADD <src> ... <dest>或  ADD ["<src>",... "<dest>"]  規則  同COPY指令的4點準則   如果<src>為URL且<dest>不以/結尾,則<src>指定的文件將被下載並直接被創建為<dest>;如果<dest>以/結尾,則文件名URL指定的文件將被直接下載,並保存為<dest>/<filename>,注意,URL不能是ftp格式的url。  如果<src>是一個本地系統上的壓縮格式的tar文件,它將被展開為一個目錄,其行為類似於“tar -x”命令,然後,通過URL獲取到的tar文件將不會自動展開。  如果<src>有多個,或其間接或直接使用了通配符,則<dest>必須是一個以/結尾的目錄路徑;如果<dest>不以/結尾,則其被視作一個普通文件,<src>的內容將被直接寫入到<dest>;  例子  ADD  http://nginx.org/download/nginx-1.15.5.tar.gz  /usr/local/src/

  5.WORKDIR  介紹  workdir為工作目錄,指當前容器環境的工作目錄,用於為Dockerfile中所有的RUN、CMD、ENTRYPOINT、COPY和ADD指定設定工作目錄。在Dockerfile文件中,WORKDIR指令可出現多次,其路徑也可以為相對路徑,不過,其是相對此前一個WORKDIR指令指定的路徑。另外,WORKDIR也可調用由ENV指定定義的變數。  語法  WORKDIR  <dirpath>  例子  WORKDIR /var/log  WORKDIR  $STATEPATH
  6.VOLUME  介紹  定義卷,只能是docker管理的卷VOLUME為容器上的目錄(也就是說只能指定容器內的路徑,不能指定宿主機的路徑),用於在image中創建一個掛載點目錄,以掛載Docker host上的卷或其它容器上的卷。如果掛載點目錄路徑下此前在文件存在,docker run命令會在卷掛載完成後將此前的所有文件複製到新掛載的卷中。  語法  VOLUME <mountpoint>  或者  VOLUME ["<mountpoint>"]  例子  VOLUME /data/mysql/
  7.EXPOSE  介紹  暴露指定埠,用於為容器打開指定要監聽的埠以實現與外部通訊。EXPOSE指令可一次指定多個埠,但是不能指定暴露為宿主機的指定埠,因為指定的宿主機埠可能已經被佔用,因此這裡使用隨機埠。比如容器提供的是一個https服務且需要對外提供訪問,那就需要指定待暴露443埠,然後在使用此鏡像啟動容器時搭配 -P 的參數才能將待暴露的狀態轉換為真正暴露的狀態,轉換的同時443也會轉換成一個隨機埠,跟 -p :443一個意思  語法  EXPOSE <port>[/<protocol>] [<port>[/<protocol>] ...]  例子  EXPOSE 11211/udp 11211/tcp
  8.ENV  介紹  ENV用於為鏡像定義所需的環境變數,並可被Dockerfile文件中位於其後的其它指令(如ENV、ADD、COPY等)所調用,即先定義後調用,調用格式為$variable_name或${variable_name}  使用docker run啟動容器的時候加上 -e 的參數為variable_name賦值,可以覆蓋Dockerfile中ENV指令指定的此variable_name的值。但是不會影響到dockerfile中已經引用過此變數的文件名。  語法  ENV <key> <value>  ENV <key>=<value> ...    第一種格式一次只能定義一個變數,<key>之後所有內容都會被視為<value>的組成部分  第二種格式一次可以定義多個變數,每個變數為一個"="的鍵值對,如果<value>中包含空格,可以用反斜線  進行轉義,也可以為<value>加引號,另外參數過長時可用反斜線做續行。  定義多個變數時,建議使用第二種方式,因為Dockerfile中每一行都是一個鏡像層,構建起來比較吃資源。  例子  # 基於busybox啟動一個鏡像,將test文件拷貝至容器內的/usr/local/zisefeizhu/目錄下。  [root@docker dockerfile]# pwd  /root/dockerfile  [root@docker dockerfile]# echo zhujingxing  > test  [root@docker dockerfile]# vim Dockerfile   # Description: test image  FROM busybox  ENV file=zisefeizhu  ADD ./test /usr/local/$file/  [root@docker dockerfile]# docker build -t busy:v1 ./  # 根據此鏡像啟動容器並查看文件是否拷貝成功,並且查看file變數的值  [root@docker dockerfile]# docker run --name busy02 --rm busy:v1 ls /usr/local/zisefeizhu  zhujingxing  [root@docker dockerfile]# docker run --name busy02 --rm busy:v1 printenv  PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin  HOSTNAME=57111b7b234c  file=zisefeizhu  HOME=/root  # 接下來我們在啟動容器的時候加上-e參數為file變數指定一個新值,並且查看file變數的值  [root@docker dockerfile]# docker run --name busy02 -e file=zhujingxing --rm busy:v1 printenv  PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin  HOSTNAME=787ad8582fs0  file=zhujingxing  HOME=/root  # 此時再看test的文件,依然是在zisefeizhu的目錄下的  [root@docker1 docker]# docker run --name busy02 -e file=bbb --rm busy:v1 ls /usr/local/zisefeizhu  zhujingxing  # 這是因為docker build屬於第一階段,而docker run屬於第二階段。第一階段定義file變數的值zisefeizhu已經被引用了,生米已經煮成熟飯了,後續階段再改file變數的值也影響不了zisefeizhu。

9.RUN  介紹  RUN用於指定 docker build過程中運行的程式,其可以是任何命令,但是這裡有個限定,一般為基礎鏡像可以運行的命令,如基礎鏡像為centos,安裝軟體命令為yum而不是ubuntu里的apt-get命令。  RUN和CMD都可以改變容器運行的命令程式,但是運行的時間節點有區別,RUN表示在docker build運行的命令,而CMD是將鏡像啟動為容器運行的命令。因為一個容器正常只用來運行一個程式,因此CMD一般只有一條命令,如果CMD配置多個,則只有最後一條命令生效。而RUN可以有多個。  語法  RUN <command>  或者  RUN ["<executable>", "<param1>", "<param2>"]    第一種格式中,<command>通常是一個shell命令,系統默認會把後面的命令作為shell的子進程來運行,以“/bin/sh -c”作為父進程來運行它,這意味著此進程在容器中的PID不為1(如果是PID為1完事就解釋了。用腿想),不能接收Unix訊號,因此,當使用 docker stop <container>命令停止容器時,此進程接收不到SIGTERM訊號;    第二種語法格式中的參數是一個JSON格式的數組,其中<executable>為要運行的命令,後面的<paramN>為傳遞給命令的選項或參數;然而,此種格式指定的命令不會以“/bin/sh -c”來發起(也就是直接由內核創建),表示這種命令在容器中直接運行,不會作為shell的子進程,因此常見的shell操作如變數替換以及通配符(?,*等)替換將不會進行。過,如果要運行的沒能力依賴此shell特性的話,可以將其替換為類似下面的格式  RUN ["/bin/bash","-C","<executable>","<paraml>"]    如果RUN的命令很多,就用&&符號連接多個命令,少構建鏡像層,提高容器的效率  例子  基礎鏡像為centos,RUN多個命令  由於安裝是到互聯網上的倉庫進行安裝,所以,建議把centos的yum源配置為本地,即創建鏡像時,把yum的配置有本地倉庫源配置在CentOS-Base.repo文件放在imp1下面,配置文件配置ADD拷貝一份到新建鏡像的/etc/yum.repos.d目錄下,因為經常默認會優先載入CentOS-Base.repo下的包,但是不建議使用這個方法,除非本地倉庫有足夠的包解決依賴關係,否則建議僅使用默認的即可  編輯dockerfile  [root@docker img1]# vim Dockerfile  # Description: nginx image  FROM centos:7.3.1611  MAINTAINER "zisefeizhu <[email protected]>"  ENV nginx_ver=1.14.0  ENV nginx_url=http://nginx.org/download/nginx-${nginx_ver}.tar.gz  WORKDIR "/usr/local/src"  ADD CentOS-Base.repo  /etc/yum.repos.d/  ADD ${nginx_url} /usr/local/src/  RUN tar xf nginx-${nginx_ver}.tar.gz &&           yum -y install gcc pcre-devel openssl-devel make &&            cd nginx-${nginx_ver} &&           ./configure && make && make install  創建鏡像  [root@docker img1]# docker build -t nginx:v1 ./  運行容器,啟動nginx進程  [root@docker img1]# docker run -it --rm --name nginxv1 nginx:v1  [root@ccedfdf5e63f src]# /usr/local/nginx/sbin/nginx  此時,nginx進程運行於後台,不建議這麼做,因為容器的進程要運行於前台模式,否則容器會終止,nginx運行於前台,需要在nginx的配置文件nginx.conf里添加配置項  vi /usr/local/nginx/conf/nginx.conf  daemon off;  這樣使得nginx運行於前台  再次運行nginx,則運行於前台  或者通過-g選項,在運行nginx的全局配置模式之後再運行某些參數,注意off後面的冒號  [root@ccedfdf5e63f local]# /usr/local/nginx/sbin/nginx -g "daemon off;"

10.CMD  介紹  指定啟動容器的默認要運行的程式,也就是PID為1的進程命令,且其運行結束後容器也會終止。如果不指定,默認是bash。CMD指令指定的默認程式會被docker run命令行指定的參數所覆蓋。Dockerfile中可以存在多個CMD指令,但僅最後一個生效。因為一個docker容器只能運行一個PID為1的進程。類似於RUN指令,也可以運行任意命令或程式,但是兩者的運行時間點不同:RUN指令運行在docker build的過程中,而CMD指令運行在基於新鏡像啟動容器(docker run)時。  語法  CMD <command>  或者  CMD ["<executable>","<param1>","<param2>"]  或者  CMD["<param1>","<param2>"]    前兩種語法格式的意義同 RUN  第三種則用於為 ENTRYPOINT指令提供默認參數  例子  CMD /bin/httpd -f -h ${WEB_DOC_ROOT}  CMD [ "/bin/httpd","-f","-h ${WEB_DOC_ROOT}"]  CMD [ "/bin/sh","-c","/bin/httpd","-f","-h ${WEB_DOC_ROOT}"]  CMD [ "/bin/sh","-c","/bin/httpd","-f","-h /data/web/html"]  CMD ["/usr/local/nginx/sbin/nginx","-g","daemon off;"]    [root@docker dockerfile]# cat Dockerfile  #Description: test image  FROM busybox  LABEL maintainer="zisefeizhu <[email protected]>" app="httpd"  ENV WEBDIR="/data/web/html"  RUN mkdir -p ${WEBDIR} &&       echo 'this is a test web' > ${WEBDIR}/index.html  CMD [ "sh","-c","/bin/httpd","-f","-h ${WEBDIR}" ]  [root@docker dockerfile]# docker build -t httpd:v1 ./  [root@docker dockerfile]# docker run --name web01 -it --rm httpd:v1 ls /data/web/html  index.html  # 可以看出命令行的參數已經替代了原本的CMD指令指定的程式

11.ENTRYPOINT  介紹  類似CMD指令的功能,用於為容器指定默認運行程式。Dockerfile中可以存在多個ENTRYPOINT指令,但僅最後一個生效。與CMD區別在於,由ENTRYPOINT啟動的程式不會被docker run命令行指定的參數所覆蓋,而且這些命令行參數會被當做參數傳遞給ENTRYPOINT指令指定的程式。不過,docker run的--entrypoint選項的參數可覆蓋ENTRYPOINT指定的默認程式  語法  ENTRYPOINT command param1 param2  ENTRYPOINT ["executable", "param1", "param2"]  例子  [root@docker dockerfile]# cat Dockerfile  #Description: test image  FROM busybox  LABEL maintainer="zisefeizhu <[email protected]>" app="httpd"  ENV WEBDIR="/data/web/html"  RUN mkdir -p ${WEBDIR} &&       echo 'this is a test web' > ${WEBDIR}/index.html  ENTRYPOINT [ "sh","-c","/bin/httpd -f -h ${WEBDIR}" ]  [root@docker dockerfile]# docker build -t httpd:v2 ./  [root@docker dockerfile]# docker run --name web01 -it --rm httpd:v2  # 也是前台啟動,複製一個窗口,kill掉容器,然後開始docker run結尾傳入新的指令  [root@docker dockerfile]# docker run --name web01 -it --rm httpd:v2 ls /data/web/html  # 可以看到沒有反應,這種情況其實是把ls /data/web/html當做參數傳給了/bin/httpd -f -h ${WEBDIR}程式。只是httpd不識別罷了。我們kill掉容器。加上--entrypoint參數再試一下  [root@docker dockerfile]# docker run --name web01 -it --rm --entrypoint="" httpd:v2 ls /data/web/html  index.html  # 使用--entrypoint參數替換命令成功。  # 再測試下CMD的第三種語法,CMD指令的後面的命令作為參數傳給ENTRYPOINT指令後的命令  [root@docker dockerfile]# vim Dockerfile  # Description: test image  FROM busybox  LABEL maintainer="zisefeizhu <[email protected]>" app="httpd"  ENV WEBDIR="/data/web/html"  RUN mkdir -p ${WEBDIR} &&       echo 'this is a test web' > ${WEBDIR}/index.html  CMD [ "/bin/httpd -f -h ${WEBDIR}" ]  ENTRYPOINT [ "sh","-c" ]  [root@docker dockerfile]# docker build -t httpd:v3 ./  [root@docker dockerfile]# docker run --name web01 -it --rm httpd:v3  # OK的,前面有說過:指定ENTRYPOINT的情況下,如果docker run命令行結尾有參數指定,那CMD後面的參數不生效,下面咱再試試,還用v3的鏡像。  [root@docker dockerfile]# docker run --name web01 -it --rm httpd:v3 "ls /data/web/html"  index.html    [root@docker dockerfile]# vim Dockerfile   FROM nginx:1.14-alpine  LABEL maintainer="zhujingxing  <zisefeizhu@zhujingxing>"  ENV NGX_DOC_ROOT='/data/web/html/'  ADD index.html ${NGX_DOC_ROOT}  ADD entrypoint.sh /bin/  CMD ["/usr/sbin/nginx","-g","daemon off;"]     //註:雙引號  ENTRYPOINT ["/bin/entrypoint.sh"]    [root@docker dockerfile]# vim entrypoint.sh     #!/bin/sh  cat > /etc/nginx/conf.d/www.conf <<EOF  server {          server_name $HOSTNAME;          listen ${IP:-0.0.0.0}:${PORT:-80};          root ${NGX_DOC_ROOT:-/usr/share/nginx/html};  }  EOF  exec "$@"    [root@docker dockerfile]# docker build -t myweb:v0.3-6 ./  [root@docker dockerfile]# docker run --name myweb1 --rm -P -e "PORT=8080" myweb:v0.3-6  [root@docker dockerfile]# docker exec -it myweb1 /bin/sh  / # netstat -lnt  Active Internet connections (only servers)  Proto Recv-Q Send-Q Local Address           Foreign Address         State         tcp        0      0 0.0.0.0:8080            0.0.0.0:*               LISTEN        tcp        0      0 0.0.0.0:80              0.0.0.0:*               LISTEN        / # ps  PID   USER     TIME   COMMAND      1 root       0:00 nginx: master process /usr/sbin/nginx -g daemon off;      8 nginx      0:00 nginx: worker process      9 root       0:00 /bin/sh     15 root       0:00 ps  / # wget -O - -q adf1e144ec50  <h1>zhujingxing</h1>  / # exit

12.HEALTHCHECK  介紹  健康檢查。此指令的就是告訴docker如果檢查容器是否正常工作。拿apache舉例,即便進程運行,服務也不一定正常,因為萬一root指錯了呢?  通過HEALTHCHECK,我們可以知道如何測試一個容器查檢一個它是否在工作,比如檢測一個web 服務是否陷入死循環,不能處理新的連接、即使伺服器進程仍在運行。  當一個窗口指定了健康檢查時、除了正常狀態之外、還會有一個健康狀態作為初始、如果檢查通過、則會變成健康狀態、如果經過了一定次數的連續故障、則會變成非健康狀態。  語法  HEALTHCHECK [OPTIONS] CMD command (通過在容器中運行一個命令執行健康檢查)  HEALTHCHECK NONE (禁用從基本鏡像繼承的任何健康檢查)    HEALTHCHECK指令讓我們去定義一個CMD,在CMD後面編寫一條命令去判斷我們的服務運行是否正常。檢查肯定不是一次性的,所以OPTIONS就是指定檢查的頻率等等。  --interval=DURATION(默認值:30s):每隔多久檢查一次,默認30s  --timeout=DURATION(默認值:30s):超時時長,默認30s  --start-period=DURATION(默認值:0s):啟動健康檢查的等待時間。因為容器啟動成功時,進程不一定立馬就啟動成功,那過早開始檢查就會返回不健康。  --retries=N(默認值:3):如果檢查一次失敗就返回不健康未免太武斷,所以默認三次機會。    CMD健康檢測命令發出時,返回值有三種情況  0:成功  1:不健康  2:保留,無實際意義。    HEALTHCHECK NONE就是不做健康檢查  規則  啟動周期為需要時間啟動的容器提供初始化時間。 在此期間的探測失敗不會計入最大重試次數。 但是,如果在啟動期間運行狀況檢查成功,則認為容器已啟動,並且所有連續的故障都將計入最大重試次數。  單次運行檢查花費時間超過timeout指定時間、判定失敗。  每個Dockerfile中只能存在一個HEALTHCHECK指令,如果有多個則最後一個起作用。  HEALTHCHECK CMD後面的命令既可以是一個shell命令、也可以是一個exec 的數組。  例子  實例:每隔五分鐘檢查一次網路伺服器是否能夠在三秒鐘內為該網站的主頁面提供服務  HEALTHCHECK --interval=5m --timeout=3s CMD curl -f http://localhost/ || exit 1    為方便故障探測調試、檢測命令通過stdout或者stderr輸出的文本都會被快取在健康狀態中(快取大小為4096位元組)、並可以通過docker inspect查詢  當容器的運行狀況發生變化時,新的狀態會生成一個health_status事件    成功的例子:  [root@docker dockerfile]# cat Dockerfile   FROM nginx:1.14-alpine  LABEL maintainer="zhujingxing  <zisefeizhu@zhujingxing>"  ENV NGX_DOC_ROOT=”/data/web/html/”  ADD index.html ${NGX_DOC_ROOT}  ADD entrypoint.sh /bin/  EXPOSE 80/TCP  HEALTHCHECK --start-period=3s CMD wget -O - -q http://${IP:-0.0.0.0}:${PORT:80}/  CMD ["/usr/sbin/nginx","-g","daemon off;"]  ENTRYPOINT ["/bin/entrypoint.sh"]  [root@docker dockerfile]# docker build -t myweb:v0.1 ./  [root@docker dockerfile]# docker run --name myweb1 --rm -P -e "PORT=8080" myweb:v0.1    [root@docker dockerfile]# docker exec -it myweb1 /bin/sh    / # netstat -tnl  Active Internet connections (only servers)  Proto Recv-Q Send-Q Local Address           Foreign Address         State         tcp        0      0 0.0.0.0:8080            0.0.0.0:*               LISTEN        tcp        0      0 0.0.0.0:80              0.0.0.0:*               LISTEN        / # wget -O    [root@docker dockerfile]# docker run --name myweb1 --rm -P -e "PORT=8080" myweb:v0.1  127.0.0.1 - - [03/Aug/2019:13:15:35 +0000] "GET / HTTP/1.1" 200 612 "-" "Wget" "-"  127.0.0.1 - - [03/Aug/2019:13:15:43 +0000] "GET / HTTP/1.1" 200 612 "-" "Wget" "-"    失敗的例子  [root@docker dockerfile]# vim Dockerfile     FROM nginx:1.14-alpine  LABEL maintainer="zhujingxing  <zisefeizhu@zhujingxing>"  ENV NGX_DOC_ROOT='/data/web/html/'  ADD index.html ${NGX_DOC_ROOT}  ADD entrypoint.sh /bin/  EXPOSE 80/TCP  HEALTHCHECK --start-period=3s CMD wget -O - -q http://${IP:-0.0.0.0}:10080/  CMD ["/usr/sbin/nginx","-g","daemon off;"]  ENTRYPOINT ["/bin/entrypoint.sh"]  [root@docker dockerfile]# docker build -t myweb:v0.2 ./  [root@docker dockerfile]# docker run --name myweb1 --rm -P -e "PORT=8080" myweb:v0.2 //三個周期默認1.5分鐘後報錯  [root@docker dockerfile]# docker exec -it myweb1 /bin/sh  / # netstat -tnl  Active Internet connections (only servers)  Proto Recv-Q Send-Q Local Address           Foreign Address         State         tcp        0      0 0.0.0.0:8080            0.0.0.0:*               LISTEN        tcp        0      0 0.0.0.0:80              0.0.0.0:*               LISTEN

13.ARG  介紹  ARG命令同EVN類似,也是指定一個變數,但不同的是,ENV指令配合-e參數可以在docker run過程中傳參,而使用ARG指令配合--build-arg參數可以在docker build過程中傳參,這方便了我們為不同場景構建不同鏡像。  語法  ARG <name>[=<default value>]  例子  [root@docker dockerfile]# vim Dockerfile  FROM nginx:1.14-alpine  ARG AUTHOR=";zisefeizhu <[email protected]>"    # 指定默認值  LABEL maintainer=$AUTHOR  ENV NGXDIR='/data/web/html/'  ADD index.html $NGXDIR  ADD entrypoint.sh /bin/  CMD ["nginx", "-g", "daemon off;"]  ENTRYPOINT ["/bin/entrypoint.sh"]  [root@docker dockerfile]# docker build --build-arg AUTHOR="zhujingxing <[email protected]>" -t nginx:v4 ./  [root@docker dockerfile]# docker image inspect nginx:v4 | grep maintainer                  "maintainer": "zhujingxing <[email protected]>"  # 上面只是以maintainer舉例,實踐環境中可以修改為不同jar包的名字構建不同java程式鏡像。

14.STOPSIJNAL  介紹  指定發送使容器退出的系統調用訊號。docker stop之所以能停止容器,就是發送了15的訊號給容器內PID為1的進程。此指令一般不會使用。    語法  STOPSIGNAL signal

15.SHELL  介紹  用來指定運行程式默認要使用的shell類型,因為windows環境默認是powershell。此指令一般不會使用。  語法  SHELL ["executable", "parameters"]  例子  # Executed as powershell -command Write-Host hello  SHELL ["powershell", "-command"]  RUN Write-Host hello    # Executed as cmd /S /C echo hello  SHELL ["cmd", "/S"", "/C"]  RUN echo hello

16.USER  介紹  USER用於指定運行image時的或運行Dockerfile中任何RUN、CMD或ENTRYPOINT指令指定的程式時的用戶名或UID,即改變容器中運行程式的身份。默認情況下,container的運行身份為root用戶。  語法  USER <user>[:<group>]  USER <UID>[:<GID>]    實踐中UID需要是/etc/passwd中某用戶的有效UID,否則docker run命令將運行失敗  規則  使用USER指定用戶後,Dockerfile中其後的命令 RUN、CMD、ENTRYPOINT 都將使用該用戶。鏡像構建完成後,通過 docker run運行容器時,可以通過-u 參數來覆蓋所指定的用戶。

17.ONBUILD  介紹  ONBUILD用於在Dockerfile中定義一個觸發器,用來指定運行docker指令。Dockerfile用於build鏡像文件,此鏡像文件亦可作為base image被另一個Dockerfile用作FROM指令的參數,並以之構建新的鏡像文件。在後面的這個Dockerfile中的FROM指令在build過程中被執行時,將會“觸發”創建其base image的Dockerfile文件中的ONBUILD指令定義的觸發器。  語法  ONBUILD <INSTRUCTION>  規則  儘管任何指令都可註冊成為觸發器指令,但是ONBUILD不能自我嵌套,且不會觸發FROM和MAINTAINER(LABEL)指令。  使用包含ONBUILD指令的Dockerfile構建的鏡像應該使用特殊的標籤,例如ruby:2.0-onbuild。  在ONBUILD指令中使用ADD或COPY指令應該格外小心,因為新構建過程的上下文在缺少指定的源文件時會失敗。  ONBUILD 在構建鏡像時不會運行,是別人基於這個鏡像作為基礎鏡像構建時,才會運行。  例子  增加一個ONBUILD命令,執行RUN  FROM centos:7.3.1611  ENV nginx_ver=1.14.0  ENV nginx_url=http://nginx.org/download/nginx-${nginx_ver}.tar.gz  WORKDIR "/usr/local/src"  EXPOSE 80/tcp  ADD ${nginx_url} /usr/local/src/  RUN tar xf nginx-${nginx_ver}.tar.gz && yum -y install gcc pcre-devel openssl-devel make   && cd nginx-${nginx_ver} && ./configure && make && make install  CMD ["/usr/local/nginx/sbin/nginx","-g","daemon off;"]  ONBUILD RUN echo -e "nSunny do an onbuild~n" >> /etc/issue  構建鏡像  [root@docker dockerfile]# docker build -t nginx:v6 ./  基於nginx:v6啟動容器,此時/etc/issue還沒寫入echo要插入的資訊  [root@docker dockerfile]# docker run -it --rm -P --name nginxv3 nginx:v6 /bin/bash  [root@docker dockerfile]# cat /etc/issue  S  Kernel r on an m  然後基於這個nginx:v6鏡像,再次製作一個新鏡像,編輯一個新的Dockerfile  [root@docker dockerfile]# mkdir nginxv7  [root@docker dockerfile]# cd nginxv7/  [root@docker dockerfile]# vim Dockerfile  FROM nginx:v6  CMD "/bin/bash"  構建鏡像,注意,會提示執行一個build trigger,如下Executing 1 build trigger  [root@docker dockerfile]# docker build -t nginx:v7 ./   基於新鏡像nginx:v7啟動新容器nginxv7  [root@docker dockerfile]# docker run -it --rm --name nginxv7 nginx:v7  [root@becc66948713 src]# cat /etc/issue  S  Kernel r on an m  Sunny do an onbuild  [root@becc66948713 src]#  此時,在舊的鏡像中的dockerfile里的ONBUILD已經觸發,把資訊寫入到/etc/issue里
2.8.5 dockerfile 優化
最不容易發生變化的文件的拷貝操作放在較低的鏡像層中
器輕量化。從鏡像中產生的容器應該盡量輕量化,能在足夠短的時間內停止、銷毀、重新生成並替換原來的容器。
為了減少鏡像的大小,減少依賴,僅安裝需要的軟體包。
一個容器只做一件事。解耦複雜的應用,分成多個容器,而不是所有東西都放在一個容器內運行。如一個 Python Web 應用,可能需要 Server、DB、Cache、MQ、Log 等幾個容器。一個更加極端的說法:One process per container。
減少鏡像的圖層。不要多個 Label、ENV 等標籤。
對續行的參數按照字母表排序,特別是使用apt-get install -y安裝包的時候。
使用構建快取。如果不想使用快取,可以在構建的時候使用參數--no-cache=true來強制重新生成中間鏡像。
2.9 docker倉庫
細心的道友一定發現,我在第一章的集群搭建中並沒有部署倉庫集群。原因是:我個人想把鏡像倉庫做成kubernetes集群的pod,這樣的話必然牽扯到後端存儲。而存儲是我要單獨用一章來講的。為了docker章節的完整性,不得不闡述鏡像倉庫,但這並不代表我集群中的倉庫部署。僅僅是為了學習,為了章節完整性。
前面的章節有講過公有倉庫的使用,如 Docker.Hub 和阿里雲鏡像倉庫。這種方式有明顯的缺陷:push 和 pull 的速度很慢,假若實際環境有上百台機器,那需要多大頻寬才能 hold 住。所以多數時候還是需要創建自己的私有倉庫。工作中的生產環境主機選擇基本有三種:自建機房、IDC機房託管和阿里公有雲,前兩種情況最好是將 docker 私有倉庫建立在區域網內,而第三種使用阿里雲鏡像倉庫無非是最恰當的選擇。
搭建私有倉庫有兩種種方式:
使用 Docker 官方提供的 docker-distribution。可以通過 docker container 或者 yum 的方式安裝。docker container 的方式需要把鏡像存儲目錄掛載到宿主機的某目錄下,防止容器意外中止或者刪除導致倉庫不可用。此種 registry 功能比較單一。
使用 harbor,這是 VMware 基於 docker-distribution 二次開發的軟體,現在已經加入了 CNCF。功能強大,介面美觀。值得一提的是harbor支援中文,是不是很 happy,道友們。因為二次開發此軟體的主力是 VMware 中國區團隊。另外,原本的 harbor 部署是非常困難的,因此 harbor 官網直接把 harbor 做成了可以在容器中運行的應用,且 harbor 容器啟動時要依賴於其它一些容器協同工作,所以它在部署和使用時需要用到 docker 的單機編排工具 docker compose。
在生產實際中,現階段的鏡像倉庫還是harbor佔據明顯優勢,so,這節,我將直接闡述harbor倉庫。
我曾寫過一篇《docker私有registry和harbor的使用》。我認為已經闡述的足夠詳盡,有興趣的道友可以了解:https://blog.csdn.net/zisefeizhu/article/details/83511586
2.9.1 harbor簡介
Harbor 是Vmware公司開源的企業級Docker Registry管理項目,開源項目地址:https://github.com/vmware/harbor
Harbor的所有組件都在Docker中部署,所以Harbor可使用Docker Compose快速部署。(由於Harbor是基於Docker Registry V2版本,所以docker版本至少1.10.0、docker-compose版本至少1.6.0)
組件
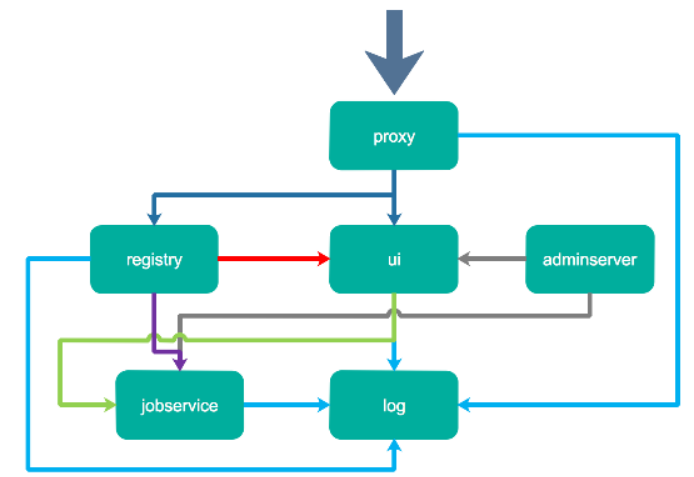
(1)proxy:nginx前端代理,分發前端頁面ui訪問和鏡像上傳和下載流量;
(2)ui:提供前端頁面和後端API,底層使用mysql資料庫;
(3)registry:鏡像倉庫,負責存儲鏡像文件,當鏡像上傳完畢後通過hook通知ui創建repository,registry的token認證也是通過ui組件完成;
(4)adminserver是系統的配置管理中心附帶檢查存儲用量,ui和jobserver啟動時候回需要載入adminserver的配置
(5)jobsevice:負責鏡像複製工作,和registry通訊,從一個registry pull鏡像然後push到另一個registry,並記錄job_log;
(6)log:日誌匯總組件,通過docker的log-driver把日誌匯總到一起。
Harbor介紹
Harbor是一個用於存儲和分發Docker鏡像的企業級Registry伺服器,通過添加一些企業必需的功能特性,例如安全、標識和管理等,擴展了開源Docker Distribution。作為一個企業級私有Registry伺服器,Harbor提供了更好的性能和安全。提升用戶使用Registry構建和運行環境傳輸鏡像的效率。Harbor支援安裝在多個Registry節點的鏡像資源複製,鏡像全部保存在私有Registry中, 確保數據和知識產權在公司內部網路中管控。另外,Harbor也提供了高級的安全特性,諸如用戶管理,訪問控制和活動審計等。
Harbor特性
基於角色的訪問控制 :用戶與Docker鏡像倉庫通過“項目”進行組織管理,一個用戶可以對多個鏡像倉庫在同一命名空間(project)里有不同的許可權。
鏡像複製 : 鏡像可以在多個Registry實例中複製(同步)。尤其適合於負載均衡,高可用,混合雲和多雲的場景。
圖形化用戶介面 : 用戶可以通過瀏覽器來瀏覽,檢索當前Docker鏡像倉庫,管理項目和命名空間。
AD/LDAP 支援 : Harbor可以集成企業內部已有的AD/LDAP,用於鑒權認證管理。
審計管理 : 所有針對鏡像倉庫的操作都可以被記錄追溯,用於審計管理。
國際化 : 已擁有英文、中文、德文、日文和俄文的本地化版本。更多的語言將會添加進來。
RESTful API : RESTful API 提供給管理員對於Harbor更多的操控, 使得與其它管理軟體集成變得更容易。
部署簡單 : 提供在線和離線兩種安裝工具, 也可以安裝到vSphere平台(OVA方式)虛擬設備。
2.9.2 harbor部署
[root@docker02 ~]# hostname -I 20.0.0.200 # harbor 託管在GitHub上,頁面搜索" Installation & Configuration Guide "可以查看安裝步驟。下載 harbor壓縮包,並解壓。 [root@docker02 ~]# mkdir work [root@docker02 ~]# cd work [root@docker02 work]# wget https://storage.googleapis.com/harbor-releases/release-1.8.0/harbor-offline-installer-v1.8.1.tgz [root@docker02 work]# ls harbor-offline-installer-v1.8.1.tgz [root@docker02 work]# tar xf harbor-offline-installer-v1.8.1.tgz [root@docker02 work]# tar xf harbor-offline-installer-v1.8.1.tgz -C /usr/local/ [root@docker02 work]# cd /usr/local/harbor/ [root@docker02 harbor]# ll 總用量 551208 -rw-r--r-- 1 root root 564403568 6月 17 11:30 harbor.v1.8.1.tar.gz -rw-r--r-- 1 root root 4519 6月 17 11:29 harbor.yml -rwxr-xr-x 1 root root 5088 6月 17 11:29 install.sh -rw-r--r-- 1 root root 11347 6月 17 11:29 LICENSE -rwxr-xr-x 1 root root 1654 6月 17 11:29 prepare #修改hardor的配置文件 hostname: 20.0.0.200 # 填寫區域網或者互聯網可以訪問得地址,有域名可以寫域名 harbor_admin_password: 123456 # 管理員的初始密碼,默認用戶名為admin database: password: root123 # 資料庫密碼。默認是root123 data_volume: /data # 存儲harbor數據的位置 jobservice: max_job_workers: 10 # 啟動幾個並發進程來處理用戶的上傳下載請求。一般略小於CPU核心數。 # 一般會修改的參數也就上面幾項,另外http和https根據自己實際情況配置進行,這裡就使用默認的http。 [root@docker02 harbor]# ./install.sh [Step 0]: checking installation environment ... Note: docker version: 19.03.1 ✖ Need to install docker-compose(1.18.0+) by yourself first and run this script again. [root@docker02 harbor]# yum info docker-compose | egrep -i 'repo|version' * elrepo: hkg.mirror.rackspace.com [root@docker02 harbor]# yum -y install docker-compose # 開始安裝harbor,因為需要解壓使用harbor.v1.8.1.tar.gz中打包好的鏡像,所以需要稍微等一下。 [root@docker02 harbor]# ./install.sh ✔ ----Harbor has been installed and started successfully.---- Now you should be able to visit the admin portal at http://20.0.0.200. For more details, please visit https://github.com/goharbor/harbor . [root@docker02 harbor]# netstat -lntup Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name tcp 0 0 127.0.0.1:1514 0.0.0.0:* LISTEN 2973/docker-proxy tcp 0 0 0.0.0.0:22 0.0.0.0:* LISTEN 955/sshd tcp6 0 0 :::80 :::* LISTEN 3724/docker-proxy tcp6 0 0 :::22 :::* LISTEN 955/sshd udp 0 0 127.0.0.1:323 0.0.0.0:* 709/chronyd udp6 0 0 ::1:323 :::* 709/chronyd 問harbor的web介面,上面執行 ./install.sh 的結尾有提示web登入的方式。用戶名和密碼:admin/123456
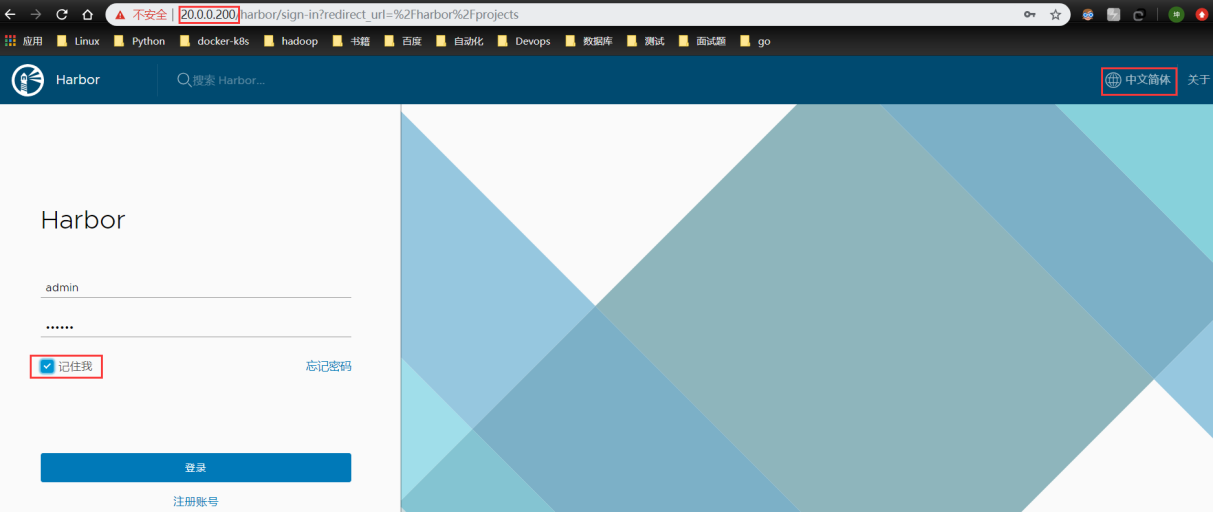

接下來我們開始創建私有倉庫。
先創建一個普通的賬戶
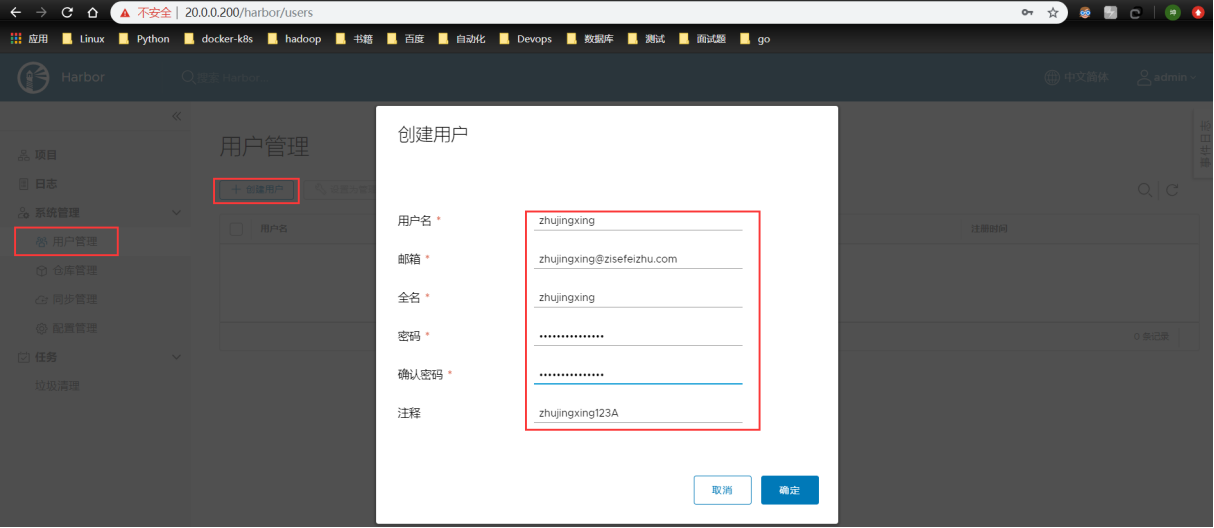
切換上面的普通賬戶,新建立一個私有項目
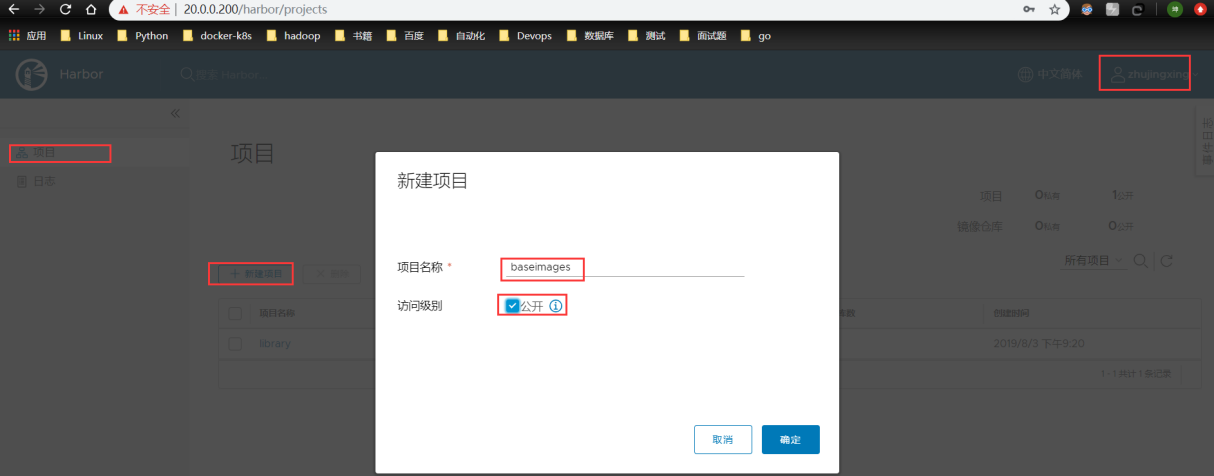
推送鏡像到baseimages項目中
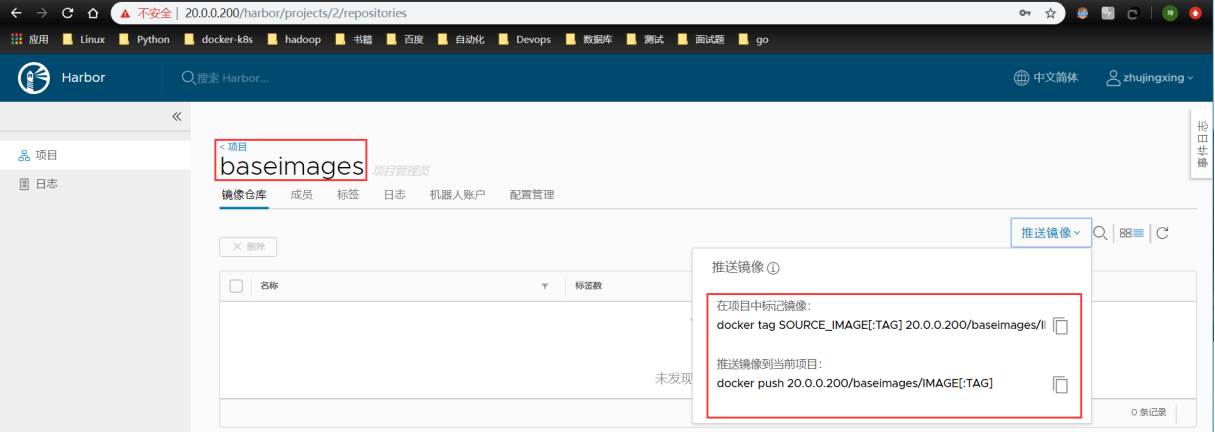
[root@docker ~]# cp /etc/docker/daemon.json{,.bak} cp:是否覆蓋"/etc/docker/daemon.json.bak"? y [root@docker ~]# vim /etc/docker/daemon.json [root@docker ~]# diff /etc/docker/daemon.json{,.bak} 3,4c3 < "bip": "10.0.0.1/16", < "insecure-registries": ["20.0.0.200"] --- > "bip": "10.0.0.1/16" [root@docker ~]# systemctl restart docker Warning: docker.service changed on disk. Run 'systemctl daemon-reload' to reload units. [root@docker ~]# systemctl daemon-reload [root@docker ~]# systemctl restart docker [root@docker ~]# docker image ls REPOSITORY TAG IMAGE ID CREATED SIZE busy v1 e0078e53d05d 6 hours ago 1.22MB [root@docker ~]# docker tag busy:v1 20.0.0.200/baseimages/busy:v1 [root@docker ~]# docker login -u zhujingxing 20.0.0.200 Password: WARNING! Your password will be stored unencrypted in /root/.docker/config.json. Configure a credential helper to remove this warning. See https://docs.docker.com/engine/reference/commandline/login/#credentials-store Login Succeeded [root@docker ~]# docker push 20.0.0.200/baseimages/busy:v1 The push refers to repository [20.0.0.200/baseimages/busy] f6d434d1b26b: Pushed 0d315111b484: Pushed v1: digest: sha256:2c7184696987b361dbf2c30cc4410858d1245a31921cec80bf6ca6b73857470b size: 734 刷新harbor頁面
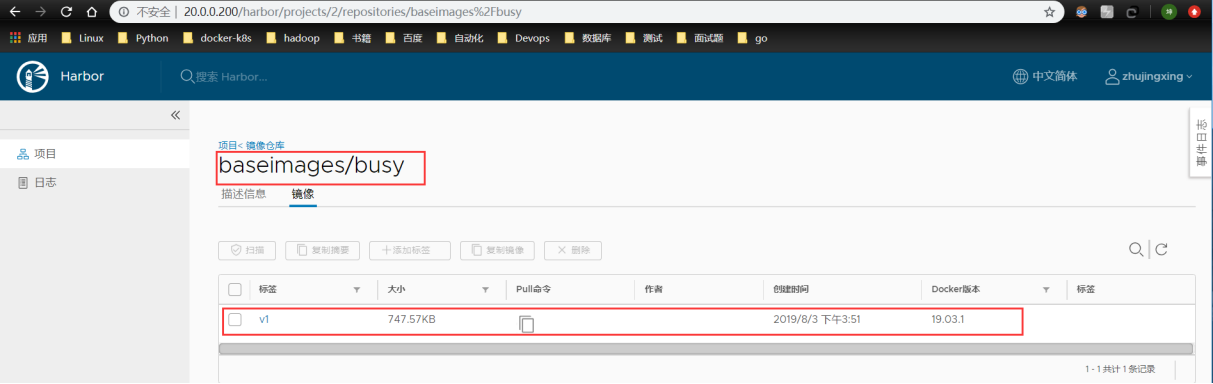
到這私有倉庫也就搭建完成了,也可以在 /data 目錄下查看數據
[root@docker02 harbor]# ll /data/registry/docker/registry/v2/repositories/baseimages/ 總用量 0 drwxr-xr-x 5 10000 10000 55 8月 3 21:35 busy 如果要對harbor服務做一些操作,需要使用docker-compose命令
# 其實前面的./install.sh也是使用的 docker-compose create 和 docker-compose start 命令啟動的 harbor。注意,命令執行需要再harbor的目錄下,否則會報錯找不到配置文件。 [root@docker02 harbor]# docker-compose --help [root@docker02 ~]# docker-compose pause ERROR: Can't find a suitable configuration file in this directory or any parent. Are you in the right directory? Supported filenames: docker-compose.yml, docker-compose.yaml [root@docker02 ~]# cd - /usr/local/harbor [root@docker2 harbor]# docker-compose pause Pausing harbor-log ... done Pausing redis ... done Pausing harbor-db ... done Pausing registry ... done Pausing registryctl ... done Pausing harbor-core ... done Pausing harbor-portal ... done Pausing harbor-jobservice ... done Pausing nginx ... done #開機自啟動harbor [root@docker02 harbor]# cp /etc/rc.d/rc.local{,.bak} [root@docker02 harbor]# vim /etc/rc.d/rc.local [root@docker02 harbor]# diff /etc/rc.d/rc.local{,.bak} 14,15d13 < #harbor < cd /usr/local/harbor && docker-compose start 註:
在此章節,我只是圍繞harbor倉庫進行闡述,詳細了解請看我提供的鏈接。
在此章節,我並沒有闡述harbor倉庫的高可用,安全等問題,這算幾處坑吧,在kubernetes編排工具章,我會進行填補。
2.10 docker資源限制
默認情況下,容器沒有資源限制,可以使用主機內核調度程式允許的儘可能多的給定資源。
Docker同LXC一樣,其對資源的隔離和管控是以Linux內核的namespaces和cgroup為基礎。Docker的資源隔離使用了Linux內核 Kernel中的Namespaces功能來實現,隔離的對象包括:主機名與域名、進程編號、網路設備、文件系統的掛載點等,namespace中的IPC隔離docker並未使用,docker中使用TCP替代IPC。
在使用Namespaces隔離資源的同時,Docker使用了Linux內核Kernel提供的cgroup來對Container使用的CPU、記憶體、磁碟IO資源進行配額管控。換句話說,在docker的容器啟動參數中,像--cpu*、--memory*和--blkio*的設置,實際上就是設置cgroup的相對應cpu子系統、記憶體子系統、磁碟IO子系統的配額控制文件,只不過這個修改配額控制文件的過程是docker實例代替我們做掉罷了。因此,我們完全可以直接修改docker容器所對應的cgroup子系統中的配額控制文件來達到控制docker容器資源配額的同樣目的。
2.10.1 memory
記憶體風險
不允許容器消耗宿主機太多的記憶體是非常重要的。在Linux主機上,如果內核檢測到沒有足夠的記憶體來執行重要的系統功能,它會拋出OOME或Out of Memory異常,並開始終止進程以釋放記憶體。任何進程都會被殺死,包括 Docker和其他重要的應用程式。如果殺錯進程,可能導致整個系統癱瘓。
Docker 通過調整 Docker daemon 上的 OOM 優先順序來降低這些風險,以便它比系統上的其他進程更不可能被殺死。容器上的 OOM 優先順序未調整,這使得單個容器被殺死的可能性比 Docker daemon 或其他系統進程被殺死的可能性更大。你不應試圖通過在 daemon 或容器上手動設置--oom-score-adj到極端負數,或通過在容器上設置--oom-kill-disable來繞過這些安全措施。
有關Linux內核的OOM管理的更多資訊,查看 Out of Memory Management:https://www.kernel.org/doc/gorman/html/understand/understand016.html
可以通過以下方式降低 OOME 導致系統不穩定的風險:
在應用程式發布到生產之前,執行相關測試以便了解應用程式的記憶體要求;
確保應用程式僅在具有足夠資源的主機上運行;
限制容器可以使用的記憶體,如下所述;
在 Docker 主機上配置 Swap 時要小心,Swap 比記憶體更慢且性能更低,但可以提供緩衝以防止系統記憶體耗盡;
考慮將 Container 轉換部署為 Service,並使用服務級別約束和節點標籤來確保應用程式僅在具有足夠記憶體的主機上運行。
限制容器記憶體
下述選項中的大多數採用正整數,後跟b/k/m/g的後綴,代表單位:位元組/千位元組/兆位元組/千兆位元組。
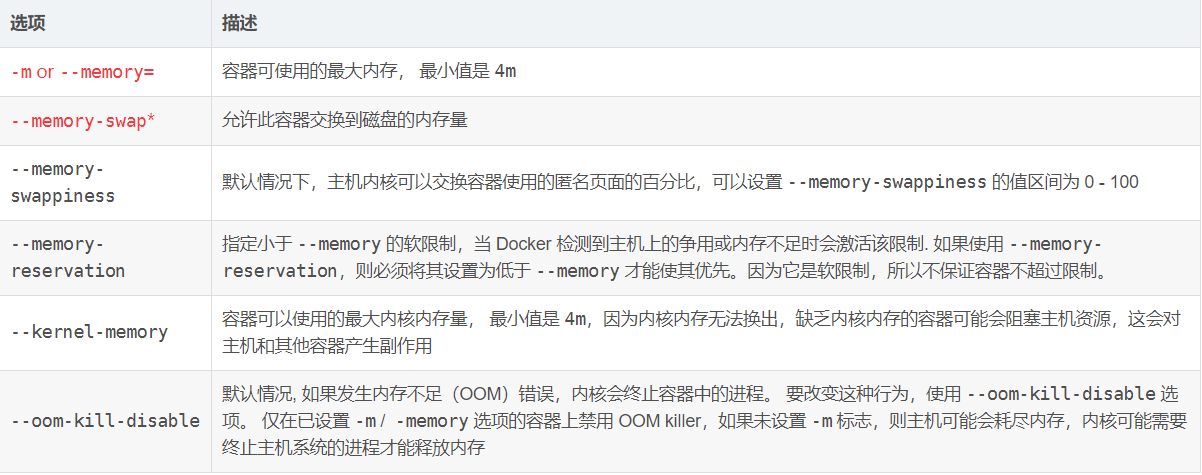
有關 cgroup 和記憶體的更多資訊,查看Memory Resource Controller:https://www.kernel.org/doc/Documentation/cgroup-v1/memory.txt
關於 --memory-swap
--memory-swap是一個修飾符標誌,只有在設置了--memory時才有意義。使用swap允許容器在容器耗盡所有可用的RAM時,將多餘的記憶體需求寫入磁碟。對於經常將記憶體交換到磁碟的應用程式,性能會受到影響。
它的設置會產生複雜的影響:
如果--memory-swap設置為正整數,則必須設置--memory和--memory-swap。--memory-swap表示可以使用的memory和swap總量, --memory控制no-swap的用量。所以,如果設置--memory="300m"和--memory-swap="1g", 容器可以使用300m memory和700m (1g - 300m)swap。
如果--memory-swap設置為0,該設置被忽略,該值被視為未設置。
如果--memory-swap的值等於--memory的值,並且--memory設置為正整數,則容器無權訪問swap。這是因為--memory-swap是可以使用組合的 Memory和 Swap,而--memory只是可以使用的 Memory。
如果--memory-swap不設置,並且--memory設置了值, 容器可以使用--memory兩倍的Swap(如果主機容器配置了Swap)。
示例:設置--memory="300m"並且不設置--memory-swap,容器可以使用300m memory和600m swap。
如果--memory-swap設置為-1,允許容器無限制使用Swap。
在容器內部,像free等工具報告的是主機的可用Swap,而不是容器內可用的。不要依賴於free或類似工具的輸出來確定是否存在 Swap。
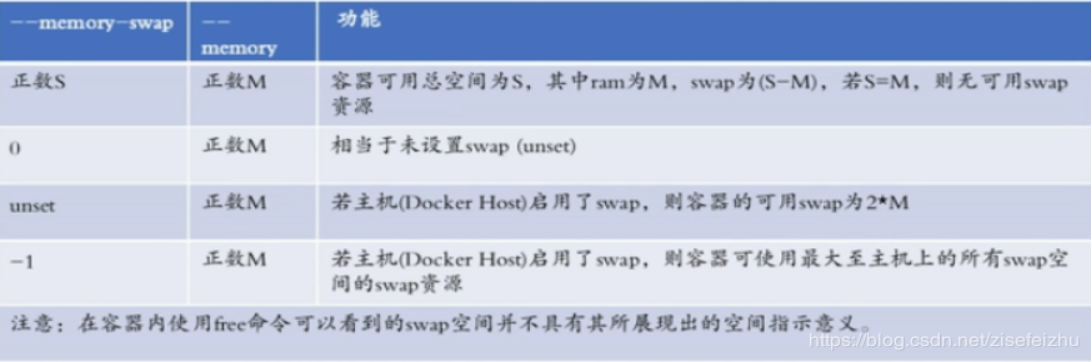
關於 --memory-swappiness
值為0時,關閉匿名頁交換。
值為100時,將所有匿名頁設置為可交換。
默認情況下,如果不設置--memory-swappiness,該值從主機繼承。
關於 --kernel-memory
內核記憶體限制是就分配給容器的總記憶體而言的,考慮一下方案:
無限記憶體,無限內核記憶體:這是默認行為。
無限記憶體,有限內核記憶體:當所有 cgroup 所需的記憶體量大於主機上實際存在的記憶體量時,它是合適的。可以將內核記憶體配置為永遠不會超過主機上可用的記憶體,而需求更多記憶體的容器需要等待它。
有限記憶體,無限內核記憶體:整體記憶體有限,但內核記憶體不是。
有限記憶體,有限內核記憶體:限制用戶和內核記憶體對於調試與記憶體相關的問題非常有用,如果容器使用意外數量的任意類型的記憶體,則記憶體不足不會影響其他容器或主機。在此設置中,如果內核記憶體限制低於用戶記憶體限制,則內核記憶體不足會導致容器遇到 OOM 錯誤。如果內核記憶體限制高於用戶記憶體限制,則內核限制不會導致容器遇到OOM。
當你打開任何內核記憶體限制時,主機會根據每個進程跟蹤“高水位線”統計資訊,因此你可以跟蹤哪些進程正在使用多餘的記憶體。通過查看主機上的/proc/<PID>/status,可以在每個進程中看到這一點。
2.10.2 cpu
默認情況下,每個容器對主機 CPU 周期的訪問許可權是不受限制的,你可以設置各種約束來限制給定容器訪問主機的CPU周期。大多數用戶使用和配置默認 CFS調度程式。在Docker 1.13 及更高版本中,還可以配置實時調度程式。
配置默認 CFS 調度程式
CFS 是用於普通Linux進程的Linux內核CPU調度程式。通過以下設置,可以控制容器的CPU資源訪問量,使用這些設置時,Docker會修改主機上容器的 cgroup的設置。
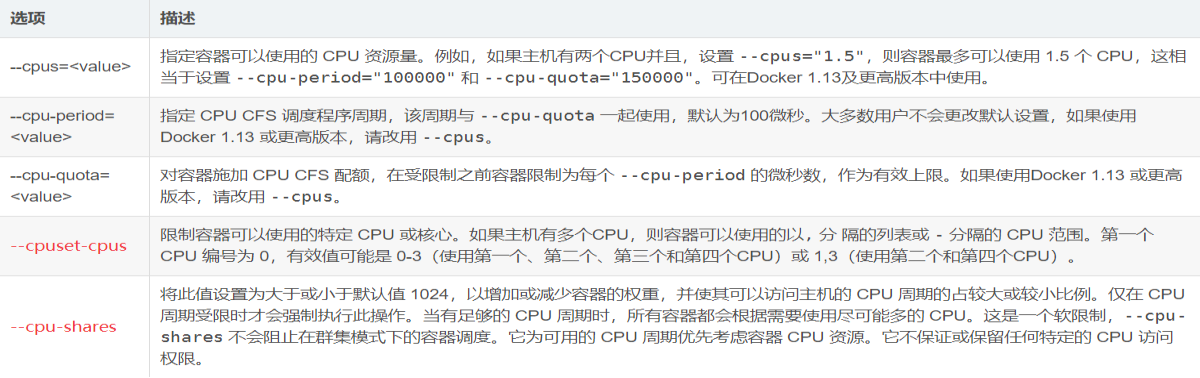
示例:如果你有 1 個 CPU,則以下每個命令都會保證容器每秒最多占 CPU 的 50%。
Docker 1.13 或更高版本:
[root@docker ~]# docker run -it --cpus=".5" busybox
配置實時調度程式
在 Docker 1.13 或更高版本,你可以配置容器使用實時調度程式。在配置 Docker daemon 或配置容器之前,需要確保正確配置主機的內核。
警告:CPU 調度和優先順序是高級內核級功能,大多數用戶不需要從默認值更改這些值,錯誤地設置這些值可能會導致主機系統變得不穩定或無法使用。
配置主機機器的內核
通過運行zcat /proc/config.gz|grep CONFIG_RT_GROUP_SCHED驗證是否在Linux內核中啟用了CONFIG_RT_GROUP_SCHED,或者檢查是否存在文件/sys/fs/cgroup/cpu.rt_runtime_us。有關配置內核實時調度程式的教程,請參閱作業系統的文檔。
配置DOCKER DAEMON
要使用實時調度程式運行容器,請運行Docker daemon,並將--cpu-rt-runtime設置為每個運行時間段為實時任務保留的最大微秒數。例如,默認周期為 1000000 微秒(1秒),設置--cpu-rt-runtime=950000可確保使用實時調度程式的容器每1000000微秒可運行950000微秒,並保留至少50000微秒用於非實時任務。要在使用systemd的系統上永久保留此配置,請參閱Control and configure Docker with systemd:https://docs.docker.com/config/daemon/systemd/
配置個別容器
使用docker run啟動容器時,可以傳遞多個參數來控制容器的CPU優先順序。有關適當值的資訊,請參閱作業系統的文檔或ulimit命令。

示例:
[root@docker ~]# docker run -it --cpu-rt-runtime=95000 --ulimit rtprio=99 --cap-add=sys_nice debian:jessie
註:如果未正確配置內核或 Docker Daemon,則會發生錯誤。
2.10.3 案例演示
[root@docker ~]# lscpu Architecture: x86_64 CPU op-mode(s): 32-bit, 64-bit Byte Order: Little Endian CPU(s): 4 #拖壓測工具 [root@docker ~]# docker pull lorel/docker-stress-ng #設置選項 給docker傳選項,該進程最多佔用256M記憶體 --vm 2 則需要512M,記憶體溢出 [root@docker ~]# docker run --name stress -it --rm -m 256m lorel/docker-stress-ng stress --vm 2 stress-ng: info: [1] defaulting to a 86400 second run per stressor stress-ng: info: [1] dispatching hogs: 2 vm 另開一個窗口,查看進程 [root@docker ~]# docker top stress UID PID PPID C STIME TTY TIME CMD root 62445 62428 0 11:25 pts/0 00:00:00 /usr/bin/stress-ng stress --vm 2 root 62479 62445 0 11:25 pts/0 00:00:00 /usr/bin/stress-ng stress --vm 2 root 62480 62445 0 11:25 pts/0 00:00:00 /usr/bin/stress-ng stress --vm 2 root 62666 62480 0 11:25 pts/0 00:00:00 /usr/bin/stress-ng stress --vm 2 root 62676 62479 0 11:25 pts/0 00:00:00 /usr/bin/stress-ng stress --vm 2 #顯示記憶體變數資訊 [root@docker ~]# docker stats CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS 76c2d2f81ee2 stress 218.24% 215MiB / 256MiB 83.97% 0B / 0B 0B / 0B 5 #演示限制CPU核心數 也可以不加,默認會把CPU核數全吞下去 [root@docker ~]# docker run --name stress -it --rm --cpus 1 lorel/docker-stress-ng:latest stress --cpu 8 stress-ng: info: [1] defaulting to a 86400 second run per stressor stress-ng: info: [1] dispatching hogs: 8 cpu [root@docker ~]# docker top stress UID PID PPID C STIME TTY TIME CMD root 64853 64836 0 11:29 pts/0 00:00:00 /usr/bin/stress-ng stress --cpu 8 root 64887 64853 13 11:29 pts/0 00:00:08 /usr/bin/stress-ng stress --cpu 8 root 64888 64853 12 11:29 pts/0 00:00:07 /usr/bin/stress-ng stress --cpu 8 root 64889 64853 13 11:29 pts/0 00:00:08 /usr/bin/stress-ng stress --cpu 8 root 64890 64853 11 11:29 pts/0 00:00:07 /usr/bin/stress-ng stress --cpu 8 root 64891 64853 13 11:29 pts/0 00:00:08 /usr/bin/stress-ng stress --cpu 8 root 64892 64853 13 11:29 pts/0 00:00:08 /usr/bin/stress-ng stress --cpu 8 root 64893 64853 11 11:29 pts/0 00:00:07 /usr/bin/stress-ng stress --cpu 8 root 64894 64853 11 11:29 pts/0 00:00:07 /usr/bin/stress-ng stress --cpu 8 [root@docker ~]# docker stats CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS 390fae70a245 stress 0.10% 28MiB / 1.936GiB 1.41% 0B / 0B 0B / 0B 9 CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS 390fae70a245 stress 0.10% 28MiB / 1.936GiB 1.41% 0B / 0B 0B / 0B 9 [root@docker ~]# docker stats CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS 390fae70a245 stress 108.93% 28MiB / 1.936GiB 1.41% 0B / 0B
2.11 感言
單單容器是基本不會出現在生產場景的,必然要藉助於編排工具,而編排工具能提供諸如:網路、資源限制、存儲等功能,也就是說單單對於docker章的學習是集中於docker的基本用法、docker的鏡像技術、dockerfile的書寫。
對於docker倉庫,我並沒有詳細闡述,甚至是一筆帶過的,原因我之前已經有講,我期待的是將重點、難點、複雜點都放在Kubernetes章節。
又是一星期,現在是2019年8月4號12點14分。到此為止docker章第一版算是基本完成。這個星期我熬了兩天晚上的夜,倒不是因為寫docker,主要是go語言有點難搞哦。7月份工作穩住,8月份該衝刺一波了。未來可期,應約而至,不忘初心,放得本心。
年輕人,一個星期熬兩三次夜,也沒得啥事嘛!